# Очистка
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
> [!NOTE]
> **В этой главе мы рассмотрим:**
>
> - что такое очистка и зачем она нужна;
>
> - живые и мертвые строки;
>
> - фоновый процесс автоочистки;
>
> - при каких условиях и как часто выполняется очистка;
>
> - как посмотреть очередь таблиц на обработку;
>
> - счетчик транзакций и предотвращение ошибок, связанных с его зацикливанием;
>
> - транзакционный горизонт;
>
> - как определить количество доступных идентификаторов транзакций;
>
> - эффект раздувания;
>
> - как определить, насколько раздулись таблицы и индексы;
>
> - способы отслеживания активных процессов очистки.
В предыдущих главах рассмотрена часть фоновых процессов СУБД, в этой продолжено их рассмотрение. Глава посвящена процессу очистки, более известной как *очистка* (vacuum). Далее в тексте я буду использовать термин «очистка», подразумевая оба его варианта, как ручной, так и автоматический; в контексте автоматической очистки будет использоваться термин «автоочистка».
Очистка представляет собой реализацию сборщика мусора (garbage collector) и является важной частью СУБД. Ее эффективная работа напрямую влияет на производительность. В этой главе в необходимом объеме будет рассмотрен механизм очистки, аспекты его работы, требующие отслеживания и, конечно же, необходимые для мониторинга инструменты СУБД.
## 8.1. Введение в очистку {#mon-section-8-1}
Чтобы обеспечить высокую производительность конкурентной работы клиентов при значительных нагрузках, PostgreSQL реализует модель MVCC[^mon-196-1] (Multiversion Concurrency Control). Эта модель минимизирует количество блокировок и позволяет читающим процессам не блокировать пишущие, а пишущим — читающие.
При выполнении запросов и транзакций СУБД оперирует *снимками* (snapshot). Снимок определяет видимое для транзакции состояние данных и включает только зафиксированные на момент создания снимка изменения, а момент создания выбирается исходя из установленного *уровня изоляции* (isolation level) транзакций. Конкурентное выполнение транзакций (и запросов) предполагает существование нескольких снимков, в рамках которых может осуществляться не только чтение, но и изменение данных.
В модели MVCC PostgreSQL строки не изменяются на месте (in-place); вместо этого различные операции выполняют действия с версиями строк:
- операция `INSERT` вставляет первую версию новой строки;
- операция `UPDATE` вставляет новую версию строки, а предыдущую версию отмечает как удаленную;
- операция `DELETE` отмечает версию строки как удаленную.
Таким образом, для одной и той же строки может существовать несколько версий — одна актуальная, она же живая (live), и, возможно, несколько мертвых (dead). Строки, помеченные как удаленные, продолжают некоторое время храниться в тех же страницах и файлах данных, поскольку все еще могут потребоваться другим активным транзакциям (то есть входят в снимки, используемые этими транзакциями). В случае высокой активности на запись может появляться все больше и больше версий строк, помеченных удаленными, что сказывается на размерах таблиц и индексов. С постепенным завершением транзакций мертвые строки в конечном счете становятся не нужными ни одной из транзакций, и их можно безопасно удалить, освободив место для новых строк. Более подробно о работе механизма MVCC можно прочитать в соответствующей главе книги The Internals of PostgreSQL[^mon-197-1].
Постепенно становясь ненужными, мертвые версии строк продолжают занимать пространство в страницах, что приводит к избыточным операциям ввода-вывода и расходу ресурсов, которого хотелось бы избежать. Так перед СУБД возникает необходимость в удалении устаревших версий строк, которые больше никому не нужны. Этой задачей и занимается очистка. В ранних версиях PostgreSQL очистка была реализована в виде отдельной команды `VACUUM`, которую администратор был должен запускать вручную или с помощью внешнего планировщика задач (обычно cron). Помимо очистки, у команды `VACUUM` есть несколько дополнительных функций: сбор статистики планировщика, полная блокирующая очистка, заморозка строк и др. Больше информации о работе команды очистки можно узнать из документации[^mon-197-2]. Впоследствии была реализована автоматическая версия очистки в виде фоновых процессов, запускающихся по необходимости.
Первый процесс автоочистки autovacuum launcher поддерживает список баз данных и принимает решение, когда нужно запустить очистку в конкретной базе. Когда в этом возникает необходимость, autovacuum launcher отправляет сигнал головному процессу postmaster, и тот, в свою очередь, запускает рабочий процесс autovacuum worker. Рабочий процесс очистки узнает имя целевой базы, подключается к ней и строит список таблиц, подлежащих обработке. Обрабатывая по очереди таблицы из списка, рабочий процесс сканирует их на предмет устаревших версий строк, не нужных ни одной из активных транзакций, и освобождает место как в самих таблицах, так и в индексах. Освобожденное пространство может использоваться для вставки новых строк. Если в ходе очистки свободное пространство образовалось в конце файла таблицы, то очистка может отсечь хвостовые пустые страницы (truncate heap) и таким образом уменьшить файл таблицы.
При некоторых видах рабочих нагрузок возникают случаи, когда в таблицах и индексах содержится относительно небольшое количество живых строк, а все остальное пространство освобождено и при этом не используется. Если при этом участки пустого пространства физически находятся в разных частях файла, то очистка не может высвободить эти участки и уменьшить сам файл. Процесс образования таких участков и их постепенное увеличение называют *раздуванием* (bloat). В самом безобидном случае следствием эффекта раздувания является впустую занимаемое пространство, а в худшем — снижение производительности ввода-вывода из-за избыточных операций, нехватки буферного кеша и снижения эффективности индексного доступа из-за образования лишних уровней у индексов. Поэтому при эксплуатации СУБД необходимо отслеживать излишнее раздувание таблиц и индексов и сокращать его.
Подводя некоторый итог, можно сказать, что с точки зрения эксплуатации администратор БД должен отслеживать эффективность работы автоочистки, создаваемый ею уровень нагрузки и долю мертвых строк в таблицах, и при необходимости корректировать настройки очистки и уменьшать образовавшееся раздувание.
В современных реалиях с ростом производительности систем хранения важность отслеживания уровня нагрузки от очистки сильно уменьшилась. Если раньше, в эпоху HDD-дисков, это было актуально, поскольку очистка могла значительно влиять на производительность запросов, то сейчас, при использовании SSD- и NVMe-носителей, это негативное влияние сильно уменьшилось или вообще сошло на нет.
## 8.2. Особенности очистки на практике {#mon-section-8-2}
Чтобы получить представление о том, что именно следует отслеживать в работе очистки, давайте рассмотрим практические особенности ее работы. Очистка запускается только при наступлении определенных событий, и в идеале не должна запаздывать. Но в случае запаздывания важно представлять себе объем накопившейся работы.
### Когда выполняется автоочистка? {#mon-section-star-149}
Автоочистка обрабатывает таблицу, когда объем мертвых строк в ней превышает некоторое допустимое количество. Устаревшие версии строк появляются из-за обновлений и удалений; при выполнении этих операций количество устаревших версий постоянно отслеживается, и, как только оно превысит допустимое значение, таблица добавляется в список на обработку. Предельное значение вычисляется на основании следующей информации:
- `pg_class.reltuples` — общее количество строк в таблице согласно последнему выполнению очистки;
- `pg_stat_all_tables.n_dead_tup` — общее количество мертвых строк, которое обновляется при операциях обновления и удаления;
- *autovacuum\_vacuum\_threshold* — параметр, определяющий базовое пороговое значение, то есть минимальное количество мертвых строк в таблице, необходимое для ее очистки (по умолчанию 50 строк);
- *autovacuum\_vacuum\_scale\_factor* — параметр, определяющий долю общего числа строк, на которую увеличивается базовое пороговое значение *autovacuum\_vacuum\_threshold* (по умолчанию 0,2, что означает 20 % от `pg_class.reltuples`).
Согласно значениям по умолчанию, для срабатывания автоочистки количество мертвых строк в таблице должно превышать 50 + 20 % от общего числа строк. Значение параметра *autovacuum\_vacuum\_scale\_factor* `= 0.2` часто воспринимается как консервативное и в современных конфигурациях принято указывать меньшее значение в диапазоне от 0,01 до 0,05, тем самым вызывая автоочистку чаще и при гораздо меньшем количестве мертвых строк. Для очень больших таблиц (с большими индексами) даже небольшое значение параметра *autovacuum\_vacuum\_scale\_factor* при переводе в строки может оказаться большим, и рабочей памяти может не хватить для размещения всех указателей на мертвые строки. Это очень сильно повышает стоимость процедуры очистки, так как при этом приходится полностью сканировать и очищать индексы несколько раз. В таких случаях для отдельных таблиц можно устанавливать индивидуальные параметры очистки с помощью параметров хранения[^mon-199-1].
Теперь, зная условие срабатывания автоочистки, можно написать запрос для определения таблиц, у которых количество мертвых строк превышает допустимое значение. Запрос выводит список пользовательских таблиц с некоторой статистикой:
- `relation` — имя таблицы. При желании можно вывести также имя схемы;
- `reltuples` — приблизительное количество строк в таблице. Это значение обновляется каждый раз после выполнения автоочистки, команд `VACUUM`, `ANALYZE` и некоторых DDL-команд вроде `CREATE INDEX`;
- `live_tup` — количество живых строк в таблице;
- `dead_tup` — количество устаревших, мертвых строк в таблице;
- `boundary` — допустимое количество мертвых версий строк. Когда количество мертвых версий превысит это значение, таблица должна обработаться автоочисткой;
- `av_cnt` — общее количество выполненных операций автоочистки на таблице;
- `since_last_av` — время, прошедшее с момента выполнения последней автоочистки;
- `av_need` — признак того, что количество мертвых версий превышает допустимое значение и таблице требуется обработка;
- `dead_ratio` — процентное отношение количества мертвых версий к общему числу строк в таблице.
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24"}
# SELECT
*,
av.dead_tup > av.boundary AS av_need,
CASE WHEN reltuples > 0
THEN round(100.0 * av.dead_tup / reltuples)
ELSE 0
END AS n_dead_ratio
FROM
(SELECT
c.relname AS relation,
c.reltuples AS reltuples,
pg_stat_get_live_tuples(c.oid) AS live_tup,
pg_stat_get_dead_tuples(c.oid) AS dead_tup,
round(current_setting('autovacuum_vacuum_threshold')::integer +
current_setting('autovacuum_vacuum_scale_factor')::numeric * c.reltuples
) AS boundary,
pg_stat_get_autovacuum_count(c.oid) AS av_cnt,
now() - pg_stat_get_last_autovacuum_time(c.oid) AS since_last_av
FROM pg_class c
LEFT JOIN pg_namespace n ON (n.oid = c.relnamespace)
WHERE c.relkind = 'r'
AND n.nspname NOT IN ('pg_catalog', 'information_schema')
) AS av
ORDER BY av_need, dead_tup DESC;
relation | reltuples | live_tup | dead_tup | boundary | av_cnt | since_last_av | av_need | dead_ratio
------------------+--------------+----------+----------+----------+--------+-----------------+---------+------------
pgbench_accounts | 1.998889e+06 | 1998889 | 161911 | 399828 | 0 | | f | 8
pgbench_history | 957729 | 973640 | 0 | 191596 | 114 | 01:02:37.853934 | f | 0
pgbench_tellers | 200 | 200 | 1361 | 90 | 2849 | 00:00:36.65028 | t | 680
pgbench_branches | 20 | 20 | 1160 | 54 | 2849 | 00:00:36.660004 | t | 5800
```
По результатам запроса можно сделать несколько наблюдений:
- есть две таблицы (`pgbench_tellers` и `pgbench_branches`), которым требуется очистка: количество мертвых версий в них существенно превышает допустимое значение, о чем говорит признак `av_need = t`;
- значения `av_cnt` и `since_last_av` показывают, что две эти таблицы регулярно очищаются, но при сложившейся рабочей нагрузке до следующего запуска очистки в таблицах успевает накопиться большое количество мертвых версий (см. `dead_ratio`);
- для оценки значения `since_last_av` важно знать значение параметра *autovacuum\_naptime*[^mon-200-1] (по умолчанию одна минута). Этот параметр определяет интервал, с которым процесс autovacuum launcher отправляет сигнал на запуск рабочих процессов очистки в каждую базу данных. В выводе запроса есть две таблицы с признаком необходимости очистки. Значения `since_last_av` для этих двух таблиц укладываются в минуту: это значит, что таблицы хоть и должны быть обработаны, но задержки при этом нет. И наоборот, если бы при наличии признака очистки значение `since_last_av` превышало значение *autovacuum\_naptime*, это указывало бы на то, что очистка опаздывает;
- есть таблица с большим количеством строк, которая при этом ни разу не подвергалась обработке (`pgbench_accounts`), поскольку объем мертвых строк ни разу не достигал порогового значения.
Можно сделать вывод: в тестовом окружении не так много таблиц, и автоочистка справляется со своей работой.
Дополнительно стоит отметить, как вычисляется допустимое значение (`boundary`). За основу берутся общие параметры конфигурации, однако СУБД предоставляет возможность указывать эти параметры индивидуально для отдельных таблиц с помощью так называемых параметров хранения (storage parameter)[^mon-201-1]. Они имеют приоритет перед общими параметрами конфигурации, и их следует учитывать при расчете порогового значения. В тестовом окружении у таблиц нет явно определенных параметров хранения, поэтому запрос их не учитывает.
### Статистика выполнения очистки {#mon-section-star-150}
В ранее рассмотренном запросе была использована функция `pg_stat_get_autovacuum_count`, которая возвращает количество обработок таблицы автоочисткой. Эта и еще несколько похожих функций используются в представлении `pg_stat_all_tables`, на котором также основаны представления `pg_stat_user_tables` и `pg_stat_sys_tables`. На основе этих функций в представлениях отображаются несколько полей, указывающих на работу как автоматической, так и ручной очистки:
- `last_vacuum` — время, когда таблица в последний раз очищалась командой `VACUUM`;
- `last_autovacuum` — время, когда таблица в последний раз была обработана автоочисткой;
- `vacuum_count` — общее количество обработок таблицы командой `VACUUM`;
- `autovacuum_count` — общее количество обработок таблицы автоочисткой.
> [!NOTE]
> **Сбор статистики для планировщика**
>
> Набор похожих полей есть и для операций сбора статистики планировщика. Сбор статистики может выполняться либо с помощью вызова команды `ANALYZE`, либо как дополнительная операция при вызове команды `VACUUM` (с указанием параметра `ANALYZE`), либо рабочим процессом автоочистки.
Следующий запрос позволяет отслеживать регулярность очистки:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7"}
# SELECT
schemaname ||'.'|| relname AS relation,
vacuum_count AS vacuum,
now() - last_vacuum AS since_last_vacuum,
autovacuum_count AS autovacuum,
now() - last_autovacuum AS since_last_autovacuum
FROM pg_stat_user_tables;
relation | vacuum | since_last_vacuum | autovacuum | since_last_autovacuum
-------------------------+--------+-------------------+------------+-----------------------
public.pgbench_tellers | 5 | 07:54:41.804464 | 2869 | 00:00:29.026952
public.pgbench_branches | 5 | 07:54:41.805567 | 2869 | 00:00:29.035908
public.pgbench_history | 0 | | 114 | 01:22:30.721539
public.pgbench_accounts | 0 | | 0 |
```
В выводе запроса отражена статистика и по ручным, и по автоматическим очисткам. Основная работа по очистке выполняется автоочисткой, и изредка выполняется команда `VACUUM` (специфика рабочей нагрузки).
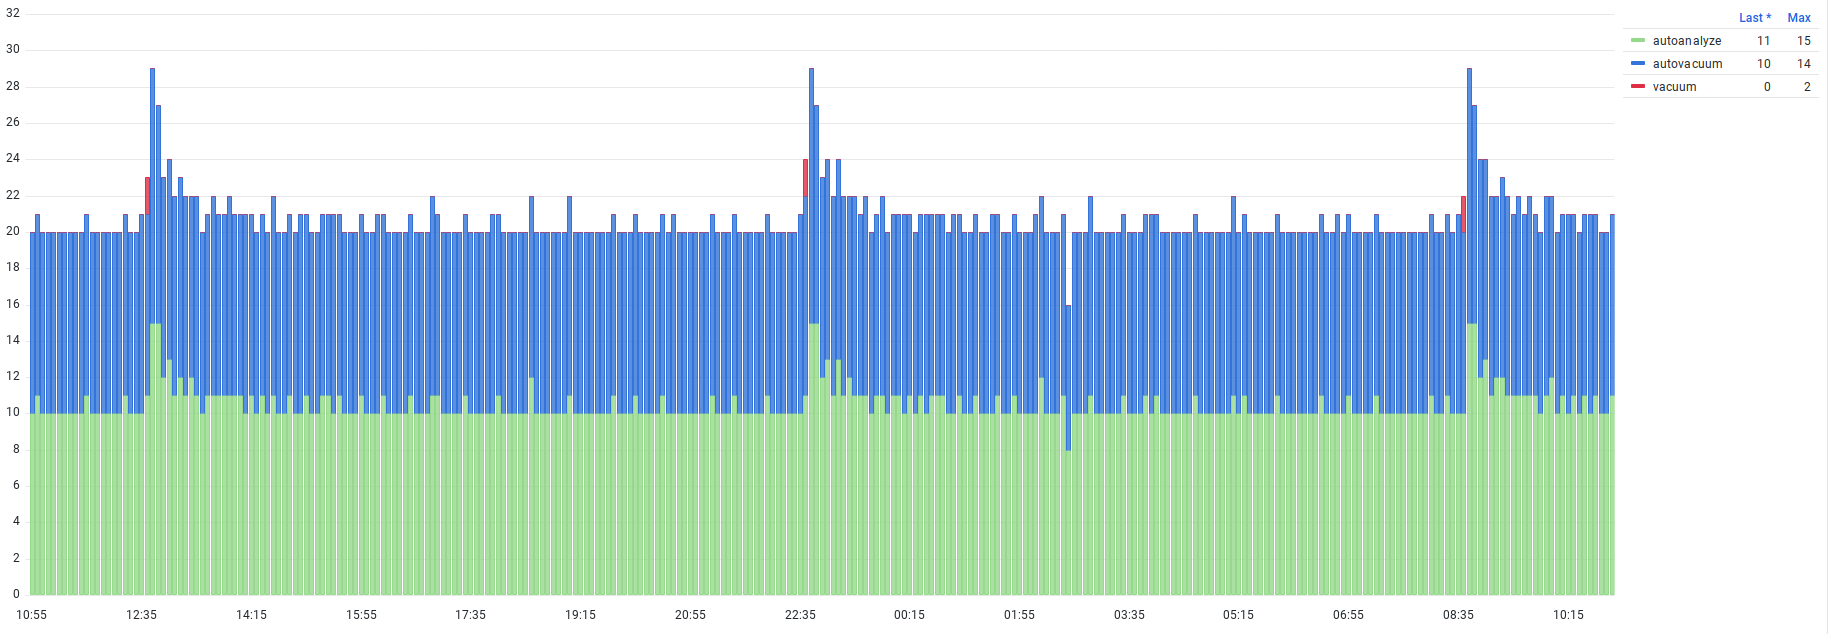
Собрав статистику выполнения операций очистки со всех БД, можно получить общую картину по всему экземпляру и вывести ее в мониторинг (рис. [8.1](/ru/08-vacuum/#mon-figure-caption-151)):
{#fig-8.1 num="8.1" caption="Частота выполнения операций очистки и анализа" width=1828 height=634}
График на рис. [8.1](/ru/08-vacuum/#mon-figure-caption-151) показывает количество операций очистки и анализа, выполненных в течение пяти минут. За показанные сутки количество операций держится на одном уровне без больших колебаний, однако можно заметить некоторую цикличность с интервалом 10 часов. В случае корректировок настроек автоочистки такой график помогает понять, как сделанные изменения отразились на ее работе. Значительные изменения в рабочей нагрузке, особенно связанные с объемом записи, также могут повлиять на частоту выполнения служебных операций, и последствия этих изменений также будут заметны на графике.
## 8.3. Счетчик транзакций и предотвращение ошибок, связанных с его зацикливанием {#mon-section-8-3}
У каждой транзакции, будь это даже одиночная команда, есть уникальный идентификатор. Это может быть виртуальный идентификатор транзакции (virtualxid), а если транзакция вносит изменения, ей присваивается постоянный 32-битный идентификатор (transaction id, xid, или txid). При выполнении команд на изменение данных (вставка, обновление, удаление) в версиях строк в служебных полях `xmin` и `xmax`[^mon-203-1] записываются идентификаторы транзакций: в `xmin` — создавшей строку, а в `xmax` — удалившей строку. Правила видимости строк опираются на эту информацию. Например, версия строки, созданная только что зафиксированной транзакцией, не попадет в уже начавшуюся выборку благодаря тому, что `xmin` этой версии будет превышать максимально видимый в выборке номер[^mon-203-2].
При постоянной нагрузке СУБД выделяет все новые и новые идентификаторы транзакций. Их диапазон ограничен 32 битами и соответствует значениям от 0 до \(2^{32-1}\) (около 4,2 миллиарда). Получается, что в какой-то момент диапазон номеров может израсходоваться и счетчик транзакций должен будет начать отсчет с нуля. Но в таком случае все строки прошлых транзакций оказались бы в будущем — ведь их идентификаторы превысили бы текущее значение счетчика. Это привело бы к внезапной потере всех данных, которые, физически оставаясь в страницах, перестали бы удовлетворять правилам видимости и стали бы недоступными. Чтобы исключить такое поведение, диапазон идентификаторов зациклен и образует круг, разделенный на две части: для любого идентификатора следующие два миллиарда идентификаторов считаются «старше» его и находятся в будущем, а предыдущие два миллиарда — «младше» и находятся в прошлом. Строка, созданная в какой-либо транзакции, для последующих двух миллиардов транзакций находится в прошлом, но, если ничего не предпринять, для следующих транзакций окажется в будущем. Поэтому еще до того, как будет достигнута граница в два миллиарда, СУБД находит такие старые строки и ставит на них признак *заморозки*. По правилам видимости замороженные (frozen) строки считаются настолько старыми, что уже нет необходимости проверять их значение `xmin`. Такие строки являются безусловно видимыми — до тех пор, пока строка не будет обновлена или удалена, что приведет к установке значения `xmax`.
> [!NOTE]
> **FrozenTransactionId**
>
> В версиях PostgreSQL до 9.4 заморозка строк реализована заменой `xmin` строки на служебный идентификатор `FrozenTransactionId` (равный двум). В последующих версиях признак заморозки устанавливается как битовый флаг в другое служебное поле, а `xmin` строки сохраняется.
Необходимость заморозки отдельно взятой строки определяется возрастом транзакции с идентификатором `xmin`. Возраст транзакции определяется количеством транзакций, начатых в системе после данной, до текущего момента. Выполнять заморозку строк с малым возрастом может быть невыгодно, поскольку строка может измениться и выполненная работа пропадет даром. Откладывать заморозку надолго тоже нельзя: при интенсивной рабочей нагрузке может скопиться большое количество незамороженных строк и их обработка потребует значительных ресурсов и времени. Заморозка обычно выполняется автоматически рабочими процессами очистки (но может быть выполнена и в ручном режиме командой `VACUUM FREEZE`), и, следовательно, для своевременной заморозки автоочистка также должна запускаться своевременно и без задержек. В зависимости от конфигурации СУБД или рабочей нагрузки могут возникать ситуации, которые откладывают работу автоочистки или даже мешают ей. Игнорирование таких ситуаций в течение продолжительного времени может привести к снижению производительности, а в худшем случае — к аварийной остановке СУБД. В качестве примеров того, что может откладывать очистку, можно привести:
- выключенную автоочистку (*autovacuum* `= off`) как на уровне общей конфигурации, так и на уровне отдельных таблиц с помощью параметров хранения;
- продолжительные транзакции (это наиболее частая причина, по которой автоочистка откладывает удаление устаревших версий строк);
- забытые незавершенные подготовленные (prepared) транзакции;
- длительные выгрузки данных с помощью pg\_dump или команды `COPY`, которые также используют механизм транзакций;
- регулярные DDL-операции, которые могут отменять автоочистку, из-за чего часть работы откладывается на потом;
- неактивные слоты репликации.
При нормальной эксплуатации автоочистка всегда должна быть включена, а в рабочей нагрузке не должно возникать продолжительных или бездействующих операций.
**Горизонт заморозки.** Каждая таблица имеет атрибут `pg_class.relfrozenxid`, который содержит идентификатор транзакции, создавшей самую позднюю из незамороженных версий строк этой таблицы. Возраст транзакции `relfrozenxid` является так называемым *горизонтом заморозки отдельной таблицы* — все версии строк с более старшими идентификаторами уже гарантированно заморожены. С помощью таблицы `pg_class` можно как получить само значение `relfrozenxid`, так и вычислить горизонт заморозки (поле `horizon`):
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10"}
# SELECT relname, relfrozenxid, age(relfrozenxid) AS horizon,
pg_stat_get_autovacuum_count(c.oid) +
pg_stat_get_vacuum_count(c.oid) AS maint_count,
now() - coalesce(
pg_stat_get_last_autovacuum_time(c.oid),
pg_stat_get_last_vacuum_time(c.oid)
) AS since_last_maint
FROM pg_class c
WHERE c.relkind = 'r' AND c.relname ~'pgbench'
ORDER BY age(relfrozenxid) DESC;
```
```text {label="text"}
relname | relfrozenxid | horizon | maint_count | since_last_maint
------------------+--------------+-----------+-------------+------------------
pgbench_accounts | 3065607 | 193389917 | 0 |
pgbench_history | 186844463 | 9611061 | 88 | 00:01:58.716975
pgbench_tellers | 194117385 | 2338139 | 1309 | 00:00:58.733513
pgbench_branches | 195212688 | 1242836 | 1277 | 00:00:58.741392
```
Диапазон идентификаторов транзакций в пределах горизонта заморозки определяет количество тех идентификаторов, которые еще не могут быть повторно использованы для будущих транзакций из-за оставшихся незамороженными версий строк. В таблицах, для которых регулярно выполняется очистка, происходят и своевременная заморозка строк, и обслуживание горизонта, то есть продвижение вперед значения `relfrozenxid`. Вывод запроса показывает, что для трех таблиц регулярно выполняются очистка и продвижение `relfrozenxid`, а для `pgbench_accounts` очистка ни разу не выполнялась, поэтому `relfrozenxid` постепенно уходит в прошлое и горизонт заморозки растет.
> [!NOTE]
> **Атрибут** `relminmxid` **и мультитранзакции**
>
> Помимо `relfrozenxid` у таблиц есть схожий атрибут `relminmxid`, который указывает на самый старый задействованный идентификатор мультитранзакции в этой таблице. Мультитранзакции представляют собой группы обычных транзакций, которым потребовалась одновременная разделяемая блокировка одной строки. Такие транзакции также имеют 32-битные идентификаторы, которые записываются в поле `xmax` версий строк, и для них также требуются аналог заморозки и продвижение `relminmxid`. Ниже при упоминании `relfrozenxid` соответствующий контекст можно распространить и на мультитранзакции, хоть это и не будет упоминаться явно.
При очистке СУБД оценивает горизонт заморозки и выбирает подходящий режим работы. В обычном режиме очистка замораживает версии строк, возраст `xmin` которых превышает значение *vacuum\_freeze\_min\_age* (по умолчанию 50 млн). Если горизонт заморозки таблицы превышает значение *vacuum\_freeze\_table\_age* (по умолчанию 150 млн), очистка выполняется в агрессивном режиме с полным сканированием всех страниц, чтобы заморозить версии строк и на тех страницах, которые в обычном режиме пропускаются из-за карты видимости. Если же возраст горизонта заморозки таблицы превышает значение *autovacuum\_freeze\_max\_age* (по умолчанию 200 млн), то очистка с заморозкой запускается принудительно, даже когда таблица не требует очистки или автоочистка выключена (глобально параметром *autovacuum* или параметрами хранения для отдельных таблиц). Это в том числе гарантирует, что версии строк будут заморожены в таблицах, строки в которых не меняются, например в архивных секциях.
Как отмечено выше, в нашем примере есть одна таблица, `pgbench_accounts`, которая ни разу не очищалась и горизонт заморозки которой больше остальных. Для эксперимента можно выполнить очистку с принудительной заморозкой (`VACUUM FREEZE`), после которой значение `relfrozenxid` продвинется вперед, а горизонт уменьшится.
```text {label="text"}
relname | relfrozenxid | horizon | maint_count | since_last_maint
------------------+--------------+---------+-------------+------------------
pgbench_accounts | 196461352 | 1059 | 1 | 00:00:33.415394
pgbench_branches | 196461367 | 1044 | 1281 | 00:01:18.82579
pgbench_history | 196461367 | 1044 | 91 | 00:01:18.803942
pgbench_tellers | 196461398 | 1013 | 1314 | 00:00:18.804065
```
Если рассматривать все таблицы в отдельной базе данных, то их значения `relfrozenxid`, как правило, различаются; среди всех таблиц найдется таблица с самым большим горизонтом (самым старым значением `relfrozenxid`). Горизонт заморозки этой таблицы определяет *горизонт заморозки базы данных* и хранится в `pg_database.datfrozenxid` — все версии строк с более старыми идентификаторами в любой таблице этой базы данных гарантированно заморожены. Самое старое значение `pg_database.datfrozenxid` в кластере баз данных определяет *горизонт заморозки всего кластера*. Продвижение вперед этого горизонта позволяет высвободить идентификаторы транзакций для их повторного использования.
```text {label="psql" .source-commands hl_lines="1"}
# SELECT datname, datfrozenxid, age(datfrozenxid) AS horizon FROM pg_database;
datname | datfrozenxid | horizon
-----------+--------------+-----------
postgres | 717 | 196462899
pgbench | 196461352 | 2264
template1 | 717 | 196462899
template0 | 717 | 196462899
```
Значение `datfrozenxid` продвинуто только у базы `pgbench` (для нее недавно была выполнена очистка с заморозкой). В остальных базах значение сохранилось еще со времен инициализации кластера: в них нет никакой активности, нет необходимости выполнять очистку, следовательно, и заморозка в них не происходит. Но, как только горизонты заморозки этих баз превысят значение *autovacuum\_freeze\_max\_age* (по умолчанию 200 млн), в них будет запущена принудительная очистка с заморозкой. Осталось ждать не так долго. Очистка скоро выполнится, и запрос покажет продвижение `datfrozenxid` и уменьшение горизонта:
```text {label="text"}
datname | datfrozenxid | horizon
-----------+--------------+-----------
postgres | 717 | 200000467
pgbench | 196461352 | 3539832
template1 | 717 | 200000467
template0 | 717 | 200000467
```
```text {label="text"}
datname | datfrozenxid | horizon
-----------+--------------+-----------
postgres | 200001187 | 79
pgbench | 196461352 | 3539914
template1 | 200001187 | 79
template0 | 200001187 | 79
```
Для базы `pgbench` все осталось как прежде, поскольку в ней заморозка была выполнена недавно и повторная пока не требуется.
**Запас идентификаторов транзакций.** При нормальной эксплуатации предполагается, что очистка и заморозка выполняются своевременно: идентификаторы `datfrozenxid` продвигаются вперед, и у СУБД есть большой запас идентификаторов для будущих транзакций. В реальности в рабочей нагрузке могут возникать аномалии, из-за которых очистка (и заморозка) может откладываться. Как правило, наиболее частой причиной пропуска строк при очистке являются долгие транзакции: они удерживают горизонт видимости других транзакций, что исключает очистку строк в пределах этого горизонта. В худшем случае, когда начнет откладываться заморозка, начнет исчерпываться и запас идентификаторов. Поэтому очень важно отслеживать продолжительность транзакций, устранять источники появления долгих транзакций и использовать тайм-ауты для их принудительного завершения.
С точки зрения мониторинга нас интересует запас доступных идентификаторов транзакций. Его можно вычислить либо на основе горизонта заморозки кластера с помощью поля `pg_database.datfrozenxid`, либо на основе горизонта видимости базы данных, который определяется наибольшим горизонтом видимости среди активных транзакций в этой базе — строки за горизонтом видимости уже не нужны ни одной из активных транзакций и в будущем могут быть заморожены (или изменены, что повлечет изменение `xmax`). Второй способ дает более оптимистичную оценку, поскольку в запас идентификаторов включается диапазон между горизонтом видимости базы данных и горизонтом заморозки кластера, а этот диапазон может быть очень большим и включать в себя несколько десятков миллионов идентификаторов. В поисках наибольшего горизонта видимости среди активных транзакций нам могут помочь следующие поля:
- `pg_stat_activity.backend_xid` — идентификатор транзакции, выданный сеансу;
- `pg_prepared_xacts.transaction` — идентификатор подготовленной транзакции;
- `pg_replication_slots.xmin` — идентификатор транзакции, определяющий горизонт видимости, удерживаемый данным слотом;
Первые два поля указывают на активные транзакции, выполняющиеся на текущем узле. Если используются реплики и включена обратная связь (*hot\_standby\_feedback* `= on`), оставшееся поле определяет горизонт, удерживаемый транзакциями на реплике с помощью слота репликации. Если репликация не использует слот, эта же информация будет доступна в поле `pg_stat_activity.backend_xid` соответствующего процесса walsender. С помощью обратной связи администратор может отслеживать долгую активность на репликах со стороны основного узла, но при этом обратная связь откладывает работу очистки, приводя ко всем сопутствующим негативным последствиям. Поэтому решение об использовании обратной связи должно приниматься взвешенно.
Давайте рассмотрим оба способа вычисления запаса идентификаторов транзакций.
Первый способ заключается в использовании горизонта заморозки кластера на основе полей `datfrozenxid` и `datminmxid`: возраст старшего из этих идентификаторов нужно вычесть из половины всего доступного диапазона идентификаторов (двух миллиардов).
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11"}
# SELECT
max_horizon,
2147483647 - max_horizon AS available_xids
FROM
(
SELECT greatest(
max(age(datfrozenxid)),
max(mxid_age(datminmxid))
) AS max_horizon
FROM pg_database
) AS d;
max_horizon | available_xids
-------------+----------------
3547151 | 2143936496
```
В приведенном выводе горизонт достиг 3,5 млн и имеется очень большой запас идентификаторов (поле `available_xids`), превышающий два миллиарда.
Второй способ определения запаса идентификаторов опирается на вычисление горизонта видимости базы данных. В этом случае нужно проверить все источники активности, найти самый долгий, вычислить его возраст и, как и в первом способе, вычесть из половины всего доступного диапазона идентификаторов. Дополнительно можно вывести и идентификатор транзакции, которая удерживает горизонт видимости:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16"}
# SELECT pid, src, age AS active_horizon,
2147483647 - coalesce(age, 0) AS available_xids
FROM
(
SELECT pid, 'pg_stat_activity', age(backend_xid)
FROM pg_stat_activity WHERE pid != pg_backend_pid()
UNION
SELECT NULL, 'pg_prepared_xacts', age(transaction)
FROM pg_prepared_xacts
UNION
SELECT active_pid, 'pg_replication_slots',
greatest(age(xmin), age(catalog_xmin))
FROM pg_replication_slots
) AS x(pid, src, age)
WHERE age IS NOT NULL
ORDER BY age DESC LIMIT 1;
pid | src | active_horizon | available_xids
--------+------------------+----------------+-----------------
35643 | pg_stat_activity | 1 | 2147483646
```
В нормальной ситуации вывод запроса будет пустой, однако если использовать `\watch` с коротким интервалом (например, одна десятая секунды), то можно будет увидеть, как быстро появляются и быстро исчезают строки с очень коротким горизонтом — например, как в выводе выше. В данном примере горизонт равен единице: в тестовом окружении нет долгих транзакций, которые бы надолго удерживали горизонт видимости.
Однако можно открыть еще один сеанс, обновить в новой транзакции произвольную строку в `pgbench_accounts` и некоторое время просто не завершать начатую транзакцию:
```text {label="text" .source-commands hl_lines="1 2"}
# BEGIN;
# UPDATE pgbench_accounts SET abalance = abalance + 1 WHERE aid = 1;
```
Теперь, если повторить запрос еще несколько раз, будет видно, что картина изменилась:
```text {label="text"}
pid | src | active_horizon | available_xids
--------+------------------+----------------+-----------------
35705 | pg_stat_activity | 295 | 2147483352
```
```text {label="text"}
pid | src | active_horizon | available_xids
--------+------------------+----------------+-----------------
35705 | pg_stat_activity | 648 | 2147482999
```
```text {label="text"}
pid | src | active_horizon | available_xids
--------+------------------+----------------+-----------------
35705 | pg_stat_activity | 990 | 2147482657
```
Из-за активности в базе данных счетчик транзакций увеличивается, а из-за открытой транзакции горизонт начал расти (идентификатор, определяющий снимок открытой транзакции, уходит в прошлое относительно номера текущей транзакции, в которой выполняется наш запрос). Количество доступных идентификаторов тоже начало уменьшаться, хотя это не так заметно. Самое главное — чем дольше транзакция во втором сеансе будет находиться в открытом состоянии, тем больше будет увеличиваться горизонт видимости, в пределах которого автоочистка не сможет удалять устаревшие версии строк (что будет приводить к раздуванию) и замораживать старые версии строк (что со временем может привести к реальному уменьшению количества доступных идентификаторов). После фиксации или отката транзакции горизонт снова уменьшится до нуля.
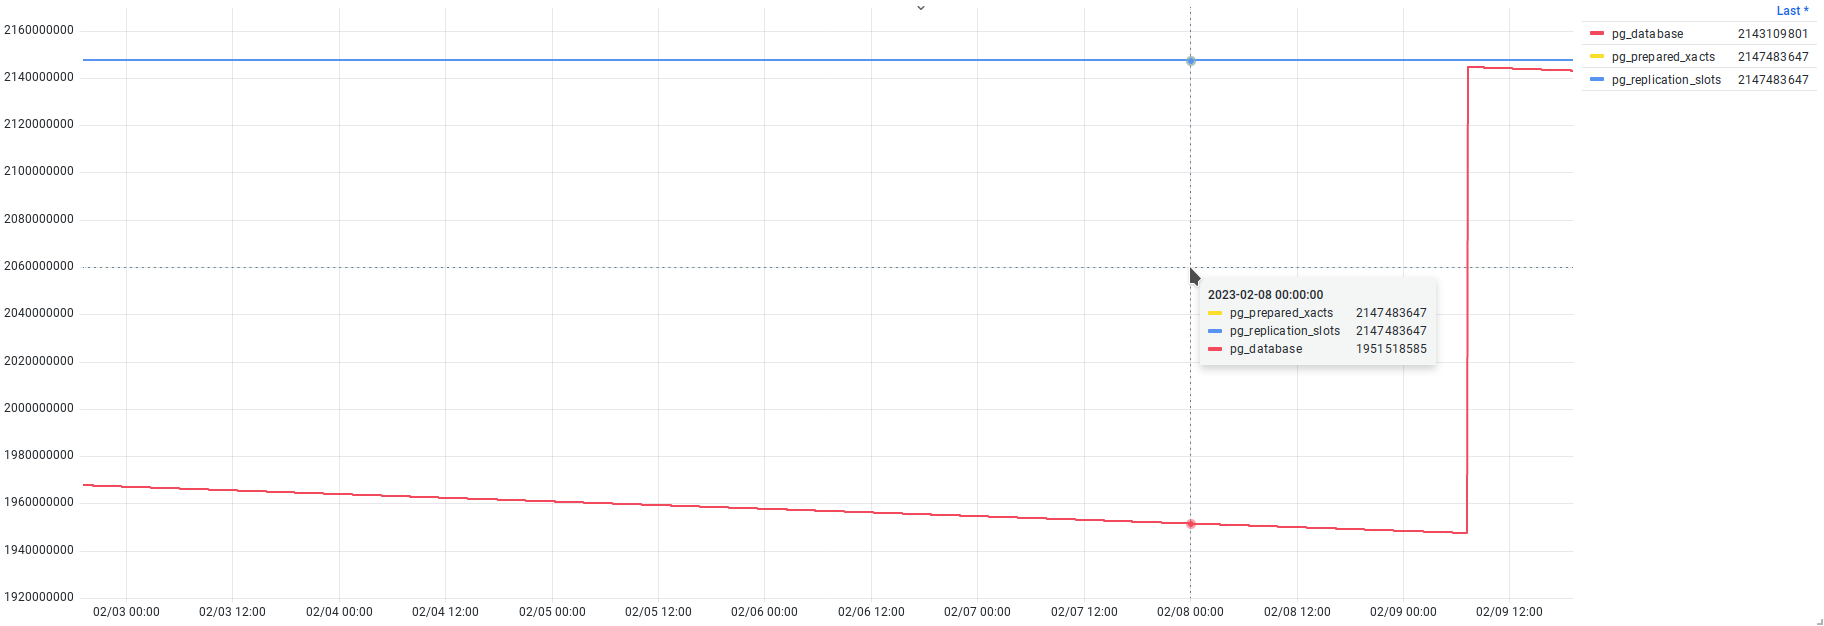
Независимо от того, какой способ вычисления запаса идентификаторов используется, в целях мониторинга его удобно выводить в виде графика. На рис. [8.2](/ru/08-vacuum/#mon-figure-caption-154) показана ситуация, когда возраст `datfrozenxid` одной из баз превысил значение *autovacuum\_freeze\_max\_age*, в результате чего была выполнена принудительная автоочистка с заморозкой. Для большей наглядности взят интервал в несколько дней, поскольку в тестовом окружении запас идентификаторов уменьшается относительно медленно. После выполнения заморозки горизонт уменьшился, а запас идентификаторов, соответственно, увеличился. В производственных средах с большим объемом транзакционной активности такое продвижение горизонта происходит регулярно и довольно часто.
**Предотвращение зацикливания.** В дополнение к механизму заморозки в СУБД встроены различные проверки, задача которых — уведомлять администратора СУБД об опасном увеличении горизонта заморозки и исключить ошибки, связанные с зацикливанием счетчика транзакций. Как только принудительная очистка не сможет нормально выполнять свою работу,
{#fig-8.2 num="8.2" caption="Количество доступных идентификаторов" width=1824 height=626}
в журнале сообщений начнут появляться уведомления о том, что самый старый используемый идентификатор транзакции находится далеко в прошлом:
```text {label="text"}
WARNING: oldest xmin is far in the past
HINT: Close open transactions soon to avoid wraparound problems.
You might also need to commit or roll back old prepared transactions,
or drop stale replication slots.
```
В качестве подсказки СУБД предлагает закрыть открытые транзакции, подтвердить или откатить старые подготовленные транзакции или удалить неактивные слоты репликации. При дальнейшем ухудшении ситуации очистка начинает выполняться в особом режиме (failsafe), при котором для ускорения заморозки пропускается обработка индексов. Этот режим включается при превышении возрастом `relfrozenxid` значения *vacuum\_failsafe\_age*:
```text {label="psql"}
WARNING: bypassing nonessential maintenance of table "postgres.pg_catalog.
pg_statistic" as a failsafe after 0 index scans
DETAIL: The table's relfrozenxid or relminmxid is too far in the past.
HINT: Consider increasing configuration parameter "maintenance_work_mem" or
"autovacuum_work_mem". You might also need to consider other ways for
VACUUM to keep up with the allocation of transaction IDs.
```
Если продолжать игнорировать сообщения, СУБД будет более прямолинейна и начнет сообщать о том, что вполне конкретные базы данных должны быть обработаны очисткой:
```text {label="psql"}
WARNING: database "postgres" must be vacuumed within 5715164 transactions
HINT: To avoid a database shutdown, execute a database-wide VACUUM in that
database. You might also need to commit or roll back old prepared
transactions, or drop stale replication slots.
```
Примерно за три миллиона транзакций до исчерпания идентификаторов СУБД переходит в режим только чтения. Любая попытка выполнить запись или изменение данных завершится ошибкой.
```text {label="text"}
ERROR: database is not accepting commands to avoid wraparound data loss in
database "postgres"
HINT: Stop the postmaster and vacuum that database in single-user mode.
You might also need to commit or roll back old prepared transactions, or
drop stale replication slots.
```
Такая ситуация расценивается как опасная и переход СУБД в аварийный режим исключает возможность продолжить работу и повредить данные. Для восстановления и продолжения нормальной работы администратору придется перезапустить СУБД в особом, однопользовательском режиме (single-user mode), выполнить очистку в тех БД, где это необходимо, после чего перезапустить СУБД в обычном режиме.
## 8.4. Раздувание таблиц и индексов {#mon-section-8-4}
Устаревшие версии строк появляются в результате операций обновления или удаления. При нормальной работе занимаемое такими версиями место оперативно освобождается очисткой и используется для вставки новых версий. Однако если устаревших версий накопилось слишком много и автоочистка долгое время не имела возможности вычищать их, то после очистки в файлах таблицы и индексов образуются большие свободные участки, которые, возможно, не израсходуются в дальнейшем и будут просто занимать место на диске. В результате дисковое пространство используется неэффективно. Стоит отдельно отметить, что это относится к «пустотам», находящимся в начале или середине файла: если очистка освобождает место в конце файла, она может попытаться сделать усечение файла.
При продолжительной эксплуатации СУБД таких пустот в таблицах и индексах может образовываться все больше и больше, и происходит так называемое раздувание. Если сложить все эти пустоты вместе, может получиться внушительная цифра. С точки зрения эксплуатации необходимо регулярно проверять таблицы и индексы на предмет раздувания, выполнять их обслуживание и высвобождать неиспользуемое пространство.
Для поиска раздутых объектов наиболее эффективным и точным средством оценки является расширение `pgstattuple`[^mon-211-1]. Однако ценой точности являются большие накладные расходы: расширение читает каждую страницу проверяемого объекта, что требует соответствующего ввода-вывода и нагружает дисковую подсистему. Учитывая, что СУБД не имеет встроенных механизмов ограничения пропускной способности, такая «проверка» может значительно загрузить подсистему хранения и существенно повлиять на производительность конкурентно выполняющихся запросов. Поэтому регулярное и частое использование `pgstattuple`, например в агентах сбора телеметрии, может быть нежелательно; рекомендуется использовать `pgstattuple` только при необходимости.
Есть и другие, эвристические способы оценки с использованием данных из системного каталога, учитывающие общее количество строк, их ширину и другие особенности хранения, но, как правило, такие способы менее точны и могут давать значительные отклонения. Выбор инструмента всегда остается за администратором и должен основываться на условиях эксплуатации. Примеры таких запросов можно найти в соответствующем разделе PostgreSQL Wiki[^mon-212-1].
В целях ознакомления расширение `pgstattuple` установлено в тестовом окружении и с его помощью мы оценим раздувание двух таблиц: `pgbench_accounts` и маленькой `pgbench_branches`.
```text {label="psql" .source-commands hl_lines="1"}
# SELECT * FROM pgstattuple('pgbench_accounts');
-[ RECORD 1 ]------+----------------------------
table_len | 294264832
tuple_count | 2000000
tuple_len | 242000000
tuple_percent | 82.24
dead_tuple_count | 80131
dead_tuple_len | 9695851
dead_tuple_percent | 3.29
free_space | 10538908
free_percent | 3.58
```
```text {label="psql" .source-commands hl_lines="1"}
# SELECT * FROM pgstattuple('pgbench_branches');
-[ RECORD 1 ]------+----------------------------
table_len | 311296
tuple_count | 21
tuple_len | 672
tuple_percent | 0.22
dead_tuple_count | 959
dead_tuple_len | 30688
dead_tuple_percent | 9.86
free_space | 274084
free_percent | 88.05
```
Время выполнения запроса зависит от размера таблицы, так как необходимо прочитать каждый ее блок, поэтому оценка `pgbench_accounts` выполнялась дольше, чем оценка `pgbench_branches`. В результате анализа таблиц доступна следующая информация, по которой можно оценить раздувание:
- `table_len` — размер объекта (таблицы или индекса) в байтах;
- `tuple_count` — общее количество живых версий строк;
- `tuple_len` — общий размер живых версий строк в байтах;
- `tuple_percent` — процент живых версий строк от общего числа всех версий;
- `dead_tuple_count` — общее количество мертвых версий строк;
- `dead_tuple_len` — общий размер мертвых версий строк в байтах;
- `dead_tuple_percent` — процент мертвых версий строк от общего числа всех версий;
- `free_space` — общий размер в байтах свободного пространства внутри файлов таблицы, за счет которого раздулась таблица. Это пространство появляется как результат очистки от мертвых версий строк и доступно для повторного использования только в этой таблице;
- `free_percent` — доля свободного пространства от общего размера объекта — то же самое раздутие, выраженное в процентах.
Наиболее интересными полями являются `free_space` и `free_percent`, поскольку прямо указывают объемы пустого пространства. Если сравнить статистику обеих таблиц, можно отметить, что таблица `pgbench_accounts` подвержена раздуванию гораздо меньше, чем `pgbench_branches`, 3,5 % против 88 %, но таблица `pgbench_branches` занимает всего 311 КБ. При высвобождении свободного места выигрыш может быть небольшим, однако если с этой таблицей связан значительный ввод-вывод, то можно существенно сократить накладные расходы.
В продолжение нашего примера выполним команду полной очистки `VACUUM FULL` для таблицы `pgbench_branches`. Это хоть и блокирующая операция, но выполнится она мгновенно, поскольку целевая таблица небольшая и содержит всего 20 строк. После операции полной очистки снова посмотрим статистику `pgstattuple`:
```text {label="psql" .source-commands hl_lines="1 2"}
# VACUUM FULL pgbench_branches;
# SELECT * FROM pgstattuple('pgbench_branches');
-[ RECORD 1 ]------+----------------------------
table_len | 8192
tuple_count | 20
tuple_len | 640
tuple_percent | 7.81
dead_tuple_count | 88
dead_tuple_len | 2816
dead_tuple_percent | 34.38
free_space | 4276
free_percent | 52.2
```
Высвободилось практически все свободное место, а таблица стала умещаться в одну страницу размером 8 КБ. Однако это всего лишь небольшая таблица в тестовом окружении. В настоящих производственных окружениях значения и результаты будут совершенно иными.
На практике для высвобождения пространства используются различные инструменты. Для индексов подходит использование команды `REINDEX CONCURRENTLY`, которая в неблокирующем режиме создает новый индекс и затем подменяет им старый. Для обработки таблиц СУБД предлагает использовать команду `VACUUM FULL`, однако ее использование полностью блокирует доступ к таблице даже на чтение, что недопустимо в производственных окружениях. В качестве альтернативы можно использовать сторонние инструменты, предлагаемые сообществом, например `pg_repack`[^mon-214-1], `pgcompacttable`[^mon-214-2] и `pg_squeeze`[^mon-214-3]. Все они имеют различные реализацию и принципы работы, но общую цель — устранить раздувание и освободить пространство.
## 8.5. Отслеживание активных процессов очистки {#mon-section-8-5}
Продолжительность выполнения очистки может зависеть от разных причин: от параметров конфигурации, размеров таблицы, количества индексов и количества мертвых строк и т. п. При обработке таблиц и индексов очистка создает дополнительную нагрузку на подсистему хранения и может конкурировать за ресурсы ввода-вывода с другими процессами СУБД и влиять на их производительность. Администратору важно не только знать о ходе выполнения операций очистки, но и оценивать их влияние на систему и представлять, как используются ресурсы.
Для отслеживания активных процессов очистки в СУБД есть два инструмента:
- `pg_stat_activity` — основное представление для отслеживания всей активности в СУБД, которое показывает также и процессы очистки;
- `pg_stat_progress_vacuum` — представление, отображающее состояние и ход выполнения операций очистки (как ручных, так и автоматических).
Поскольку `pg_stat_activity` является представлением общего назначения и показывает активность всех процессов СУБД в некотором обобщенном виде, из него нельзя узнать особенности, характерные для конкретных процессов. Для отслеживания процессов очистки следует использовать представление `pg_stat_progress_vacuum`: оно содержит больше информации о работе именно очистки. Более того, оба представления можно объединить и получить максимум возможной информации.
### Представление pg\_stat\_activity {#mon-section-star-156}
Представление `pg_stat_activity` должно быть уже хорошо знакомо по предыдущим главам, поэтому не будем подробно рассматривать его, лишь перечислим интересующие нас поля:
- `pid` — идентификатор процесса, в рамках которого выполняется операция очистки;
- `backend_type` — по типу процесса можно отфильтровать только те строки, которые относятся к процессам автоочистки. Однако следует быть внимательным: по этому полю нельзя получить очистку, запущенную в обычном сеансе с помощью команды `VACUUM`: у таких процессов значение `backend_type` будет равно `client backend`, как и у всех прочих клиентских процессов;
- `datname` — имя базы данных, к которой выполнено подключение и в которой выполняется очистка;
- `xact_start` — время начала транзакции позволяет определить продолжительность выполнения очистки. Здесь тоже есть нюанс: очистка даже одной таблицы включает в себя выполнение нескольких транзакций, следовательно, отметка времени может меняться. Можно было бы использовать `backend_start`, но рабочий процесс автоочистки за время своего существования обрабатывает множество таблиц, и выделить время, затраченное на обработку одной конкретной, становится невозможным;
- `state` — состояние процесса;
- `wait_event`, `wait_event_type` — события ожидания могут быть полезны на случай, если очистка приостанавливается по какой-либо причине;
- `query` — текст запроса является определяющим и позволяет взять только те строки, которые относятся к процессам, выполняющим очистку, неважно, автоматическую или запущенную администратором в отдельном сеансе.
При необходимости можно добавить и другие поля. Используя фильтры на основе перечисленных полей, можно исключить все прочие процессы и выбрать только те, что выполняют очистку. С точки зрения постоянного мониторинга нас могут интересовать ответы на следующие вопросы:
- Сколько процессов очистки выполняется в данный момент? Это позволяет понять, не достигнуто ли ограничение количества рабочих процессов (заданное параметром *autovacuum\_max\_workers*). Если ограничение достигнуто и при этом есть необходимость в запуске дополнительных процессов автоматической очистки, это приведет к тому, что таблицы будут вынуждены ждать очереди на обработку, а мертвые строки будут продолжать накапливаться, увеличивая объем работы для очистки. Рост очереди сдвигает обработку и других таблиц, что постепенно приводит к раздуванию и увеличению размеров таблиц и индексов.
- Сколько времени длится очистка? В идеале, если позволяют ресурсы, очистка должна выполняться быстро. Наличие свободных рабочих процессов в распоряжении СУБД позволяет избегать появления очередей таблиц на обработку. Особенно опасной может считаться ситуация, характерная для «больших» баз данных со смешанной нагрузкой (HTAP, Hybrid Transactional/Analytical Processing). В таких базах могут встречаться как таблицы больших размеров, так и таблицы с большим объемом записи. Первые таблицы могут требовать заморозки, при которой таблица должна быть прочитана полностью, что может занять много времени, а изменения вторых будут постоянно сдвигать счетчик транзакций вперед.
При таком стечении обстоятельств (продолжительная очистка больших таблиц, активная запись и недостаток рабочих процессов очистки) СУБД не будет успевать выполнять обработку и сдвигать счетчик транзакций, что может привести к аварийному переходу в режим только чтения.
Для получения ответов на эти вопросы достаточно использования `pg_stat_activity`. В тестовом окружении довольно сложно поймать продолжительную очистку, поэтому для удобства демонстрации перепишем таблицу `pgbench_accounts`:
```text {label="text" .source-commands hl_lines="1"}
# UPDATE pgbench_accounts SET abalance = abalance + 1;
```
В соседнем сеансе с помощью `\watch 1` запустим выполнение запроса к `pg_stat_activity`. После выполнения запроса на обновление `pgbench_accounts` в течение минуты (поскольку *autovacuum\_naptime* `= 1min`) запустится рабочий процесс автоочистки, который будет «пойман» запросом к `pg_stat_activity`.
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10"}
# SELECT
pid,
datname,
now() - xact_start as duration,
state,
wait_event_type,
wait_event,
query
FROM pg_stat_activity
WHERE query ~'^autovacuum' OR query ~*'^vacuum';
-[ RECORD 1 ]------+----------------------------
pid | 2364758
datname | pgbench
duration | 00:00:10.04677
state | active
wait_event_type | Timeout
wait_event | VacuumDelay
query | autovacuum: VACUUM ANALYZE public.pgbench_accounts
```
В запросе используется условие на текст запроса, который должен начинаться с шаблонов, характерных для рабочих процессов автоочистки и очистки, запущенной в отдельном сеансе. Такой способ более удобен, чем условие на поле `backend_type`, не позволяющее выделить очистку в обычных сеансах. Одна строка в выводе запроса указывает на то, что запущен всего один рабочий процесс. Подсчитав количество строк функцией `count`, можно узнать, сколько рабочих процессов очистки запущено в конкретный момент. Это позволяет ответить на первый вопрос — о количестве выполняющихся процессов. Поле `duration` отображает продолжительность выполнения очистки, что дает ответ на второй вопрос — о длительности. Приведенная в запросе информация о состоянии и событиях ожиданий в мониторинг не собирается и чаще всего нужна только в случаях поиска и устранения проблем.
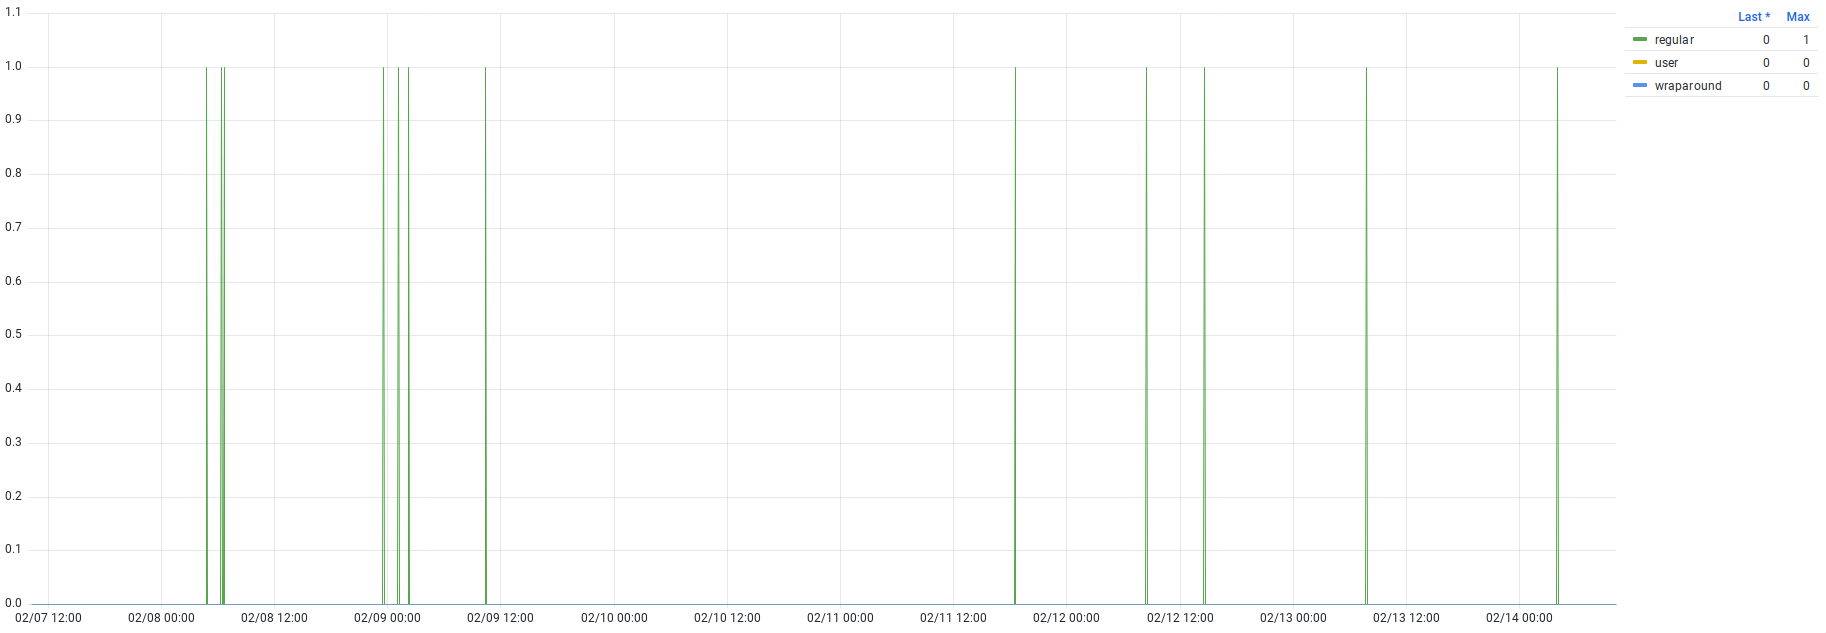
Полученные ответы можно отобразить в виде графиков. На рис. [8.3](/ru/08-vacuum/#mon-figure-caption-157) показан график количества процессов очистки. Возникает резонный вопрос: откуда такая разница между рисунком и реальным количеством очисток, выполняемых в таблицах `pgbench_branches` и `pgbench_tellers`? Ответ заключается в специфике представления `pg_stat_activity`, которое показывает текущий снимок и не носит накопительного характера: все то, что происходит между снимками, остается неизвестным. Для понимания количества очисток предпочтителен график на рис. [8.1](/ru/08-vacuum/#mon-figure-caption-151).
{#fig-8.3 num="8.3" caption="Количество процессов, выполняющих очистку" width=1826 height=633}
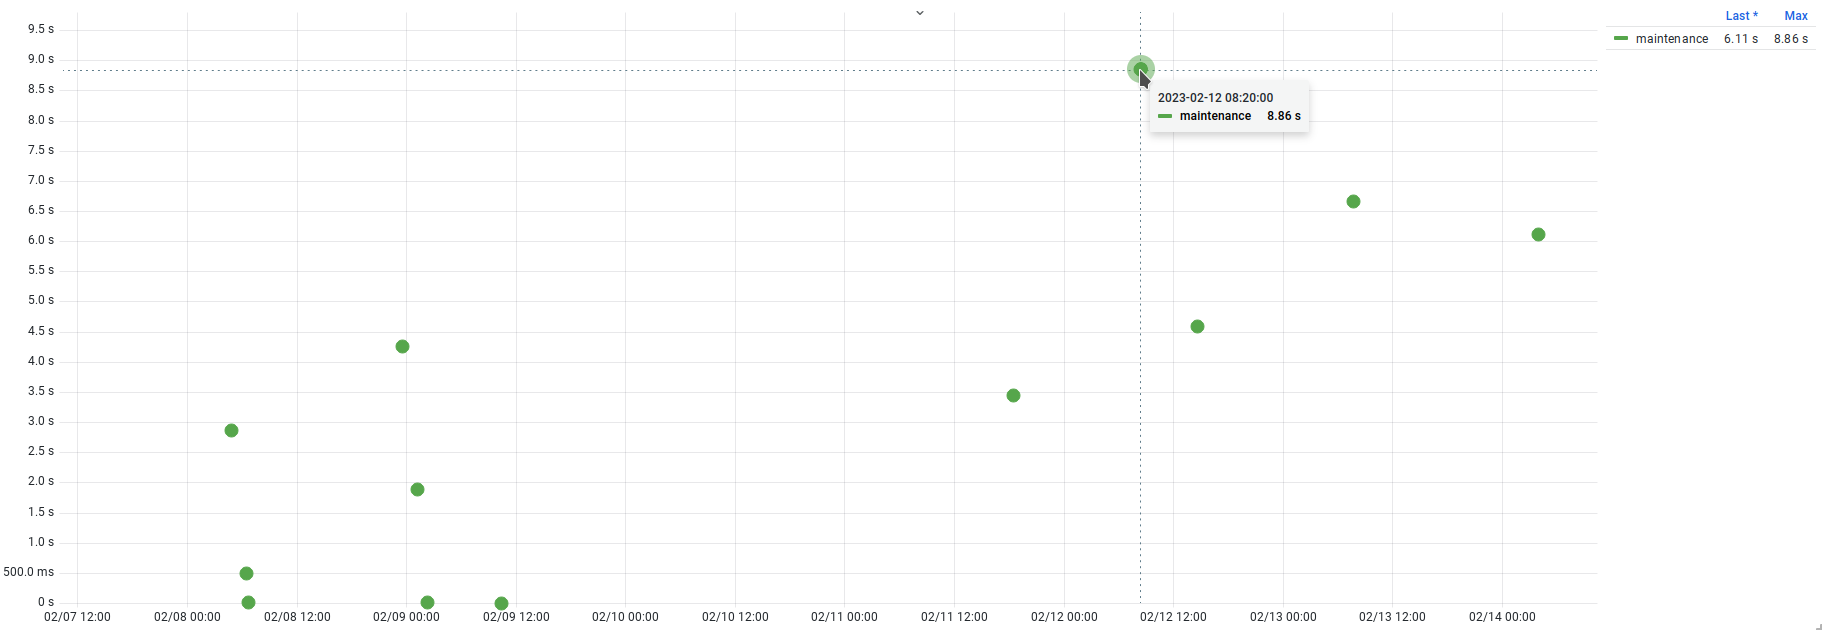
График на рис. [8.4](/ru/08-vacuum/#mon-figure-caption-158) показывает те моменты, когда удалось поймать процессы очистки в `pg_stat_activity` и зафиксировать их продолжительность. Значений снова не так уж и много, но, к сожалению, в СУБД нет других представлений, откуда можно было бы извлечь такую информацию. Более полную и точную информацию можно получить из журналов активности. При установке параметра *log\_autovacuum\_min\_duration* статистика работы каждого процесса автоочистки, занявшего более указанного времени, будет записана в журнал сообщений.
{#fig-8.4 num="8.4" caption="Продолжительность выполнения операций очистки" width=1823 height=631}
```text {label="text"}
LOG: automatic vacuum of table "pgbench.public.pgbench_accounts": index scans: 1
pages: 0 removed, 66788 remain, 66788 scanned (100.00% of total)
tuples: 1793208 removed, 2000413 remain, 411 are dead but not yet removable
removable cutoff: 215988728, which was 1945 XIDs old when operation ended
new relfrozenxid: 215985452, which is 104702 XIDs ahead of previous value
index scan needed: 33412 pages from table (50.03% of total) had 1887056 dead item identifiers removed
index "pgbench_accounts_pkey": pages: 10970 in total, 0 newly deleted, 0 currently deleted, 0 reusable
I/O timings: read: 2668.125 ms, write: 935.198 ms
avg read rate: 13.761 MB/s, avg write rate: 14.561 MB/s
buffer usage: 83992 hits, 94033 misses, 99499 dirtied
WAL usage: 173015 records, 77548 full page images, 328276128 bytes
system usage: CPU: user: 1.90 s, system: 1.58 s, elapsed: 53.38 s
```
Статистика о работе очистки содержит массу информации, и, если проанализировать статистику за продолжительный период, наверняка можно сделать интересные наблюдения и выводы. В приведенном примере нас интересует последняя строка, где отмечено, что выполнение очистки заняло 53,38 секунды. Таким образом, анализируя поток журнала, можно отследить все очистки, выполнявшиеся дольше *log\_autovacuum\_min\_duration*, в отличие от обращений к `pg_stat_activity`, где приходится полагаться на удачу. Однако не стоит злоупотреблять и слишком сильно уменьшать значение *log\_autovacuum\_min\_duration*, поскольку в системах с большой активностью и большим количеством таблиц может выполняться огромное количество очисток, что приведет к существенному объему записи в журнал сообщений.
### Представление pg\_stat\_progress\_vacuum {#mon-section-star-159}
Представление `pg_stat_progress_vacuum` содержит подробную информацию о работе процессов очистки и позволяет оценить ход их выполнения. Каждая строка в представлении описывает отдельный процесс, который идет в данный момент. Если выполняющихся процессов очистки нет, то и в представлении не будет ни одной строки.
- `pid` — идентификатор процесса в операционной системе;
- `datid`, `datname` — идентификатор и имя базы данных, с которой установлено соединение и в которой в данный момент выполняется очистка таблиц и индексов;
- `relid` — идентификатор таблицы, для которой в данный момент выполняется очистка;
- `phase` — фаза выполнения очистки:
— `initializing` — инициализация и подготовка к работе;
— `scanning heap` — сканирование таблицы, может включать в себя очистку, дефрагментацию страниц и заморозку строк;
— `vacuuming indexes` — обработка индексов, может выполняться несколько раз (в случае нехватки *autovacuum\_work\_mem* или *maintenance\_work\_mem*);
— `vacuuming heap` — обработка таблиц, отличается от сканирования тем, что выполняется каждый раз после обработки индексов (сначала в индексах удаляются указатели на строки, затем в таблице удаляются непосредственно сами версии строк, отмеченные указателями);
— `cleaning up indexes` — окончательная обработка индексов, выполняется после завершения полного сканирования таблицы и очистки как таблицы, так и ее индексов;
— `truncating heap` — усечение файла таблицы и высвобождение свободных страниц с целью вернуть место операционной системе;
— `performing final cleanup` — окончательная очистка, обновление карты свободного пространства, обновление статистики в `pg_class` и т. п., завершение работы;
- `heap_blks_total` — общее количество блоков в таблице на момент начала работы; блоки, добавленные в процессе очистки, не учитываются;
- `heap_blks_scanned` — общее количество просканированных блоков. Для оптимизации сканирования используется карта видимости, и часть блоков может быть пропущена без проверки, но пропущенные блоки также учитываются в этом поле и в конечном счете `heap_blks_scanned` сравняется с `heap_blks_total`;
- `heap_blks_vacuumed` — общее количество блоков, которые были очищены от устаревших версий строк. Если в таблице нет индексов, этот счетчик увеличивается только в фазе `vacuuming heap`. Блоки, не содержащие мертвых строк, пропускаются, так что счетчик может увеличиваться большими рывками;
- `index_vacuum_count` — общее количество завершенных циклов очистки индексов;
- `max_dead_tuples` — количество указателей на устаревшие версии строк, которые можно поместить в рабочую память (*autovacuum\_work\_mem*, *maintenance\_work\_mem*). Когда рабочая память заканчивается, выполняется цикл очистки индексов;
- `num_dead_tuples` — количество указателей на устаревшие версии строк, собранных в рабочей памяти с момента завершения последнего цикла очистки индексов.
Необработанная статистика может показаться недостаточно понятной и не отвечающей на возникающие у администратора вопросы: какая таблица сейчас обрабатывается, как долго и с какой скоростью выполняется очистка и когда она закончится?
```text {label="psql" .source-commands hl_lines="1"}
# SELECT * FROM pg_stat_progress_vacuum;
-[ RECORD 1 ]------+---------------------------------------------------
pid | 2688928
datid | 16437
datname | pgbench
relid | 16462
phase | vacuuming heap
heap_blks_total | 66788
heap_blks_scanned | 66788
heap_blks_vacuumed | 30540
index_vacuum_count | 1
max_dead_tuples | 11184809
num_dead_tuples | 1921611
```
В выводе присутствуют идентификаторы и значения в блоках, менее привычные, чем обычные байты. Для удобства к запросу можно добавить информацию из `pg_stat_activity`, а поля `pg_stat_progress_vacuum` привести к более привычному для восприятия виду:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23"}
# SELECT
p.pid,
now() - a.xact_start AS duration,
wait_event_type ||'.'|| wait_event AS wait_event,
CASE
WHEN a.query ~ '^autovacuum.*to prevent wraparound' THEN 'wraparound'
WHEN a.query ~ '^vacuum' THEN 'user'
ELSE 'regular'
END AS mode,
p.datname AS database,
p.relid::regclass AS table,
p.phase,
pg_size_pretty(p.heap_blks_total * current_setting('block_size')::int) AS table_size,
pg_size_pretty(pg_total_relation_size(relid)) AS total_size,
pg_size_pretty(p.heap_blks_scanned * current_setting('block_size')::int) AS scanned,
round(100.0 * p.heap_blks_scanned / p.heap_blks_total, 1) AS scanned_pct,
pg_size_pretty(p.heap_blks_vacuumed * current_setting('block_size')::int) AS vacuumed,
round(100.0 * p.heap_blks_vacuumed / p.heap_blks_total, 1) AS vacuumed_pct,
p.index_vacuum_count,
round(100.0 * p.num_dead_tuples / p.max_dead_tuples,1) AS work_mem_usage
FROM pg_stat_progress_vacuum p
JOIN pg_stat_activity a ON a.pid = p.pid
ORDER BY now() - a.xact_start DESC;
-[ RECORD 1 ]------+---------------------------------------------------
pid | 2688928
duration | 00:00:52.050535
wait_event | Timeout.VacuumDelay
mode | regular
database | pgbench
table | pgbench_accounts
phase | vacuuming heap
table_size | 522 MB
total_size | 608 MB
scanned | 522 MB
scanned_pct | 100.0
vacuumed | 239 MB
vacuumed_pct | 45.7
index_vacuum_count | 1
work_mem_usage | 17.2
```
Теперь в полученном результате есть четкие ответы:
- выполняется обработка таблицы `pgbench_accounts`;
- обработка текущей таблицы длится 52 секунды;
- в данный момент выполняется штатная пауза между обработкой блоков (`wait_event = Timeout.VacuumDelay`);
- `mode = regular` указывает на то, что это обычная автоочистка (не связанная с обслуживанием счетчика транзакций и не вызванная пользователем);
- размер таблицы 522 МБ, вместе с индексами — 608 МБ;
- значение `scanned_pct = 100.0 %` говорит о том, что таблица полностью просканирована на предмет мертвых строк и выполняется непосредственно очистка (`phase = vacuuming heap`);
- `vacuumed_pct = 45.7 %` указывает на то, что очистка выполнена почти наполовину;
- рабочая память заполнена на 17.2 % (`work_mem_usage`) и уже был выполнен один цикл обработки индексов (`index_vacuum_count = 1`).
Если снова провести полное обновление таблицы `pgbench_accounts`, а в соседнем сеансе запустить запрос с помощью `\watch 1`, можно будет наглядно наблюдать за тем, как выполняется очистка. Однако такой запрос и выводимая статистика больше подходят для текущей оценки происходящего, собирать такую информацию в мониторинг не имеет особого смысла.
## Резюме {#mon-p221-h310}
- Механизм конкурентного доступа допускает существование нескольких версий одной и той же строки.
- Жизненный цикл строк подразумевает существование живых и мертвых версий.
- Мертвые версии строки необходимо регулярно вычищать.
- Очистка выполняется как для таблиц, так и для индексов.
- Автоочистка выполняется, когда количество мертвых версий строк превышает определенный порог.
- Очистка создает дополнительный ввод-вывод и может влиять на производительность.
- Администратору важно отслеживать работу очистки в СУБД.
- Автоочистка должна запускаться без задержек.
- Автоочистка обслуживает счетчик транзакций и обеспечивает постоянный запас свободных идентификаторов транзакций.
- Администратору важно отслеживать запас доступных идентификаторов транзакций.
- При неблагоприятном стечении обстоятельств запас идентификаторов может оказаться исчерпанным, что приведет к остановке нормальной работы СУБД.
- Неэффективная работа очистки может приводить к эффекту раздувания.
- Следствием раздувания являются неэффективное использование дискового пространства и снижение производительности.
- Для оценки степени раздувания используется расширение `pgstattuple`.
- Для отслеживания активных процессов очистки могут использоваться представления `pg_stat_activity` и `pg_stat_progress_vacuum`.
[^mon-196-1]: [momjian.us/main/writings/pgsql/mvcc.pdf]()
[^mon-197-1]: [www.interdb.jp/pg/pgsql05.html]()
[^mon-197-2]: [postgrespro.ru/docs/postgrespro/15/sql-vacuum]()
[^mon-199-1]: [postgrespro.ru/docs/postgresql/current/sql-createtable#SQL-CREATETABLE-STORAGE-PARAMETERS]()
[^mon-200-1]: [postgrespro.ru/docs/postgresql/current/runtime-config-autovacuum#GUC-AUTOVACUUM-NAPTIME]()
[^mon-201-1]: [postgrespro.ru/docs/postgresql/current/sql-createtable#SQL-CREATETABLE-STORAGE-PARAMETERS]()
[^mon-203-1]: [postgrespro.ru/docs/postgresql/current/ddl-system-columns]()
[^mon-203-2]: [postgrespro.ru/education/books/internals]()
[^mon-211-1]: [postgrespro.ru/docs/postgresql/current/pgstattuple]()
[^mon-212-1]: [wiki.postgresql.org/wiki/Show\_database\_bloat]()
[^mon-214-1]: [github.com/reorg/pg\_repack]()
[^mon-214-2]: [github.com/dataegret/pgcompacttable]()
[^mon-214-3]: [github.com/cybertec-postgresql/pg\_squeeze]()