# Репликация
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
> [!NOTE]
> **В этой главе мы рассмотрим:**
>
> - репликацию и ее устройство;
>
> - инструменты отслеживания репликации;
>
> - представления `pg_stat_replication` и `pg_stat_wal_receiver`;
>
> - отставание репликации;
>
> - слоты репликации;
>
> - представление `pg_replication_slots`;
>
> - публикации и подписки;
>
> - представление `pg_stat_replication_slots`;
>
> - представления `pg_stat_subscription` и `pg_stat_subscription_stats`;
>
> - конфликты восстановления и представление `pg_stat_database_conflicts`.
В предыдущей главе мы рассмотрели журнал упреждающей записи, один из важных компонентов СУБД, обеспечивающий гарантии сохранности данных. Кроме того, на использовании WAL-журнала основана репликация. С помощью репликации становится возможным построение комплексных и распределенных конфигураций, которые позволяют обеспечить резервирование, отказо- и катастрофоустойчивость и распределение нагрузки. Использование репликации и кластерных конфигураций усложняет администрирование, требует ответственного отношения и навыков настройки и эксплуатации. В этой главе мы кратко рассмотрим устройство репликации в PostgreSQL и варианты ее использования, а также более детально погрузимся в инструменты, которые предоставляет СУБД для отслеживания работы кластеров и механизма репликации.
## 7.1. Обзор репликации {#mon-section-7-1}
Репликация — это процесс синхронизации данных между двумя и более узлами. Обычно различают два вида репликации: физическую и логическую. Физическая репликация предполагает передачу физических изменений блоков данных без анализа содержимого передаваемых изменений. Логическая репликация является более сложной и включает в себя анализ, фильтрацию и выборочную передачу изменений. В минимальной конфигурации в репликации участвует два узла: один — в роли *основного* (primary), являясь источником изменений, второй — в роли *реплики*, принимая изменения с основного узла и воспроизводя их у себя. В зависимости от типа репликации терминология может изменяться: например, в случае физической репликации реплики обычно называют *резервными*, или *запасными* (standby) узлами. В более сложных схемах репликации могут участвовать несколько основных узлов, типы репликации могут комбинироваться, и каждый из отдельных узлов может реплицировать изменения на другие узлы. Основное применение репликация находит в задачах распределения нагрузки на несколько узлов и обеспечения отказоустойчивости: при аварии на основном узле можно переключить реплику в основной режим и продолжить обслуживать рабочую нагрузку с минимальным простоем (downtime) системы в целом. Физическая репликация получила распространение в силу своей универсальности и применимости в обоих сценариях. Логическая же репликация применяется для выборочной передачи набора данных, например в случае шардирования (sharding). В этой главе мы по большей части сосредоточимся на рассмотрении именно физической репликации, а логическую затронем в меньшей степени.
Оба типа репликации в PostgreSQL устроены схожим образом. Сначала выполняется начальная синхронизация данных с основного узла на реплику. Дальше реплика подключается к основному узлу, и все изменения, попадающие в WAL-журнал основного узла, передаются на реплику по протоколу репликации. Реплики, в свою очередь, также могут передавать изменения на другие узлы; таким образом можно выстраивать каскадные конфигурации.
Репликация по умолчанию является асинхронным процессом: изменения на основном сервере фиксируются независимо от наличия реплик. Репликацию можно переключить в синхронный режим (см. *synchronous\_commit*), в котором транзакция на основном узле фиксируется только после подтверждения ее получения резервным узлом. В зависимости от значения параметра *synchronous\_commit* подтверждение может отсылаться после сохранения полученных журнальных записей на диск (`remote_write`), синхронизации их с диском (`on`, по умолчанию) или воспроизведения принятых изменений (`remote_apply`). Синхронный режим позволяет в аварийных случаях свести потери зафиксированных транзакций к нулю. Однако использование синхронной репликации, особенно в режиме `remote_apply`, может значительно сказаться на производительности, и, более того, отказ реплики может привести к отказу в обслуживании на основном узле: все операции по фиксации транзакций будут ожидать доставки журнальных записей на реплику. Поэтому решение использовать синхронную репликацию должно быть взвешенным и обоснованным. В любом случае все изменения, записанные в журнал основного узла, появляются на репликах с некоторой *задержкой* (replication lag); ее величина зависит от таких факторов, как производительность узлов, сетевое окружение или текущая рабочая нагрузка.
Процесс репликации инициируется репликой. Процесс walreceiver проверяет состояние локального WAL-журнала и отправляет на основной узел запрос на передачу журнальных записей. Если у основного узла есть в распоряжении запрашиваемые записи, то на нем запускается фоновый процесс walsender, который в дальнейшем и будет отвечать за потоковую передачу журнала. Оба процесса, walsender и walreceiver, поддерживают между собой постоянное соединение, и, как только в журнале появляются новые данные (включая данные еще незафиксированных транзакций), walsender передает их процессу walreceiver. Процесс walreceiver ожидает передачи данных. Получив журнальные записи, он сохраняет их в локальный каталог pg\_wal основного каталога данных, после чего другой фоновый процесс, startup, *воспроизводит* (replay) переданные изменения на локальной копии данных. Как только изменения применены, обновленные данные становятся видны запросам, выполняющимся на реплике. Такой механизм репликации зарекомендовал себя как простой и надежный.
На основе передачи WAL-записей реализованы оба вида репликации — и физическая, и логическая. Поскольку в WAL-журнале фиксируются изменения на уровне отдельных физических блоков, физическая репликация и заключается в передаче изменений физических блоков. Эти изменения описывают атомарный переход блока из одного физического состояния в другое без уточнения, какие именно пользовательские данные были изменены (таблицы, строки или отдельные поля). Таким образом, процессы walsender и walreceiver обеспечивают непрерывную и последовательную передачу потока изменений между узлами, а процесс startup применяет все изменения, без пропусков и строго в порядке следования журнальных записей. Для оценки работы физической репликации достаточно отслеживать состояние процессов walsender и walreceiver и объем данных передаваемых основным узлом на реплики.
Логическая репликация более сложна и позволяет реплицировать изменения выборочно. В PostgreSQL эта функциональность реализована механизмом *публикаций*[^mon-176-1] и *подписок*[^mon-176-2]. В случае логической репликации исчезают понятия основного и резервного узлов, поскольку узлы логической репликации могут совмещать обе роли; для обозначения источника и получателя изменений используются термины *сервер публикации* и *сервер подписки*. Сервер публикации декодирует поток журнала и выявляет объекты, которые были изменены. В результате декодирования появляется возможность фильтровать поток записей и реплицировать изменения (все или определенный набор операций) отдельных объектов. Выбранные изменения передаются серверу подписчика, который сохраняет их локально и затем применяет транзакции в том порядке, в котором они были зафиксированы на стороне сервера публикации (а не в порядке следования записей в WAL, как в случае физической репликации).
При физической репликации могут использоваться так называемые *слоты репликации*, а в случае логической репликации они являются обязательными. Слоты позволяют удерживать необходимый объем WAL-сегментов, исключая возможность их переработки в ходе выполнения контрольных точек. Слоты являются важной частью механизма репликации и требуют внимания и контроля со стороны администратора: для мониторинга логической репликации нужно отслеживать не только передачу изменений, но и состояние слотов репликации.
При эксплуатации кластеров репликации могут возникнуть разные проблемы, способные повлиять как на работоспособность кластера, так и на производительность отдельных узлов:
- отказ, недоступность узлов и невозможность передачи журнала;
- задержка при передаче журнала из-за недостаточной производительности узлов СУБД или среды передачи;
- недостаточная производительность при воспроизведении журнала на репликах и, как результат, отставание от основного узла;
- конфликты при воспроизведении журнала, приводящие к отставанию или ошибкам при выполнении запросов;
- аварийное завершение работы СУБД из-за нехватки места на диске в связи с накоплением сегментов журнала.
Как видно из приведенного списка, потенциальных проблем предостаточно. Некоторые из них могут приводить к деградации или даже к полному отказу в обслуживании с непрогнозируемым временем восстановления. Поэтому в обязанности администратора входит отслеживание состояния кластера и работоспособности отдельных узлов, а также предупреждение проблем, способных нарушить нормальную работу. Дальше мы рассмотрим инструменты, которые предлагает СУБД для отслеживания репликации и выявления связанных с ней проблем.
## 7.2. Инструменты отслеживания репликации {#mon-section-7-2}
Для отслеживания репликации есть несколько инструментов, и в зависимости от способа репликации могут понадобиться только некоторые из них:
- `pg_stat_replication` — отслеживание процессов walsender и процедуры передачи журнала на реплики;
- `pg_stat_wal_receiver` — отслеживание процесса walreceiver и процедуры приема журнала;
- `pg_replication_slots` — отслеживание слотов репликации, как физических, так и логических;
- `pg_stat_replication_slots` — статистика использования логических слотов репликации;
- `pg_stat_subscription` — статистика работы подписчиков;
- `pg_stat_subscription_stats` — статистика ошибок в работе подписчиков;
- `pg_stat_database_conflicts` — статистика конфликтов восстановления с разделением по причинам их возникновения.
Далее мы рассмотрим эти инструменты и возможные сценарии их использования.
### Представление pg\_stat\_replication {#mon-section-star-141}
Основной узел является источником всех изменений и может реплицировать данные больше чем на один узел. Скорость отправки изменений и скорость их применения на репликах могут различаться, что выражается в величине отставания репликации и степени актуальности данных. Для определения отставания репликации и других характеристик передачи журнала можно использовать представление `pg_stat_replication`. В каждой его строке содержится статистика работы отдельного процесса walsender. Представление `pg_stat_replication` показывает текущие данные аналогично тому, как работает представление `pg_stat_activity`:
```text {label="text" .source-commands hl_lines="1"}
# TABLE pg_stat_replication;
-[ RECORD 1 ]----+------------------------------
pid | 39
usesysid | 16431
usename | replica
application_name | walreceiver
client_addr | 172.22.0.3
client_hostname |
client_port | 46666
backend_start | 2022-12-14 03:54:32.228266+00
backend_xmin |
state | streaming
sent_lsn | D8/EF27AFC0
write_lsn | D8/EF27AFC0
flush_lsn | D8/EF27AFC0
replay_lsn | D8/EF27AFC0
write_lag | 00:00:00.000159
flush_lag | 00:00:00.002637
replay_lag | 00:00:00.002807
sync_priority | 0
sync_state | async
reply_time | 2022-12-16 04:36:36.495495+00
```
В тестовом окружении настроен кластер репликации с одним запасным узлом; соответственно, в представлении будет всего одна строка. Набор полей таков:
- `pid` — идентификатор процесса walsender в операционной системе;
- `usesysid`, `usename` — идентификатор и имя пользователя СУБД, от которого выполнено подключение со стороны резервного узла;
- `application_name` — дополнительный идентификатор приложения, который можно указать при подключении к основному узлу;
- `client_addr`, `client_hostname`, `client_port` — сетевые реквизиты со стороны резервного узла: адрес, имя узла и номер порта;
- `backend_start` — отметка времени подключения и создания процесса walsender;
- `backend_xmin` — транзакционный горизонт реплики, переданный основному узлу через обратную связь (см. *hot\_standby\_feedback*);
- `state` — текущее состояние процесса walsender, определяющее и общее состояние репликации:
— `startup` — walsender находится в процессе запуска;
— `catchup` — реплика пытается «догнать» основной узел;
— `streaming` — это основной режим работы: walsender передает поток изменений на реплику, после того как реплика успешно «догнала» основной узел;
— `backup` — walsender находится в процессе передачи резервной копии;
— `stopping` — walsender находится в процессе выключения.
На основе следующих полей, показывающих состояние отправки и приема журнала, можно определить величину отставания конкретной реплики и объем работы, который ей предстоит проделать, чтобы полностью устранить это отставание:
- `sent_lsn` — позиция журнала, записи до которой отправлены на реплику;
- `write_lsn` — позиция журнала, записи до которой приняты, но еще не синхронизированы процессом walreceiver;
- `flush_lsn` — позиция журнала, записи до которой уже синхронизированы процессом walreceiver;
- `replay_lsn` — позиция журнала, записи до которой воспроизведены процессом startup.
Как уже упоминалось, изменения на репликах могут появляться с задержкой. Величина задержки (отставание репликации) в идеале должна быть близка к нулю, но это не всегда возможно. Отставание еще можно расценивать как меру работы, которую необходимо проделать. Однако основной узел не стоит на месте, и в его журнал записываются новые и новые изменения. Объем появляющихся изменений может варьироваться; соответственно, отставание реплики тоже будет непостоянным. Увеличение отставания может выражаться в том, что результаты выполнения запросов к основному узлу и реплике будут расходиться, и это следует учитывать при проектировании приложений, которые получают данные с реплик.
Чтобы «догнать» основной узел, реплике требуется: а) получить все изменения с него, б) записать их в локальное хранилище, в) синхронизировать и г) воспроизвести над локальной копией данных. Используя вышеперечисленные поля с позициями журнала, можно вычислить расстояние в байтах между позициями и получить представление о том, в каком месте образовалась наибольшая задержка. Для этого потребуются уже известная функция `pg_current_wal_lsn` и оператор вычитания, который поддерживается типом данных `pg_lsn`:
- `pg_current_wal_lsn - sent_lsn` — объем данных к отправке, который состоит из всех журнальных записей, накопленных на основном узле, но еще не переданных на реплику;
- `sent_lsn - write_lsn` — объем данных, отправленных с основного узла, но еще не записанных на стороне реплики;
- `write_lsn - flush_lsn` — объем данных, записанных, но еще не синхронизированных на реплике;
- `flush_lsn - replay_lsn` — объем данных, готовых для воспроизведения процессом startup.
Полученный объем выражается в байтах и позволяет довольно наглядно представить масштабы отставания реплик. На практике отставание часто возникает на этапе отправки или воспроизведения журнала. Часто это происходит из-за того, что в результате изменения больших объемов данных генерируется много журнальных записей и процессы walsender или walreceiver не справляются с передачей или процессу startup не хватает производительности, чтобы своевременно воспроизводить весь объем журналов.
Следующая группа полей позволяет сразу отслеживать отставание в секундах, показывая приблизительное время, которое потребуется реплике, чтобы «догнать» основной узел:
- `write_lag` — время, прошедшее между локальной синхронизацией журнала и получением уведомления о том, что изменения записаны (но еще не синхронизированы) на реплике;
- `flush_lag` — время, прошедшее между локальной синхронизацией журнала и получением уведомления о том, что изменения записаны и синхронизированы на реплике;
- `replay_lag` — время, прошедшее между локальной синхронизацией журнала и получением уведомления о том, что изменения записаны, синхронизированы и применены;
- `reply_time` — отметка времени о получении последнего служебного сообщения от реплики, в котором и содержатся данные по обработке журнала.
Данные поля позволяют оценить задержку, возникающую при подтверждении транзакции в случае синхронной репликации, когда параметр *synchronous\_commit* установлен в одно из значений — `remote_write`, `on` или `remote_apply`.
Остаются еще два поля: `sync_priority` и `sync_state`. При асинхронной репликации `sync_state` всегда равно `async`. В случае синхронной репликации узлы могут находиться в разных состояниях и выполнять в кластере разные роли. Значение `sync` означает, что в данный момент реплика работает как синхронная. Если используется синхронная репликация, *основанная на приоритетах*, значение `potential` говорит о том, что реплика работает в асинхронном режиме, но является кандидатом на переход в синхронный режим (в этом случае `sync_priority` показывает приоритет данного узла). Если же используется синхронная репликация, *основанная на кворуме*, значение `quorum` означает, что реплика входит в минимально необходимое число узлов, подтвердивших получение изменений. Больше информации о настройке синхронной репликации можно получить из документации[^mon-180-1].
С точки зрения поиска и устранения проблем интересными являются поля с адресом, позициями обработки журнала и задержками, которые позволяют точно идентифицировать реплики (особенно если их несколько) и определить, на каких этапах обработки журнала возникают задержки. Поля с позициями журнала можно сразу преобразовать в величину задержек:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12"}
# SELECT
client_addr,
state,
pg_current_wal_lsn() - replay_lsn AS total_lag_bytes,
pg_current_wal_lsn() - sent_lsn AS pending_bytes,
sent_lsn - write_lsn AS write_lag_bytes,
write_lsn - flush_lsn AS flush_lag_bytes,
flush_lsn - replay_lsn AS replay_lag_bytes,
write_lag,
flush_lag,
replay_lag
FROM pg_stat_replication;
-[ RECORD 1 ]----+----------------
client_addr | 172.22.0.3
state | streaming
total_lag_bytes | 17152
pending_bytes | 0
write_lag_bytes | 0
flush_lag_bytes | 17152
replay_lag_bytes | 0
write_lag | 00:00:00.000151
flush_lag | 00:00:00.000151
replay_lag | 00:00:00.000151
```
Представление позволяет оценивать величину задержки как в байтах, так и в секундах, показывая, какой объем данных нужно обработать реплике, чтобы «догнать» основной узел, и сколько времени это займет. В выводе запроса видно, что отставание реплики незначительно и составляет несколько микросекунд, в байтах задержка составляет всего около 17 КБ, при этом данные уже переданы и записаны на реплику, их осталось только синхронизировать и воспроизвести.
На основе величин задержек можно собирать метрики и строить графики, которые будут отображать отставание реплик во времени (рис. [7.1](/ru/07-replication/#mon-figure-caption-142) и [7.2](/ru/07-replication/#mon-figure-caption-143)).
Обратите внимание на легенды обоих графиков. Отставание в байтах представлено более подробно и содержит информацию об объеме журнала, который еще не был отправлен на реплику. Второй любопытный факт связан с тем, что в выбранный момент оба графика показывают разные максимумы отставания. Например, большая часть отставания в байтах находится на этапе записи изменений, в то время как отставание в секундах — уже на этапах синхронизации и воспроизведения. Особенно хорошо это заметно на небольших значениях. Общая картина обоих графиков показывает, что отставание часто появляется на этапах синхронизации и воспроизведения. Это говорит о том, что реплика чуть хуже справляется со своей частью работы.
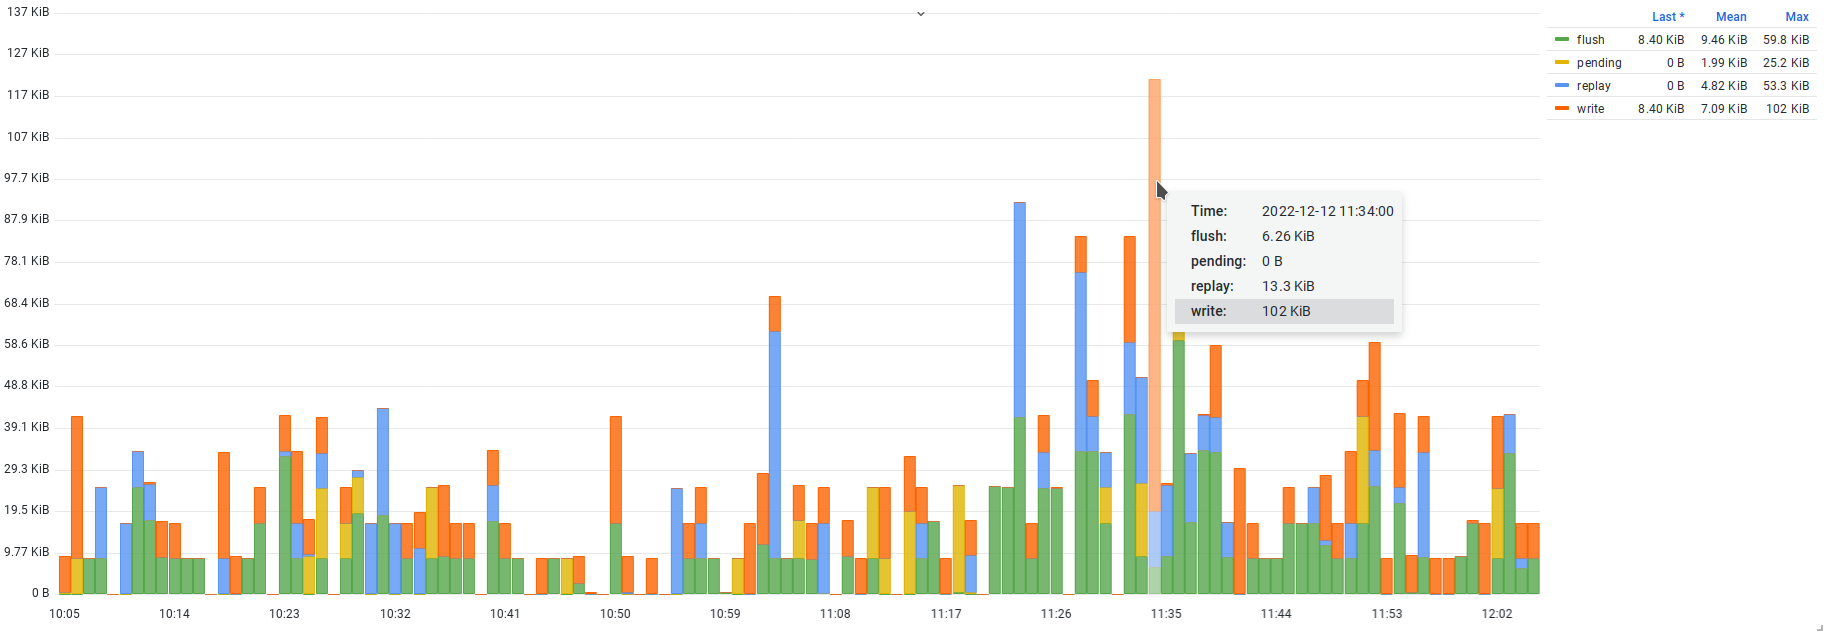
{#fig-7.1 num="7.1" caption="Отставание реплики в байтах" width=1824 height=632}
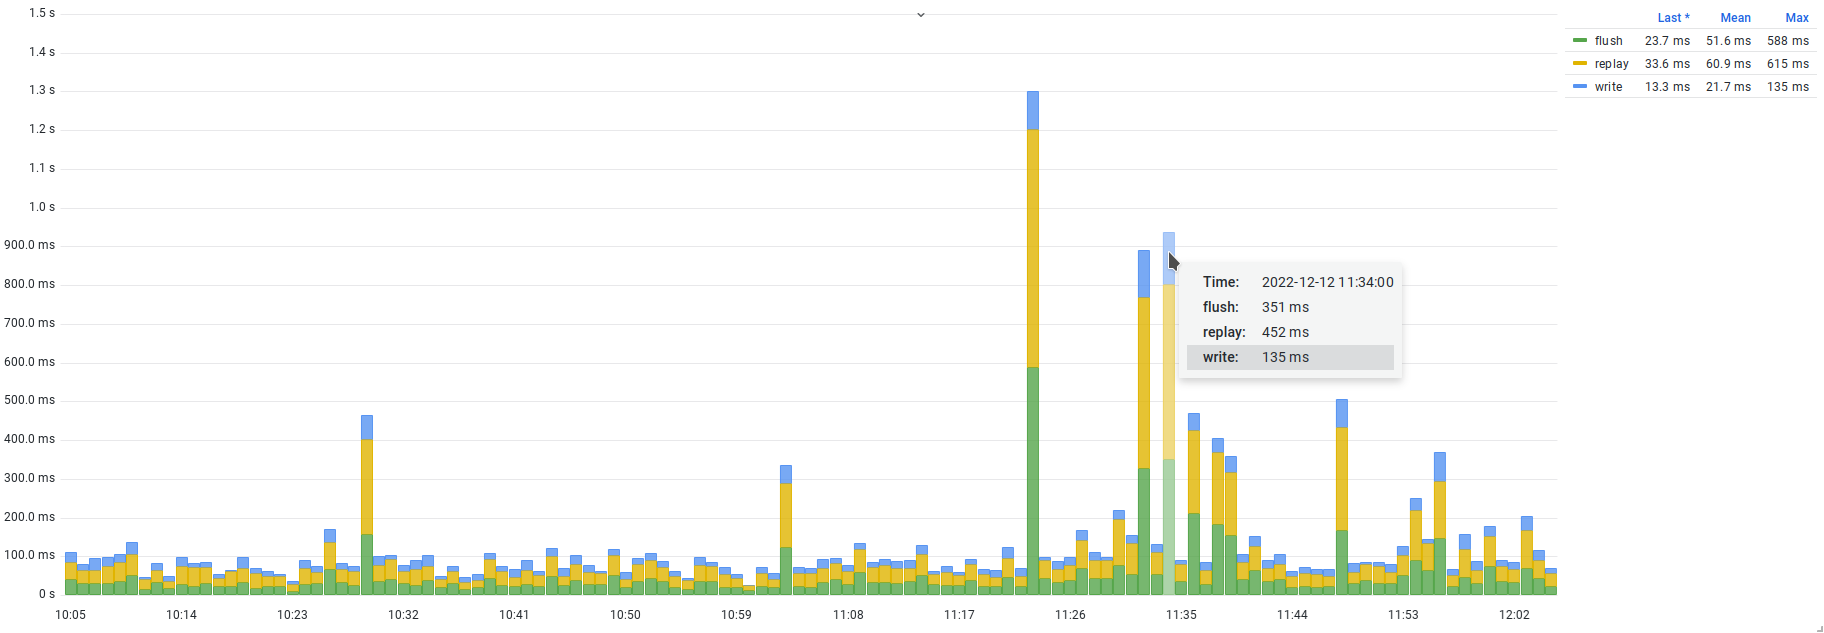
{#fig-7.2 num="7.2" caption="Отставание реплики в секундах" width=1824 height=633}
### Представление pg\_stat\_wal\_receiver {#mon-section-star-144}
Следующий способ отслеживания репликации доступен на резервных узлах с помощью представления `pg_stat_wal_receiver`. Представление отражает состояние репликации со стороны процесса walreceiver и содержит следующую информацию:
- `pid` — идентификатор процесса walreceiver в операционной системе;
- `status` — состояние процесса walreceiver;
- `receive_start_lsn` — позиция журнала на момент старта процесса walreceiver;
- `receive_start_tli` — линия времени в журнале на момент старта процесса walreceiver;
- `written_lsn` — позиция журнала, соответствующая последним записанным, но еще не синхронизированным данным;
- `flushed_lsn` — позиция журнала, соответствующая последним записанными и синхронизированным данным. Эта позиция используется как отправная точка при запуске процесса walreceiver;
- `received_tli` — номер линии времени, соответствующий последним записанным и синхронизированным данным. Линия времени используется как отправная линия при запуске процесса walreceiver;
- `last_msg_send_time` — время отправки последнего сообщения, полученного от основного узла;
- `last_msg_receipt_time` — время поступления последнего сообщения, полученного от основного узла;
- `latest_end_lsn` — позиция журнала, отправленная репликой основному узлу в последнем сообщении;
- `latest_end_time` — время последней позиции в журнале, отправленной основному узлу в последнем сообщении;
- `slot_name` — имя слота, используемого в данном сеансе репликации;
- `sender_host` — имя основного узла, с которым установлено соединение;
- `sender_port` — номер сетевого порта основного узла, с которым установлено соединение;
- `conninfo` — строка подключения к основному узлу, используемая процессом walreceiver.
В представлении нет информации о воспроизведении журнала, поскольку это задача процесса startup. Процесс walreceiver занимается только приемом и записью журнала. В целях мониторинга это представление практически не используется, поскольку все данные можно получить с основного узла через `pg_stat_replication`.
Помимо `pg_stat_wal_receiver`, есть несколько функций, которые позволяют получить дополнительную информацию о журнале:
- `pg_last_wal_receive_lsn` — последняя позиция журнала, полученного с основного узла;
- `pg_last_wal_replay_lsn` — последняя позиция журнала, записи до которой воспроизведены процессом startup;
- `pg_is_in_recovery` — находится ли СУБД в режиме восстановления (это рабочий режим реплики, так как она постоянно восстанавливается на основе журнала).
Функцию `pg_is_in_recovery` удобно использовать для определения, является узел основным или резервным. Функции `pg_last_wal_receive_lsn` и `pg_last_wal_replay_lsn` подходят для определения объема журнала на реплике, который необходимо воспроизвести, однако эти функции нельзя использовать для расчета отставания, поскольку они не учитывают тот объем журнала, который находится на основном сервере и должен быть передан на реплику. В случае отказа основного узла и его полной недоступности (при аппаратной неисправности, сетевой недоступности или из-за катастрофы) эти функции можно использовать для определения узла, который наилучшим образом подходит на роль основного: сравнивая позиции журнала, следует выбрать узел, который успел принять больше журнальных записей или воспроизвести бо́льшую их часть.
### Cлоты репликации и pg\_replication\_slots {#mon-section-star-145}
При нормальной работе репликации основной узел отправляет журналы на реплику, а реплика воспроизводит изменения на локальной копии данных. Однако могут возникнуть обстоятельства, при которых реплика не будет успевать воспроизводить изменения, или даже не будет успевать получать и записывать журнал. Например, из-за увеличенной нагрузки на основном узле генерируется большой объем журнала, пропускной способности сети становится недостаточно, сегменты журнала начинают скапливаться на основном узле и отставание реплики все увеличивается. Или передача журналов прерывается из-за нарушения сетевой связности между основным узлом и репликой, и репликация останавливается. В ранних версиях PostgreSQL основной узел никак не отслеживал необходимость реплики в тех или иных сегментах журнала — если реплика отключилась, сервер продолжает работу и при выполнении контрольной точки может удалить те журналы, которые еще не были переданы на реплику. Если реплика вновь подключится и запросит журнал с известной ей позиции, а на основном узле таких сегментов журнала уже нет, то репликация не сможет продолжиться. Решением этой проблемы являлась либо загрузка необходимых сегментов из архива, либо повторная инициализация реплики. Оба варианта имеют свои минусы: содержать архив сегментов может быть накладно по ресурсам, а инициализация может занимать много времени. Для минимизации проблемы можно использовать параметр *wal\_keep\_size* (ранее назывался *wal\_keep\_segments*), который указывает СУБД удерживать от переработки дополнительный объем журнала как раз на случай подобных отказов реплик. Другой, современный способ решить проблему — использовать слоты репликации.
Слоты репликации гарантируют удерживание сегментов журнала в рамках конкретного сеанса репликации до тех пор, пока они не будут переданы на реплику. Однако при продолжительном отключении реплики и большом приросте новых сегментов возникает риск полного исчерпания свободного места, что может привести к аварийному завершению СУБД. В качестве защитной меры появился параметр *max\_slot\_wal\_keep\_size*, позволяющий указать предельный объем, при достижении которого СУБД начнет удалять сегменты, и напоминающий улучшенный вариант *wal\_keep\_size*. В любом случае независимо от выбранных настроек остается риск либо полного и необратимого отставания реплики (с возможностью восстановления только с помощью WAL-архива), либо аварийного завершения СУБД из-за исчерпания места.
Поэтому применение слотов репликации добавляет администратору задачу отслеживания их состояния и использования. Для этого есть представление `pg_replication_slots`, которое содержит информацию обо всех слотах репликации, по одной строке на каждый:
```text {label="text" .source-commands hl_lines="1"}
# TABLE pg_replication_slots;
-[ RECORD 1 ]-------+------------
slot_name | standby
plugin |
slot_type | physical
datoid |
database |
temporary | f
active | t
active_pid | 39
xmin |
catalog_xmin |
restart_lsn | D3/94ADE4C8
confirmed_flush_lsn |
wal_status | reserved
safe_wal_size |
two_phase | f
```
Обычно этого представления достаточно для оценки состояния слотов и определения факта существования проблем:
- `slot_name`, `slot_type`, `plugin` — поля, идентифицирующие слот: его имя, тип и плагин для декодирования потока WAL-записей (указываются только для логических слотов);
- `datoid`, `database` — идентификатор и имя базы данных, с которой ассоциирован слот (только для логических слотов;
- `temporary` — флаг, указывающий на то, что слот является временным. Состояние временных слотов не сохраняется на диске, в случае ошибки или завершения сеанса они автоматически удаляются;
- `active` — флаг, указывающий на то, что слот является активным и используется в данный момент. Это один из главных атрибутов слота, по которому можно определить, что потребитель слота жив;
- `active_pid` — идентификатор процесса сеанса, который использует слот в данный момент;
- `xmin` — идентификатор транзакции, определяющий горизонт возможной очистки версии строк;
- `catalog_xmin` — аналогичный горизонт для версий строк в объектах системного каталога;
- `restart_lsn` — позиция в журнале, начиная с которой записи еще могут понадобиться потребителю в рамках работы со слотом. Все журнальные записи с этой позиции не могут быть переработаны в ходе выполнения контрольной точки до тех пор, пока их объем не превысит *max\_slot\_wal\_keep\_size*;
- `confirmed_flush_lsn` — позиция журнала, записи до которой потребитель уже гарантированно получил (только для логических слотов);
- `wal_status` — состояние файлов журнала, которые требуются для этого слота:
— `reserved` — требуемый объем журнала укладывается в ограничение *max\_wal\_size*;
— `extended` — объем журнала превышает ограничение *max\_wal\_size*, но сегменты все еще удерживаются слотом или укладываются в ограничение *wal\_keep\_size*;
— `unreserved` — для слота больше не сохраняются требуемые сегменты журнала и некоторые из них будут удалены при следующей контрольной точке. Это говорит о том, что потребитель не успевает вычитывать изменения, но, если скорость увеличится, это состояние еще может вернуться к `reserved` или `extended`;
— `lost` — необходимые сегменты журнала удалены, и данный слот уже нельзя использовать;
- `safe_wal_size` — объем изменений в байтах, при записи которого в журнал слот окажется в состоянии `lost` (при отсутствии потребителя). Значение может быть не указано (`NULL`), если слот уже потерян или ограничение *max\_slot\_wal\_keep\_size* не установлено;
- `two_phase` — флаг, указывающий на то, что слот используется для декодирования подготовленных транзакций (только для логических слотов).
При мониторинге слотов важными показателями являются:
- Разница между текущей позицией журнала (значение функции `pg_current_wal_lsn`) и позицией `confirmed_flush_lsn`. По сути, это объем данных в очереди на отправку подписчику, определяющий его отставание. Чем больше это значение, тем больше накоплено журналов и тем больше времени потребуется подписчику для обработки изменений.
- Величина горизонта транзакций (на основе полей `xmin` и `catalog_xmin`), который учитывается процессами очистки при удалении устаревших версии строк.
- Доступность сегментов журнала для потребителя слота (`wal_status`), которую СУБД оценивает самостоятельно.
- Величина `safe_wal_size`, указывающая предельный объем журнала, при исчерпании которого появляется риск переработки журнала и невозможности использовать слот.
Так, например, в тестовом окружении репликация работает с использованием слота и отставание можно отслеживать с помощью `pg_replication_slots` (рис. [7.3](/ru/07-replication/#mon-figure-caption-146)):
Можно поставить небольшой эксперимент — установить *max\_slot\_wal\_keep\_size* и выключить реплику — и посмотреть, как меняется статистика. Некоторое время СУБД будет удерживать сегменты, однако, после того как объем журнала превысит *max\_slot\_wal\_keep\_size*, СУБД переработает часть сегментов, что сделает слот недоступным для дальнейшего использования. Итак, включаем *max\_slot\_wal\_keep\_size*:
```text {label="psql" .source-commands hl_lines="1 2"}
# ALTER SYSTEM SET max_slot_wal_keep_size TO '1GB';
# SELECT pg_reload_conf();
```
Далее выключаем контейнер, в котором запущена реплика:
```text {label="text" .source-commands hl_lines="1 2"}
# cd playground
# docker-compose stop standby
```
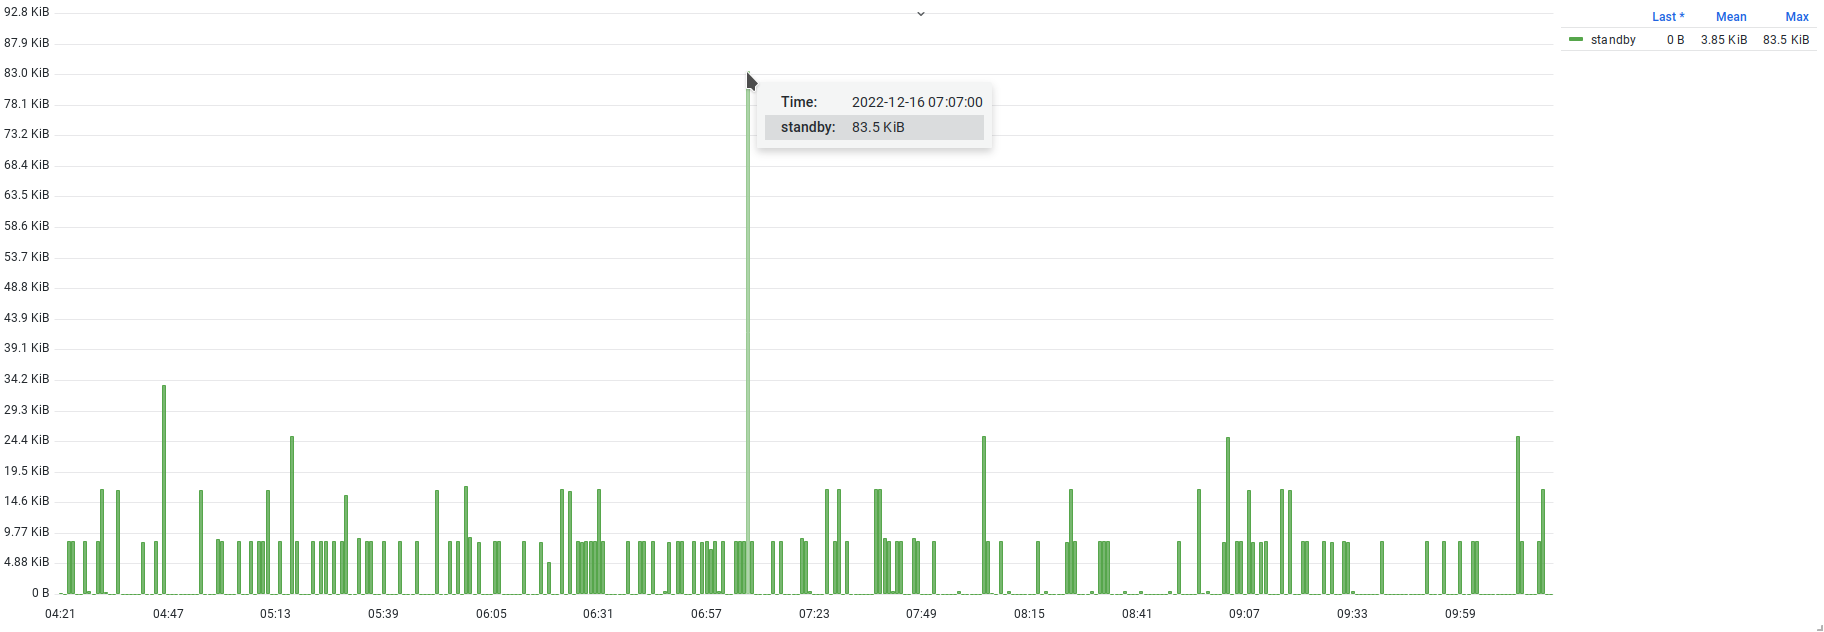
{#fig-7.3 num="7.3" caption="Объем журнала, удерживаемый слотом репликации" width=1824 height=632}
Теперь посмотрим содержимое `pg_replication_slots`:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5"}
# SELECT
slot_name, active,
pg_current_wal_lsn() - restart_lsn AS backlog,
wal_status, safe_wal_size
FROM pg_replication_slots;
slot_name | active | backlog | wal_status | safe_wal_size
-----------+--------+-----------+------------+---------------
standby | f | 353427008 | reserved | 722212616
```
Из-за выключения резервного узла через слот перестали передаваться изменения, и слот стал неактивным (`active = f`). При этом рабочая нагрузка никуда не делась, и новые изменения продолжают записываться в WAL-журнал, в результате чего растет отставание потребителя (поле `backlog`). Вместе с ростом отставания начинает уменьшаться запас объема журнала `safe_wal_size`, при этом состояние журнала пока `reserved`, что указывает на то, что требуемый объем журнала укладывается в *max\_wal\_size*.
Можно запустить метакоманду `\watch 60` и понаблюдать за тем, как отставание будет увеличиваться со временем и в какой-то момент `safe_wal_size` станет отрицательным.
```text {label="text"}
Tue Jan 3 14:21:54 2023 (every 60s)
```
```text {label="text"}
slot_name | active | backlog | wal_status | safe_wal_size
-----------+--------+------------+------------+---------------
standby | f | 1115080952 | unreserved | -39441328
```
```text {label="text"}
Tue Jan 3 14:22:54 2023 (every 60s)
```
```text {label="text"}
slot_name | active | backlog | wal_status | safe_wal_size
-----------+--------+---------+------------+---------------
standby | f | | lost |
```
Если не включить вовремя реплику, слот будет потерян, что и произошло в этом эксперименте. В журнале сообщений можно найти запись о том, что слот стал недействительным в процессе выполнения контрольной точки:
```text {label="text"}
2023-01-03 14:18:10.111 UTC 21 LOG: checkpoint starting: time
2023-01-03 14:22:40.095 UTC 21 LOG: invalidating slot "standby" because its restart_lsn E3/DDE30AB8
exceeds max_slot_wal_keep_size
2023-01-03 14:22:40.458 UTC 21 LOG: checkpoint complete: wrote 3545 buffers (21.6%); 0 WAL file(s)
added, 57 removed, 6 recycled; write=269.931 s, sync=0.015 s, total=270.348 s; sync files=10,
longest=0.009 s, average=0.002 s; distance=78162 kB, estimate=81638 kB
```
Для возвращения реплики в строй придется повторно инициализировать ее (поскольку в тестовом окружении нет WAL-архива):
```text {label="text" .source-commands hl_lines="1 2 3"}
# docker-compose rm standby
# docker volume rm playground_standby_data
# docker-compose up -d
```
После пересоздания контейнера статус слота покажет, что слот снова начал использоваться, как и прежде:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5"}
# SELECT
slot_name, active,
pg_current_wal_lsn() - restart_lsn AS backlog,
wal_status, safe_wal_size
FROM pg_replication_slots;
slot_name | active | backlog | wal_status | safe_wal_size
-----------+--------+-----------+------------+---------------
standby | f | 0 | reserved | 1090234536
```
### Публикации и подписки {#mon-section-star-147}
Логическая репликация использует модель публикаций и подписок. На одном узле можно опубликовать изменения, происходящие в одной или нескольких таблицах, а на другом — подписаться на получение этих изменений и воспроизводить их. Как и в случае физической репликации, механизм публикаций и подписок реализован на основе передачи журнала упреждающей записи. Процесс репликации инициируется на стороне подписки: при создании подписки запускается фоновый рабочий процесс logical replication worker, который подключается по указанному адресу к серверу публикации. На стороне публикации запускаются два процесса walsender, один из которых выполняет начальное копирование целевых таблиц и завершается, а второй остается и занимается передачей WAL-журнала. Если серверов подписки несколько, для каждого из них будет запущен отдельный процесс walsender, но не больше, чем указано в параметре *max\_wal\_senders*. Дальше начинается процесс декодирования WAL-журнала, при котором происходят разбор журнальных записей, извлечение данных об изменении отдельных строк таблиц и их группировка по отдельным транзакциям. В результате подписчику передаются данные зафиксированных транзакций. Для декодирования используется буфер, размер которого определяется параметром *logical\_decoding\_work\_mem* (64 МБ по умолчанию). При нехватке этого буфера отправитель может принять решение о вытеснении содержимого буфера на диск или немедленной отправке части декодированных данных подписчику. Это решение принимается на основе параметра `streaming`, указанного при создании подписчика. По умолчанию потоковая передача выключена, и транзакция сначала полностью декодируется на стороне отправителя, и только затем декодированные данные отправляются подписчику. Узнать больше об устройстве, настройке и работе логической информации можно в официальной документации[^mon-189-1].
В тестовом окружении не используется логическая репликация и нет ни публикаций, ни подписок, однако давайте рассмотрим инструменты для отслеживания их работы.
Представление `pg_stat_replication_slots` содержит информацию только о слотах логической репликации и может быть использовано для оценки объемов выполняемой работы. Каждая строка представления содержит статистику по отдельному логическому слоту:
- `slot_name` — уникальный идентификатор слота;
- `spill_txns` — общее количество транзакций, вытесненных на диск из-за нехватки рабочей памяти при декодировании журнала. Учитываются как транзакции верхнего уровня, так и вложенные транзакции (subtransaction);
- `spill_count` — общее количество фактов вытеснения транзакций на диск при декодировании журнала. Счетчик увеличивается каждый раз при вытеснении транзакции, одна и та же транзакция может быть вытеснена несколько раз;
- `spill_bytes` — общий объем декодированных данных в байтах, вытесненных на диск при декодировании журнала;
- `stream_txns` — общее количество активных транзакций, данные которых отправлялись подписчику из-за нехватки рабочей памяти при декодировании журнала. Таким образом передаваться могут только данные транзакций верхнего уровня (данные вложенных транзакций не передаются в потоке отдельно), поэтому счетчик не учитывает вложенные транзакции;
- `stream_count` — общее количество раз, когда данные активных транзакций отправлялись подписчику из-за нехватки рабочей памяти при декодировании журнала. Этот счетчик увеличивается каждый раз, когда данные транзакций передаются в потоковом режиме; одна и та же транзакция может быть передана таким способом несколько раз;
- `stream_bytes` — общий объем декодированных данных в байтах, переданных подписчику в потоковом режиме;
- `total_txns` — общее количество декодированных транзакций, отправленных подписчику. Учитываются только транзакции верхнего уровня, но не вложенные транзакции. Счетчик учитывает как транзакции, передаваемые в потоковом режиме, так и вытесненные транзакции;
- `total_bytes` — общий объем декодированных данных в байтах, отправленных подписчику. Счетчик учитывает данные транзакций, передаваемых как в потоковом режиме, так и вытесненных;
- `stats_reset` — отметка времени сброса этой статистики.
Счетчики помогают оценить объем работы и ввода-вывода, связанного с логическим декодированием журнала, и настроить параметр *logical\_decoding\_work\_mem*.
Следующий инструмент — это представление `pg_stat_subscription` со статистикой подписок, которое позволяет отслеживать процесс получения журнала со стороны отправителя:
- `subid`, `subname` — уникальный идентификатор и имя подписки;
- `pid` — процесс, обслуживающий подписку;
- `relid` — идентификатор отношения, для которого в данных момент выполняется начальная синхронизация. Значение будет отсутствовать (`NULL`), если процесс работает в основном рабочем режиме, в котором только применяются изменения;
- `received_lsn` — последняя позиция журнала, записи до которой приняты подписчиком;
- `last_msg_send_time` — время отправки последнего сообщения, полученного подписчиком;
- `last_msg_receipt_time` — время поступления последнего сообщения, полученного со стороны публикующего узла;
- `latest_end_lsn` — последняя локальная позиция в журнале, подтвержденная подписчиком публикующему узлу;
- `latest_end_time` — время последней локальной позиции в журнале, подтвержденное подписчиком публикующему узлу.
На практике `pg_stat_subscription` может пригодиться для отслеживания состояния подписок и скорости обработки приходящих изменений.
Следующий инструмент — это представление `pg_stat_subscription_stats`, которое помогает отслеживать появление ошибок на стороне подписки. При репликации изменений, связанных с операциями обновления и удаления (команды `UPDATE` и `DELETE`), используется так называемый *репликационный идентификатор*, который, как правило, основан на значениях первичного ключа таблицы. Вместо первичного ключа может использоваться любой другой уникальный ключ или вообще вся строка. Если при репликации изменений происходит нарушение уникальности репликационного идентификатора, например при попытке вставить строку с идентификатором, который уже присутствует в таблице, то возникает *конфликт*, который приводит к ошибке. Автоматическое разрешение конфликтов отсутствует; процесс синхронизации или применения изменений останавливается и требует ручного вмешательства администратора. Чтобы таких конфликтов не возникало, при начальной синхронизации таблицы на стороне подписчика должны быть пустыми, а при действующей репликации следует избегать внесения изменений на стороне подписки. Но даже при соблюдении этих условий полезно отслеживать появление ошибок с помощью представления `pg_stat_subscription_stats`, в котором есть следующие поля:
- `subid`, `subname` — уникальный идентификатор и имя подписки;
- `apply_error_count` — общее количество ошибок, возникших при применении изменений в режиме действующей репликации;
- `sync_error_count` — общее количество ошибок, возникших во время начальной синхронизации таблиц;
- `stats_reset` — отметка времени сброса этой статистики.
Когда механизм публикаций и подписок был добавлен, подобные ошибки фиксировались только в журнале сообщений, который приходилось обрабатывать и анализировать. После добавления `pg_stat_subscription_stats` отслеживать подобные ошибки стало проще.
## 7.3. Конфликты восстановления {#mon-section-7-3}
Один из сценариев применения физической репликации связан с распределением нагрузки таким образом, что часть запросов от приложений выполняются на основном узле, а часть запросов (на чтение) — на репликах, благодаря чему более эффективно используются вычислительные ресурсы всего кластера СУБД.
В процессе воспроизведения изменений на реплике, выполняющей нагрузку на чтение, существует вероятность того, что применение очередной журнальной записи приведет к невозможности продолжить выполнение запроса. Такая ситуация называется *конфликтом восстановления* (recovery conflict). Перед СУБД встает вопрос: продолжить выполнение запроса, но при этом остановить процесс применения изменений (то есть приостановить репликацию), или отменить запрос и применить изменения. СУБД поступает следующим образом: применение изменений приостанавливается на величину *max\_standby\_streaming\_delay* (по умолчанию 30 секунд), чтобы дать запросу возможность выполниться. Если запрос не успел выполниться за это время, то СУБД принудительно завершает его и возобновляет применение изменений. Важно отметить, что во время отсчета этой задержки СУБД продолжает получать от основного узла новые журнальные записи, но не применяет их. В лучшем случае запросы, задерживающие репликацию, появляются редко и отставание, накопленное за время выполнения таких запросов, будет быстро наверстываться. В худшем же случае применение журнальных записей может постоянно откладываться из-за большого количества одновременно выполняемых запросов: в этом случае после завершения одного конфликтующего запроса та же журнальная запись может вступить в конфликт уже со следующим запросом, из-за чего отставание может накапливаться.
В случае принудительной отмены запроса приложение получит ошибку, которая будет также зафиксирована в журнале сообщений:
```text {label="text"}
ERROR: canceling statement due to conflict with recovery
DETAIL: User query might have needed to see row versions that must be removed.
```
Конфликты восстановления могут возникать и при восстановлении из архива, когда вместо потоковой репликации сегменты журнала копируются из WAL-архива. В таком случае величина задержки определяется значением *max\_standby\_archive\_delay*, по умолчанию равным тем же 30 секундам.
Как поступать с такими ошибками, зависит от бизнес-требований: важно определить, что является наименьшим из двух зол — отставание от основного узла или прерывание запросов. Если важно выполнение запросов без ошибок, то имеет смысл увеличить величину задержки *max\_standby\_streaming\_delay*, что потенциально может приводить к еще большему отставанию реплики. Если же, наоборот, отставание реплики недопустимо (например, реплика является основным кандидатом для аварийного переключения), то ошибки можно игнорировать или обрабатывать их на стороне приложения, повторяя сбойные запросы на основном узле. Другим частым решением является использование отдельной реплики с очень большой величиной допустимой задержки и потенциально большим отставанием. Такая реплика используется преимущественно для выполнения продолжительных запросов и не участвует в процедурах аварийного переключения.
Помимо журнала сообщений, конфликты восстановления можно отследить с помощью `pg_stat_database.conflicts`: этот счетчик учитывает все типы конфликтов для каждой из существующих баз данных. Более детально причины конфликтов можно отследить в представлении `pg_stat_database_conflicts`. Это представление актуально только для реплик, поскольку конфликты происходят только там. Представление содержит список баз и счетчики для каждого типа конфликтов:
- `datid`, `datname` — уникальный идентификатор и имя базы данных;
- `confl_tablespace` — общее количество запросов, отмененных по причине удаления табличного пространства;
- `confl_lock` — общее количество запросов, отмененных по причине истечения тайм-аута блокировки;
- `confl_snapshot` — общее количество запросов, отмененных по причине устаревания снимка данных;
- `confl_bufferpin` — общее количество запросов, отмененных по причине закрепления буфера в общем кеше;
- `confl_deadlock` — общее количество запросов, отмененных по причине возникновения взаимоблокировки.
Обычно конфликты восстановления относят к ошибкам и при появлении ненулевых значений в `pg_stat_database.conflicts` детали и причины конфликтов расследуются уже с помощью журнала сообщений (какие именно запросы вызвали конфликты) и представления `pg_stat_database_conflicts` (какие именно конфликты возникали).
Причинами конфликтов могут быть разные события, возникающие на основном узле. На практике чаще всего встречается отмена запросов из-за очистки: изменения, вызванные очисткой устаревших версий строк, попадают на реплику, в то время как на ней выполняется запрос, которому все еще нужны эти версии (счетчик `confl_snapshot`). Как правило, это продолжительные аналитические запросы, обрабатывающие большие объемы данных, из-за чего они могут выполняться непредсказуемо долго и требовать большого объема ресурсов. Отмена и повторение таких запросов может обходиться дорого как по ресурсам, так и по времени ожидания результата. Для уменьшения вероятности отмены запросов есть две меры, которые можно принимать как по отдельности, так и вместе. Первая — это увеличение величины допустимой задержи *max\_standby\_streaming\_delay*. Вторая — включение обратной связи *hot\_standby\_feedback*. С помощью обратной связи процесс walsender будет получать от реплики необходимый ей горизонт и учитывать его при удалении устаревших версий строк (этот горизонт виден в `pg_stat_replication.backend_xmin`, если слот не используется, или в `pg_replication_slots.xmin`, если используется). В этом случае конфликтующих изменений не возникнет (подробно о том, что такое транзакционный горизонт, можно узнать в главе [8](/ru/08-vacuum/#mon-chapter-8), посвященной очистке). Однако ни один из этих способов не дает 100 % гарантии, что запрос будет выполнен, и оказывают определенное негативное влияние. Увеличение задержки может приводить к росту отставания, но, если время выполнения запроса превысит задержку, запрос все равно будет отменен (в крайнем случае можно заставить реплику ждать бесконечно, установив значение параметра в −1). Обратная связь гарантирует защиту только от очистки, но за счет откладывания очистки таблицы будут раздуваться; кроме того, остаются и другие причины, по которым могут произойти конфликт и последующая отмена запроса. Поэтому идеального решения проблемы не существует и следует отталкиваться от бизнес-требований о допустимости отмены запросов и возможной величине отставания. В качестве компромиссного решения для аналитических запросов можно сделать отдельную реплику с большим значением допустимой задержки, но не использовать ее в выборах основного узла. Тогда большое отставание будет допустимо; при этом можно отказаться от использования обратной связи и минимизировать эффекты раздувания.
## Резюме {#mon-p193-h589}
- Репликация практически всегда используется в производственной среде.
- Репликация работает на основе передачи WAL-журнала.
- Репликация бывает физической и логической.
- `pg_stat_replication` — основной инструмент отслеживания репликации.
- Для отслеживания репликации на репликах используется `pg_stat_wal_receiver`.
- Отставание репликации — самая часто возникающая проблема.
- Величину отставания можно измерять в байтах или секундах.
- Слоты репликации позволяют исключить риск необратимого отставания реплик, но добавляют риск исчерпания места на диске.
- Для отслеживания слотов репликации используется представление `pg_replication_slots`.
- Логическая репликация использует модель публикаций и подписок.
- Для отслеживания слотов логической репликации можно использовать представление `pg_stat_replication_slots`.
- Для отслеживания подписок можно использовать представления `pg_stat_subscription` и `pg_stat_subscription_stats`.
- Конфликты восстановления могут возникать при выполнении запросов на репликах.
- Для отслеживания конфликтов восстановления можно использовать представления `pg_stat_database` и `pg_stat_database_conflicts`.
[^mon-176-1]: [postgrespro.ru/docs/postgresql/current/sql-createpublication]()
[^mon-176-2]: [postgrespro.ru/docs/postgresql/current/sql-createsubscription]()
[^mon-180-1]: [postgrespro.ru/docs/postgrespro/15/runtime-config-replication#GUC-SYNCHRONOUS-STANDBY-NAMES]()
[^mon-189-1]: [postgrespro.ru/docs/postgresql/current/logical-replication]()