# Журнал упреждающей записи
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
> [!NOTE]
> **В этой главе мы рассмотрим:**
>
> - что такое журнал упреждающей записи;
>
> - устройство журнала упреждающей записи в PostgreSQL;
>
> - как отслеживать активность, связанную с журналом;
>
> - представление `pg_stat_wal`;
>
> - отслеживание записи в журнал запросами;
>
> - архивирование сегментов журнала;
>
> - представление `pg_stat_archiver`;
>
> - способы отслеживания проблем при архивировании журнала;
>
> - отслеживание очереди архивирования журнала.
В этой главе мы рассмотрим *журнал упреждающей записи*, он же *журнал предзаписи* (Write-Ahead Log), который в том или ином виде присутствует в большинстве СУБД. Журнал предзаписи в общем виде представляет собой историю всех изменений данных, происходящих в СУБД. В случае аварий такая история позволяет воспроизвести всю последовательность изменений до момента аварии и восстановить актуальное и согласованное состояние СУБД. В этой главе мы кратко рассмотрим устройство журнала (здесь и далее в этой главе под термином «журнал» будет подразумеваться именно WAL-журнал, а не журнал сообщений СУБД) и более подробно рассмотрим инструменты и способы отслеживания событий, связанных с журналом.
## 6.1. Write-Ahead Log — журнал упреждающей записи {#mon-section-6-1}
Для гарантий надежности все изменения данных в СУБД должны быть записаны в надежное хранилище (обычно на диск). Нельзя допускать искажений, повреждений и тем более потери данных даже в случае сбоев в системе. Для реализации этих требований практически все СУБД используют журнал предзаписи. В PostgreSQL журнал представляет собой историю изменений данных, и СУБД в случае аварии использует журнал для воспроизведения этих изменений и достижения последней согласованной точки до момента аварии.
Экземпляр СУБД состоит из множества клиентских и фоновых процессов, которые работают с данными, размещенными в общей памяти, — к таким данным относятся и буферный кеш с пользовательскими данными, и служебные структуры данных. Приложения отправляют запросы, а СУБД выполняет их. В случае запросов на чтение СУБД обращается к данным и возвращает необходимый набор строк; в случае запросов на изменение данных (или схемы) СУБД вносит соответствующие изменения. Все изменения происходят в общей памяти, затем в отложенном режиме процесс фоновой записи или контрольной точки синхронизирует изменения в кеше с основным хранилищем. Общая память СУБД является оперативной, и ее содержимое не защищено от системных сбоев вроде отказов питания. Также существует класс программных ошибок, при которых область общей памяти может быть повреждена и потребуется ее полная очистка и пересоздание — как правило, это ошибки сегментации (segmentation fault). К подобным последствиям приводит и аварийное завершение операционной системой каких-либо процессов СУБД. Обычно такие аварийные ситуации происходят внезапно, нельзя подготовиться к ним заранее и ждать их наступления в известный момент. Получается, что СУБД нужен инструмент, позволяющий восстановить те изменения данных, которые произошли в общей памяти, но из-за аварии не были записаны в основное хранилище.
Однако СУБД может эксплуатироваться очень долго, и хранить абсолютно всю историю изменений невозможно (либо это требует значительных или даже неадекватных экономических вложений). Для повторного использования файлов журнала и поддержания его в разумных объемах применяются контрольные точки: все изменения, предшествующие такой точке, гарантированно записаны в основное хранилище данных, которое считается надежным. Отметки об успешном завершении контрольных точек также записываются в журнал, после чего часть журнала до контрольной точки может быть удалена. В случае аварии остается воспроизвести только те изменения, которые были записаны в журнал после контрольной точки, и прийти к состоянию до момента аварии.
На практике журнал представляет собой набор файлов (сегментов) внутри подкаталога pg\_wal в основном каталоге данных:
```text {label="text" .source-commands hl_lines="1"}
# ls -l /var/lib/postgresql/data/pg_wal/
total 196616
-rw------- 1 postgres postgres 341 Nov 4 05:03 000000010000000000000011.0001F7A0.backup
-rw------- 1 postgres postgres 16777216 Nov 18 05:26 000000010000004B000000C2
-rw------- 1 postgres postgres 16777216 Nov 18 05:27 000000010000004B000000C3
-rw------- 1 postgres postgres 16777216 Nov 18 05:28 000000010000004B000000C4
-rw------- 1 postgres postgres 16777216 Nov 18 05:28 000000010000004B000000C5
-rw------- 1 postgres postgres 16777216 Nov 18 05:29 000000010000004B000000C6
-rw------- 1 postgres postgres 16777216 Nov 18 05:30 000000010000004B000000C7
-rw------- 1 postgres postgres 16777216 Nov 18 05:31 000000010000004B000000C8
-rw------- 1 postgres postgres 16777216 Nov 18 05:32 000000010000004B000000C9
-rw------- 1 postgres postgres 16777216 Nov 18 05:24 000000010000004B000000CA
-rw------- 1 postgres postgres 16777216 Nov 18 05:20 000000010000004B000000CB
-rw------- 1 postgres postgres 16777216 Nov 18 05:25 000000010000004B000000CC
-rw------- 1 postgres postgres 16777216 Nov 18 05:23 000000010000004B000000CD
drwx------ 2 postgres postgres 4096 Nov 18 05:31 archive_status
```
Все сегменты журнала имеют имя из 24 цифр в шестнадцатеричном формате без расширения. Имя состоит из трех октетов (на примере сегмента `000000010000004B000000CD`):
1. `00000001` — идентификатор линии времени (timeline id). Линии времени используется механизмом восстановления на точку во времени (Point-in-Time Recovery, PITR)[^mon-160-1] [^mon-160-2].
2. `0000004B` — идентификатор верхнего диапазона сегментов со значениями от `00000000` до `FFFFFFFF`.
3. `000000CD` — идентификатор нижнего диапазона сегментов со значениями от `00000000`, а последний номер зависит от размера сегмента, заданного при инициализации основного каталога.
Каждый сегмент имеет фиксированный размер (см. *wal\_segment\_size*), по умолчанию 16 МБ. Внутри каждый сегмент поделен на блоки по 8 КБ (см. *wal\_block\_size*). Размер сегмента можно менять при инициализации кластера (параметр `--wal-segsize`). Каждый блок содержит WAL-записи (records) в непечатаемом двоичном формате, описывающие отдельные изменения данных. Одна такая запись содержит достаточно информации для воспроизведения (повторного применения) одного конкретного изменения в случае сбоя системы. Записи могут иметь разные типы и относиться к изменениям самых разных объектов. Для анализа содержимого журнала можно использовать утилиту pg\_waldump[^mon-160-3] или расширение `pg_walinspect`[^mon-160-4]. Оба инструмента предоставляют одинаковую функциональность, но первый предназначен для работы только в среде терминала, а расширение предоставляет SQL-интерфейс с более богатыми возможностями для анализа результатов:
```text {label="psql" .source-commands hl_lines="1"}
# SELECT * FROM pg_get_wal_records_info('4B/DF000000','4B/E0000000') LIMIT 14;
start_lsn | end_lsn | prev_lsn | xid | resource_manager | record_type | record_length | main_data_length | fpi_length |
-------------+-------------+-------------+----------+------------------+-------------+---------------+------------------+------------+-----------...
4B/DF000350 | 4B/DF0003F8 | 4B/DEFFE370 | 43601290 | Heap | HOT_UPDATE | 163 | 14 | 0 | off 88 xma...
4B/DF0003F8 | 4B/DF000448 | 4B/DF000350 | 43601290 | Heap | HOT_UPDATE | 78 | 14 | 0 | off 22 xma...
4B/DF000448 | 4B/DF000498 | 4B/DF0003F8 | 43601290 | Heap | HOT_UPDATE | 74 | 14 | 0 | off 111 xm...
4B/DF000498 | 4B/DF0004E8 | 4B/DF000448 | 43601290 | Heap | INSERT | 79 | 3 | 0 | off 43 fla...
4B/DF0004E8 | 4B/DF000518 | 4B/DF000498 | 43601290 | Transaction | COMMIT | 46 | 20 | 0 | 2022-11-18...
4B/DF000518 | 4B/DF0024E8 | 4B/DF0004E8 | 0 | Heap2 | PRUNE | 8119 | 8 | 8060 | latestRemo...
4B/DF0024E8 | 4B/DF002590 | 4B/DF000518 | 43601291 | Heap | HOT_UPDATE | 163 | 14 | 0 | off 104 xm...
4B/DF002590 | 4B/DF0025E0 | 4B/DF0024E8 | 43601291 | Heap | HOT_UPDATE | 78 | 14 | 0 | off 71 xma...
4B/DF0025E0 | 4B/DF002630 | 4B/DF002590 | 43601291 | Heap | HOT_UPDATE | 74 | 14 | 0 | off 133 xm...
4B/DF002630 | 4B/DF002680 | 4B/DF0025E0 | 43601291 | Heap | INSERT | 79 | 3 | 0 | off 27 fla...
4B/DF002680 | 4B/DF0026B0 | 4B/DF002630 | 43601291 | Transaction | COMMIT | 46 | 20 | 0 | 2022-11-18...
4B/DF0026B0 | 4B/DF004680 | 4B/DF002680 | 0 | Heap2 | PRUNE | 8119 | 8 | 8060 | latestRemo...
4B/DF004680 | 4B/DF004728 | 4B/DF0026B0 | 43601292 | Heap | HOT_UPDATE | 163 | 14 | 0 | off 78 xma...
4B/DF004728 | 4B/DF004778 | 4B/DF004680 | 43601292 | Heap | HOT_UPDATE | 78 | 14 | 0 | off 179 xm...
```
Каждая отдельная запись имеет уникальный идентификатор LSN (log sequence number). Идентификатор можно использовать как *позицию* в WAL-журнале, по которой можно определить местоположение записи в журнале. На примере записи `4B/DF0026B0`:
- `4B` — идентификатор верхнего диапазона (второй октет имени файла сегмента);
- `DF` — идентификатор нижнего диапазона (третий октет имени файла сегмента);
- `0026B0` — смещение внутри файла сегмента.
Определить сегмент, в котором находится конкретная запись, можно с помощью функции `pg_walfile_name`, передав ей LSN:
```text {label="psql" .source-commands hl_lines="1"}
# SELECT pg_walfile_name('4B/DF008B78');
pg_walfile_name
--------------------------
000000010000004B000000DF
```
При активной эксплуатации СУБД и постоянном изменении данных в журнал вставляются новые записи и текущая позиция (выраженная в LSN) постоянно смещается вперед. После вставки добавленные записи следует надежно записать и в основное хранилище. Получить текущую позицию записи журнала можно с помощью нескольких функций:
- `pg_current_wal_insert_lsn` — позиция последней вставленной в журнал записи;
- `pg_current_wal_lsn` — позиция последней сохраненной на диск записи;
- `pg_current_wal_flush_lsn` — позиция последней сохраненной и синхронизированной с диском записи.
При полном заполнении сегмента вставка начинается в следующий по порядку сегмент.
Объем WAL-журнала ограничен параметрами конфигурации и при нормальной эксплуатации количество сегментов колеблется в определенном диапазоне. При пиковых нагрузках, особенно связанных с изменением данных, могут создаваться дополнительные сегменты, отчего размер журнала может увеличиваться. При возвращении нагрузки к нормальным значениям и после выполнения контрольной точки размер журнала скорректируется — излишние сегменты будут либо удалены, либо переименованы для использования в будущем; таким образом объем журнала уменьшится до размеров, заданных в конфигурации СУБД. В следующем листинге по отметкам времени можно заметить, что запись идет в сегмент `000000010000004B000000FC`, а сегменты с бóльшими номерами, но меньшим временем зарезервированы под использование в ближайшем будущем — как только активный сегмент будет заполнен, СУБД переключится на запись в следующий сегмент.
```text {label="text" .source-commands hl_lines="1"}
# ls -l /var/lib/postgresql/data/pg_wal/
total 196616
-rw------- 1 postgres postgres 341 Nov 4 05:03 000000010000000000000011.0001F7A0.backup
-rw------- 1 postgres postgres 16777216 Nov 18 06:21 000000010000004B000000F5
-rw------- 1 postgres postgres 16777216 Nov 18 06:22 000000010000004B000000F6
-rw------- 1 postgres postgres 16777216 Nov 18 06:23 000000010000004B000000F7
-rw------- 1 postgres postgres 16777216 Nov 18 06:24 000000010000004B000000F8
-rw------- 1 postgres postgres 16777216 Nov 18 06:25 000000010000004B000000F9
-rw------- 1 postgres postgres 16777216 Nov 18 06:26 000000010000004B000000FA
-rw------- 1 postgres postgres 16777216 Nov 18 06:27 000000010000004B000000FB
-rw------- 1 postgres postgres 16777216 Nov 18 06:28 000000010000004B000000FC <<< активный сегмент
-rw------- 1 postgres postgres 16777216 Nov 18 06:17 000000010000004B000000FD
-rw------- 1 postgres postgres 16777216 Nov 18 06:16 000000010000004B000000FE
```
```text {label="text"}
-rw------- 1 postgres postgres 16777216 Nov 18 06:19 000000010000004B000000FF
-rw------- 1 postgres postgres 16777216 Nov 18 06:18 000000010000004C00000000
drwx------ 2 postgres postgres 4096 Nov 18 06:27 archive_status
```
Запись в журнал может осуществляться как клиентом, так и фоновым процессом walwriter. По умолчанию все изменения в журнал пишутся клиентским процессом. Это может происходить при подтверждении транзакции командой `COMMIT` или при заполнении WAL-буфера (см. *wal\_buffers*). Такая запись называется синхронной, и, перед тем как отправить следующую команду или запрос, клиент вынужден дождаться завершения записи в журнал. Настройки СУБД позволяют переопределить поведение и использовать асинхронное подтверждение транзакций (см. *synchronous\_commit*). В таком режиме запись в журнал делегируется процессу walwriter, который работает в фоновом режиме. Перекладывая задачу записи в журнал на фоновый процесс, клиентские процессы могут не дожидаться завершения записи и сразу отправлять серверу следующую команду. Однако следует помнить, что в таком режиме в случае сбоев есть риск потери последних транзакций, которые еще не были записаны процессом walwriter. Настройка подтверждения транзакций имеет еще несколько режимов, действующих при использовании репликации. Более подробно с ними можно ознакомиться в документации[^mon-162-1]. Можно найти и исчерпывающую информацию о работе WAL-журнала[^mon-162-2] [^mon-162-3].
## 6.2. Отслеживание активности в журнале {#mon-section-6-2}
Журнал упреждающей записи является важной частью СУБД, и администратору необходимо иметь представление об активности, связанной с ним. Запись в журнал влияет на продолжительность транзакций, поэтому для хорошей производительности СУБД важно, чтобы запись проходила быстро и без задержек. Может возникнуть и ряд других вопросов: каковы объемы записи в журнал? Сколько времени уходит на запись? Какой объем записи в журнал выполняют те или иные типы запросов?
Для отслеживания активности, связанной с журналом, имеется несколько инструментов:
- pg\_waldump и `pg_walinspect` — инструменты для детального анализа журнала, которые больше подходят для отладки и поиска проблем или для образовательных целей;
- `pg_stat_wal` — общая статистика связанной с журналом активности;
- `pg_stat_statements` — это хорошо зарекомендовавшее себя расширение содержит также статистику, связанную с журналом, по отдельным типам запросов;
- `EXPLAIN ANALYZE` — средство для вывода плана запроса, которое показывает дополнительную информацию о записи в журнал при указании параметра `WAL`.
С точки зрения регулярного мониторинга особенно интересны представления `pg_stat_wal` и `pg_stat_statements`, поэтому рассмотрим их более подробно.
### Представление pg\_stat\_wal {#mon-section-star-128}
Представление `pg_stat_wal` содержит всего одну строку:
```text {label="text" .source-commands hl_lines="1"}
# TABLE pg_stat_wal;
-[ RECORD 1 ]----+------------------------------
wal_records | 322508636
wal_fpi | 46090986
wal_bytes | 393680012729
wal_buffers_full | 15545
wal_write | 48958771
wal_sync | 48846599
wal_write_time | 5697276.907
wal_sync_time | 486414839.104
stats_reset | 2022-11-04 05:01:49.427562+00
```
Статистика носит накопительный характер и включает следующую информацию:
- `wal_records` — общее количество записей, отправленных в журнал;
- `wal_fpi` — общее количество записанных FPI-страниц (full page image);
- `wal_bytes` — общий объем данных, записанный в журнал, в байтах;
- `wal_buffers_full` — общее количество раз, когда данные в журнал были записаны из-за заполнения WAL-буфера;
- `wal_write` — количество операций ввода-вывода для записи данных из WAL-буфера;
- `wal_sync` — количество запросов на синхронизацию WAL-сегментов с основным хранилищем;
- `wal_write_time` — время, затраченное на запись содержимого WAL-буфера в основное хранилище, в миллисекундах. Может включать в себя время, затраченное на синхронизацию, если параметр *wal\_sync\_method* установлен в `open_datasync` или `open_sync`;
- `wal_sync_time` — время, затраченное на синхронизацию сегментов в основное хранилище, в миллисекундах;
- `stats_reset` — отметка времени сброса статистики.
Статистика по времени отслеживается только при включенном параметре *track\_wal\_io\_timing*. На основе данных представления можно отслеживать активность, связанную с журналом, объемы и продолжительность записи и факты, указывающие на нехватку места в WAL-буфере, что может послужить поводом к пересмотру настройки параметра *wal\_buffers*.
На основе метрик по этой статистике можно построить графики общей WAL-активности на уровне экземпляра СУБД.
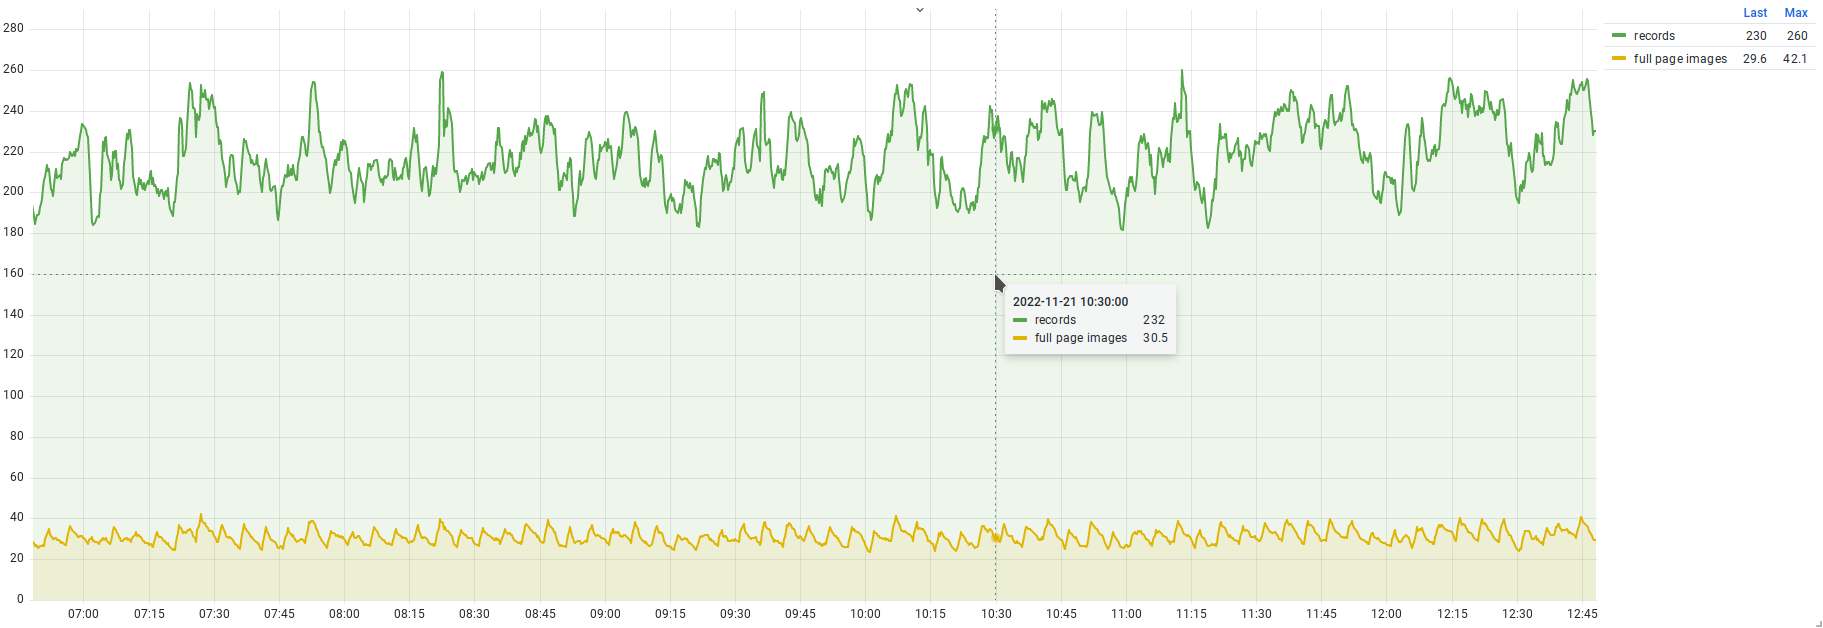
На рис. [6.1](/ru/06-write-ahead-log/#mon-figure-caption-129) изображен график с количеством обычных записей и FPI-страниц, попадающих в журнал. Можно отметить, что объем записи в журнал стабильный, без значительных всплесков. Также можно отметить постоянный и пилообразный поток записи FPI-страниц. Продолжительность пиков укладывается в пятиминутный интервал, что соответствует значению *checkpoint\_timeout* по умолчанию. Выполнение принудительных контрольных точек визуально никак не сказывается на объеме записи FPI-страниц, и на графике это остается незаметным.
{#fig-6.1 num="6.1" caption="Количество обычных записей и FPI-страниц в журнале" width=1823 height=628}
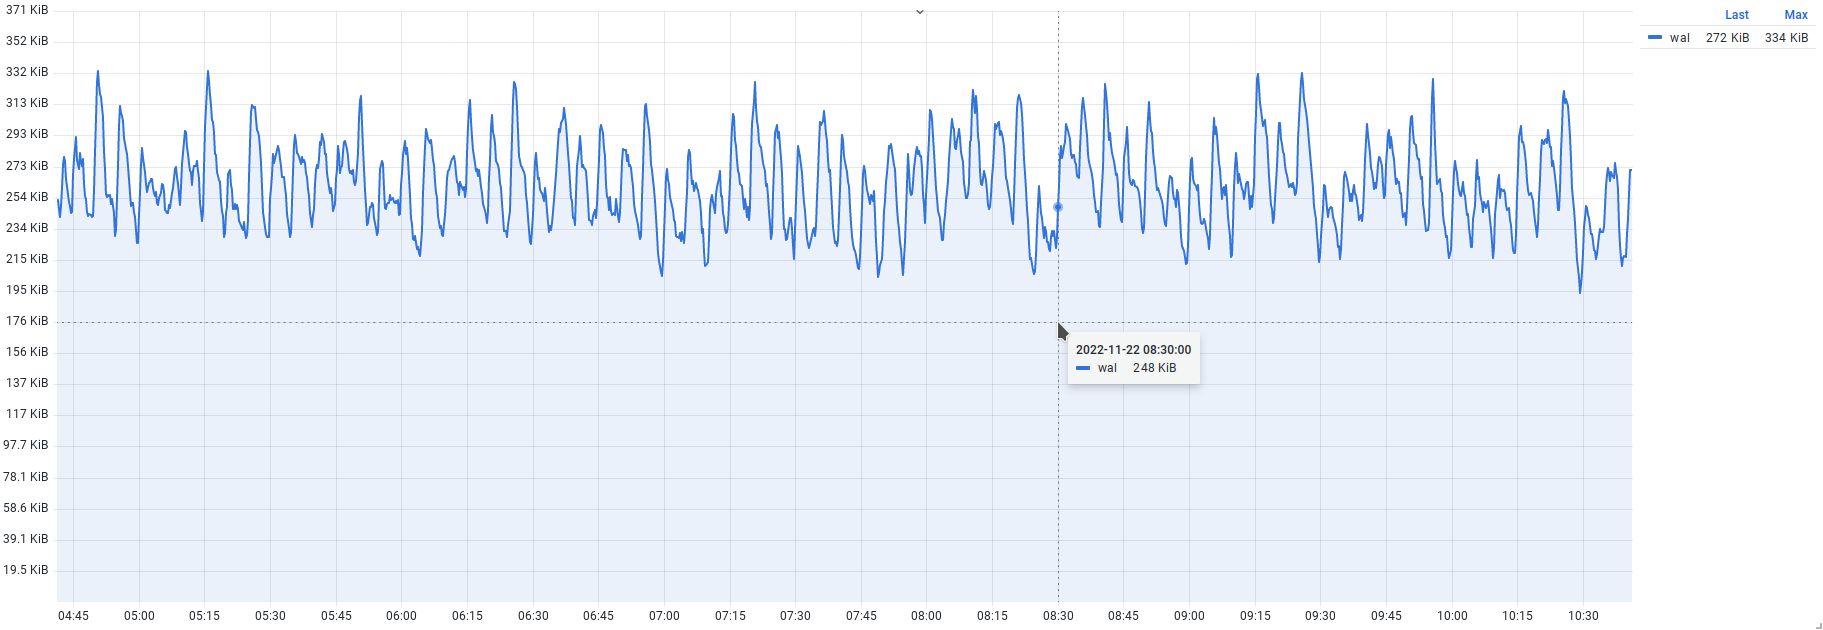
На рис. [6.2](/ru/06-write-ahead-log/#mon-figure-caption-130) изображен график объема записи в журнал в байтах, и здесь нагрузка также умеренно ровная. Но, если присмотреться, этот график, так же как и предыдущий, напоминает пилу с пятиминутными интервалами. Подобный график можно использовать для визуализации объема записи в журнал.
{#fig-6.2 num="6.2" caption="Объем записи в журнал в байтах" width=1823 height=630}
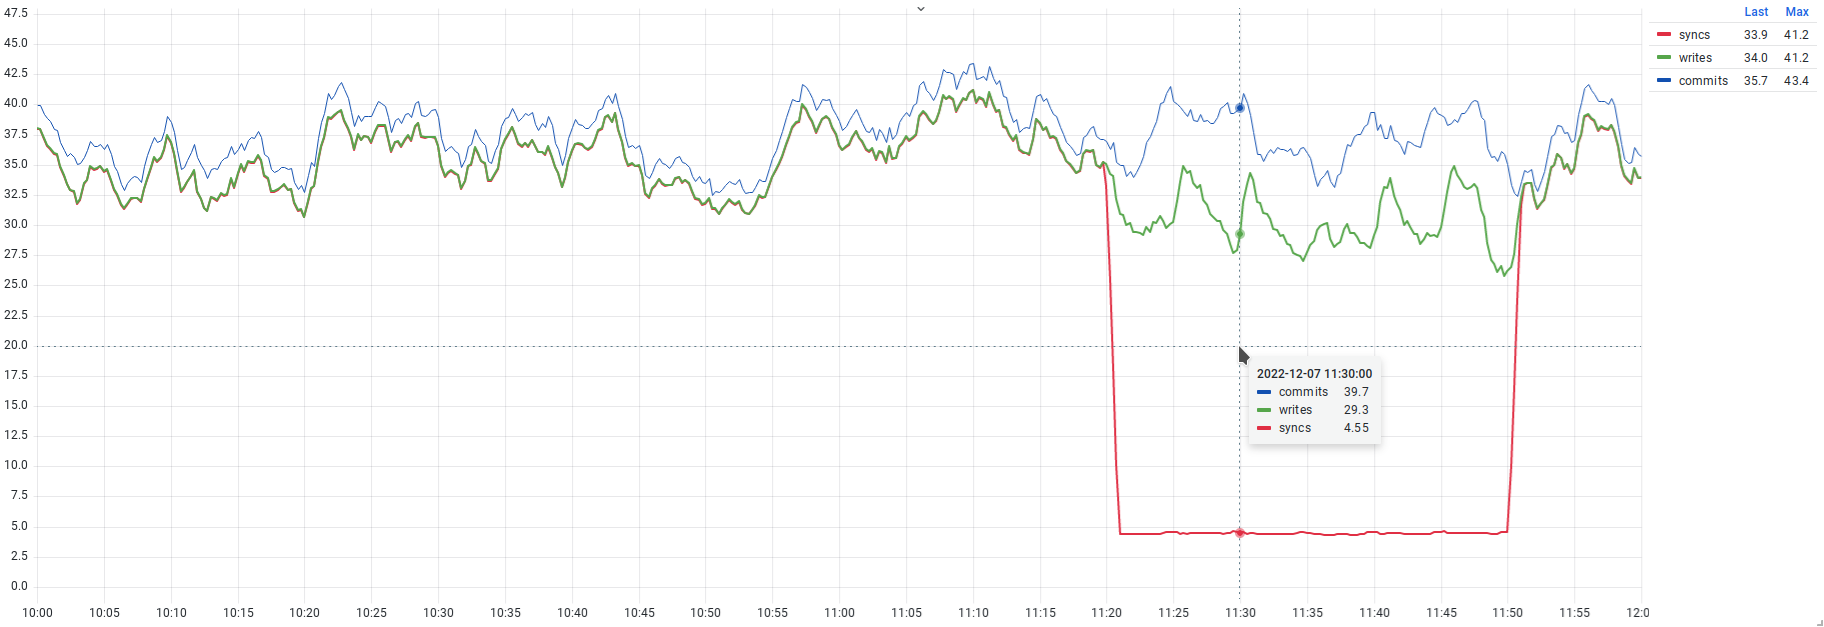
График на рис. [6.3](/ru/06-write-ahead-log/#mon-figure-caption-131) показывает количество операций записи данных из буфера в журнал и последующих синхронизаций сегментов. В левой части графика количество операций записи совпадает с количеством синхронизаций. Это связано с тем, что запись и последующая синхронизация происходят при завершении каждой транзакции. Рядом показано количество подтвержденных транзакций (синяя линия commits), практически совпадающее с остальными метриками. Дальше, в правой части графика, при неизменном потоке транзакций количество синхронизаций сегментов сильно уменьшилось и затем через какое-то время вернулось на прежний уровень. Количество операций записи тоже уменьшилось, хотя и не так сильно. В этот период был включен режим асинхронного подтверждения транзакций (*synchronous\_commit* `= off`). В этом режиме задачи по записи в журнал и синхронизации сегментов перекладываются на процесс walwriter, который делает это согласно своим настройкам.
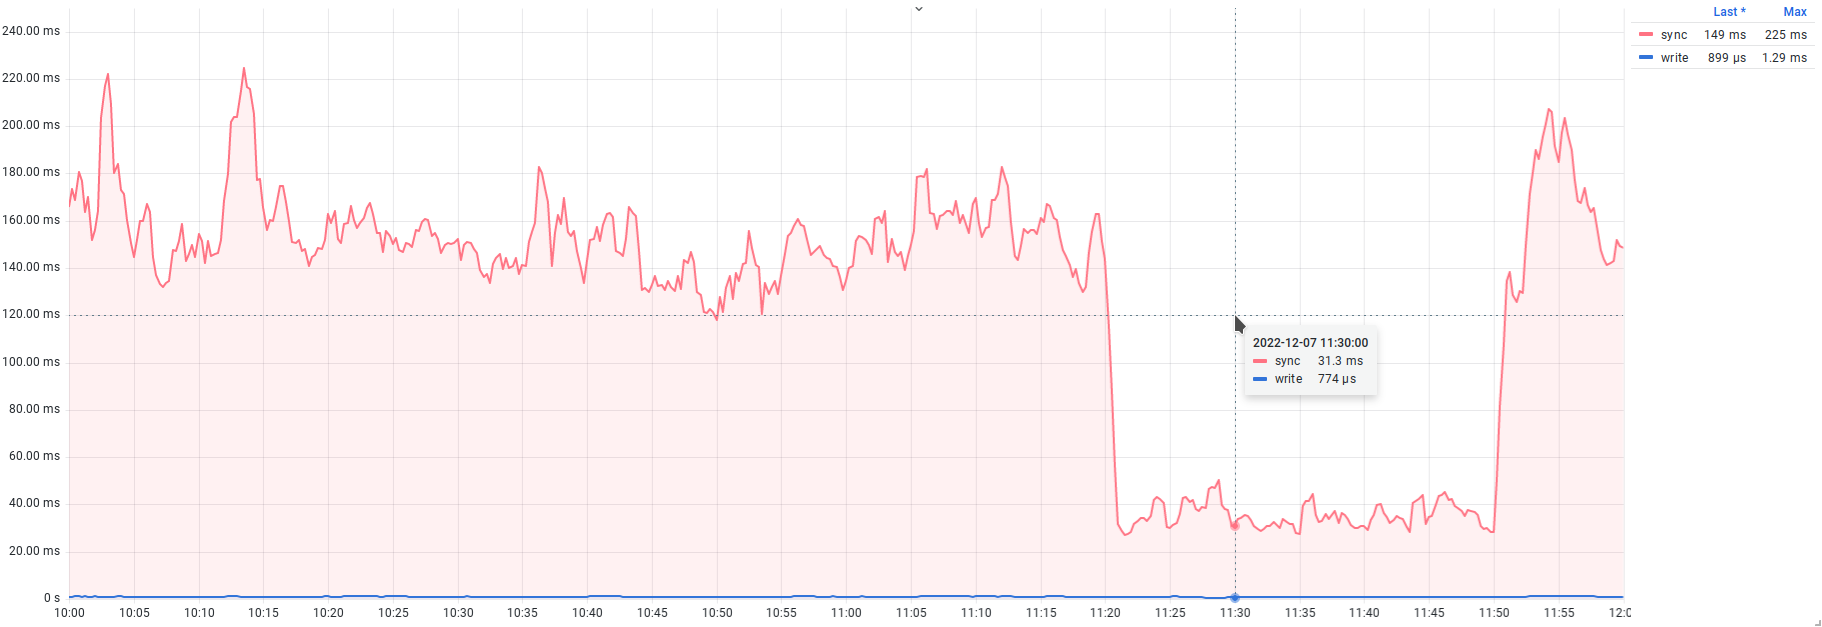
Важной информацией является и время, затраченное на запись и синхронизацию (рис. [6.4](/ru/06-write-ahead-log/#mon-figure-caption-132)).
{#fig-6.3 num="6.3" caption="Количество операций записи из WAL-буфера, синхронизаций сегментов и подтвержденных транзакций" width=1824 height=627}
{#fig-6.4 num="6.4" caption="Время, затраченное на запись в журнал и синхронизацию сегментов" width=1822 height=627}
На таком графике важно отслеживать пики и выяснять причины всплесков, когда на запись в журнал СУБД тратит больше времени, чем обычно.
Отключение синхронного подтверждения транзакций повлияло также и на время. Когда запись в журнал происходит в асинхронном режиме фоновым процессом walwriter, вместе с уменьшением количества синхронизаций уменьшается и время, затрачиваемое на синхронизацию сегментов. Отключение синхронного подтверждения транзакций часто используется как оптимизация производительности за счет перекладывания обязанности подтверждения транзакций с клиентских процессов на фоновый процесс. Высвободившееся время СУБД может использовать для выполнения еще большего числа запросов, что увеличивает общую пропускную способность СУБД.
### Представление pg\_stat\_statements {#mon-section-star-133}
Если представление `pg_stat_wal` содержит общую статистику уровня СУБД, то в представлении `pg_stat_statements` можно найти аналогичную статистику в контексте отдельных типов запросов:
- `wal_records` — общее количество записей, отправленных в журнал;
- `wal_fpi` — общее количество FPI-страниц, записанное в журнал;
- `wal_bytes` — общий объем данных, записанный в журнал, в байтах.
В перечисленных полях содержится статистика записи для каждого конкретного типа запросов. С ее помощью можно проанализировать состав WAL-журнала и ответить на вопрос о том, какие запросы пишут в журнал больше остальных:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7"}
# SELECT
pg_size_pretty(sum(wal_bytes)) AS wal_volume,
left(query, 64) AS query_trunc
FROM pg_stat_statements
GROUP BY query
ORDER BY sum(wal_bytes) DESC
LIMIT 10;
wal_volume | query_trunc
------------+------------------------------------------------------------------
678 GB | UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE aid =
10196 MB | INSERT INTO pgbench_history (tid, bid, aid, delta, mtime) VALUES
8219 MB | UPDATE pgbench_tellers SET tbalance = tbalance + $1 WHERE tid =
7805 MB | UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid =
9313 kB | SELECT abalance FROM pgbench_accounts WHERE aid = $1
1394 kB | truncate pgbench_history
536 kB | vacuum pgbench_tellers
375 kB | select count(*) from pgbench_branches
250 kB | vacuum pgbench_branches
129 kB | SELECT current_database() AS database, schemaname AS schema, fun
```
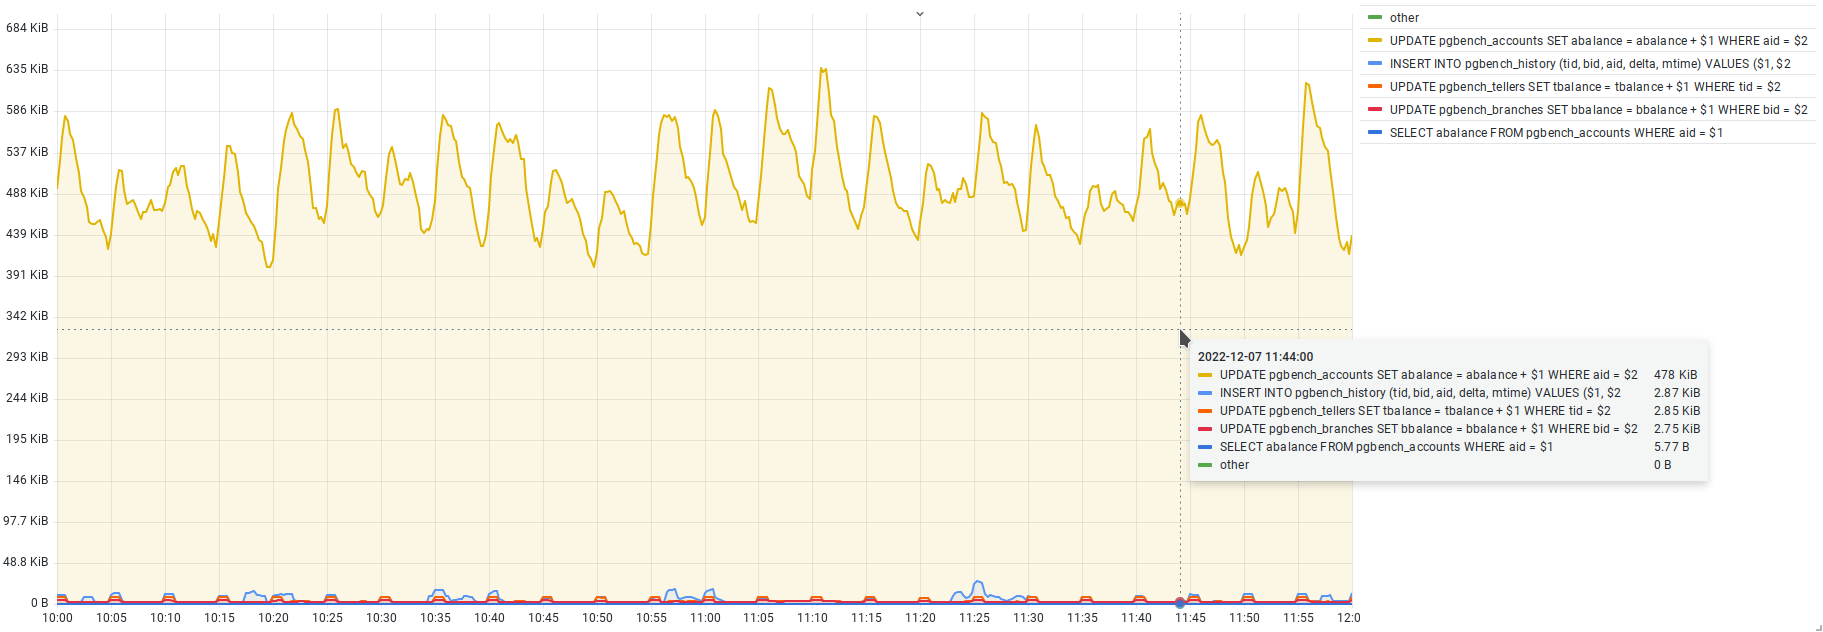
Результат показывает, что наибольший объем записи в журнал генерирует запрос, связанный с обновлением строк в `pgbench_accounts` (678 ГБ), с большим отрывом опережающий запрос, занявший второе место. Получить данные из мониторинга можно следующим запросом:
```text {label="PromQL" .source-commands hl_lines="1 2 3 4 5 6 7"}
# topk_avg(5,
sum by (queryid,query) (
rate(postgres_statements_wal_bytes_all_total{
service_id="primary"
}[1m]) + on(database,user,queryid) group_left(query)
0 * postgres_statements_query_info{service_id="primary"}
), "other")
```
График на рис. [6.5](/ru/06-write-ahead-log/#mon-figure-caption-134) подтверждает результат запроса к `pg_stat_statements`: в динамике видно, что запрос на обновление `pgbench_accounts` пишет в среднем примерно 500 КБ в секунду и по объему записи значительно опережает остальные запросы.
{#fig-6.5 num="6.5" caption="Запросы, пишущие в журнал больше остальных" width=1823 height=632}
## 6.3. Архивирование журнала {#mon-section-6-3}
Обслуживая журнал, СУБД поддерживает непрерывную историю изменений в целях защиты от потенциальных системных сбоев. Напомню, что после сбоя СУБД может автоматически восстановить согласованное состояние данных с помощью проигрывания изменений. Существование журнала дает также возможность резервного копирования СУБД. Выполнив резервное копирование файлов СУБД вместе с сегментами журнала, впоследствии из созданной резервной копии можно восстановить состояние СУБД до произвольной точки — сначала восстанавливая файлы, затем воспроизводя изменения по журналу. Такой подход связан с некоторыми сложностями, но в целом имеет много положительных сторон.
При таком подходе требуется постоянное архивирование сегментов журнала в отдельное от СУБД хранилище[^mon-168-1]. По умолчанию архивирование сегментов журнала выключено и требует отдельной настройки. При включении архивирования СУБД запустит фоновый процесс archiver. Когда запись в отдельный сегмент журнала завершается и он готов для архивирования, archiver запускает команду архивирования из параметра *archive\_command* и ждет ее завершения. Если команда завершилась ошибкой, через некоторое время процесс предпримет еще одну попытку заархивировать сегмент и будет повторять такие попытки до тех пор, пока команда не завершится успехом. Очевидно, что это может привести к ситуации, когда из-за «сломанного» архивирования начнет увеличиваться количество сегментов, и в какой-то момент это может привести к исчерпанию свободного места на диске и аварийной остановке СУБД при попытке записи в журнал. При таких рисках у администратора появляется еще одна обязанность — наблюдение за работой архивирования, отслеживание потенциальных ошибок и их устранение.
### Представление pg\_stat\_archiver {#mon-section-star-135}
Для отслеживания процесса архивирования есть представление `pg_stat_archiver`, которое содержит всего одну строку со следующими полями:
- `archived_count` — общее количество сегментов, отправленных в архив;
- `last_archived_wal` — имя последнего сегмента, отправленного в архив;
- `last_archived_time` — отметка времени последней отправки сегмента в архив;
- `failed_count` — количество неудачных попыток отправки в архив;
- `last_failed_wal` — имя сегмента, при отправке которого произошла последняя ошибка;
- `last_failed_time` — отметка времени, когда произошла последняя ошибка при отправке в архив;
- `stats_reset` — отметка времени, когда была сброшена статистика.
В тестовом окружении настроено псевдоархивирование: когда наступает время отправки сегмента в архив, вызывается команда /bin/true, которая ничего не делает и лишь возвращает код успешного завершения. Тем не менее это позволяет увидеть статистику архивирования:
```text {label="text" .source-commands hl_lines="1"}
# TABLE pg_stat_archiver;
-[ RECORD 1 ]------+------------------------------
archived_count | 45711
last_archived_wal | 00000001000000B20000009D
last_archived_time | 2022-12-07 06:43:05.091157+00
failed_count | 21
last_failed_wal | 000000010000004600000073
last_failed_time | 2022-11-17 05:52:27.826036+00
stats_reset | 2022-11-04 05:01:49.427562+00
```
Чтобы понять, как лучше использовать эту статистику, важно понимать классы проблем, которые могут возникнуть при архивировании журнала:
- ошибки передачи данных или отказ в обслуживании на стороне архива — в этом случае процесс архивирования не может передать сегмент в хранилище;
- ошибка при выполнении команды архивирования, например из-за ошибки в скрипте или его отсутствия;
- зависание процесса (по каким-то неизвестным причинам), ответственного за непосредственную отправку в архив;
- зависание процесса archiver — это маловероятный сценарий, однако его нельзя исключать полностью.
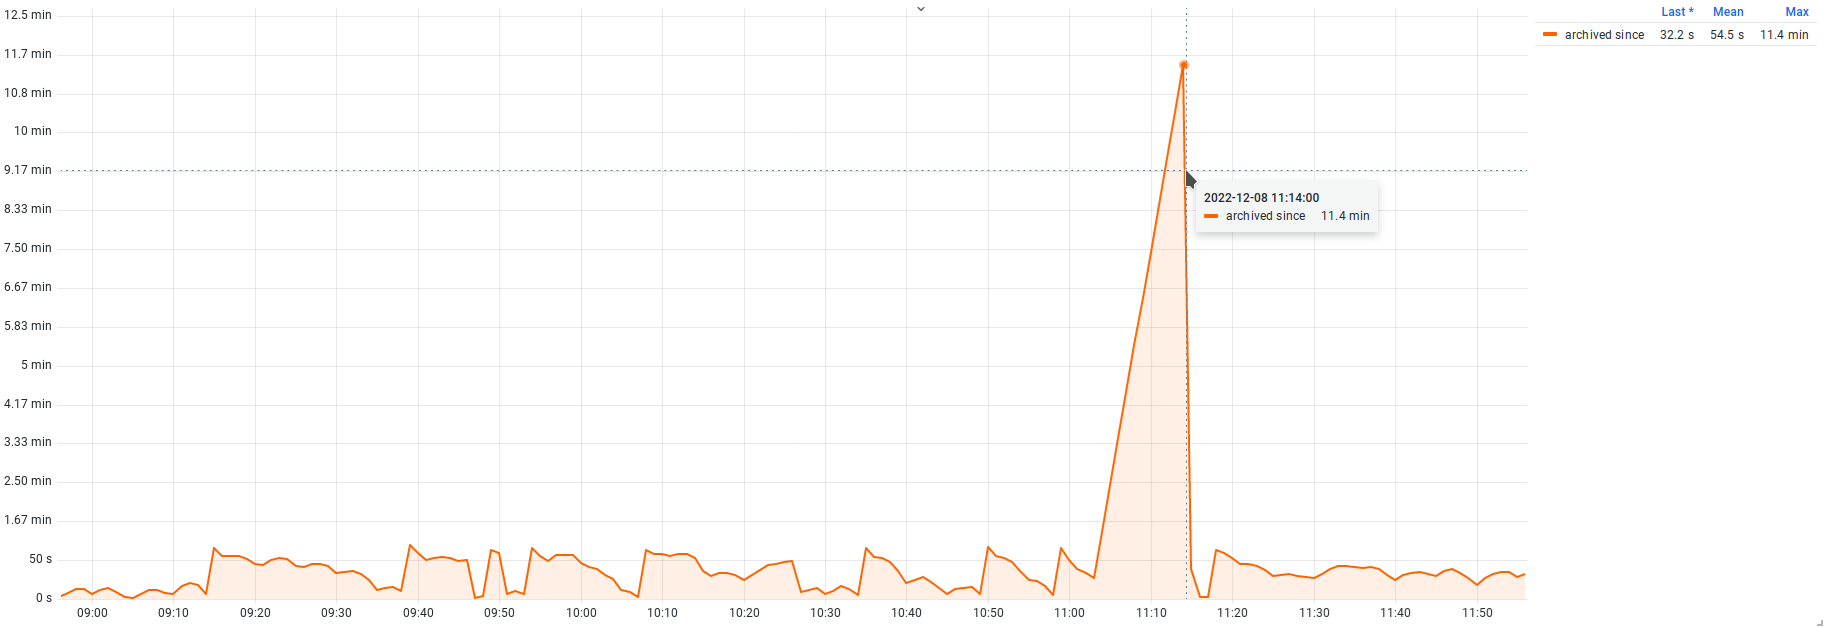
В первых двух сценариях необходимо отслеживать количество неудачных попыток архивирования. А если архивирование уже сломалось, важно понимать и то, как долго оно находится в таком состоянии. Для оценки хорошо подходят поля `failed_count` и `last_archived_time`. При возникновении ошибок счетчик `failed_count` начнет увеличиваться (а рост `archived_count` остановится). Факт увеличения количества ошибок более красноречив, чем отсутствие попыток архивирования, ведь система может быть не под нагрузкой и простаивать, а отсутствие успешных попыток архивирования может быть нормальным. То же самое справедливо и для времени: возраст `now() - last_archived_time` будет увеличиваться до тех пор, пока архивирование не будет восстановлено, и тоже является хорошим маркером наличия проблем с архивированием.
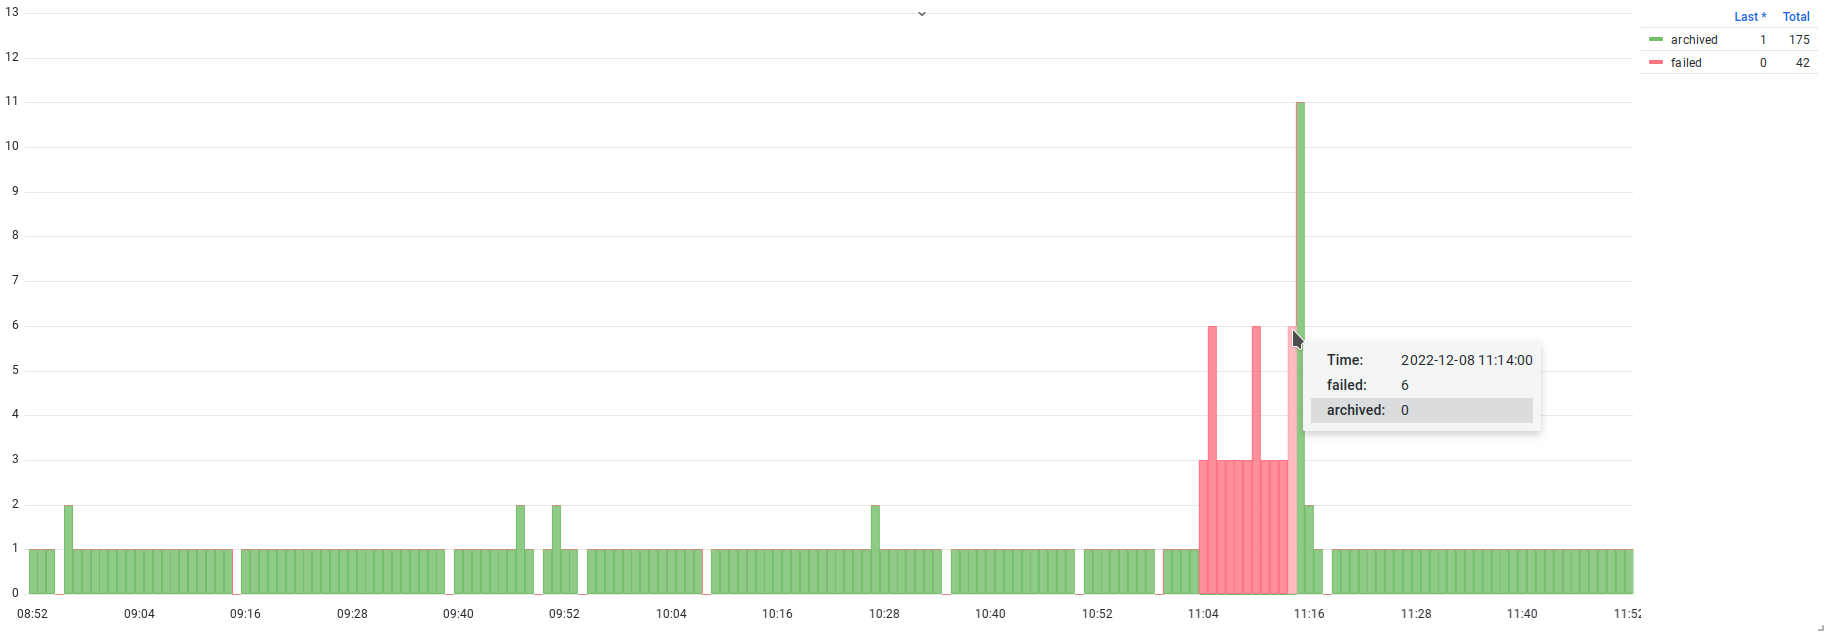
На рис. [6.6](/ru/06-write-ahead-log/#mon-figure-caption-136) изображен график с количеством успешных и неудачных попыток архивирования. Полоса неудачных попыток указывает на то, что в течение 10 минут архивирование не работало, сегменты при этом продолжали копиться. После того как проблема была устранена, наблюдается небольшой всплеск успешной отправки в архив накопившихся сегментов.
С проблемами вроде зависаний дело обстоит сложнее: в этой ситуации команда запустилась, но не может завершиться, а процесс архивирования ожидает ее завершения. В таком случае `archived_count`, `failed_count` и `last_failed_time` остаются без изменений, но при этом возраст `now() - last_archived_time` начинает расти, что указывает на остановку архивирования. На рис. [6.7](/ru/06-write-ahead-log/#mon-figure-caption-137) изображен график, демонстрирующий ту же самую остановку архивирования, что и на рис. [6.6](/ru/06-write-ahead-log/#mon-figure-caption-136). В среднем архивирование сегментов выполняется каждые 54 секунды, но был период, когда время увеличилось до 11 минут.
Ориентироваться на возраст последней успешной отправки удобно в активных системах с интенсивной и постоянной записью в журнал, где архивирование сегментов происходит регулярно. Для систем с малой активностью, эпизодической и небольшой записью в журнал, где между архивированием даже двух сегментов может проходить много времени, большой возраст `now() - last_archived_time` может и не указывать на проблему. Конечно, для принудительного архивирования можно использовать тайм-аут (см. *archive\_timeout*), по истечении которого выполняется переключение на запись в следующий сегмент журнала, а предыдущий отправляется в архив.
{#fig-6.6 num="6.6" caption="Успешные и неудачные попытки отправки сегментов в архив" width=1825 height=632}
{#fig-6.7 num="6.7" caption="Время с момента последней успешной отправки сегмента в архив" width=1824 height=627}
### Очередь архивирования {#mon-section-star-138}
Ранее рассмотренные способы оценки состояния архивирования опираются на конечный результат: был ли сегмент отправлен в архив. Существует еще один подход к отслеживанию работоспособности архивирования. Он учитывает необходимый объем работы и заключается в отслеживании количества сегментов в очереди на отправку. Если очередь пустая — значит, все хорошо, если очередь растет — значит, есть проблемы. Для реализации способа необходимо некоторое знание об устройстве файловой иерархии основного каталога данных.
Внутри каталога pg\_wal есть подкаталог archive\_status с набором файлов, описывающих статус архивирования конкретных сегментов.
```text {label="text" .source-commands hl_lines="1"}
# ls -l /var/lib/postgresql/data/pg_wal/archive_status/
-rw------- 1 postgres postgres 0 Nov 4 05:03 000000010000000000000011.0001F7A0.backup.done
-rw------- 1 postgres postgres 0 Dec 8 06:00 00000001000000B7000000D7.done
-rw------- 1 postgres postgres 0 Dec 8 06:01 00000001000000B7000000D8.done
-rw------- 1 postgres postgres 0 Dec 8 06:02 00000001000000B7000000D9.done
-rw------- 1 postgres postgres 0 Dec 8 06:04 00000001000000B7000000DA.done
-rw------- 1 postgres postgres 0 Dec 8 06:05 00000001000000B7000000DB.done
-rw------- 1 postgres postgres 0 Dec 8 06:06 00000001000000B7000000DC.done
-rw------- 1 postgres postgres 0 Dec 8 06:06 00000001000000B7000000DD.done
-rw------- 1 postgres postgres 0 Dec 8 06:08 00000001000000B7000000DE.done
```
В этом каталоге нас интересуют файлы с расширениями ready и done. Статус ready указывает на то, что соответствующий сегмент готов для архивирования, а статус done — на то, что сегмент был успешно отправлен в архив. Таким образом, чтобы получить число сегментов в очереди на отправку, нам нужно лишь подсчитать количество файлов с расширением ready. Размер очереди можно перевести в байты (умножить на размер сегмента, по умолчанию 16 МБ) и получить представление о том, сколько места на диске занимают сегменты, требующие архивирования. Для подсчета потребуется функция `pg_ls_archive_statusdir` либо ее более универсальный аналог `pg_ls_dir`:
```text {label="psql" .source-commands hl_lines="1 2 3"}
# SELECT count(*)
FROM pg_ls_archive_statusdir()
WHERE name ~'.ready';
count
-------
0
```
В тестовом окружении настроено псевдоархивирование командой /bin/true, при вызове которой не происходит реального копирования, однако и такое архивирование отражается в статистике в `pg_stat_archiver`. В целях экспериментов архивирование можно «сломать», указав вместо /bin/true команду /bin/false.
Перед началом эксперимента можно выполнить запрос к статистике и зафиксировать образец того, как выглядит рабочее состояние архивирования:
```text {label="psql" .source-commands hl_lines="1 2"}
# SELECT *, now() - last_archived_time AS last_archived_age
FROM pg_stat_archiver;
-[ RECORD 1 ]------+------------------------------
archived_count | 47058
last_archived_wal | 00000001000000B7000000E0
last_archived_time | 2022-12-08 06:10:14.254712+00
failed_count | 0
last_failed_wal |
last_failed_time |
stats_reset | 2022-11-04 05:01:49.427562+00
last_archived_age | 00:00:09.227001
```
Теперь следует изменить параметр *archive\_command*:
```text {label="psql" .source-commands hl_lines="1 3"}
# ALTER SYSTEM SET archive_command TO '/bin/false';
ALTER SYSTEM
# SELECT pg_reload_conf();
pg_reload_conf
----------------
t
```
Понаблюдаем за тем, что теперь происходит в статистике:
```text {label="psql" .source-commands hl_lines="1 2"}
# SELECT *, now() - last_archived_time AS last_archived_age
FROM pg_stat_archiver;
-[ RECORD 1 ]------+------------------------------
archived_count | 47061
last_archived_wal | 00000001000000B7000000E3
last_archived_time | 2022-12-08 06:13:06.971114+00
failed_count | 75
last_failed_wal | 00000001000000B7000000E4
last_failed_time | 2022-12-08 06:17:23.115775+00
stats_reset | 2022-11-04 05:01:49.427562+00
last_archived_age | 00:04:21.452935
```
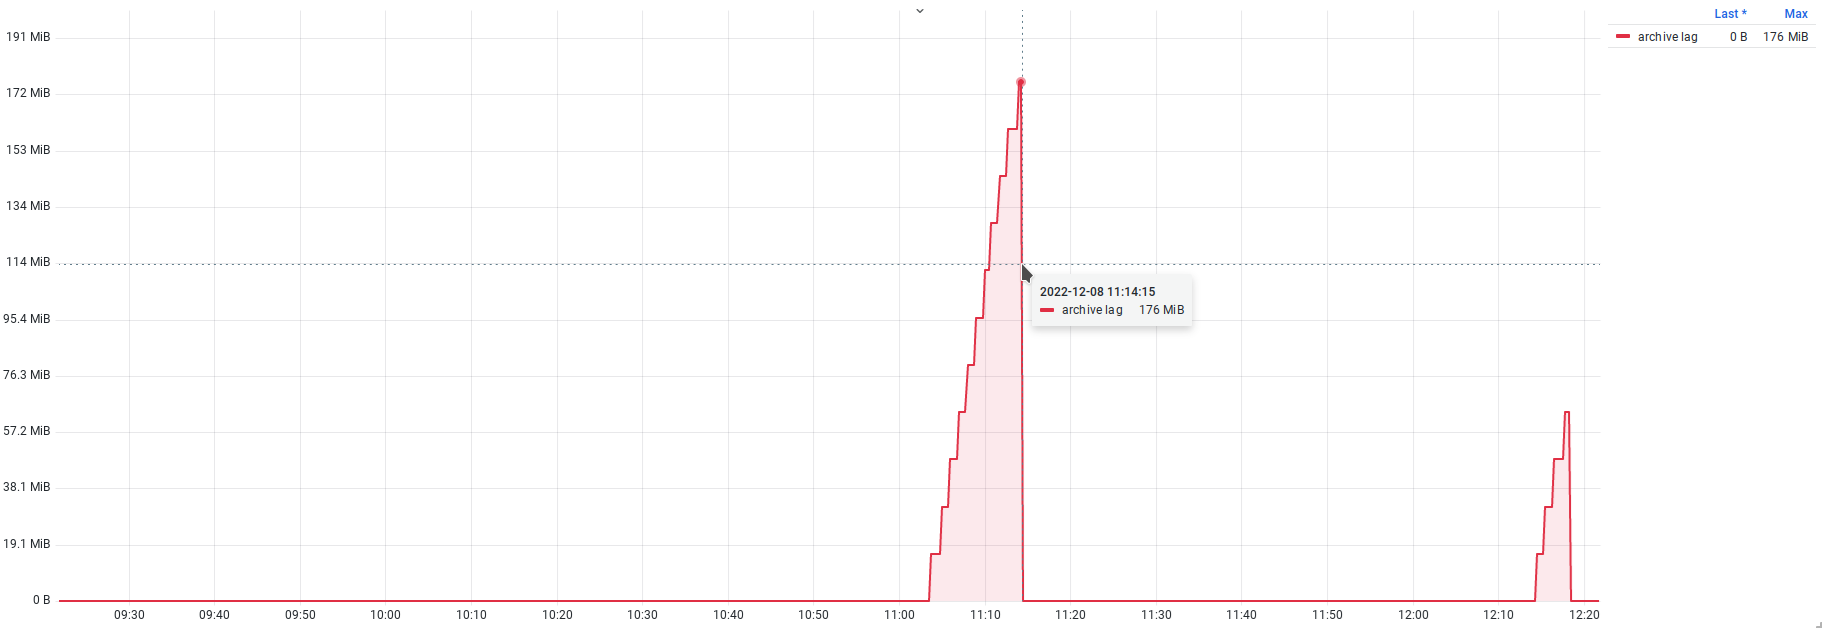
Счетчик `archived_count` остановился, а `failed_count` начал расти; время с момента последней успешной попытки архивирования в добавленном поле `last_archived_age` также растет и достигло четырех минут. Проверим, что в каталоге статусов:
```text {label="psql" .source-commands hl_lines="1 2"}
# SELECT *
FROM pg_ls_archive_statusdir() ORDER BY modification;
name | size | modification
-----------------------------------------------+------+------------------------
000000010000000000000011.0001F7A0.backup.done | 0 | 2022-11-04 05:03:21+00
00000001000000B7000000E0.done | 0 | 2022-12-08 06:10:14+00
00000001000000B7000000E1.done | 0 | 2022-12-08 06:11:08+00
00000001000000B7000000E2.done | 0 | 2022-12-08 06:12:06+00
00000001000000B7000000E3.done | 0 | 2022-12-08 06:13:06+00
00000001000000B7000000E4.ready | 0 | 2022-12-08 06:14:15+00
00000001000000B7000000E5.ready | 0 | 2022-12-08 06:15:17+00
00000001000000B7000000E6.ready | 0 | 2022-12-08 06:16:19+00
00000001000000B7000000E7.ready | 0 | 2022-12-08 06:17:29+00
```
Появились файлы с расширением ready, можно их посчитать и определить количество сегментов в очереди на архивирование:
```text {label="psql" .source-commands hl_lines="1 2"}
# SELECT count(*)
FROM pg_ls_archive_statusdir() WHERE name ~'.ready';
count
-------
4
```
Соответствующие измерения можно отразить на графике (рис. [6.8](/ru/06-write-ahead-log/#mon-figure-caption-139)):
{#fig-6.8 num="6.8" caption="Очередь архивирования в байтах" width=1823 height=629}
Способ с размером очереди является универсальным, не зависит от активности и объемов записи в журнал и позволяет отслеживать как ошибки в архивировании, так и случаи, связанные с зависанием.
После экспериментов не забываем откатить конфигурацию:
```text {label="psql" .source-commands hl_lines="1 2"}
# ALTER SYSTEM RESET archive_command;
# SELECT pg_reload_conf();
```
## Резюме {#mon-p173-h453}
- Журнал упреждающей записи — важный компонент любой СУБД, который хранит историю всех изменений.
- Журнал представляет собой непрерывную последовательность файлов-сегментов.
- Для детального анализа содержимого журнала используются утилита pg\_waldump и расширение `pg_walinspect`.
- Для отслеживания общей активности, связанной с журналом, используется представление `pg_stat_wal`.
- `pg_stat_statements` содержит статистику записи в журнал для конкретных запросов.
- Журнал также используется для резервного копирования и репликации.
- Журнал можно архивировать для задач резервного копирования и восстановления.
- Для отслеживания архивирования используется представление `pg_stat_archiver`.
- Отслеживание очереди архивирования — наиболее универсальный способ выявления проблем.
[^mon-160-1]: [www.interdb.jp/pg/pgsql10.html#\_10.3.1.]()
[^mon-160-2]: [postgrespro.ru/docs/postgresql/current/continuous-archiving]()
[^mon-160-3]: [postgrespro.ru/docs/postgresql/current/pgwaldump]()
[^mon-160-4]: [postgrespro.ru/docs/postgresql/current/pgwalinspect]()
[^mon-162-1]: [postgrespro.ru/docs/postgresql/current/wal-async-commit]()
[^mon-162-2]: [postgrespro.ru/docs/postgresql/current/wal-configuration]()
[^mon-162-3]: [www.interdb.jp/pg/pgsql09.html]()
[^mon-168-1]: [postgrespro.ru/docs/postgresql/current/continuous-archiving]()