# Область общей памяти и ввод-вывод
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
> [!NOTE]
> **В этой главе мы рассмотрим:**
>
> - как анализировать содержимое общей памяти;
>
> - представления `pg_buffercache` и `pg_shmem_allocations`;
>
> - использование буферов в общем кеше;
>
> - как анализировать память клиентских процессов;
>
> - представление `pg_stat_slru`;
>
> - как оценивать ввод-вывод на уровне объектов баз данных;
>
> - как оценивать ввод-вывод на уровне выполнения запросов;
>
> - что такое временные файлы и как оценивать их использование;
>
> - как оценивать ввод-вывод процессов фоновой записи и процесса контрольной точки;
>
> - представление `pg_stat_bgwriter`;
>
> - особенности выполнения контрольных точек;
>
> - как оценивать запись буферов различными процессами СУБД.
В предыдущих главах мы рассмотрели запросы и основные объекты СУБД. Запросы определяют рабочую нагрузку и направлены на объекты СУБД — таблицы и индексы. Для размещения пользовательских и системных данных и выполнения запросов СУБД нужна отдельная область в оперативной памяти. Память является быстрой, но энергозависимой, и для надежного хранения данных используются другие накопители, уступающие ей в скорости. Этим обусловлена необходимость перемещения данных между «быстрой» оперативной памятью и «медленным» основным хранилищем. Такое перемещение данных можно назвать довольно общим термином *ввод-вывод* (input/output). С точки зрения производительности важно понимать объем и скорость выполняемого ввода-вывода, ведь это напрямую влияет на производительность — чем быстрее данные перемещаются между областью в памяти и основным хранилищем, тем быстрее будут выполняться запросы и тем больше их можно выполнить. В этой главе мы рассмотрим средства, имеющиеся в СУБД, и способы оценки, которые могут потребоваться для мониторинга ввода-вывода с точки зрения объектов СУБД, фоновых процессов и выполнения запросов.
## 5.1. Анализ общей памяти {#mon-section-5-1}
Область общей памяти используется для оперативного размещения данных таблиц, индексов и большого количества различных служебных структур. Общей она называется потому, что все процессы СУБД имеют к ней равный доступ и изменения, внесенные одним процессом, становятся доступными всем остальным. Как правило, самой большой частью общей памяти является *буферный*, или, как его еще называют, *общий кеш*, который используется для размещения пользовательских данных.
С буферным кешем почти никогда не возникает проблем ровно до тех пор, пока он способен вместить себя все данные из основного хранилища (основной каталог данных и табличные пространства). Однако, когда объем хранимых данных превышает объем общего кеша, появляется задача эффективного использования отведенного объема: как держать в нем нужные данные и замещать ненужные в случае нехватки места. Могут возникнуть вопросы: какие системные структуры находятся в общей памяти и сколько они занимают места? Какие объекты (таблицы, индексы) находятся в буферном кеше? Каковы размеры и доля этих объектов относительно друг друга? Насколько эффективно используется буферный кеш? Какой процент обращений заканчивается успехом? Как часто данные не удается найти и приходится обращаться к основному хранилищу? Для ответа на эти вопросы СУБД предлагает несколько инструментов, которые можно использовать как для разового анализа, так и для регулярного мониторинга:
- `pg_buffercache`[^mon-131-1] — отдельное расширение с представлением (на основе функции), которое показывает использование буферов общего кеша;
- `pg_shmem_allocations`[^mon-131-2] — представление с информацией о том, какие служебные структуры находятся в общей памяти.
С помощью этих представлений можно получить информацию о содержимом общей памяти с точки зрения как таблиц и индексов, так и внутренних служебных структур. Давайте более подробно рассмотрим оба инструмента и сценарии их использования.
### Представление pg\_buffercache {#mon-section-star-106}
Расширение `pg_buffercache` предоставляет возможность анализа буферного кеша с точки зрения пользовательских объектов и помогает получить ответы на такие вопросы, как:
- страницы каких таблиц и индексов находятся в общем кеше;
- какое количество буферов используется для размещения таблиц и индексов, их процентное отношение относительно всего объема кеша;
- сколько свободных и занятых («чистых» или «грязных») буферов находятся сейчас в кеше.
Для использования расширения достаточно установить его с помощью команды `CREATE EXTENSION`. После установки появятся соответствующие функция и представление. В тестовом окружении расширение уже установлено и готово к использованию.
```text {label="psql" .source-commands hl_lines="1"}
# SELECT * FROM pg_buffercache LIMIT 10;
bufferid | relfilenode | reltablespace | reldatabase | relforknumber | relblocknumber | isdirty | usagecount | pinn...
----------+-------------+---------------+-------------+---------------+----------------+---------+------------+-----...
1 | 1262 | 1664 | 0 | 0 | 0 | f | 5 | 0
2 | 1260 | 1664 | 0 | 0 | 0 | f | 5 | 0
3 | 1259 | 1663 | 5 | 0 | 0 | f | 5 | 0
4 | 1259 | 1663 | 5 | 0 | 1 | f | 5 | 0
5 | 1259 | 1663 | 5 | 0 | 2 | f | 5 | 0
6 | 1259 | 1663 | 5 | 0 | 3 | f | 5 | 0
7 | 1249 | 1663 | 5 | 0 | 0 | f | 5 | 0
8 | 1249 | 1663 | 5 | 0 | 1 | f | 5 | 0
9 | 1249 | 1663 | 5 | 0 | 2 | f | 5 | 0
10 | 1249 | 1663 | 5 | 0 | 3 | f | 5 | 0
```
Каждая строка описывает отдельный буфер; соответственно, чем больше размер буферного кеша, тем больше будет строк в представлении. На основе практического опыта отмечу, что не помню случаев, когда бы могла понадобиться информация по отдельно взятому буферу: обычно нужна статистика, сгруппированная по объектам, базам и таблицам. При составлении запросов к `pg_buffercache` важно учитывать, что расширение устанавливается в конкретную БД, но статистика описывает все буферы, в том числе и те, что ассоциированы с объектами в других БД. Для преобразования числовых идентификаторов в имена таблиц и других отношений можно выполнить соединение с `pg_class`, но такое преобразование будет работать только для объектов из данной БД. В таких случаях рекомендуется добавить условие, чтобы выводить буферы только для текущей БД, а не всех вообще.
Представление содержит несколько полей:
- `bufferid` — идентификатор конкретного буфера. У свободных (неиспользуемых) буферов значения всех полей, кроме `bufferid`, будут отсутствовать (`NULL`);
- `relfilenode` — номер файла отношения (ссылается на `pg_class.relfilenode`); по этому номеру объект можно найти в основном каталоге данных;
- `reltablespace` — идентификатор табличного пространства отношения (ссылается на поле `pg_tablespace.oid`);
- `reldatabase` — идентификатор базы данных (ссылается на `pg_database.oid`). Общие объекты, принадлежащие системному каталогу, будут иметь нулевое значение;
- `relforknumber` — идентификатор, указывающий на слой отношения (main, visibility map, free space map, init);
- `relblocknumber` — номер блока внутри отношения;
- `isdirty` — флаг, указывающий на то, что буфер является грязным и содержимое находящегося в нем блока отличается от содержимого блока в основном хранилище;
- `usagecount` — счетчик обращений к буферу, который используется алгоритмом Clock Sweep для вытеснения неиспользуемых страниц из общего кеша[^mon-133-1];
- `pinning_backends` — текущее количество закреплений буфера клиентскими процессами.
> [!NOTE]
> **Закрепление буферов**
>
> Пока процесс читает страницу, буфер необходимо блокировать от попыток изменения другими процессами, но долгая блокировка буфера негативно скажется на конкурентной работе. Благодаря правилам видимости строк блокировка буфера нужна только на время чтения оглавления страницы; однако по-прежнему важно, чтобы страница не была вытеснена из буфера и содержимое страницы не изменилось кардинально. Чтобы ограничить спектр возможных действий с буфером, не блокируя его, используется так называемое *закрепление* (pin) буфера, которое позволяет другим процессам читать и изменять данные, но не позволяет вытеснять страницу из буфера или очищать ее.
Используя числовые идентификаторы, можно точно определить объекты (таблицы и индексы) в буферном кеше, их принадлежность к конкретным базам данных и даже с помощью функции `pg_relation_filepath` узнать их расположение в файловой системе.
На основе полей `isdirty`, `usagecount` и `pinning_backends` можно выделить набор состояний, в которых могут находиться буферы, и таким образом определить степень использования буферного кеша. После инициализации буферного кеша на старте СУБД бóльшая часть буферов не используется и не ассоциирована ни с одним из блоков (отсутствуют все значения, кроме `bufferid`). При выполнении запросов СУБД обращается к основному хранилищу и заполняет буферный кеш данными таблиц и индексов; буферы из свободного состояния переходят в занятое. В этом состоянии буферы ассоциированы с конкретными блоками таблиц и индексов. Такое состояние определяется полями `reltablespace`, `reldatabase` и `relfilenode`, которые вместе указывают на ассоциированный с буфером объект.
Также можно принять во внимание значение `usagecount`, которое показывает текущую интенсивность обращений к буферу. Этот счетчик увеличивается на единицу при каждом доступе (максимальное значение — 5) и уменьшается на единицу при каждом проходе алгоритма вытеснения. Блок вытесняется и заменяется другим блоком, если к моменту уменьшения счетчика его значение уже равно нулю. Таким образом, по значению `usagecount` (от 0 до 5) можно определить, насколько активно используются буферы.
Состояние занятого буфера можно детализировать. Так, например, к буферу могут обращаться клиентские процессы, читая или изменяя данные блока, на что указывает ненулевое значение `pinning_backends`. Если содержимое буфера было изменено, он становится грязным, и эти изменения должны быть перенесены в ассоциированный с буфером блок в основном хранилище. На грязное состояние указывает флаг `isdirty`.
Таким образом, использование буферного кеша можно рассматривать как минимум в двух проекциях:
1. На верхнем уровне по свободным, используемым, закрепленным и грязным буферам.
2. На детальном уровне на основе счетчика обращений (`usagecount`), значения которого варьируются от 0 до 5.
При использовании `pg_buffercache` в регулярном мониторинге стоит учитывать, что представление показывает только снимок состояния буферов в момент опроса; состояние буферов между опросами остается неизвестным. Это поведение аналогично тому, как работают `pg_locks` и `pg_stat_activity`.
> [!NOTE]
> **Влияние на производительность**
>
> До версии PostgreSQL 10 внутренний механизм `pg_buffercache` использовал блокировки для получения согласованного состояния всех буферов. Эти блокировки приводили к снижению производительности в системах с интенсивной рабочей нагрузкой. Начиная с версии 10 блокировки в менеджере буферов больше не устанавливаются. Поэтому обращения к `pg_buffercache` стали меньше влиять на обычную активность буферов, но набор результатов, полученный для всех буферов, в целом может оказаться несогласованным (что, как правило, некритично). Внутри каждого отдельного буфера согласованность информации по-прежнему гарантируется.
Давайте вернемся чуть назад, к SQL-запросу к `pg_buffercache`. Практически весь его вывод представлен числовыми идентификаторами; для получения более понятной информации потребуется соединить результат с дополнительными источниками информации и проделать некоторые преобразования.
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16"}
# SELECT
n.nspname,
c.relname,
count(*) AS buffers,
pg_size_pretty(count(*) * 8192) AS bytes
FROM pg_buffercache b
JOIN pg_class c
ON b.relfilenode = pg_relation_filenode(c.oid) AND
b.reldatabase IN (
0,
(SELECT oid FROM pg_database WHERE datname = current_database())
)
JOIN pg_namespace n ON n.oid = c.relnamespace
GROUP BY n.nspname, c.relname
ORDER BY 3 DESC
LIMIT 10;
```
```text {label="text"}
nspname | relname | buffers | bytes
------------+--------------------------------+---------+---------
public | pgbench_accounts | 9902 | 77 MB
public | pgbench_accounts_pkey | 5234 | 41 MB
public | pgbench_tellers | 290 | 2320 kB
public | pgbench_history | 198 | 1584 kB
pg_catalog | pg_proc | 99 | 792 kB
pg_catalog | pg_attribute | 38 | 304 kB
pg_catalog | pg_class | 15 | 120 kB
pg_catalog | pg_proc_proname_args_nsp_index | 14 | 112 kB
pg_catalog | pg_operator | 14 | 112 kB
pg_catalog | pg_statistic | 13 | 104 kB
```
Полученный результат стал более понятен: вместо числовых идентификаторов объектов теперь выводятся имена, статистика сгруппирована по объектам, а блоки просуммированы и дополнительно выражены в байтах. Теперь видно, что бóльшую часть в буферном кеше (в тестовом окружении значение *shared\_buffers* установлено в 128 МБ) занимают таблица pgbench\_accounts и ее индекс.
> [!NOTE]
> **Преобразование в байты**
>
> В тестовом окружении мне заранее известен размер блока, и в примерах запросов используется константа 8192. Однако на практике размер блока может быть переопределен на этапе компиляции из исходных кодов, и в таких случаях преобразование будет неверным. Вместо константы можно использовать более универсальное решение и получать актуальный размер блока из конфигурации СУБД вызовом функции `current_setting('block_size')`. Такой способ предпочтителен, когда нужно выразить размер блоков в байтах, но при этом точный размер блока неизвестен.
Следующим запросом можно получить информацию об использовании буферного кеша и узнать соотношение объемов буферов, находящихся в разных состояниях.
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12"}
# SELECT
pg_size_pretty(count(*) FILTER (
WHERE reldatabase IS NULL) * 8192) AS free,
pg_size_pretty(count(*) FILTER (
WHERE pinning_backends = 0 AND isdirty = 'f') * 8192) AS clean,
pg_size_pretty(count(*) FILTER (
WHERE pinning_backends > 0 AND isdirty = 'f') * 8192) AS "clean/pinned",
pg_size_pretty(count(*) FILTER (
WHERE pinning_backends = 0 AND isdirty = 't') * 8192) AS dirty,
pg_size_pretty(count(*) FILTER (
WHERE pinning_backends > 0 AND isdirty = 't') * 8192) AS "dirty/pinned"
FROM pg_buffercache;
```
```text {label="text"}
free | clean | clean/pinned | dirty | dirty/pinned
---------+-------+--------------+--------+--------------
0 bytes | 26 MB | 8192 bytes | 102 MB | 40 kB
```
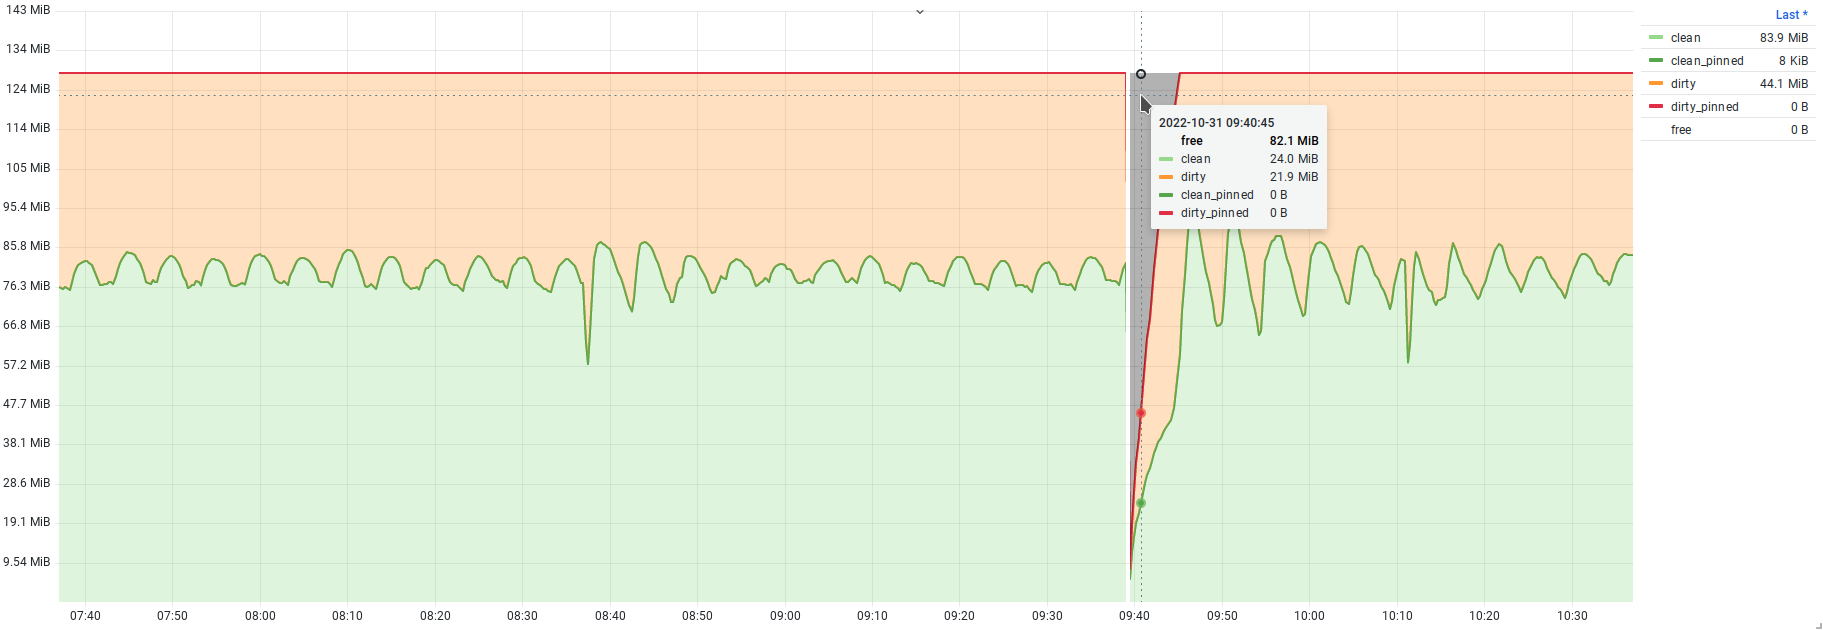
В выводе запроса видно, что бóльшая часть буферов является грязными. Это говорит о том, что вносится довольно много изменений, и это действительно так: в главе, посвященной запросам, мы выяснили, что в тестовой рабочей нагрузке преобладают запросы на обновление записей в `pgbench_accounts`. В тестовом окружении агент мониторинга использует подобный запрос для получения метрики `postgres_shared_buffers_all_usage_bytes`, на основе которой можно построить следующий график (рис. [5.1](/ru/05-shared-memory-and-io/#mon-figure-caption-107)):
{#fig-5.1 num="5.1" caption="Использование буферов в общем кеше" width=1823 height=630}
На графике запечатлен момент перезапуска контейнера с СУБД, при котором происходит сброс буферного кеша. Некоторое время в буферном кеше присутствуют свободные буферы, однако они довольно быстро заканчиваются.
Другим вариантом отображения может быть график, на котором статистика сгруппирована по именам баз данных. Так можно отслеживать заполненность буферного кеша страницами конкретных баз данных, что может быть полезно, если в кластере используется много баз.
### Представление pg\_shmem\_allocations {#mon-section-star-108}
Расширение `pg_buffercache` показывает данные только о буферах, используемых под кеш для таблиц и индексов. Но кроме буферного кеша, в общей памяти размещаются различные служебные структуры, доступные всем процессам СУБД, как клиентским, так и фоновым. Для структурного анализа общей памяти можно использовать представление `pg_shmem_allocations`.
```text {label="psql" .source-commands hl_lines="1 2 3"}
# SELECT *
FROM pg_shmem_allocations
ORDER BY size DESC LIMIT 10;
name | off | size | allocated_size
----------------------+-----------+-----------+----------------
Buffer Blocks | 6843520 | 134217728 | 134217728
| | 6710784 | 6710784
XLOG Ctl | 54144 | 4208200 | 4208256
| 149586304 | 1900160 | 1900160
Buffer Descriptors | 5794944 | 1048576 | 1048576
CommitTs | 4792192 | 533920 | 534016
Xact | 4263040 | 529152 | 529152
Checkpointer Data | 146862208 | 393280 | 393344
Checkpoint BufferIds | 141323392 | 327680 | 327680
Subtrans | 5326336 | 267008 | 267008
```
Каждая строка описывает отдельный участок памяти, выделенный под конкретную служебную структуру. Самая большая структура в списке — область `Buffer Blocks`. Именно в ней размещается буферный кеш с данными пользовательских объектов, который можно детально исследовать с помощью `pg_buffercache`. Если посмотреть на полный вывод представления, то можно заметить, что в общей памяти размещается большое количество структур. Например, для версии 15 их около шестидесяти, а итоговое число может варьироваться в зависимости от конфигурации, используемых модулей и т. п. В самом представлении не так много полей:
- `name` — имя сегмента, по которому можно примерно понять его назначение. Сегмент, у которого отсутствует имя (`NULL`), представляет неиспользуемую память; сегменты с именем `` являются анонимными и могут использоваться для хранения информации о блокировках;
- `off` — смещение в области общей памяти, с которого начинается сегмент. У анонимных сегментов значение смещения отсутствует (`NULL`);
- `size` — размер сегмента в байтах;
- `allocated_size` — размер сегмента с учетом выравнивания (padding). Для свободной памяти и анонимных сегментов значения `size` и `allocated_size` всегда равны.
В повседневном мониторинге информация из `pg_shmem_allocations` не очень полезна. По большей части она может пригодиться в редких случаях поиска и устранения проблем или для контроля эффективности использования памяти при разработке и отладке новой функциональности СУБД.
## 5.2. Анализ памяти клиентских процессов {#mon-section-5-2}
Еще два инструмента, которые также могут пригодиться для отладки и поиска проблем, — это представление `pg_backend_memory_contexts` и функция `pg_log_backend_memory_contexts`. Оба инструмента предназначены для отображения информации по используемым сегментам памяти конкретного процесса, но поведение представления и функции отличаются друг от друга. Представление показывает распределение памяти только для процесса, ассоциированного с текущим сеансом, и его невозможно использовать, чтобы посмотреть раскладку памяти соседних процессов (которые, например, заняты выполнением долгого запроса). Для таких случаев следует использовать функцию `pg_log_backend_memory_contexts`, которая принимает в качестве аргумента идентификатор процесса и сбрасывает раскладку памяти в журнал СУБД.
```text {label="psql" .source-commands hl_lines="1 2"}
# SELECT * FROM pg_backend_memory_contexts
ORDER BY used_bytes DESC LIMIT 10;
name | ident | parent | level | total_bytes | total_nblocks | free_bytes | free_chunks
-------------------------+-------+------------------+-------+-------------+---------------+------------+------------...
CacheMemoryContext | | TopMemoryContext | 1 | 1048576 | 8 | 499872 | 2
Timezones | | TopMemoryContext | 1 | 104120 | 2 | 2616 | 0
TopMemoryContext | | | 0 | 97680 | 5 | 12232 | 7
ExecutorState | | PortalContext | 3 | 49208 | 4 | 4280 | 3
WAL record construction | | TopMemoryContext | 1 | 50208 | 2 | 6360 | 0
MessageContext | | TopMemoryContext | 1 | 73728 | 4 | 30856 | 4
TupleSort main | | ExecutorState | 4 | 32824 | 2 | 6808 | 7
Type information cache | | TopMemoryContext | 1 | 24376 | 2 | 2616 | 0
smgr relation table | | TopMemoryContext | 1 | 32768 | 3 | 12712 | 8
Operator lookup cache | | TopMemoryContext | 1 | 24576 | 2 | 10752 | 3
```
В каждой строке содержится информация о конкретном участке памяти (так называемый *контекст*), метрики использования, а также дополнительные данные: родительский контекст, уровень вложенности, количество блоков (`total_nblocks`) и свободных фрагментов (`free_chunks`).
Применение этих инструментов может пригодиться скорее для отладки, поиска и устранения проблем, чем для регулярного мониторинга. Однако на данный момент (версия 15) это единственные инструменты, позволяющие детально проанализировать состав и использование памяти процессов СУБД.
## 5.3. Оценка использования SLRU-кешей {#mon-section-5-3}
Осталось рассмотреть еще одну группу кешей, SLRU-кеши (Simple Least-Recently-Used). Это отдельные кеши, призванные ускорять доступ к некоторым служебным структурам, которые размещаются на диске в основном каталоге данных. Примерами таких служебных структур являются:
- структуры журнала фиксации транзакций (clog, commit log);
- структуры, обеспечивающие работу вложенных транзакций (subtransactions);
- структуры отслеживания времени фиксации транзакций (см. *track\_commit\_timestamp*);
- структуры, связанные с подсистемой уведомлений (команды `LISTEN` и `NOTIFY`);
- прочие структуры, использующие кеши на основе SLRU-алгоритма.
Для отслеживания использования SLRU-кешей применяется представление `pg_stat_slru`:
```text {label="psql" .source-commands hl_lines="1"}
# SELECT * FROM pg_stat_slru;
name | blks_zeroed | blks_hit | blks_read | blks_written | blks_exists | flushes | truncates | ...
-----------------+-------------+----------+-----------+--------------+-------------+---------+-----------+----------...
CommitTs | 0 | 0 | 0 | 0 | 0 | 1424 | 0 | 2022-11-0...
MultiXactMember | 1 | 0 | 0 | 1 | 0 | 1424 | 0 | 2022-11-0...
MultiXactOffset | 1 | 1 | 4 | 5 | 0 | 1424 | 0 | 2022-11-0...
Notify | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 2022-11-0...
Serial | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 2022-11-0...
Subtrans | 7522 | 0 | 0 | 7462 | 0 | 1424 | 0 | 2022-11-0...
Xact | 471 | 79554357 | 48 | 1889 | 0 | 1424 | 0 | 2022-11-0...
other | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 2022-11-0...
```
Каждая строка содержит накопленную статистику использования конкретного SLRU-кеша (список кешей фиксирован):
- `name` — название SLRU-кеша;
- `blks_zeroed` — количество блоков, заполненных нулями во время инициализации;
- `blks_hit` — количество блоков, найденных в кеше;
- `blks_read` — количество блоков, которые потребовалось прочитать из основного хранилища на диске;
- `blks_written` — количество грязных блоков, которые потребовалось записать из кеша на диск;
- `blks_exists` — количество блоков, успешно найденных на диске;
- `flushes` — количество выполненных запросов на синхронизацию грязных блоков;
- `truncates` — количество выполненных запросов на удаление блоков ввиду их ненужности (при операциях обслуживания);
- `stats_reset` — отметка времени последнего сброса статистики.
Статистика использования SLRU-кешей пока может применяться только для мониторинга, поскольку конфигурация СУБД не предусматривает параметров, позволяющих регулировать их размеры (однако не исключено, что такие параметры могут появиться в будущем). Основной сценарий использования статистики — это оценка эффективности кешей.
## 5.4. Ввод-вывод в контексте объектов СУБД {#mon-section-5-4}
Статистика `pg_buffercache`, рассмотренная ранее, позволяет анализировать только общую картину использования буферного кеша. Мониторинг буферного кеша с помощью этого представления не дает полной информации об объеме ввода-вывода, поскольку содержит информацию только о тех объектах, что находятся в кеше в данный момент, и из поля зрения может пропасть множество других объектов БД, доступ к которым осуществлялся между снимками статистики. Для более полного учета ввода-вывода нужна статистика накопительного характера по всем объектам БД. Эта информация располагается в нескольких представлениях, с одним из которых нам уже приходилось сталкиваться:
- `pg_stat_database` содержит часть статистики ввода-вывода для отдельных баз данных;
- `pg_statio_all_tables` — статистика ввода-вывода по таблицам (включая TOAST и временные таблицы);
- `pg_statio_all_indexes` — статистика ввода-вывода по индексам;
- `pg_statio_all_sequences` — статистика ввода-вывода по последовательностям.
### Базы данных {#mon-section-star-109}
Представление `pg_stat_database` уже знакомо нам из предыдущих глав, и сейчас мы возвращаемся к нему, потому что оно содержит несколько полей с информацией о вводе-выводе в разрезе отдельных баз данных:
- `blks_hit` — количество блоков, найденных в общем и локальных кешах;
- `blks_read` — количество блоков, прочитанных с диска (включая найденные в страничном кеше ОС);
- `blk_read_time` — время, затраченное на чтение с диска, в миллисекундах;
- `blk_write_time` — время, затраченное на запись на диск, в миллисекундах.
Учет времени доступен только при включенном параметре *track\_io\_timing*. Для полноты картины не хватает только статистики по записанным и грязным блокам. На основе этих данных можно получить общее представление об эффективности использования кеша, однако важно помнить, что статистика содержит данные как по общему, так и по локальным кешам, что имеет особое значение при широком использовании временных таблиц.
Оценить эффективность и посчитать коэффициент попаданий в кеш можно следующим запросом:
```text {label="psql" .source-commands hl_lines="1 2"}
# SELECT sum(blks_hit) / sum(blks_hit + blks_read) AS hit_ratio
FROM pg_stat_database;
hit_ratio
------------------------
0.98473387049692560384
```
Полученная метрика показывает, насколько эффективно используется кеш. Значения, близкие к единице, говорят о том, что нужные данные успешно обнаруживаются в кеше. И наоборот, чем ближе значения к нулю, тем реже нужные данные обнаруживаются в кеше и тем чаще СУБД приходится обращаться к основному хранилищу, чтобы прочитать данные и затем загрузить их в кеш, при этом вытесняя из кеша другие данные. При постоянной низкой эффективности кеша много времени тратится на дисковый ввод-вывод, и это негативно сказывается на общей производительности. К сожалению, здесь нет простого или универсального решения, и повысить эффективность кеша можно разными способами. Самый очевидный — это увеличение общего кеша, однако такой способ не всегда приводит к успеху. Более правильным способом является выявление тех запросов, которые осуществляют бóльшую часть ввода-вывода или тратят на это значительное время, и попытка их оптимизации (с помощью рефакторинга или добавления индексов). За счет такой оптимизации можно в десятки и сотни раз улучшить производительность запросов и увеличить эффективность использования кеша, не прибегая к изменению конфигурации.
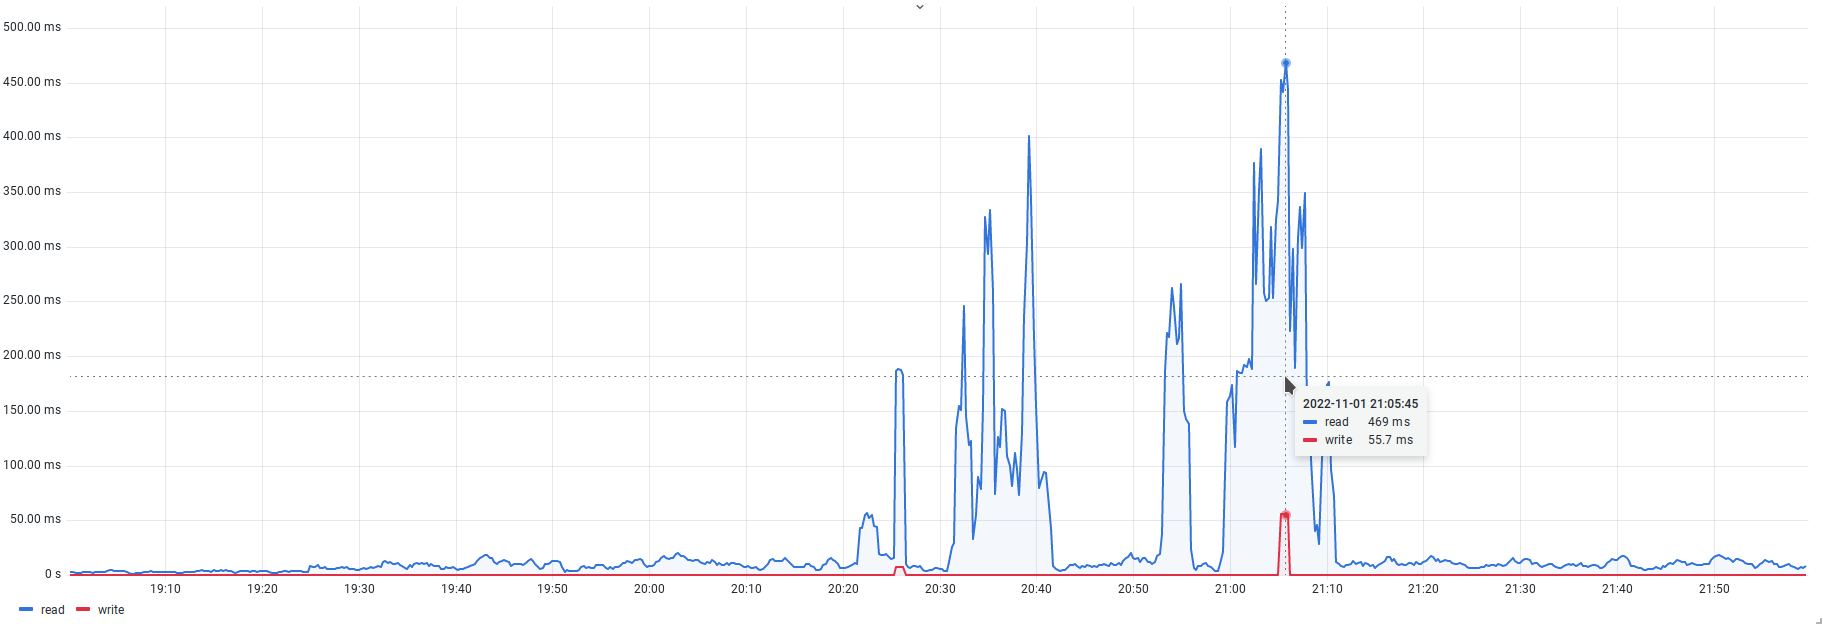
Еще один способ использования статистики — это отслеживание времени, затраченного на ввод-вывод, с помощью `blk_read_time` и `blk_write_time` (рис. [5.2](/ru/05-shared-memory-and-io/#mon-figure-caption-110)):
{#fig-5.2 num="5.2" caption="Время, затраченное на чтение и запись блоков" width=1823 height=626}
Такой график хорошо подходит для общей оценки состояния СУБД и отражает моменты, когда СУБД была вынуждена тратить время на чтение и запись, в результате чего могли возникать просадки производительности при выполнении запросов.
### Таблицы, индексы и последовательности {#mon-section-star-111}
Для получения более детальной информации о происходящем вводе-выводе на уровне отдельных объектов СУБД можно воспользоваться следующими представлениями:
- `pg_statio_all_tables` содержит статистику по каждой таблице:
— `heap_blks_read` — количество блоков, прочитанных с диска;
— `heap_blks_hit` — количество блоков, найденных в кеше;
— `idx_blks_read` — количество блоков всех индексов, принадлежащих этой таблице, прочитанных с диска; — `idx_blks_hit` — количество блоков всех индексов, принадлежащих этой таблице, найденных в кеше;
— `toast_blks_read` — количество блоков TOAST-таблицы, прочитанных с диска;
— `toast_blks_hit` — количество блоков TOAST-таблицы, найденных в кеше;
— `tidx_blks_read` — количество блоков индексов TOAST-таблицы, прочитанных с диска;
— `tidx_blks_hit` — количество блоков индексов TOAST-таблицы, найденных в кеше.
- `pg_statio_all_indexes` содержит статистику по каждому индексу:
— `idx_blks_read` — количество блоков, прочитанных с диска;
— `idx_blks_hit` — количество блоков, найденных в кеше.
- `pg_statio_all_sequences` содержит статистику по каждой последовательности:
— `blks_read` — количество блоков, прочитанных с диска;
— `blks_hit` — количество блоков, найденных в кеше.
Перечисленные представления содержат статистику по всем объектам, включая пользовательские и системные (которые принадлежат системному каталогу). Раздельную статистику по пользовательским и системным объектам можно найти в представлениях с префиксами `pg_statio_sys_` и `pg_statio_user_`.
Отдельного внимания заслуживает статистика попаданий в кеш (поля с суффиксом `_hit`). Когда блок найден в буферном кеше, ввода-вывода не происходит: блок уже находится в памяти, принадлежащей СУБД, так что достаточно прочитать в буфере нужную строку или даже ее часть. Важно понимать что статистика попаданий в кеш показывает объем найденных в кеше данных, но при этом реальный объем потребовавшихся данных может быть меньшим. При организации мониторинга нужно стараться избегать попыток прямого сравнения попаданий в кеш с объемом чтения и особенно представления обоих значений в байтах. Для оценки эффективности кеша лучше оценивать отношение попаданий в кеш к общему количеству обращений к данным (попаданиям в кеш и чтениям из хранилища). То же самое справедливо и в отношении статистики загрязнения буферов и записи страниц (поля `blks_dirtied` и `blks_written` в представлении `pg_stat_statements`): загрязнение блока при вставке, обновлении или удалении отдельных строк является лишь частичным изменением буфера и не приводит к вводу-выводу в отличие от записи блока непосредственно в основное хранилище. Этот нюанс важно учитывать при сведении метрик в один график или вычислении объемов ввода-вывода при составлении отчетов производительности и при выборе общих единиц измерения (блоков или байтов).
Другое важное замечание относится к индивидуальности этой статистики — базы данных являются своего рода изолированными контейнерами для таблиц, индексов и прочих объектов. Следовательно, представления содержат статистику только по тем объектам, которые принадлежат этой базе данных. Для сбора статистики по всем объектам в кластере баз данных необходимо подключаться по очереди к каждой отдельной БД.
Статистика по отдельным объектам дает детальную информацию по вводу-выводу, но обычно она требуется в исключительных случаях оптимизации или поиска узких мест в производительности. За годы моей практики случаи, когда требовалась такая подробная информация, можно пересчитать по пальцам одной руки. Во многих производственных окружениях может быть большое количество баз, таблиц и индексов. Мониторинг будет производить большой объем метрик, перед сбором и хранением которых важно оценить их практическую ценность.
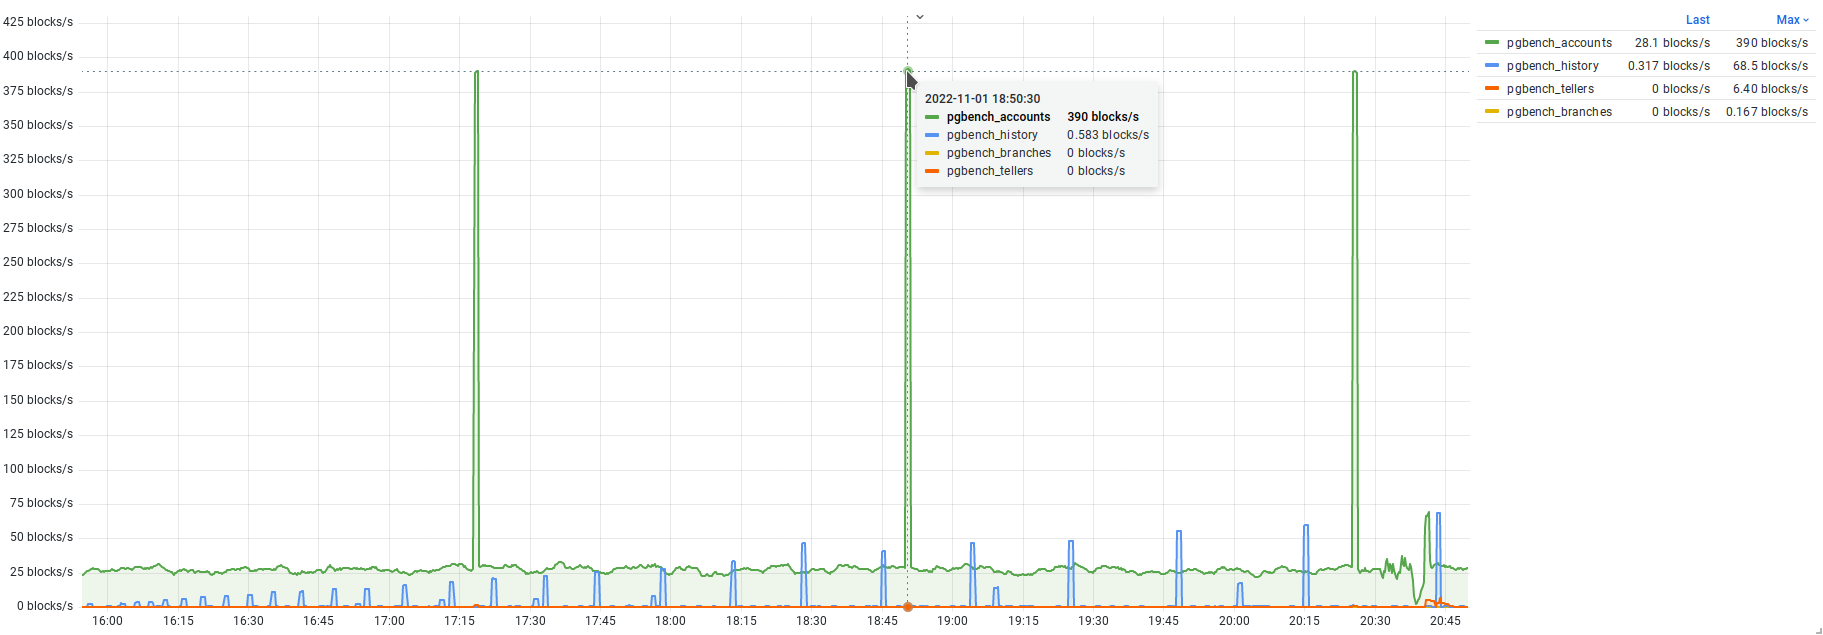
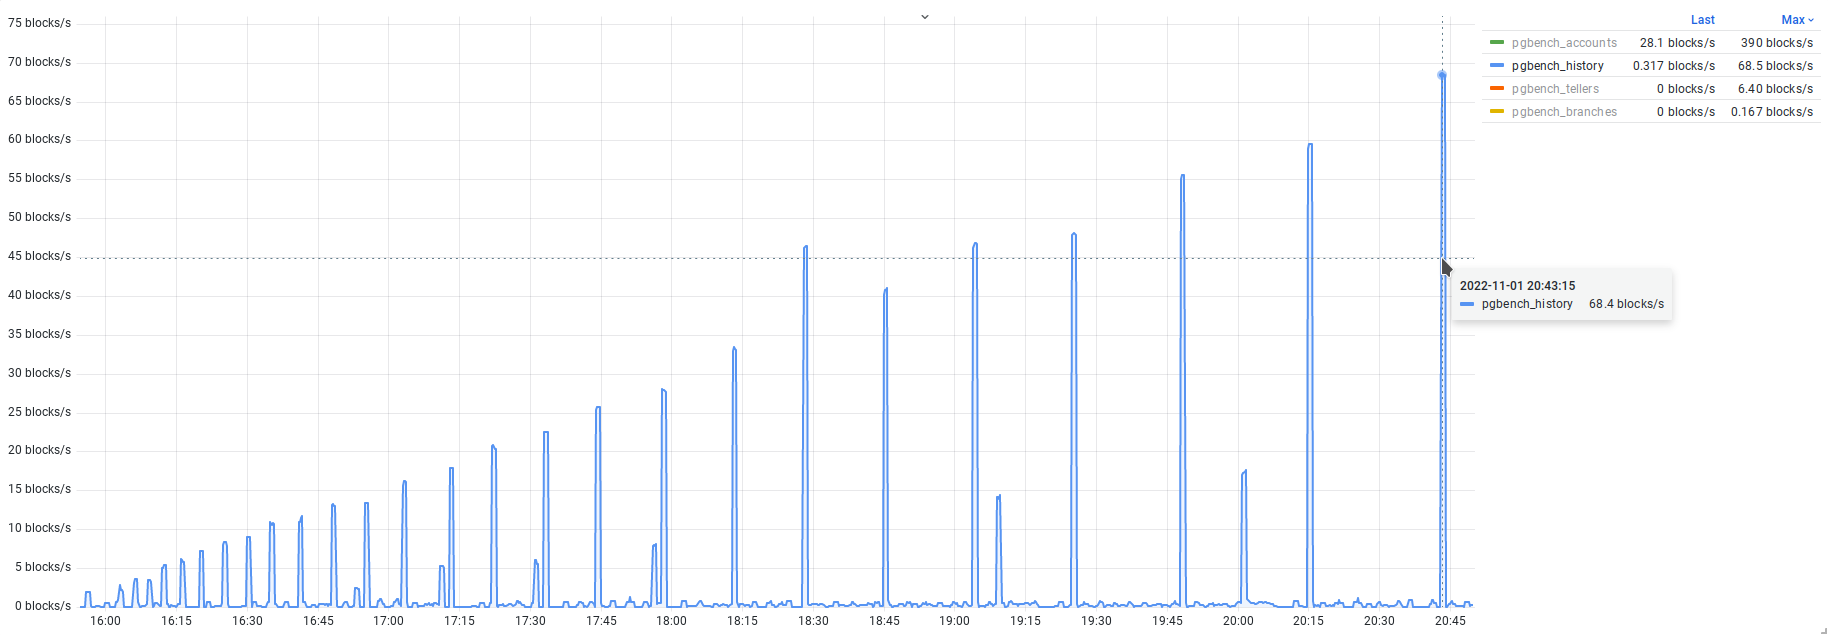
Следующим запросом можно получить объем чтения, который приходится на таблицы базы (рис. [5.3](/ru/05-shared-memory-and-io/#mon-figure-caption-112) и [5.4](/ru/05-shared-memory-and-io/#mon-figure-caption-113)):
```text {label="PromQL" .source-commands hl_lines="1 2"}
# sum by (table)
(rate(postgres_table_io_blocks_total{service_id="primary",access="read"}[1m]))
```
{#fig-5.3 num="5.3" caption="Объем чтения по таблицам" width=1823 height=635}
{#fig-5.4 num="5.4" caption="Объем чтения таблицы pgbench_history" width=1828 height=635}
Объем ввода-вывода на первом графике (рис. [5.3](/ru/05-shared-memory-and-io/#mon-figure-caption-112)) более или менее стабилен, но с точки зрения производственной эксплуатации все-таки могут возникнуть вопросы относительно периодических пиков, связанных с таблицей `pgbench_accounts`, и увеличения объема чтения таблицы `pgbench_history`, который менее заметен, чем пики, однако проявляется, если выключить остальные метрики (рис. [5.4](/ru/05-shared-memory-and-io/#mon-figure-caption-113)).
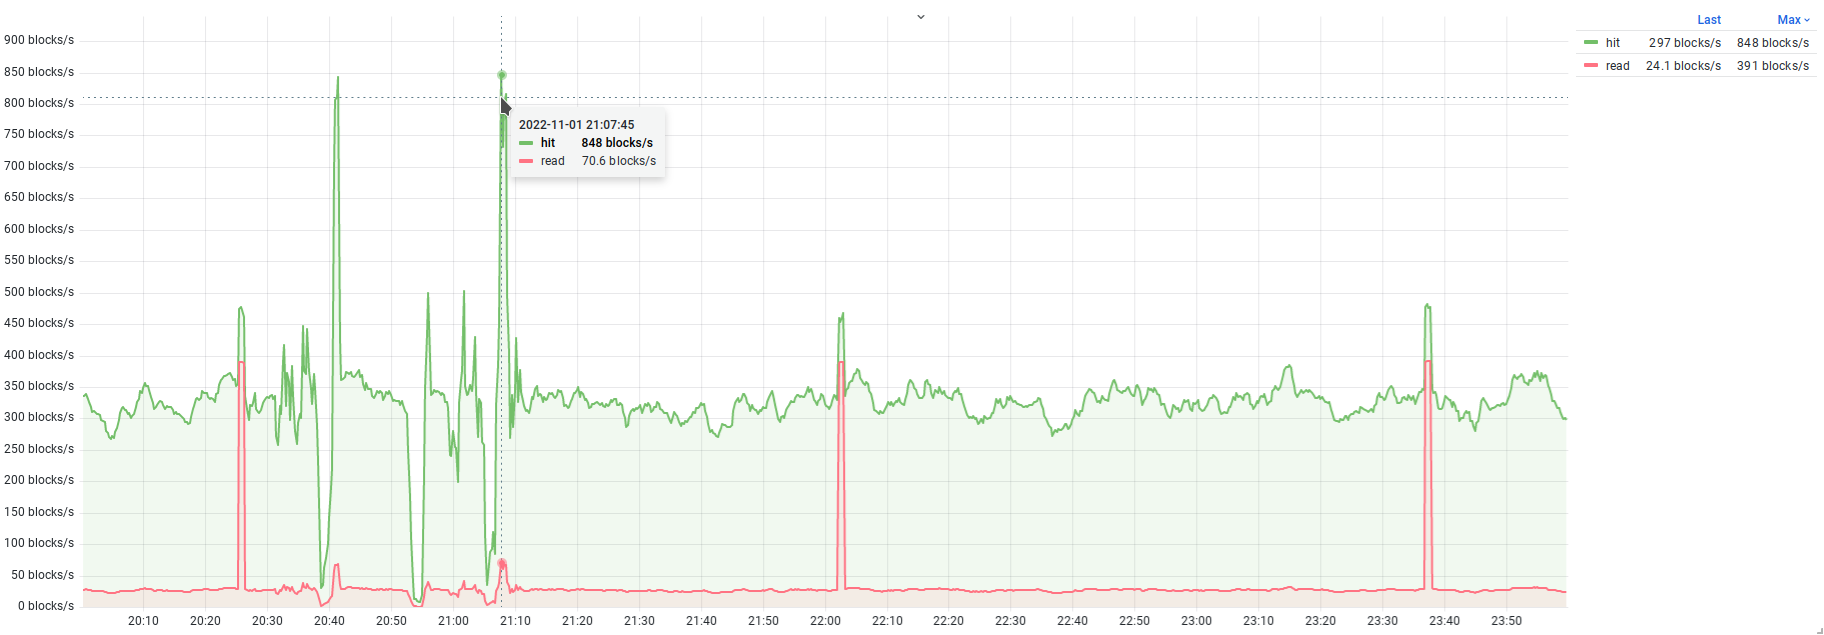
Следующий запрос показывает количество блоков, найденных в кеше и прочитанных с диска для таблицы `pgbench_accounts` (самая используемая таблица в тестовом окружении; рис. [5.5](/ru/05-shared-memory-and-io/#mon-figure-caption-114)):
```text {label="PromQL" .source-commands hl_lines="1 2 3"}
# sum by (access) (rate(postgres_table_io_blocks_total{
service_id="primary", table="pgbench_accounts"
}[1m]))
```
{#fig-5.5 num="5.5" caption="Объем ввода-вывода для таблицы pgbench_accounts" width=1824 height=635}
На графике видно, что большая часть блоков читается из кеша и относительно небольшая часть читается из основного хранилища (или страничного кеша ОС), что в общем хорошо для производительности. И, конечно, важно отметить, что в качестве единиц измерения используются блоки без какого-либо преобразования.
## 5.5. Ввод-вывод в контексте выполнения запросов {#mon-section-5-5}
Для анализа выполняемых запросов существует расширение `pg_stat_statements`, с которым мы успели познакомиться в предыдущих главах. Представление содержит массу полезной информации, в том числе и статистику ввода-вывода по каждому типу запроса. В отличие от `pg_stat_database` и `pg_statio_*` статистика по запросам более полная:
- `shared_blks_hit` — количество блоков, найденных в буферном кеше;
- `shared_blks_read` — количество блоков, прочитанных с диска или из страничного кеша ОС в общий буферный кеш;
- `shared_blks_dirtied` — количество блоков в общем буферном кеше, ставших грязными в результате внесения изменений;
- `shared_blks_written` — количество блоков в общем буферном кеше, содержимое которых было записано на диск.
Статистику дополняют аналогичные поля с данными по локальным кешам: `local_blks_hit`, `local_blks_read`, `local_blks_dirtied` и `local_blks_written`. В главе [3](/ru/03-queries-and-functions/#mon-chapter-3), посвященной запросам, рассмотрены поля `blk_read_time` и `blk_write_time`, которые показывают время, затраченное на ввод-вывод.
Статистику можно использовать в следующих сценариях:
- определение объемов ввода-вывода конкретными запросами;
- выявление запросов к временным таблицам и объем ввода-вывода, связанный с ними (для работы с временными таблицами используются локальные кеши, их размер определяется параметром *temp\_buffers*);
- оценка эффекта от внесенных оптимизаций (как изменился объем ввода-вывода при выполнении конкретных запросов);
- оценка ввода-вывода запросов при определении приоритета для оптимизации (оптимизация запроса с бóльшим объемом ввода-вывода будет заметнее и эффективнее с точки зрения утилизации ресурсов).
Также возможны и другие сценарии использования в каких-то особых случаях поиска и устранения проблем производительности.
## 5.6. Временные файлы {#mon-section-5-6}
Исполнение запросов, особенно сложных, состоит из нескольких шагов, соответствующих узлам плана. На этих шагах обычно происходит определенная работа с данными (выборка, фильтрация, сортировка, сравнение и т. д.). Для некоторых типов работ, таких как сортировка данных, построение хеш-таблицы для соединений и агрегаций или материализация CTE, может потребоваться временный буфер. Для него выделяется рабочая память размером *work\_mem*, обычно небольшая — по умолчанию 4 МБ. При этом запросы могут оперировать значительно бóльшими объемами данных. В случае нехватки рабочей памяти создается временный файл на диске и часть данных переносится в него. После того как запрос выполнен, все потребовавшиеся для его выполнения временные файлы удаляются. Ожидаемая особенность использования временных файлов — замедление производительности запросов, поскольку необходимые данные приходится записывать на диск и считывать с диска. С точки зрения производительности следует отслеживать все запросы, которые используют временные файлы и предпринимать шаги по их оптимизации с целью исключения необходимости ввода-вывода.
Статистика СУБД предлагает несколько источников для отслеживания временных файлов, которые могут пригодиться в разных сценариях:
- `pg_stat_database` содержит статистику по созданным временным файлам в контексте отдельных баз данных;
- `pg_stat_statements` содержит статистику по вводу-выводу во временные файлы в контексте выполнения запросов;
- в журналах сообщений СУБД также могут фиксироваться случаи использования временных файлов (см. *log\_temp\_files*), включая и тексты запросов.
Всем трем источникам присуща общая особенность: статистика использования фиксируется только в момент завершения запроса. Это неудобно, когда запрос выполняется долго и уже использует временные файлы, — обновление статистики произойдет только после его *успешного* завершения, а в случае аварийного завершения из-за тайм-аута (*statement\_timeout* и т. п.) или принудительного завершения администратором (функцией `pg_terminate_backend`) фиксации не произойдет.
Далее мы рассмотрим все способы получения статистики по временным файлам.
### Уровень баз данных {#mon-section-star-115}
Представление `pg_stat_database` содержит поля `temp_files` и `temp_bytes`, которые указывают на суммарное количество временных файлов и их размер. Как известно, каждая строка `pg_stat_database` содержит накопленную статистику по конкретной БД, соответственно, указанные поля будут содержать кумулятивную статистику за все время накопления (время сброса статистики указано в `stats_reset`).
```text {label="psql" .source-commands hl_lines="1 2 3"}
# SELECT datname, temp_files, pg_size_pretty(temp_bytes) AS temp_size
FROM pg_stat_database WHERE temp_files > 0
ORDER BY temp_bytes DESC;
datname | temp_files | temp_size
---------+------------+-----------
pgbench | 4 | 38 MB
| 1 | 178 kB
```
Запросы, выполняемые в тестовом окружении, практически не используют временных файлов, однако какую-то статистику все же можно увидеть. Далее для экспериментов будет использоваться следующий запрос, для выполнения которого гарантированно потребуется временный файл (при значении *work\_mem* по умолчанию):
```text {label="psql" .source-commands hl_lines="1"}
# SELECT a.*, b.* FROM pg_class a, pg_class b ORDER BY random();
```
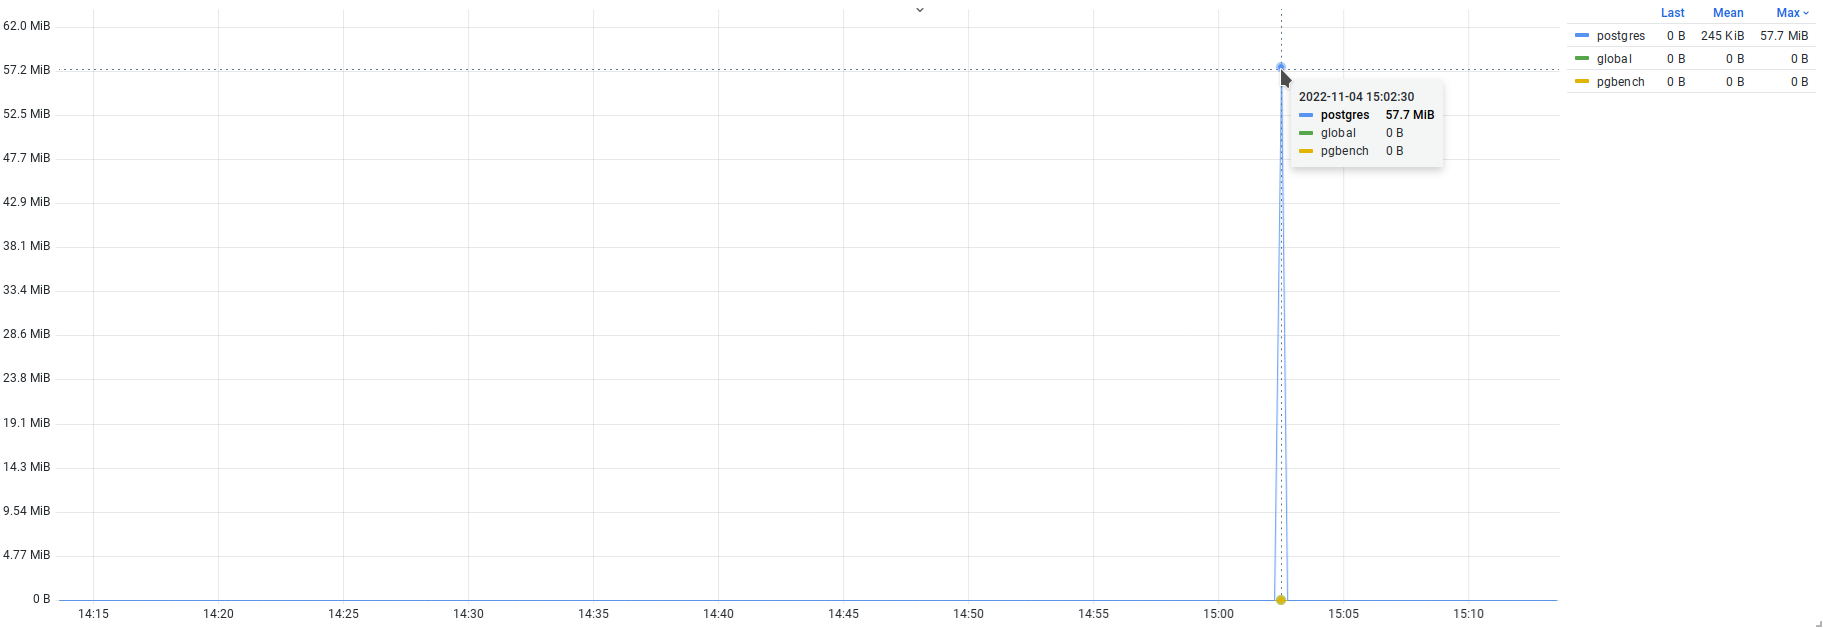
Запрос выполняется несколько секунд и создает временный файл размером около 60 МБ. Повторив запрос к `pg_stat_database`, можно обнаружить, что в БД `postgres` зафиксировано использование временного файла:
```text {label="psql" .source-commands hl_lines="1 2 3 4"}
# SELECT datname, temp_files, pg_size_pretty(temp_bytes) AS temp_size
FROM pg_stat_database
WHERE temp_files > 0
ORDER BY temp_bytes DESC;
datname | temp_files | temp_size
----------+------------+-----------
postgres | 1 | 58 MB
pgbench | 4 | 38 MB
| 1 | 178 kB
```
C помощью метрики `postgres_database_temp_bytes_total` можно получить график (рис. [5.6](/ru/05-shared-memory-and-io/#mon-figure-caption-116)):
{#fig-5.6 num="5.6" caption="Временный файл в БД postgres" width=1823 height=628}
Обычно такой график нужен для поверхностного отслеживания временных файлов: как только замечены критические уровни использования временных файлов, можно перейти к более детальному анализу с помощью `pg_stat_statements` или журналов сообщений.
Важной особенностью счетчика `temp_bytes` является фиксация итогового размера временного файла. Этот размер не следует путать с объемом ввода-вывода, связанного с файлом: чтение и запись в файл можно осуществлять многократно, и объем выполненного ввода-вывода может многократно превышать конечный размер файла.
### Ввод-вывод при выполнении запросов {#mon-section-star-117}
Расширение `pg_stat_statements` — это второй источник отслеживания временных файлов. Следующие столбцы одноименного представления показывают объем ввода-вывода запросов и время, затраченное на работу с временными файлами:
- `temp_blks_read` — количество блоков, прочитанных из временных файлов;
- `temp_blks_written` — количество блоков, записанных во временные файлы;
- `temp_blk_read_time` — время, затраченное на чтение временных файлов, в миллисекундах;
- `temp_blk_write_time` — время, затраченное на запись во временные файлы, в миллисекундах.
Отсутствие счетчиков `_hits` и `_dirtied` является нормальным, поскольку весь ввод-вывод осуществляется напрямую с файлом без кеширования. Более того, для работы с временным файлом используется техника, отличная от страничной, которая применяется при работе с буферными кешами (общим или локальными): ввод-вывод в этом случае работает с плотно упакованными строками без заголовков и только с нужными полями. В представлении также есть поле `dbid`, группировка по которому позволяет получить статистику по отдельным базам. Это может навести на мысли о сходстве с `pg_stat_database`, однако в нем ведется учет количества и размеров временных файлов, а в `pg_stat_statements` — объема ввода-вывода. Прямое сравнение значений из `pg_stat_database` и `pg_stat_statements` довольно бессмысленно.
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6"}
# SELECT calls, total_exec_time,
pg_size_pretty(temp_blks_read * 8192) AS temp_read_bytes,
pg_size_pretty(temp_blks_written * 8192) AS temp_written_bytes,
temp_blk_read_time, temp_blk_write_time,
left(query, 32) as query
FROM pg_stat_statements WHERE query ~ 'SELECT a.*, b.*';
-[ RECORD 1 ]-------+--------------------------------------------------------------
calls | 1
total_exec_time | 3262.312213999999
temp_blks_read | 115 MB
temp_blks_written | 115 MB
temp_blk_read_time | 96.354933
temp_blk_write_time | 257.18505
query | SELECT a.*, b.* FROM pg_class a, pg_class b ORDER BY random()
```
С точки зрения мониторинга запросов полезны также графики top-K, позволяющие быстро выявить запросы, которые больше остальных используют временные файлы. Однако в тестовом окружении нет подходящих запросов и такой график не покажет ничего интересного.
### Отслеживание в журнале сообщений {#mon-section-star-118}
Следующий способ отслеживания временных файлов предполагает использование журнала сообщений СУБД. По умолчанию запись сообщений о временных файлах выключена, для ее включения следует установить пороговое значение с помощью параметра *log\_temp\_files*. Если размер временного файла превысит это значение, информация о нем, включая и текст запроса, будет сохранена в журнале сообщений. Записи об использовании временных файлов имеют узнаваемую сигнатуру с текстом `temporary file` и указанием пути до файла и его размера в байтах, в следующей строке будет указан текст запроса:
```text {label="psql"}
LOG: temporary file: path "base/pgsql_tmp/pgsql_tmp51374.0", size 60497920
STATEMENT: SELECT a.*, b.* FROM pg_class a, pg_class b ORDER BY random();
```
> [!NOTE]
> **Следите за журналом**
>
> На практике произошел следующий случай. От системы мониторинга пришло уведомление о нехватке свободного места на диске. Довольно быстро выяснилось, что причина — в журналах сообщений: они стали занимать много места. При этом избыточный размер имели только журналы за последние два дня, размеры журналов за предыдущие дни были в десятки раз меньше. Анализ содержимого журналов показал, что в рабочей нагрузке появилось большое количество запросов с временными файлами. Но проблема была не в файлах, а в текстах запросов. Запрос содержал длинный `IN`-список, который автоматически генерировался приложением и не ограничивался по длине. В результате список содержал десятки тысяч `UUID`-значений, а текст запроса достигал нескольких мегабайт. При вставке записи об использовании временного файл дополнительно вставляется запись с текстом огромного запроса, что в результате и привело к увеличению объема журнала.
### Отслеживание активных временных файлов {#mon-section-star-119}
Недостаток отслеживания временных файлов с помощью представлений `pg_stat_database` и `pg_stat_statements` обусловлен тем, что статистика учитывается только после окончания запроса, который использовал временные файлы, а сами временные файлы к тому моменту уже удалены. Это нормально, если запросы выполняются быстро, однако в случае длительных запросов, работающих минутами, такое поведение может стать неприемлемым. В худшем случае количество и размер требуемых выполняющемуся запросу временных файлов могут увеличиваться до тех пор, пока не закончится все свободное место на диске, что может привести к аварийной остановке СУБД. Заметно будет только то, что заканчивается место, но по какой причине оно заканчивается, будет неочевидно. Размеры баз данных, таблиц и индексов при этом будут неизменны, а информация о временных файлах появится только после успешного завершения запроса.
Для эффективного отслеживания нужен способ обнаружения активных временных файлов, с которыми осуществляется работа в данный момент. Для этого нам потребуются функции для работы с файловой системой и некоторое знание об устройстве файловой иерархии каталога данных СУБД.
Начнем с устройства файловой системы. Для размещения временных файлов[^mon-149-1] СУБД руководствуется параметром *temp\_tablespaces*, в котором указывается список табличных пространств: одно из них выбирается из этого списка случайным образом, и временный файл создается в подкаталоге pgsql\_tmp выбранного пространства. Однако по умолчанию, да и вообще в большинстве конфигураций, значение *temp\_tablespaces* отсутствует (`NULL`); в таком случае используется табличное пространство по умолчанию для текущей базы данных. Обычно таким табличным пространством является `pg_default`, и временные файлы создаются в подкаталоге base/pgsql\_tmp. Имена временных файлов имеют формат `pgsql_tmpPPP.NNN`, где `PPP` — идентификатор клиентского процесса, которому принадлежит файл, а `NNN` — порядковый номер файла, которым отличаются файлы, принадлежащие одному процессу.
Зная каталоги, в которых размещаются временные файлы, остается просмотреть их и с помощью функций доступа к файловой системе получить статистику по временным файлам.
Для эксперимента откроем два сеанса и в первом запустим уже известный запрос, создающий временные файлы, однако модифицируем его, добавив еще одно соединение для увеличения объема выполняемой работы:
```text {label="psql" .source-commands hl_lines="1"}
# SELECT a.*, b.*, c.* FROM pg_class a, pg_class b, pg_class c ORDER BY random();
```
Запрос, выводящий нужную статистику, занимает несколько десятков строк, поэтому я не буду его приводить, однако его можно найти в каталоге scripts в тестовом окружении[^mon-150-1]. Во втором сеансе будем периодически запускать SQL-скрипт с запросом, который покажет не только увеличение размеров временного файла, но и появление новых сегментов:
```text {label="psql" .source-commands hl_lines="1"}
# \i /var/lib/postgresql/scripts/active_temp_files.sql
pid | query_age | filename | size | last_modification |
-------+-----------------+---------------------------------+---------+-------------------+--------------------------...
68403 | 00:02:06.101641 | base/pgsql_tmp/pgsql_tmp68403.0 | 1024 MB | 00:01:01.995852 | SELECT a.*, b.*, c.* FROM...
68403 | 00:02:06.101641 | base/pgsql_tmp/pgsql_tmp68403.1 | 1024 MB | 00:00:10.995852 | SELECT a.*, b.*, c.* FROM...
68403 | 00:02:06.101641 | base/pgsql_tmp/pgsql_tmp68403.2 | 455 MB | 00:00:01.004148 | SELECT a.*, b.*, c.* FROM...
```
Дополнительно можно открыть еще один сеанс и понаблюдать за тем, в какой момент обновляется статистика в представлениях `pg_stat_database` и `pg_stat_statements`.
## 5.7. Ввод-вывод фоновых процессов {#mon-section-5-7}
Среди процессов СУБД помимо клиентских процессов есть еще и фоновые службы, которые также осуществляют ввод-вывод. В этой главе рассмотрим процесс фоновой записи background writer и процесс checkpointer, выполняющий контрольные точки. Оба процесса берут на себя задачу записи изменений из буферного кеша в основное хранилище. Поскольку объем данных и количество необходимых операций ввода-вывода может быть довольно большим, процессы записывают данные не в момент внесения изменений, а асинхронно в фоновом режиме.
Задача процесса фоновой записи заключается в записи грязных буферов из буферного кеша в основное хранилище. Процесс выполняет свою работу, чередуя ее с паузами. Перед началом очередной итерации выполняется оценка количества обращений к буферам, которое произошло за предыдущую итерацию, — чем больше обращений, тем больше буферов будет списано в этой итерации (см. *bgwriter\_lru\_multiplier*), но не более, чем указано в *bgwriter\_lru\_maxpages*[^mon-151-1]. Среди грязных буферов выбираются именно те, что будут вытеснены в ближайшем будущем, — для этого фактически повторяется алгоритм вытеснения, но без уменьшения счетчика использования. То есть процесс фоновой записи работает на упреждение и предотвращает попытки вытеснения грязных страниц со стороны клиентских процессов.
Процесс `checkpointer` выполняет контрольную точку, надежно записывая измененные данные в основное хранилище. В момент завершения контрольной точки гарантируется, что все изменения, произошедшие до начала контрольной точки, синхронизированы с диском. Контрольные точки позволяют обслуживать WAL-журнал, удаляя старые сегменты и освобождая место под новые. В процессе выполнения контрольной точки процесс сканирует буферный кеш, отмечая все грязные буферы как требующие синхронизации, а затем постепенно записывает их содержимое в основное хранилище. Выполнение этой работы тоже подразумевает ввод-вывод, объем которого напрямую зависит от количества грязных буферов. Исчерпывающую информацию о работе процесса контрольной точки можно получить из документации[^mon-151-2] и книг[^mon-151-3].
**Представление pg\_stat\_bgwriter.** Для отслеживания работы процессов фоновой записи и контрольной точки можно использовать представление `pg_stat_bgwriter`. Исторически обе задачи выполнялись одним процессом, но в версии 9.2 работа, связанная с контрольными точками, была вынесена в отдельный процесс, а статистика так и осталась в общем представлении. Представление содержит всего одну строку:
```text {label="text" .source-commands hl_lines="1"}
# TABLE pg_stat_bgwriter;
-[ RECORD 1 ]---------+------------------------------
checkpoints_timed | 316
checkpoints_req | 2
checkpoint_write_time | 84919068
checkpoint_sync_time | 58509
buffers_checkpoint | 1254815
buffers_clean | 1801423
maxwritten_clean | 0
buffers_backend | 443469
buffers_backend_fsync | 0
buffers_alloc | 2646195
stats_reset | 2022-11-04 05:01:49.427562+00
```
Статистика относится не только к процессам фоновой записи и контрольной точки, но и к *фоновой записи* в целом. Давайте рассмотрим представление более подробно.
**Причины наступления контрольных точек.** Первые два поля описывают количество выполненных контрольных точек:
- `checkpoints_timed` — количество контрольных точек, выполненных по расписанию;
- `checkpoints_req` — количество контрольных точек, выполненных по необходимости.
Как видно, контрольные точки могут запускаться либо по расписанию, через интервал времени, указанный в параметре *checkpoint\_timeout*, либо по необходимости, что означает внеплановый запуск при превышении объемом записи ограничения, установленного в параметре *max\_wal\_size*. Также к последней категории относятся контрольные точки, запущенные администратором с помощью команды `CHECKPOINT`, и контрольные точки, выполняемые при выключении сервера СУБД для синхронизации буферного кеша с основным хранилищем.
При настройке контрольных точек есть две стратегии. Первая стратегия полагается на выполнение контрольных точек по расписанию, когда выбирается относительно длинный интервал времени *checkpoint\_timeout* и выполнение контрольной точки растягивается на этот интервал. Эта стратегия применима на оборудовании с низкой производительностью, и ее смысл состоит в распределение нагрузки от контрольных точек таким образом, чтобы ее выполнение меньше влияло на общую производительность. При этом появление контрольных точек по необходимости указывает на то, что нагрузка увеличилась и в WAL-журнал стало записываться больше данных еще до истечения настроенного интервала. У этой стратегии есть недостаток: если увеличивать интервал *checkpoint\_timeout* и предел *max\_wal\_size*, то из-за больших объемов записи в WAL-журнал и редких контрольных точек восстановление после потенциальной аварии может занять много времени (так как при восстановлении после сбоя все изменения, записанные в WAL, нужно воспроизвести).
Вторая стратегия полагается на выполнение контрольных точек по необходимости на основе значения *max\_wal\_size* — как только объем записи в WAL-журнал достигнет указанного значения, будет запущено выполнение контрольной точки. Этот способ хорошо подходит для регулировки времени восстановления после сбоя: оно более предсказуемо, поскольку известно, какой объем WAL нужно воспроизвести, и значение *max\_wal\_size* можно подстроить под характеристики производительности оборудования. Но и у этой стратегии есть недостаток. Значение *max\_wal\_size* служит только ориентиром, а в реальности в WAL-журнал может быть записано больше изменений, что тоже отразится на времени восстановления.
Особенностью записи в WAL-журнал является то, что после выполнения контрольной точки первое изменение любого буфера в кеше приводит к записи всей страницы (full page write, FPW) из этого буфера в журнал (см. *full\_page\_writes*). Все последующие изменения в этом буфере будут журналироваться отдельно. Таким образом, при частом выполнении контрольных точек (неважно, по интервалу или по необходимости) будет возникать дополнительная нагрузка от записи полных образов страниц, и объем этой нагрузки зависит от размера буферного кеша и объема происходящих в нем изменений (операции `INSERT`, `UPDATE`, `DELETE`).
Можно отметить, что на практике большее распространение получила первая стратегия настройки, именно потому, что контрольная точка воспринимается как тяжелая операция и желательно проводить ее аккуратно с наименьшим влиянием на производительность остальных процессов и выполняемых запросов. При такой стратегии увеличение `checkpoints_req` расценивается негативно и является поводом для оценки увеличения реальной нагрузки и ее влияния на общую производительность, для пересмотра конфигурации и последующего поиска причин возрастания нагрузки. В современных условиях, когда производительность дисковых подсистем сильно выросла благодаря SSD- и NVMe-носителям, актуальность такого подхода уже ставится под сомнение. В любом случае при выборе стратегии следует ориентироваться на метрики производительности подсистемы хранения и пропускной способности СУБД при выполнении запросов.
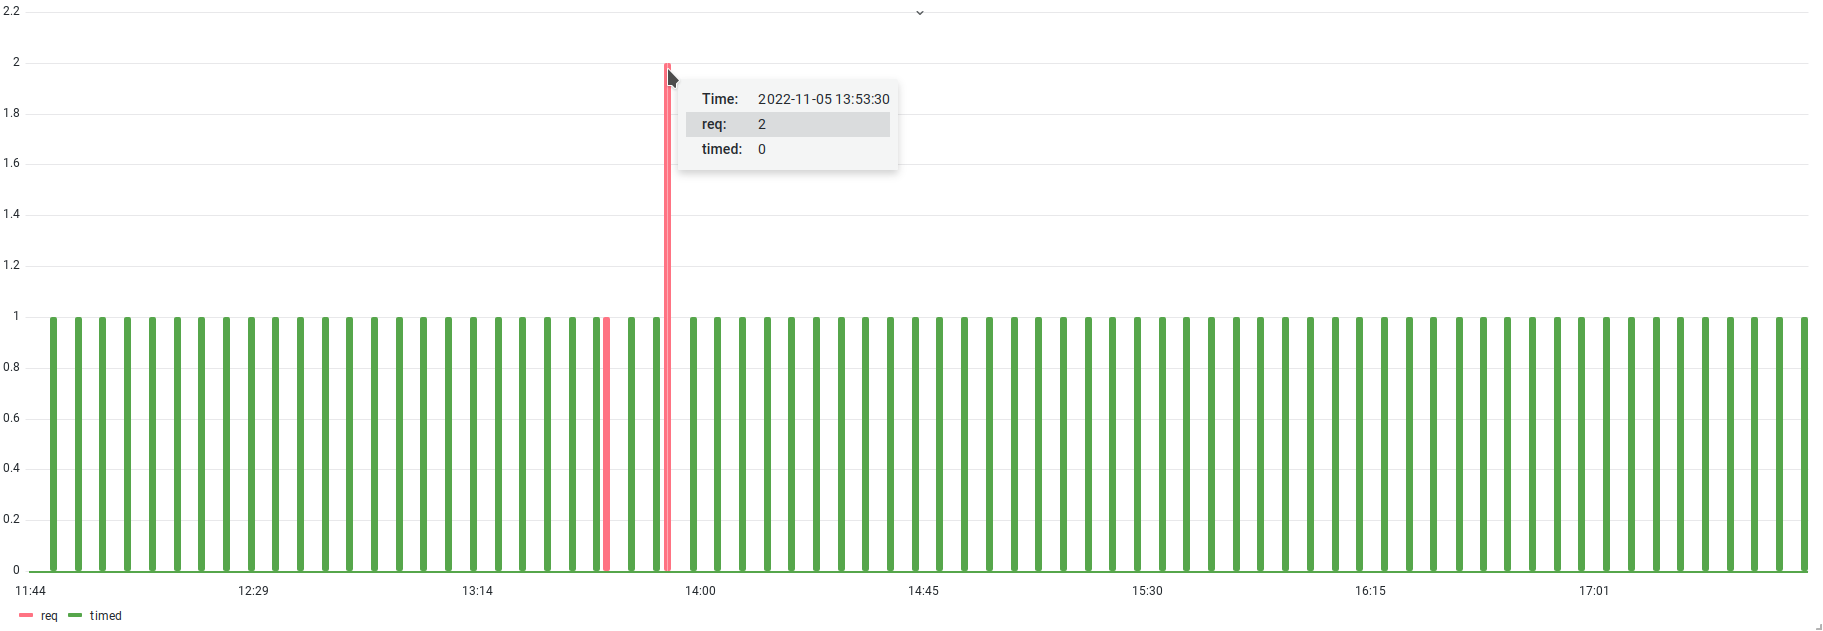
В мониторинге можно использовать график на основе этих метрик (рис. [5.7](/ru/05-shared-memory-and-io/#mon-figure-caption-122)) и отслеживать пики появления «нежелательных» контрольных точек (в зависимости от выбранной стратегии настройки).
{#fig-5.7 num="5.7" caption="Выполнение контрольных точек" width=1823 height=631}
График показывает, что бóльшая часть контрольных точек выполняются по расписанию, значит, объем записи в WAL-журнал укладывается в предел *max\_wal\_size*. Есть и контрольные точки, выполненные по необходимости: если бы это была производственная среда, это мог бы быть пик записи в WAL, но в тестовом окружении нагрузка стабильная, и, как следствие, объем записи в WAL тоже ровный, без резких всплесков. Для демонстрации эти контрольные точки были запущены с помощью команды `CHECKPOINT`.
**Продолжительность выполнения контрольных точек.** Выполнение контрольной точки можно условно разделить на два этапа: запись содержимого грязных буферов на диск и вызов синхронизации с основным хранилищем (см. *fsync*). Запись на первом этапе не дает надежной гарантии сохранности данных, поэтому необходим второй этап с явной синхронизацией (однако и здесь могут быть проблемы[^mon-153-1]). Разделение на этапы условное, поскольку выполнение контрольной точки устроено так, что запросы на синхронизацию выстраиваются в очередь, и, если очередь заполнена, запись приостанавливается, выполняется синхронизация уже записанных блоков, после чего запись возобновляется. Следующие поля как раз показывают время, затраченное на этих этапах (оба значения — в миллисекундах):
- `checkpoint_write_time` — время, затраченное на запись страниц;
- `checkpoint_sync_time` — время, затраченное на синхронизацию.
Запись страниц на первом этапе занимает бóльшую часть времени контрольной точки, а синхронизация является завершающим этапом и, как правило, выполняется существенно быстрее. Однако скорость синхронизации зависит от производительности дисковой подсистемы: на медленных носителях на этапе синхронизации могут образоваться очереди запросов ввода-вывода, что приведет к увеличению задержек и снижению производительности. Следовательно, медленная синхронизация — признак недостаточной производительности дисковой подсистемы. По значениям этих полей мы можем отслеживать время, требуемое на синхронизацию, и, если синхронизация становится долгой, стоит оценить влияние контрольных точек на производительность запросов (изменение времени выполнения запросов в момент синхронизации на контрольных точках).
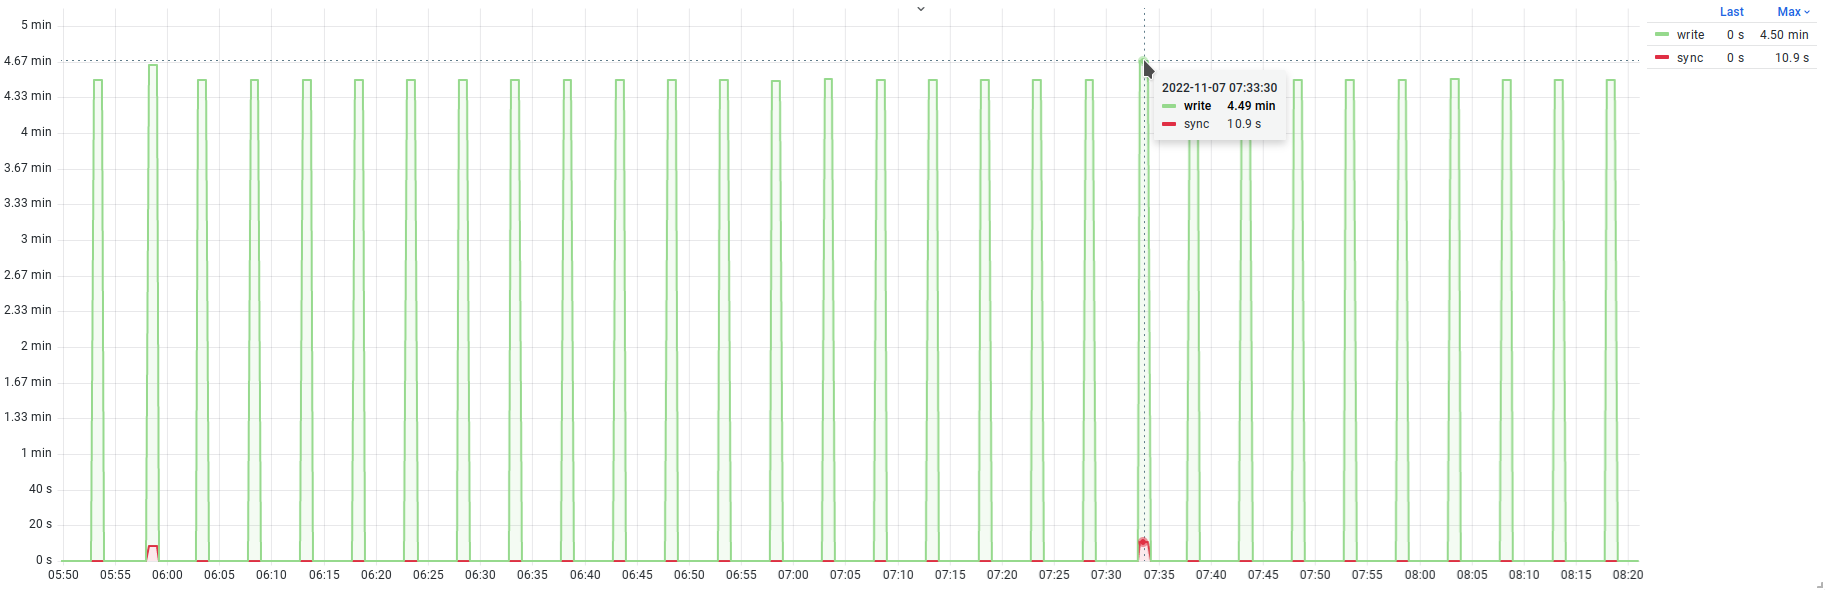
Для отслеживания времени выполнения можно использовать график на основе метрики `postgres_checkpoints_seconds_total` (рис. [5.8](/ru/05-shared-memory-and-io/#mon-figure-caption-124)):
{#fig-5.8 num="5.8" caption="Продолжительность выполнения контрольных точек" width=1825 height=590}
На этом графике видно, что время выполнения контрольных точек ровное, но в интервале есть две контрольные точки, где синхронизация длится около 10 секунд. Это выделяется на фоне других контрольных точек и является достаточным поводом проявить интерес и разобраться, почему в редких случаях синхронизация выполняется так долго.
**Запись буферов.** Следующие поля позволяют анализировать объем данных, записанных как фоновыми, так и клиентскими процессами:
- `buffers_checkpoint` — количество буферов, записанных процессом контрольной точки;
- `buffers_clean` — количество буферов, записанных процессом фоновой записи;
- `buffers_backend` — количество буферов, записанных клиентскими процессами;
- `buffers_alloc` — количество буферов, выделенных для размещения страниц данных;
- `maxwritten_clean` — количество приостановок сброса грязных страниц процессом фоновой записи по причине достижения предела, указанного в *bgwriter\_lru\_maxpages*.
Процесс фоновой записи можно рассматривать как помощника процесса контрольной точки. Постоянно записывая грязные страницы, он уменьшает объем работы, необходимый для выполнения контрольной точки. Первые две метрики показывают объем работы, проделанный двумя этими фоновыми процессами. Третья метрика показывает количество буферов, записанных клиентскими процессами, включая и рабочие процессы автоочистки. Напомню, что, если процесс не смог найти нужный блок с данными в кеше, он вынужден прочитать этот блок с диска. Для этого обычно требуется найти буфер (`buffers_alloc`) и вытеснить из него имеющийся блок. Если найденный буфер окажется грязным, то дополнительно придется записать содержимое буфера на диск. Именно эту работу и проделывает заранее процесс фоновой записи.
Конфигурация СУБД подразумевает несколько параметров[^mon-155-1], которые регулируют работу процесса фоновой записи и, соответственно, влияют на объем выполняемой работы и производимой им нагрузки (в пределах одной итерации рабочего цикла). С помощью метрики `maxwritten_clean` можно оценивать, как часто процесс фоновой записи останавливался по причине достижения предела, указанного в *bgwriter\_lru\_maxpages*. Таким образом, рассматривая значения метрик `buffers_backend` и `maxwritten_clean`, можно оценивать эффективность процесса фоновой записи: чем меньше оба значения, тем лучше. При конфигурировании следует помнить, что работа процесса фоновой записи предполагает нагрузку на подсистему ввода-вывода. Со слишком агрессивными настройками процесс будет выполнять избыточный ввод-вывод, что может негативно сказаться на производительности других процессов.
Перечисленные метрики можно вывести в график (рис. [5.9](/ru/05-shared-memory-and-io/#mon-figure-caption-126)). На нем видно, что процессы фоновой записи и контрольной точки создают более или менее стабильную и ровную нагрузку, а вот от клиентских процессов есть два пика запросов на запись. Стоит разобраться, справляется ли процесс фоновой записи (см. `maxwritten_clean`) или это был спонтанный всплеск в рабочей нагрузке.
Осталось рассмотреть еще два поля:
- `buffers_backend_fsync` — количество раз, когда клиентские процессы были вынуждены выполнить синхронизацию самостоятельно. Операции синхронизации обычно делегируется процессу контрольной точки, но могут быть выполнены и клиентскими процессами, что считается плохим признаком. За всю практику эксплуатации СУБД мне ни разу не приходилось сталкиваться с тем, чтобы `buffers_backend_fsync` был больше нуля;
- `stats_reset` — уже хорошо известное по другим представлениям поле с отметкой времени сброса статистики. Обычно к этому полю не приходится обращаться, если статистика по фоновой записи и контрольным точкам складывается в систему мониторинга, но если
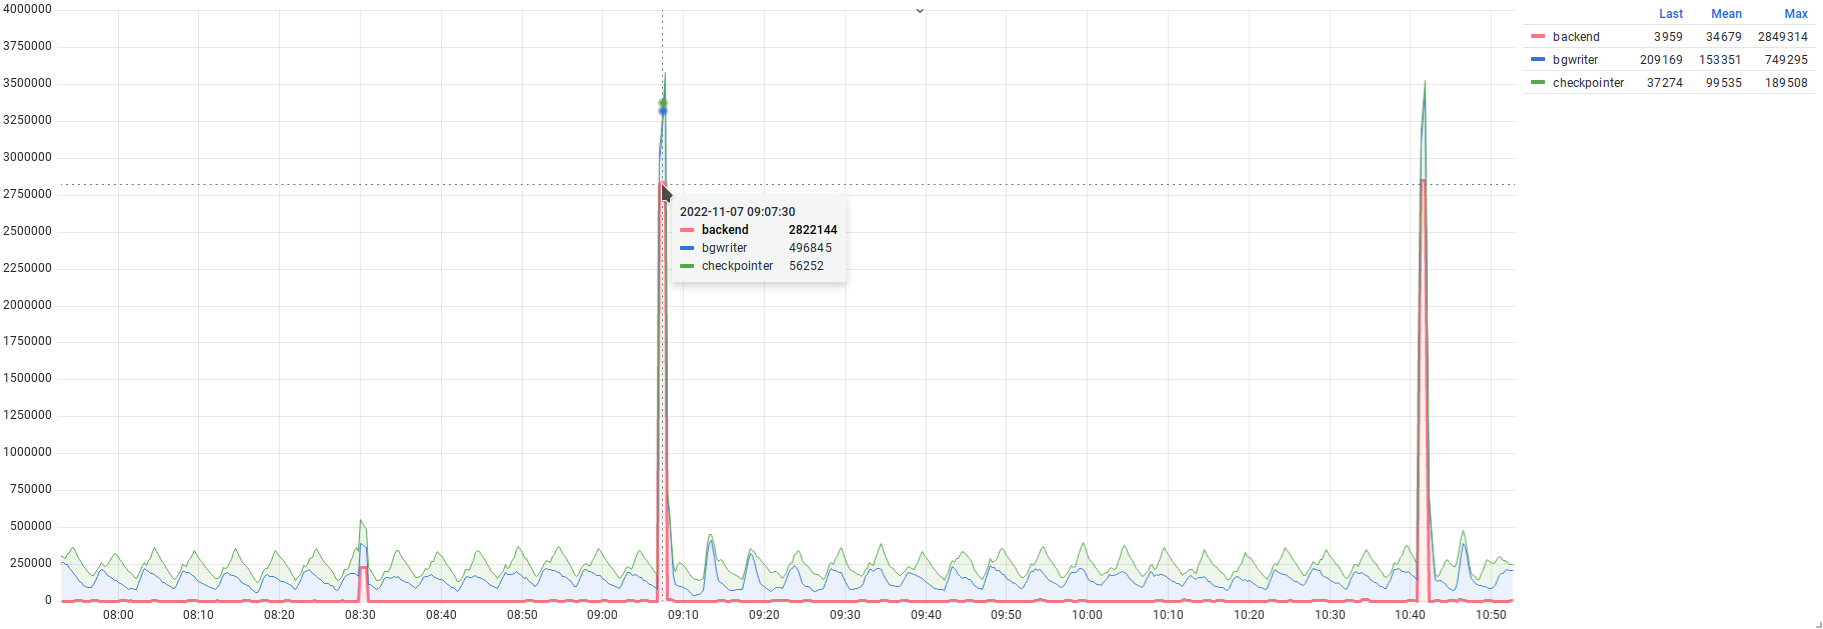
{#fig-5.9 num="5.9" caption="Количество буферов, записанных разными процессами" width=1823 height=629}
статистика этого представления используется для построения сводных отчетов, то важно смотреть, чтобы статистика была накоплена за относительно длинный период, например 2–4 недели. Статистика за более короткие периоды может быть не очень показательной, а за слишком большие — сильно усредненной и не отражающей какие-либо всплески и возможные аномалии.
Завершая главу, стоит отметить, что некоторые другие представления, такие как `pg_stat_wal` или `pg_stat_replication_slots`, также содержат статистику ввода-вывода. Они в меньшей степени относятся к вводу-выводу, связанному с пользовательскими данными, однако могут служить источником информации о вводе-выводе на уровне экземпляра СУБД. Эти и другие представления будут рассмотрены в следующих главах, посвященных WAL-журналу и репликации.
## Резюме {#mon-p156-h509}
- Представление `pg_buffercache` позволяет оценить использование буферного кеша с разных сторон.
- Для анализа структуры общей памяти используется представление `pg_shmem_allocations`.
- Для анализа структуры памяти клиентских процессов используются представление `pg_backend_memory_contexts` и функция `pg_log_backend_memory_contexts`.
- Для оценки использования SLRU-кешей используется представление `pg_stat_slru`.
- Для оценки общего ввода-вывода можно использовать `pg_stat_database`.
- Детальную оценку ввода-вывода по конкретным объектам БД можно получить в соответствующих представлениях `pg_statio_*`.
- Для оценки ввода-вывода при выполнении запросов можно использовать представление `pg_stat_statements`.
- Для общей оценки временных файлов можно использовать `pg_stat_database`.
- Для оценки ввода-вывода, связанного с временными файлами, при выполнении запросов можно использовать `pg_stat_statements`.
- Отслеживать временные файлы можно с помощью журналов сообщений СУБД.
- Важно отслеживать активные временные файлы.
- Фоновый процесс записи и процесс контрольной точки являются источниками ввода-вывода, причем последний может оказывать существенное влияние на общую производительность.
- Для оценки ввода-вывода фоновой записи и процесса контрольной точки следует использовать представление `pg_stat_bgwriter`.
[^mon-131-1]: [postgrespro.ru/docs/postgresql/current/pgbuffercache]()
[^mon-131-2]: [postgrespro.ru/docs/postgresql/current/view-pg-shmem-allocations]()
[^mon-133-1]: [www.interdb.jp/pg/pgsql08.html#\_8.4.4.]()
[^mon-149-1]: [postgrespro.ru/docs/postgresql/current/storage-file-layout]()
[^mon-150-1]: [github.com/lesovsky/postgresql-monitoring-book/blob/main/playground/scripts/active\_temp\_files.sql]()
[^mon-151-1]: [postgrespro.ru/docs/postgresql/current/runtime-config-resource#RUNTIME-CONFIG-RESOURCE-BACKGROUND-WRITER]()
[^mon-151-2]: [postgrespro.ru/docs/postgresql/current/wal-configuration]()
[^mon-151-3]: [www.interdb.jp/pg/pgsql09.html#\_9.7.]()
[^mon-153-1]: [wiki.postgresql.org/wiki/Fsync\_Errors]()
[^mon-155-1]: [postgrespro.ru/docs/postgresql/current/runtime-config-resource#RUNTIME-CONFIG-RESOURCE-BACKGROUND-WRITER]()