4 Базы данных
В этой главе мы рассмотрим:
иерархию объектов СУБД;
кластер баз данных, табличные пространства, базы данных, схемы, таблицы и индексы;
отношения;
служебные структуры отношений — TOAST, карты видимости и свободного пространства;
рабочую нагрузку в отношении таблиц и индексов;
избыточное последовательное сканирование таблиц;
ошибки и нежелательные события в кластере баз данных;
функции для определения размеров объектов;
функции вывода содержимого служебных каталогов кластера баз данных.
В предыдущей главе мы рассмотрели запросы как основу любой рабочей нагрузки, а также связанные с ними статистику и мониторинг активности. Другой стороной рабочей нагрузки являются пользовательские данные. В запросах указываются конкретные таблицы, из которых читаются и в которые сохраняются данные. В этой главе мы рассмотрим статистику активности с точки зрения обращений к объектам СУБД и проследим события, которые происходят в контексте именно этих объектов — баз данных, таблиц и индексов.
4.1. Иерархия объектов СУБД
Одной из главных задач СУБД является надежное хранение данных и обеспечение доступа к этим данным. На уровне СУБД средствами организации и хранения данных являются таблицы и другие типы объектов, каждый со своим предназначением. Все эти средства являются логическим слоем организации данных. Однако СУБД не является вещью самой в себе и вынуждена опираться на средства операционной системы, на ее собственные абстракции и ресурсы. С точки зрения операционной системы данные СУБД размещаются в файловой системе и используют блочные устройства. На физическом уровне все таблицы, индексы и многие другие абстракции СУБД — это всего лишь файлы и каталоги на диске.
Дальше мы рассмотрим, как в СУБД организовано хранение данных. Это поможет лучше понять качественный состав рабочей нагрузки (на какие объекты СУБД приходится нагрузка) и более осознанно подойти к созданию мониторинга рабочей нагрузки с точки зрения использования объектов и данных. Опытные администраторы, хорошо представляющие внутреннюю структуру хранения, могут сразу перейти к разделу 4.2.
Кластер баз данных
Первое, что мы рассмотрим, — это концепция кластера баз данных (database cluster). Кластер представляет собой единый и неделимый набор баз данных и общий для них набор глобальных объектов. Свойство единости и неделимости означает, что весь набор существует вместе в рамках одного экземпляра СУБД (instance) — группы процессов, запущенных в пространстве операционной системы и имеющих область общей памяти. На одном сервере могут работать несколько экземпляров СУБД, если их TCP-порты не конфликтуют. Кластер баз данных не следует путать с кластером репликации. Кластер репликации обычно состоит из нескольких экземпляров СУБД, запущенных в независимых средах (отдельные физические, виртуальные серверы или контейнеры).
С точки зрения операционной системы кластер баз данных представляет собой набор каталогов и файлов. Инициализация кластера осуществляется командой initdb с указанием целевого каталога. Полученный каталог принято называть каталогом данных (data directory), он содержит в себе другие каталоги и файлы кластера. Исключением могут быть каталоги табличных пространств и WAL-журнала, которые могут быть вынесены за пределы каталога данных и связаны с основным каталогом через символические ссылки. Таким образом, каталог данных и все возможные внешние каталоги (табличные пространства и WAL) образуют хранилище данных кластера.
Ниже приведен пример каталога данных из тестового окружения. Каждый подкаталог играет свою значимую роль в функционировании кластера. Администратору важно знать назначение каждого подкаталога и его роль в работе СУБД.
pg_wal и pg_xlog
Зачем же нужно знать внутреннюю структуру каталога данных? Хорошим примером является история подкаталога WAL-журнала. Этот каталог критически важен для функционирования СУБД. При некоторых обстоятельствах его содержимое может неконтролируемо расти и занимать все больше и больше места на диске, но удаление каталога может привести к непредсказуемым последствиям. До версии 9.6 включительно каталог журнала WAL назывался pg_xlog, и неопытные администраторы нередко удаляли его, считая, что там хранятся какие-то «обычные текстовые логи», которыми можно пожертвовать, чтобы освободить место. В итоге удаление каталога приводило к печальным последствиям1.
В версии 10 каталог WAL был переименован в pg_wal в попытке устранить двусмысленность и предотвратить случайные удаления2. Заранее зная роль и назначение отдельных подкаталогов внутри основного каталога данных, можно избежать попадания в подобные истории.
Подробнее об организации физического хранения баз данных можно узнать из официальной документации3.
Табличные пространства
Следующей (внешней) частью каталога данных являются табличные пространства. С их помощью можно объединять независимые каталоги (размещенные на разных файловых системах и блочных устройствах) и использовать для нужд СУБД. После инициализации initdb в СУБД присутствует два табличных пространства:
pg_default— табличное пространство по умолчанию, где будут создаваться все базы, таблицы, индексы. Это пространство размещается внутри основного каталога кластера. При инициализации в этом пространстве создаются две служебные базы —template0иtemplate1, которые используются как шаблоны для создания новых баз (см. командуCREATE DATABASE4);pg_global— служебное пространство, которое также размещается внутри основного каталога кластера. Здесь размещаются общие для всего кластера объекты системного каталога.
Получить список всех табличных пространств можно с помощью метакоманды \db+ или из таблицы pg_tablespace:
В выводе команды интерес представляет поле Location, которое содержит путь до каталога табличного пространства. Для пространств по умолчанию это поле содержит NULL (поскольку оба находятся в основном каталоге данных). Все остальные подключаемые пространства (как правило) находятся вне основного каталога данных. Они связаны с основным каталогом посредством символических ссылок, определенных в подкаталоге pg_tblspc.
Табличные пространства могут использоваться для размещения как баз данных, так и отдельных таблиц и индексов. Отдельно стоит отметить базы данных: размещение в конкретном табличном пространстве фактически означает, что в нем размещаются объекты системного каталога этой базы, а остальное содержимое может размещаться и в других табличных пространствах. Например, вполне допустимо существование базы в пространстве pg_default, в которой может находиться большая секционированная таблица; при этом секции и индексы этой таблицы за последние три месяца могут находиться в пространстве, размещенном в быстром SSD-хранилище, а более старые, архивные секции и индексы — в медленном HDD-хранилище. Таким образом, база размещена в одном пространстве, а часть ее данных — в двух других пространствах.
Табличные пространства и стоимость обслуживания
Практика показывает, что использование дополнительных пространств усложняет обслуживание СУБД. Следует помнить о существовании этих пространств и учитывать их в задачах обновления, настройки физической репликации и многих других. Также добавляются дополнительные операции при миграциях данных между табличными пространствами. Лучше до последнего избегать использования пространств и серьезно оценивать плюсы и минусы от их внедрения. На практике в большинстве систем достаточно тех табличных пространств, что создаются по умолчанию.
Базы данных
Базы данных являются своего рода контейнерами для данных и обеспечивают их изоляцию. Таблицы и индексы одной базы недоступны в других базах (для обхода этого ограничения можно использовать такие средства, как postgres_fdw и dblink). Отдельные базы используются для логического разделения данных внутри одного кластера — данные нескольких не взаимосвязанных между собой приложений можно разделить и хранить в отдельных базах, но в рамках одного кластера баз данных.
Посмотреть список баз можно с помощью метакоманды \l (или в таблице pg_database):
При инициализации кластера создаются три базы данных. Две базы — template0 и template1 — используются самой СУБД в качестве шаблонов при создании новых баз, а третья база — postgres — является обычной базой, пригодной для создания в ней таблиц. Как правило, БД postgres не используется для прикладных бизнес-задач, администраторы обычно устанавливают в нее вспомогательные скрипты и инструменты. Для размещения пользовательских данных рекомендуется создавать отдельные базы и давать им имена, которые ясно указывали бы на назначение БД или на суть хранимых там данных.
Все базы данных внутри основного каталога размещены в подкаталоге base. Каждая база размещена в каталоге, имя которого соответствует идентификатору в pg_database.oid.
Схемы
Внутри отдельной базы можно дополнительно разделить данные по схемам (schema). Схемы, по сути, являются пространствами имен (namespace) и позволяют задействовать дополнительный уровень изоляции и хранения объектов, но не предусматривают вложенности. Например, с помощью схем можно организовать хранение таблиц согласно разным предметным областям, версионирование функций и представлений. Массу интересных вариантов использования схем можно найти в презентации Б. Момджяна, посвященной микросервисам5.
Любая база создается со схемой public, которая является схемой по умолчанию для всех создаваемых таблиц и индексов. Часто на практике достаточно одной этой схемы.
Посмотреть список схем можно метакомандой \dn+ (или в таблице pg_namespace):
Схемы являются внутренней абстракцией СУБД для логической группировки объектов. Они не имеют ассоциированных с ними файлов или каталогов в файловой системе.
Таблицы и индексы
Таблицы являются основными, можно даже сказать, главными объектами для размещения пользовательских данных, представленных в виде строк. Индексы являются дополнительной к таблице структурой и позволяют ускорить поиск отдельных строк таблицы.
Получить список таблиц можно с помощью метакоманды \dt+ или представления pg_tables:
В выводе представлены только пользовательские таблицы. Для просмотра всех таблиц, включая системные, следует указать модификатор S: команда примет вид \dtS+. Для индексов есть аналогичная метакоманда \di и представление pg_indexes (на основе таблицы pg_index):
Отдельно можно отметить таблицу pg_class, которая содержит список всех объектов в текущей базе и часто используется как вспомогательная при получении статистики по объектам базы. Далее в некоторых запросах мы будем обращаться к этой таблице.
Отношения и кортежи
Отношение (relation) — это обобщающий термин для любых объектов в базе данных, которые имеют имя и список атрибутов. Таблицы и индексы, внешние таблицы, представления (обычные и материализованные), последовательности (sequence), составные типы — все это можно назвать отношениями. Также в PostgreSQL существует термин класс — это устаревший синоним отношения, который остался со времен увлечения объектной ориентированностью. В самых ранних версиях PostgreSQL существовала таблица pg_relation, которую быстро переименовали в pg_class, а вот префикс rel у атрибутов так и остался.
В более общем виде отношение — это множество кортежей (tuple); например, результат запроса также является отношением. Кортеж представляет собой упорядоченный набор атрибутов. Порядок атрибутов задается при определении таблицы (или другого отношения), которая будет содержать кортежи. В этом случае кортеж часто называют строкой таблицы. Он также может определяться структурой результирующего множества; такие кортежи иногда называют записями. Часто этот термин принимает смысл «версия строки», так как относится скорее к физическому представлению данных внутри страницы, чем к логическому понятию строки.
И таблицы, и индексы (и некоторые другие типы отношений) представлены в виде отдельных файлов в каталогах БД. Если таблица содержит большое количество строк, файл таблицы (или индекса) автоматически сегментируется на файлы по одному гигабайту. Каждый такой файлсегмент нумеруется по возрастанию.
Каждая таблица или индекс представлены несколькими файлами, так называемыми слоями (fork):
Основной файл таблицы (main fork) содержит пользовательские данные в виде строк.
Карта видимости (visibility map) предназначена для отслеживания страниц, строки в которых видны всем активным транзакциям. Карты видимости существуют только для таблиц. Файлы карт видимости имеют суффикс _vm. Карты видимости обновляются при очистке и обычно занимают немного места. Более подробное описание можно найти в документации6.
Карта свободного пространства (free space map) предназначена для отслеживания свободного места в таблице (или индексе) и тех страниц, что доступны для вставки новых строк. Так же как и карты видимости, карты свободного пространства обновляются при очистке и занимают немного места. Файлы этих карт имеют суффикс _fsm. Более подробное описание можно найти в документации7.
Файл инициализации (initialization fork) используется только для нежурналируемых таблиц (unlogged table) и индексов, изменения в которых не фиксируются в WAL-журнале. Такие таблицы не восстанавливаются после сбоя и пересоздаются путем копирования файла инициализации поверх основного файла (если таблица была большой и содержала несколько сегментов, они удаляются). В документации не так много информации по файлу инициализации8.
На более низком уровне таблицы и индексы имеют страничную организацию и состоят из страниц (блоков) по 8 КБ. Каждая такая страница имеет служебные поля и место, зарезервированное под пользовательские данные, — строки, или кортежи. Индексы также имеют страничную организацию, но в зависимости от типа индекса (btree, hash, gin и пр.) могут по-разному структурировать место внутри страниц.
TOAST
Одним из ограничений страничной организации является то, что строки не могут выходить за пределы страниц, то есть в странице нельзя хранить строки длиной, превышающей ее размер. Для преодоления этого ограничения используется методика хранения сверхбольших атрибутов TOAST (The Oversized-Attribute Storage Technique), которая заключается в сжатии и/или разбиении длинных строк. Это происходит автоматически и прозрачно для конечного пользователя, хотя отмечу, что возможности для тонкой настройки TOAST имеются. Методика TOAST поддерживается только для тех типов данных, которые могут быть представлены атрибутами переменной длины (varlena, variable-length attribute), так как она не имеет смысла для типов фиксированного размера.
Если таблица имеет столбцы с типами переменной длины, с таблицей также будет связана дополнительная TOAST-таблица, в которой и будут размещаться данные, не вмещающиеся в обычные страницы. Как и обычные таблицы, TOAST-таблицы также используют страничную организацию с фиксированным размером страницы, но за счет дополнительного сжатия и разбиения значений на фрагменты методика позволяет распределять большие значения по нескольким страницам. Более подробное описание методики и то, как устроено размещение данных на диске и в памяти, можно прочитать в официальной документации9.
Мы коротко рассмотрели основные концепции иерархии объектов СУБД. В дальнейшем это позволит нам лучше ориентироваться в статистике, особенно в вопросах, связанных с использованием дискового пространства и общего кеша.
4.2. События в кластере баз данных
В главе 3 рабочая нагрузка рассматривалась с точки зрения выполняемых запросов. Запросы условно можно представить как внешнюю силу, направленную от приложений на СУБД, а рабочую нагрузку — как внутреннюю работу, совершаемую СУБД под действием этой силы. Это позволяет взглянуть на рабочую нагрузку совершенно с другой стороны — например, с точки зрения объектов БД (таблиц и индексов), задействованных в рабочей нагрузке при обработке команд от приложений.
Рабочая нагрузка в отношении таблиц и индексов
Еще одной статистикой, которая также характеризует рабочую нагрузку, является статистика по использованию таблиц и индексов. Эта статистика доступна в двух вариантах: на уровне строк и на уровне блоков. Первый вариант представляет собой информацию о том, сколько строк затронуто в результате выполнения запросов. Статистика по строкам является логическим отражением рабочей нагрузки, поскольку указывает на использование логических абстракций СУБД; статистика по блокам, выраженная в страницах или байтах, является более близкой к физическому слою хранения данных и хорошо подходит для анализа ввода-вывода.
Для получения нужных данных потребуется несколько представлений. Получить общую картину в рамках кластера или отдельных БД можно в представлении pg_stat_database, в котором содержится набор необходимых полей:
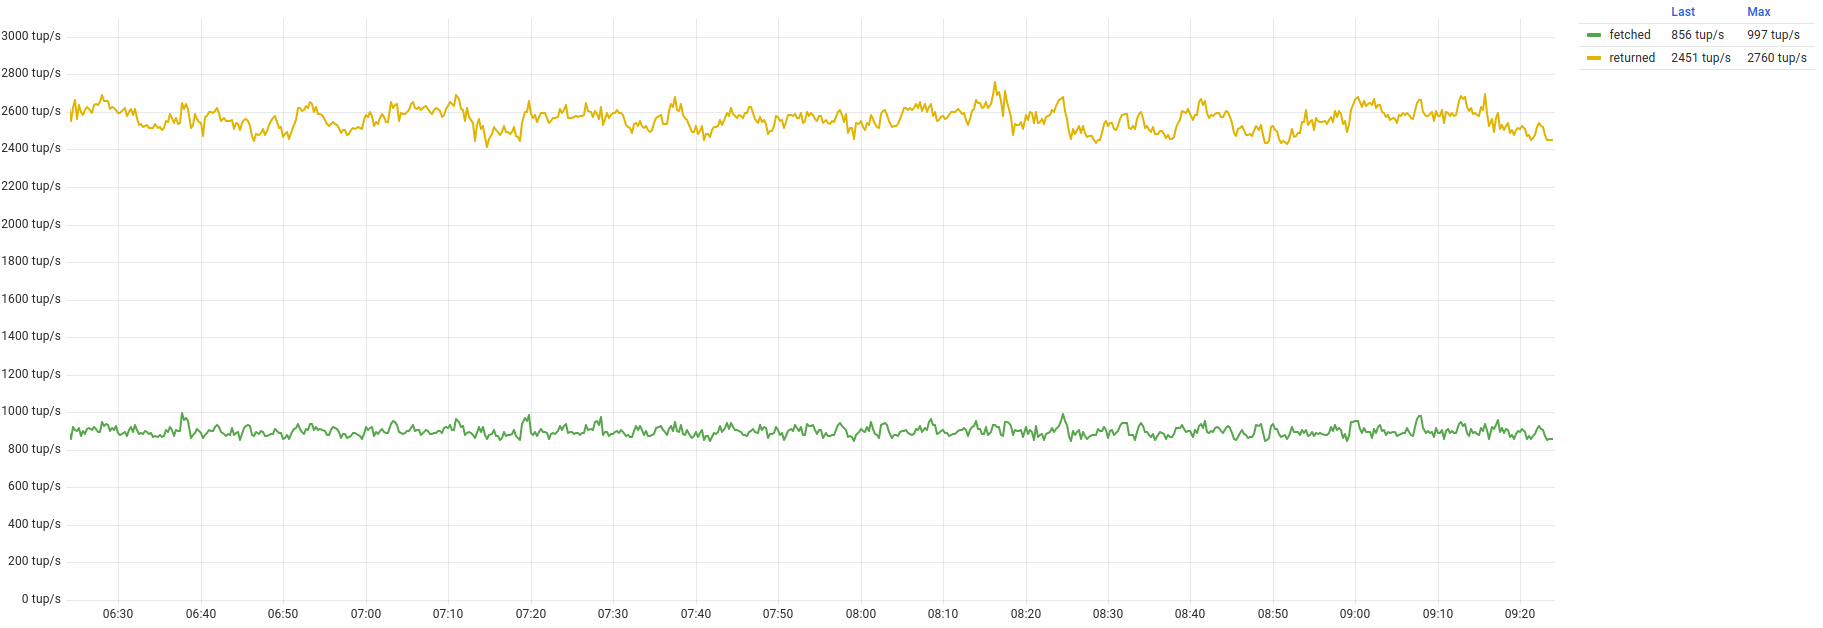
tup_returnedиtup_fetched— показывают общее количество строк, затронутых при доступе к таблицам и индексам (не количество строк, отданных клиенту!).
— Для индексов tup_returned показывает количество строк, возвращенных индексными методами доступа (Index Scan, Bitmap Index Scan, Index Only Scan), а tup_fetched показывает количество строк, прочитанных при этом из таблицы (но только для простого индексного доступа без битовой карты).
— Для таблиц tup_returned показывает количество прочитанных из таблицы строк при последовательном сканировании (Seq Scan), а tup_fetched показывает количество строк, прочитанных из таблицы в случае доступа по битовой карте (Bitmap Heap Scan). Дело в том, что при объединении битовых карт (Bitmap And) статистику доступа нельзя отнести к какому-то конкретному индексу, поэтому она всегда учитывается в статистике по таблице.
Из приведенного описания видно, что некоторые операции могут увеличивать оба счетчика одновременно, поэтому не стоит суммировать их значения. Также счетчики могут увеличиваться и при операциях обновления и удаления строк (ведь целевую строку тоже нужно найти и прочитать). В представлении pg_stat_database можно получить общую картину по затронутым строкам, а более детальную информацию можно получить, анализируя статистику отдельных таблиц и индексов.
tup_inserted,tup_updatedиtup_deleted— с этими полями все гораздо проще: они содержат количество строк, затронутых операциямиINSERT,UPDATEиDELETE, без всяких тонкостей и нюансов.
Эта статистика также подходит для поверхностной оценки колебаний рабочей нагрузки. Из мониторинга ее можно получить с помощью следующих метрик:
postgres_database_tuples_returned_total;postgres_database_tuples_fetched_total;postgres_database_tuples_inserted_total;postgres_database_tuples_updated_total;postgres_database_tuples_deleted_total.
Каждая метрика возвращает соответствующее значение затронутых строк для отдельной БД. Для наблюдения в динамике следует ориентироваться на частоту изменения величины, и для оценки общей картины метрики отдельных баз следует просуммировать.
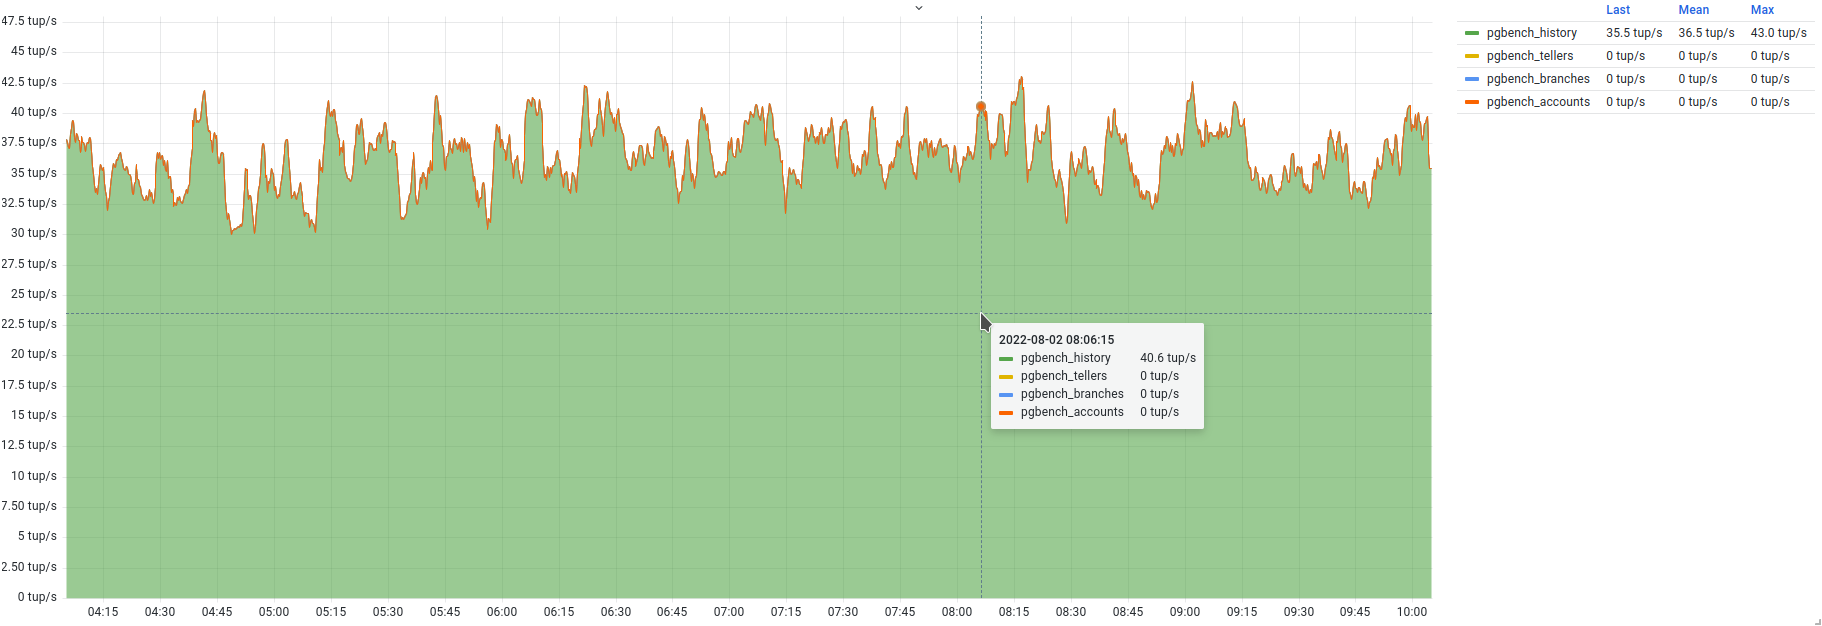
Для графика (рис. 4.1) потребуется два запроса: каждая из метрик описывает отдельное действие, связанное со строкой.
Аналогичную картину можно получить для строк, затронутых при операциях изменения. Для построения графика (рис. 4.2) потребуются три запроса:
Оба графика показывают ровную рабочую нагрузку без сильных колебаний. Это говорит о том, что со стороны приложений количество клиентов и объем запросов более или менее постоянны, и со стороны СУБД количество затрагиваемых строк при выполнении рабочей нагрузки также постоянно. Причиной сильных колебаний может быть как изменение количества экземпляров приложений и объема отправляемых запросов, так и внутренние причины, такие как
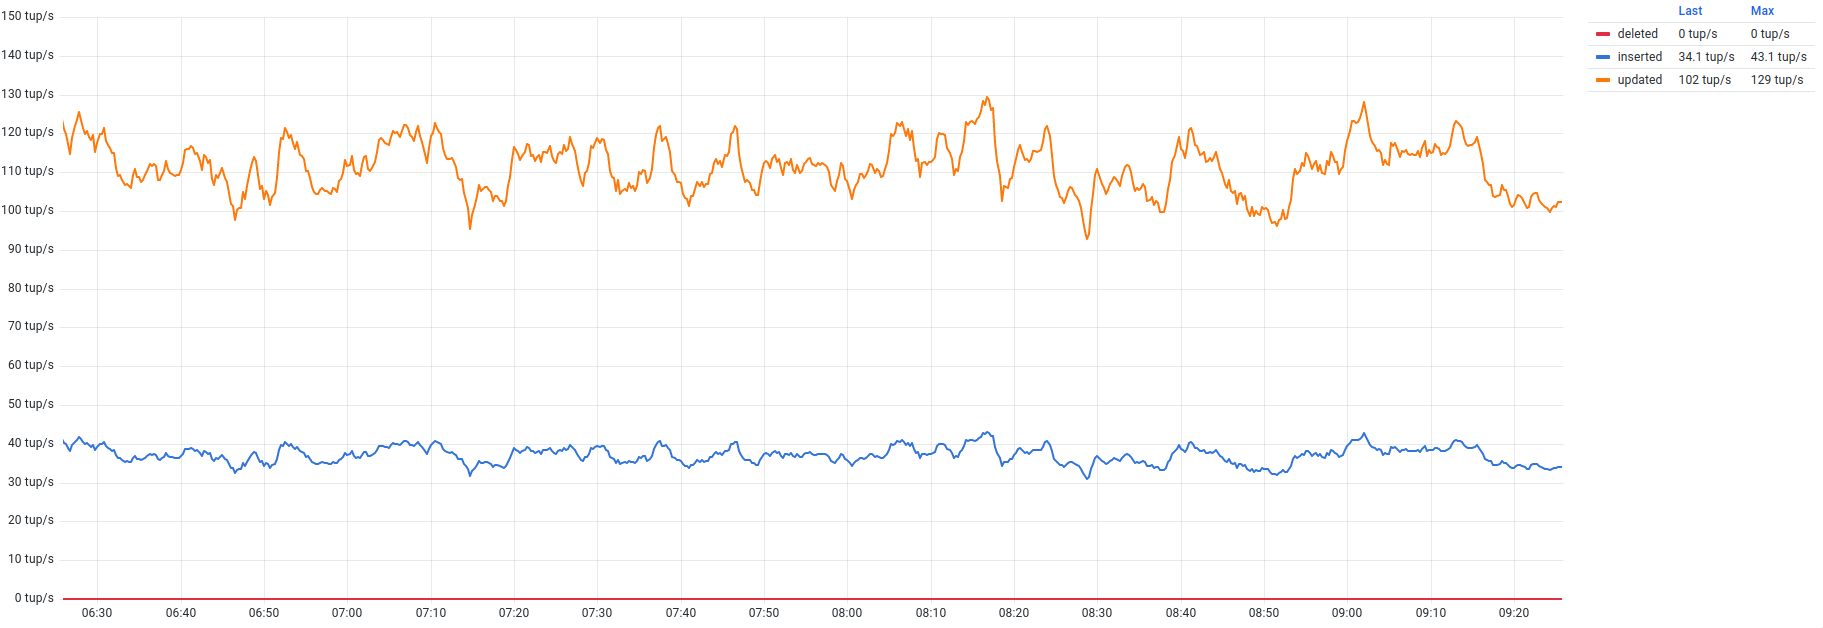
использование неоптимальных планов, которые могут приводить к изменению количества затрагиваемых строк и долгому выполнению запросов.
Для более детального анализа и понимания того, какие именно таблицы затронуты в нагрузке, следует использовать представления pg_stat_user_tables и pg_stat_user_indexes. В этих представлениях содержится больше информации об использовании именно таблиц и индексов. В pg_stat_user_tables интерес представляют следующие поля:
seq_scan— количество операций последовательного доступа (sequential scan);seq_tup_read— количество строк, затронутых в результате выполнения всех операций последовательного доступа;idx_scan— количество операций индексного доступа (index scan);idx_tup_fetch— количество строк, затронутых индексным доступом;n_tup_ins— количество вставленных строк (обычно в результате выполненияINSERT- запросов);n_tup_upd— количество обновленных строк, включая и так называемые HOT-обновления (в результате выполненияUPDATE-запросов);n_tup_del— количество удаленных строк (в результате выполненияDELETE-запросов);n_tup_hot_upd— количество строк, обновленных с использованием механизма HOT (HeapOnly Tuples update) — оптимизации, направленной на уменьшение накладных расходов при обновлении строк. Ее суть состоит в том, что если в результате обновления значения атрибутов не изменились ни в одном индексе, то и вставку индексных указателей можно исключить. За счет этого обновление выполняется быстрее и с меньшими затратами ресурсов. Количество HOT-обновлений также включено в полеn_tup_upd. Более подробно о механизме HOT можно почитать в некоторых публикациях10 11.
Похожая статистика есть и по индексам в представлении pg_stat_user_indexes:
idx_scan— количество обращений к данному индексу. Это поле позволяет обнаруживать неиспользуемые индексы, что важно, поскольку их существование не обходится даром;idx_tup_read— количество элементов индекса, прочитанных при сканированиях по индексу (без обращения к таблице);idx_tup_fetch— количество живых строк таблицы, отобранных при простых сканированиях по индексу.
Стоит разобраться, как работают счетчики idx_tup_read и idx_tup_fetch в случае использования битовых карт индексов. При использовании нескольких индексов результаты сканирования могут объединяться логическим умножением или сложением, и, как следствие, становится невозможно связать выборки отдельных строк с конкретными индексами. В таких случаях увеличиваются значения pg_stat_user_indexes.idx_tup_read для задействованных индексов и счетчики pg_stat_user_tables.idx_tup_fetch для каждой таблицы, а значения pg_stat_user_indexes.idx_tup_fetch не меняются.
В представлениях pg_stat_user_tables и pg_stat_user_indexes собрана статистика по пользовательским таблицам и индексам. По системным объектам статистика собрана в аналогичных представлениях pg_stat_sys_tables и pg_stat_sys_indexes. Эти представления обращаются к двум другим, в которых собрана статистика по всем объектам вместе (pg_stat_all_tables и pg_stat_all_indexes), а они, в свою очередь, основаны на большом наборе функций, которые обращаются к отдельным счетчикам статистики. Перечисленные представления индивидуальны для каждой БД (в отличие от pg_stat_database, которое является общим для всего кластера баз данных).
Давайте рассмотрим возможные сценарии использования этой статистики:
избыточный последовательный доступ;
таблицы с наибольшим количеством вставок, обновлений и удалений.
Избыточный последовательный доступ. Последовательный доступ подразумевает обращение к таблице (чтение и, возможно, запись) ровно до того момента, как будет обработано необходимое количество строк. Это один из базовых методов доступа, который используется в случае, когда нужно обратиться к большому количеству строк, или при отсутствии подходящих индексов. В первом случае последовательное сканирование может использоваться в аналитических запросах или при массовых (bulk) изменениях, когда требуется прочитать большую часть таблицы или даже всю таблицу полностью. Во втором случае при отсутствии подходящего индекса последовательный доступ будет задействован даже при запросе всего одной строки, что может привести к избыточному использованию ресурсов ввода-вывода и процессора (чтение и фильтрация строк).
На практике необходимо отслеживать количество операций последовательного доступа и понимать, действительно ли они необходимы. В случае аналитических запросов это оправданно, а для OLTP-запросов обычно не требуется большое количество записей, и последовательный доступ может обходиться дороже, чем использование индекса. Однако из этого не следует, что на каждое поле нужно создавать индекс, — обслуживание индексов не обходится бесплатно и при некоторых обстоятельствах может вызывать избыточный ввод-вывод. При добавлении нового индекса важно оценивать планы выполнения запросов и понимать, будет ли новый индекс использоваться и будет ли он полезен.
Для получения списка таблиц, которые читаются последовательно, можно использовать следующий запрос (подключение должно быть выполнено к БД pgbench):
Запрос выводит статистику доступа к таблице с помощью последовательного и индексного доступов — количество операций и количество затронутых строк. В тестовой нагрузке не так много таблиц, и запрос выводит всего одну таблицу, доступ к которой осуществляется последовательно. На самом деле у таблицы есть индекс, который мог бы использоваться, но в таблице всего 20 строк (то есть вся таблица целиком помещается в один блок) и планировщик считает, что использование индекса обойдется дороже: ведь придется читать блоки не только таблицы, но и индекса. Поэтому он выбирает более дешевый план с последовательным доступом.
В производственных окружениях с разнообразной нагрузкой может оказаться больше таблиц, сканируемых последовательно, и, сравнивая их между собой, следует принимать во внимание некоторые показатели (для большего удобства их можно также выводить в запросе):
среднее количество строк за одно сканирование —
seq_tup_read / seq_scan. Чем больше строк в среднем, тем больше и ресурсов требуется при сканировании. Но это не значит, что все запросы читают именно среднее количество строк;доля последовательных обращений от общего числа обращений —
seq_scan / ( seq_scan+ +idx_scan). Чем больше доля, тем больше ресурсов используется при сканировании, однако стоит помнить про небольшие таблицы, которые могут полностью помещаться в общем кеше;размер таблицы в байтах позволяет сравнивать таблицы друг с другом. Например, устранение случаев последовательного доступа к большим таблицам может быть приоритетнее, чем к небольшим таблицам. Определение размеров таблиц и других объектов БД рассматривается в этой главе чуть дальше.
Получение этой и подобной статистики с помощью запросов удобно для построения отчетов за периоды, однако для оперативного анализа и поиска проблем важно видеть динамику изменений. Следующим запросом можно получить первые K таблиц по количеству строк, прочитанных при последовательном доступе:
Если на основе этого запроса построить график, на нем будет показана всего одна таблица, что полностью соответствует результату SQL-запроса.
В качестве небольшого эксперимента можно выполнить разовый запрос с чтением всех строк другой таблицы:
Спустя некоторое время на графике появится характерный выброс (рис. 4.3).
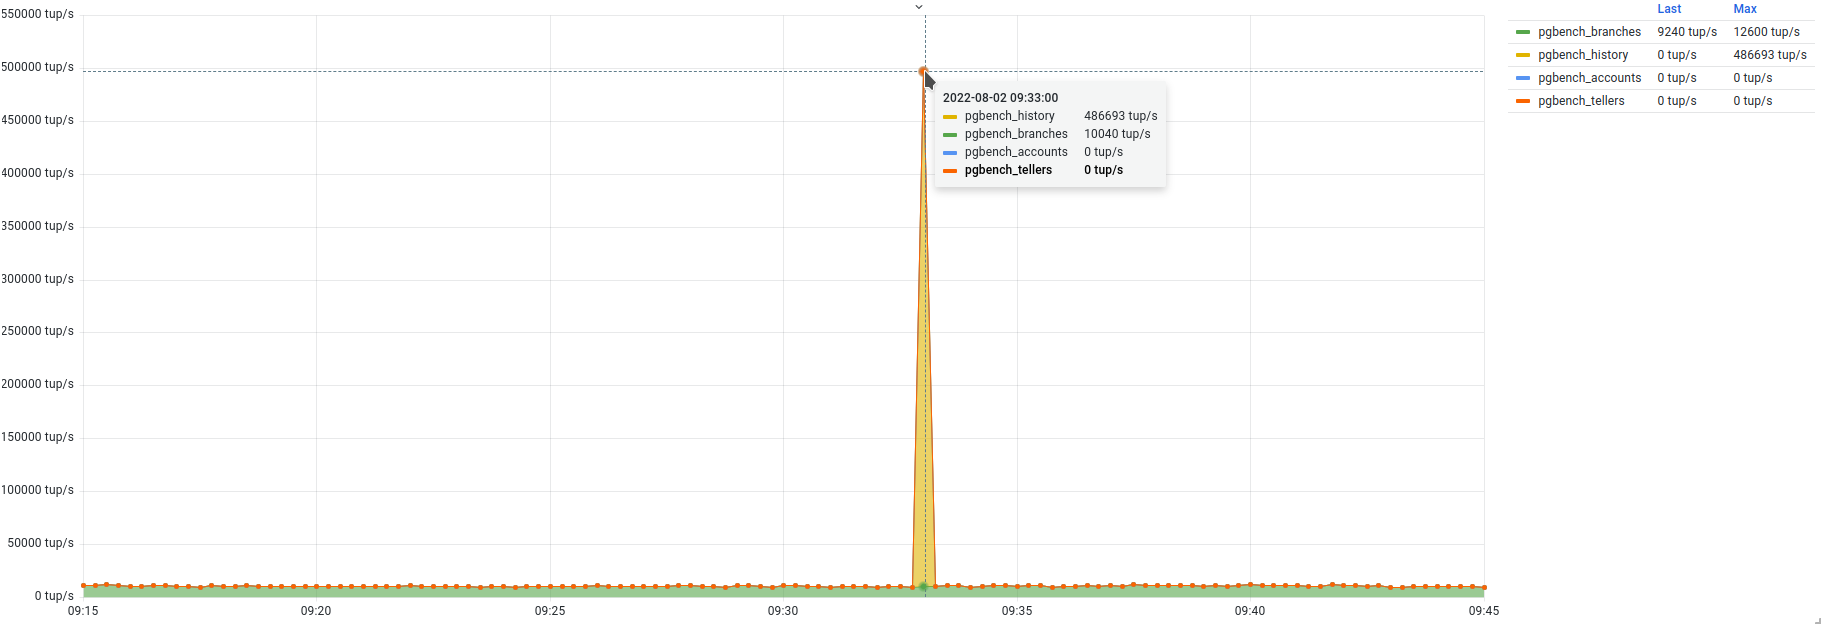
Таким образом, с помощью подобного графика можно оперативно отслеживать изменение в динамике последовательного доступа и реагировать должным образом (анализировать запросы к таблице, строить индексы и т. п.).
Таблицы с наибольшим количеством вставок, обновлений и удалений. Статистика использования таблиц является логическим развитием статистики строк из представления pg_stat_database. Если там мы видели общую статистику уровня баз данных, то с помощью pg_stat_user_tables можно заглянуть внутрь отдельных БД и более подробно проанализировать таблицы, задействованные в рабочей нагрузке, и оценить объемы затронутых строк.
Представление pg_stat_user_tables является индивидуальным для каждой БД, поэтому, чтобы получить статистику по таблицам в БД pgbench, нужно подключиться именно к этой базе. Следующим запросом можно получить статистику затронутых строк:
В этом примере выведены все пользовательские таблицы в БД pgbench и общее количество строк, затронутое различными операциями; указывая интересующее поле в предложении ORDER BY, можно получить таблицы с наибольшим количеством затронутых строк. Однако в выводе снова появляются большие цифры, и на практике удобно отслеживать эти величины в динамике. Для этого можно воспользоваться следующими метриками (имена метрик аналогичны названиям полей):
postgres_table_seq_tup_read_total;postgres_table_idx_tup_fetch_total;postgres_table_tuples_inserted_total;postgres_table_tuples_updated_total;postgres_table_tuples_deleted_total;postgres_table_tuples_hot_updated_total.
Следующим запросом можно получить таблицы с наибольшим количеством обновлений:
График (рис. 4.4) более наглядно выводит информацию о том, на какие именно таблицы приходится больше всего обновлений.
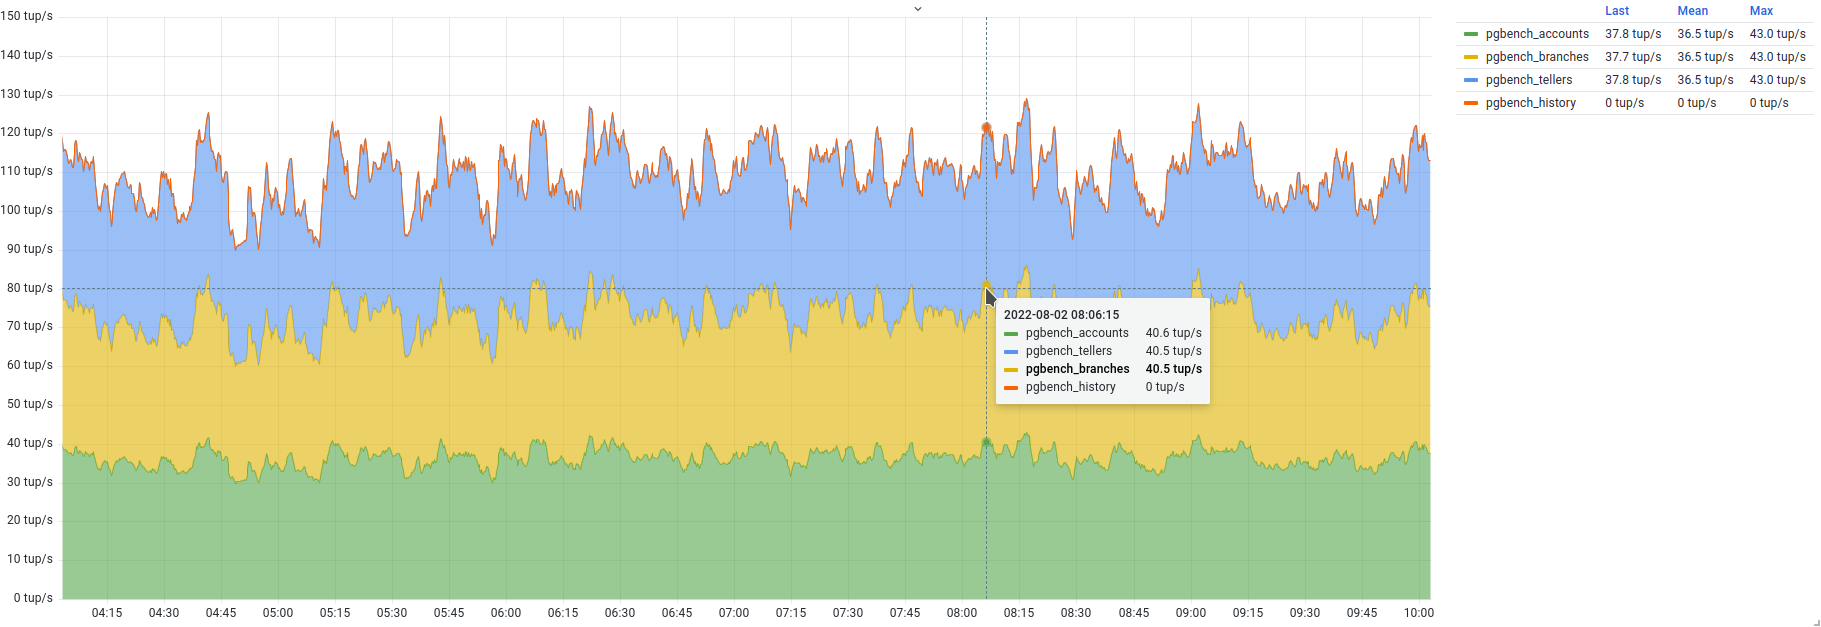
Меняя метрику в запросе, можно получить соответствующие графики для других показателей, например для вставленных строк (рис. 4.5). Используя такие графики на практике, можно оперативно отслеживать колебания в рабочей нагрузке, особенно в случае каких-то значительных изменений на стороне приложений.
Ошибки и нежелательные события
Давайте снова вернемся к pg_stat_database и рассмотрим следующие поля:
xact_rollback— это поле упоминалось при рассмотрении транзакционной активности. Оно указывает на количество транзакций, завершившихся откатом. Факт отката можно расценивать как возникновение ошибки (за исключением случаев явного вызова командыROLLBACK). Следовательно, большое число откатов может сигнализировать об ошибках при выполнении как отдельных запросов, так и транзакций, иxact_rollbackможно использовать как счетчик таких ошибок. Типичными примерами могут служить нарушение уникальности при вставке строк, ошибки синтаксиса, неверное указание аргументов функции или обращение к несуществующим объектам. Однако кроме таких ошибок возможны и другие, которые могут возникать по причинам, не зависящим от приложения, но эту информацию можно получить только из журнала СУБД.conflicts— количество запросов, отмененных из-за конфликтов между выполнением запроса и воспроизведением WAL-журнала на узлах горячего резерва (при использовании репликации). Это отдельный класс ошибок, который более подробно будет рассмотрен в главе 7, посвященной репликации. В любом случае возникновение таких конфликтов также можно расценивать как ошибку.deadlocks— взаимоблокировки, их мы также рассматривали ранее в главе 2. Для разрешения взаимоблокировки какая-то из транзакций завершается принудительно, и это также можно расценивать как ошибку.checksum_failuresиchecksum_last_failureпоказывают количество ошибок при проверке контрольных сумм (data page checksums) и время последней зафиксированной ошибки. Контрольные суммы рассчитываются на основе содержимого страницы данных, пересчитываются при последующих изменениях и используются для выявления повреждения данных при обращениях к странице. Это один из наиболее неприятных типов ошибок; их появление (особенно в производственном окружении) следует расценивать очень серьезно и предпринимать все необходимые меры по исключению таких ошибок в будущем.sessions_abandoned,sessions_fatal,sessions_killedуказывают на количество сеансов с ненормальным завершением. Эти поля мы также обсуждали в главе 2. Они указывают на то, что сеанс завершился ненормально, и это также можно рассматривать как ошибку.
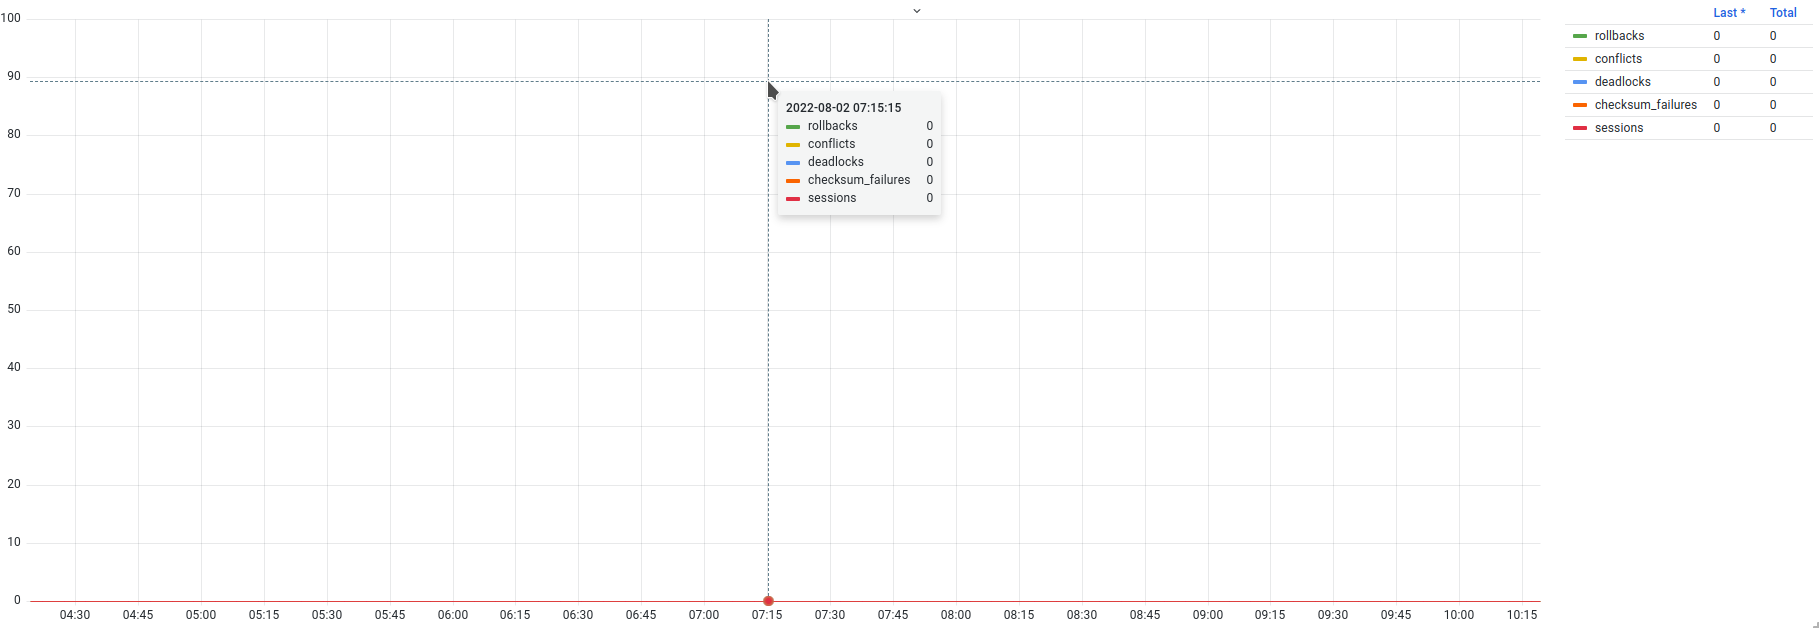
Как вы могли заметить, все рассмотренные события по сути являются ошибками, и при нормальной и правильной эксплуатации СУБД и приложений их вообще не должно возникать. Хорошей практикой является использование графика, где все метрики по этим ошибкам собраны вместе:
postgres_database_xact_rollbacks_total;postgres_database_conflicts_total;postgres_database_deadlocks_total;postgres_database_checksum_failures_total;postgres_database_sessions_total{reason=~"abandoned|fatal|killed"}.
В самом идеальном случае такой график должен быть «пустым», как на рис. 4.6. Любые выбросы должны привлекать внимание администратора БД и служить поводом разобраться с причинами.
Бóльшая часть перечисленных событий свидетельствует о проблемах со стороны приложений, и лишь ошибки контрольных сумм указывают на проблемы в СУБД. При долгой и продолжительной эксплуатации некоторые ошибки могут иметь хронический накопительный характер, и, если сформировать такой график, на нем уже может быть какой-то постоянный фон из ошибок. Тем более что некоторые классы ошибок могут восприниматься как нечто привычное и нормальное, так как обработка этих ошибок выполняется на стороне приложений (например, переустановка сеанса при обрыве или повтор запроса при взаимоблокировке). В таком случае часть событий, такие как откаты и конфликты репликации, можно игнорировать как менее важные и не влияющие значительно на производительность СУБД, а взаимоблокировки и ошибки контрольных сумм по-прежнему воспринимать серьезно — взаимоблокировки негативно влияют на производительность конкурентной работы, а ошибки контрольных сумм могут указывать на риск повреждения данных.
4.3. Функции для работы с объектами СУБД
Довольно часто вместе с основной статистикой по объектам БД хочется видеть и размеры этих объектов, чтобы понимать их масштаб относительно друг друга. Часто размер объекта определяет приоритет работ и сам подход к работе — большие объекты требуют большей аккуратности (нельзя допускать долгого удерживания блокировок, следует избегать побочной нагрузки), и конечная выгода в результате проведенных работ может быть больше. Размеры объектов важны и сами по себе, они являются одним из ключевых факторов при планировании емкости дискового пространства. При продолжительной эксплуатации СУБД данные будут добавляться, объекты будут увеличиваться и занимать все больше и больше места на диске.
Отслеживать размеры объектов можно как со стороны операционной системы, так и со стороны СУБД. Как известно, почти все объекты СУБД — это файлы и каталоги, и можно получить информацию об объеме этих объектов в файловой системе. С другой стороны, СУБД оперирует собственными абстракциями — табличными пространствами, базами данных, таблицами, индексами и т. д. В обоих случаях для получения размеров нам понадобятся так называемые функции системного администрирования12. Это большой набор вспомогательных функций для получения самой разной информации, которая может потребоваться администратору БД. Пока из всего набора функций нас интересуют две группы:
Функции управления объектами баз данных13. Большинство функций в этой группе используются для подсчета места, занимаемого различными объектами СУБД.
Функции доступа к файлам14 предоставляют доступ к каталогам системы, на которой запущен сервер СУБД. Это мощный набор функций для исследования системы вообще; доступ к функциям имеют только суперпользователи и участники роли
pg_read_server_files. Доступ к ним должен предоставляться очень аккуратно с учетом всех требований безопасности, поскольку к этим функциям неприменимы проверки привилегий, встроенные в СУБД. Так, например, выдача правEXECUTEна функциюpg_read_fileразрешает читать любые файлы, доступные серверному процессу СУБД; пользователь с правом выполнения такой функции может прочитать содержимое любой таблицы, включая и те, где могут содержаться конфиденциальные данные (например,pg_authid).
Определение размеров объектов СУБД
Среди функций управления объектами интерес представляют следующие:
pg_tablespace_size— показывает размер указанного табличного пространства;pg_database_size— показывает размер указанной базы данных;pg_table_size— показывает общий размер указанной таблицы, включая TOAST-хранилище и служебные слои (vm, fsm, init);pg_indexes_size— показывает общий размер всех индексов указанной таблицы;pg_total_relation_size— показывает общий размер указанной таблицы (включая TOAST и служебные слои) и все индексы этой таблицы. Результат подсчета эквивалентен сумме функцийpg_table_sizeиpg_indexes_size;pg_relation_size— показывает размер слоя отношения (таблицы или индекса), указанного в первом аргументе. Во втором аргументе можно указать имя интересующего слоя:
— main — подсчитать размер основной структуры с данными;
— fsm — подсчитать размер карты свободного пространства;
— vm — подсчитать размер карты видимости.
Если не указывать второй аргумент, значение main предполагается по умолчанию. Для индекса размер карты видимости всегда будет нулевым.
pg_size_pretty— вспомогательная функция, переводящая значение в байтах в текстовый вид с единицами измерения (bytes,kB,MB,GB,TB,PB).pg_size_bytes— вспомогательная функция, обратнаяpg_size_pretty: она позволяет пересчитать текстовое значение в байты.
Некоторые из этих функций существуют в двух вариантах и в качестве объекта могут принимать либо его числовой идентификатор OID, либо текстовое имя.
В запросах, выводящих статистику по объектам БД, эти функции удобно использовать для указания размеров объектов. Размеры таких составных объектов, как табличные пространства или базы данных, необходимы для оценки используемого места в хранилище и для планирования емкости. Размеры прочих объектов, таких как таблицы и индексы, обычно нужны при оценке использования места внутри базы данных или для оценки эффекта раздувания. Дальше мы коротко рассмотрим примеры использования функций.
Табличные пространства. В начале главы упоминалась метакоманда \db+, показывающая список табличных пространств. Большинство метакоманд на самом деле выполняют SQL-запросы к служебным таблицам системного каталога, соответственно, и результат, аналогичный выводу \db+, можно получить напрямую, используя SQL.
Запросы метакоманд
Чтобы получить текст запроса, который используется метакомандой, можно запустить psql c аргументом -E (--echo-hidden), который указывает psql включить отображение запросов при использовании встроенных метакоманд. В открытом сеансе отображение запросов можно включить с помощью команды \set ECHO_HIDDEN on.
Запрос, показанный ниже, работает как упрощенная версия метакоманды \db+:
Для определения пути (поле path) используется функция pg_tablespace_location. В тестовом окружении используются табличные пространства по умолчанию; значения пути для них отсутствуют (NULL), так как эти пространства находятся в основном каталоге кластера БД. Для получения размера используется функция pg_tablespace_size, которая может принимать как числовой идентификатор OID, так и имя табличного пространства.
Базы данных. Для получения размеров баз данных используется функция pg_database_size. В качестве аргумента функция может принимать числовой идентификатор OID или имя базы данных. Пример запроса для получения размеров:
Таблицы. Таблицы являются комплексными абстракциями, и, когда речь заходит об их размере, важно четко определять тот смысл, что вкладывается в термин «размер». Таблица состоит из основного слоя пользовательских строк и также включает в себя такие служебные слои, как карты видимости и свободного пространства. Кроме того, с таблицами могут быть ассоциированы индексы и TOAST-таблицы, которые с физической стороны являются отдельными сущностями (файлами на диске), но с логической не могут существовать без своей родительской таблицы. Для получения полного размера таблиц, включая все служебные, удобно использовать функцию pg_table_size. При необходимости учета индексов следует использовать функцию pg_total_relation_size (которая эквивалентна сумме pg_table_size и pg_indexes_size). Наконец, для определения размеров на уровне служебных слоев следует использовать pg_relation_size, которой можно указать конкретный служебный слой. Следующий запрос демонстрирует использование перечисленных функций:
В этом примере есть несколько особенностей:
Вместо
pg_stat_user_tablesиспользуетсяpg_class, так как в этой таблице содержится полный список объектов БД.Для получения нужных объектов используется фильтр
c.relkind IN ('p', 'r', 'm'), который оставляет только обычные (r) и секционированные (p) таблицы, а также материализованные представления (m), таким образом исключая индексы, TOAST-таблицы, обычные представления, последовательности и прочие объекты.Исключение таблиц, заблокированных в исключительном режиме
AccessExclusiveLock. Важным нюансом использования административных функций является уровень устанавливаемых блокировок. Для подсчета размеров объекта функциям требуется блокировка уровняExclusiveLock15. При регулярном использовании таких функций, например в случае мониторинга, появляется риск конфликта с самой строгой исключительной (AccessExclusiveLock) блокировкой и вероятность встать в очередь. Для устранения такого риска заблокированные таблицы не выводятся; их размер можно будет получить в другой раз, когда блокировка будет снята.Выбираются только таблицы, размер которых превышает 500 КБ. Подобным условием удобно отсекать небольшие таблицы. Впрочем, в тестовом окружении вообще немного таблиц, а больших — и того меньше.
Отдельным подзапросом к
pg_indexподсчитывается общее количество индексов для каждой таблицы.Для полноты картины добавлен подсчет размера init-слоев, хотя это актуально только при использовании нежурналируемых таблиц, которых, впрочем, нет в тестовом окружении.
Логическим улучшением такого запроса может быть представление служебных слоев в виде процентных отношений относительно общего размера таблицы: так будет удобнее видеть аномалии и перекосы (хотя я не припомню, чтобы мне встречались служебные слои больших размеров). Также можно вывести табличные пространства, которым принадлежат таблицы, однако для этого потребуется выполнить соединение с pg_tablespace.
Индексы. Размер конкретного индекса определяется с помощью функций pg_relation_size или pg_total_relation_size. Обе функции подходят как для таблиц, так и для индексов.
Для удобства работы с индексами можно использовать представление pg_indexes, которое основано на pg_class и pg_index, однако в нем нет поля с уникальным идентификатором, что делает невозможным соединение с другими представлениями по OID. Для простоты запрос выполняется только к pg_indexes без соединения с pg_locks, однако риск конфликта с исключительной блокировкой остается, как и в случае с таблицами.
Оценка размеров объектов БД в системах мониторинга. Представление размеров в виде таблицы, как в SQL-запросах, хорошо подходит для отчетов. Для оперативного наблюдения за размерами объектов СУБД можно использовать следующие метрики:
postgres_database_size_bytes;postgres_table_size_bytes;postgres_index_size_bytes.
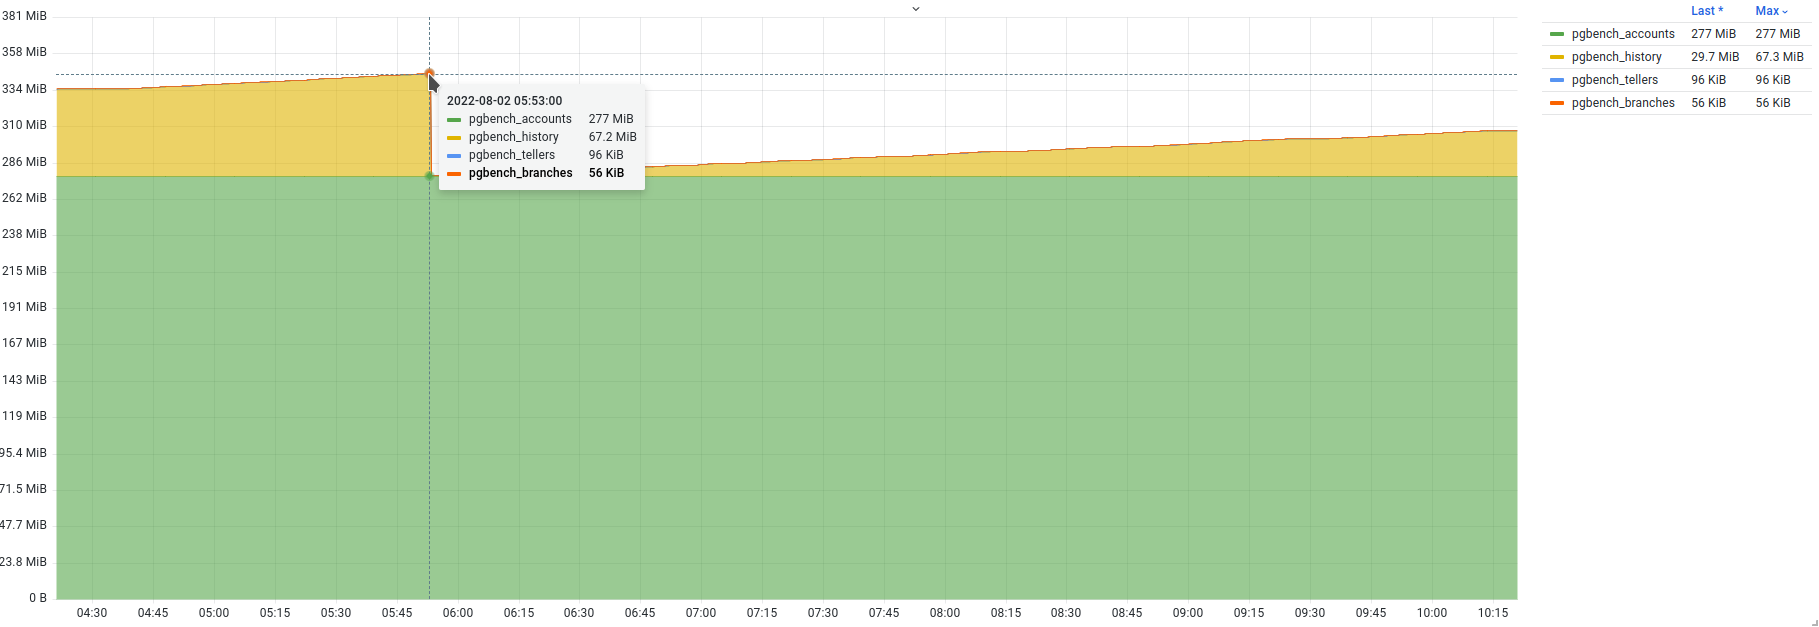
На основе этих метрик можно сделать два типа графиков. Первый и самый простой вариант — показывать объекты с наибольшим размером. Это простая оценка того, как используется место самыми большими объектами БД, однако такой график не покажет аномального роста каких-то других таблиц — это будет заметно, только когда таблица увеличится в размерах настолько, что попадет в список самых больших. Рост может длиться долгое время, за которое проблема аномального увеличения могла бы быть уже исправлена. Вторым, дополнительным вариантом может быть использование графика с объектами, у которых происходит наибольшее изменение размера в интервале времени.
На примере таблиц давайте рассмотрим несколько случаев. Следующим запросом можно получить самые большие таблицы:
На графике (рис. 4.7) это будет выглядеть следующим образом:
Пример запроса для второго варианта с таблицами, у которых происходит наибольшее изменение размера:
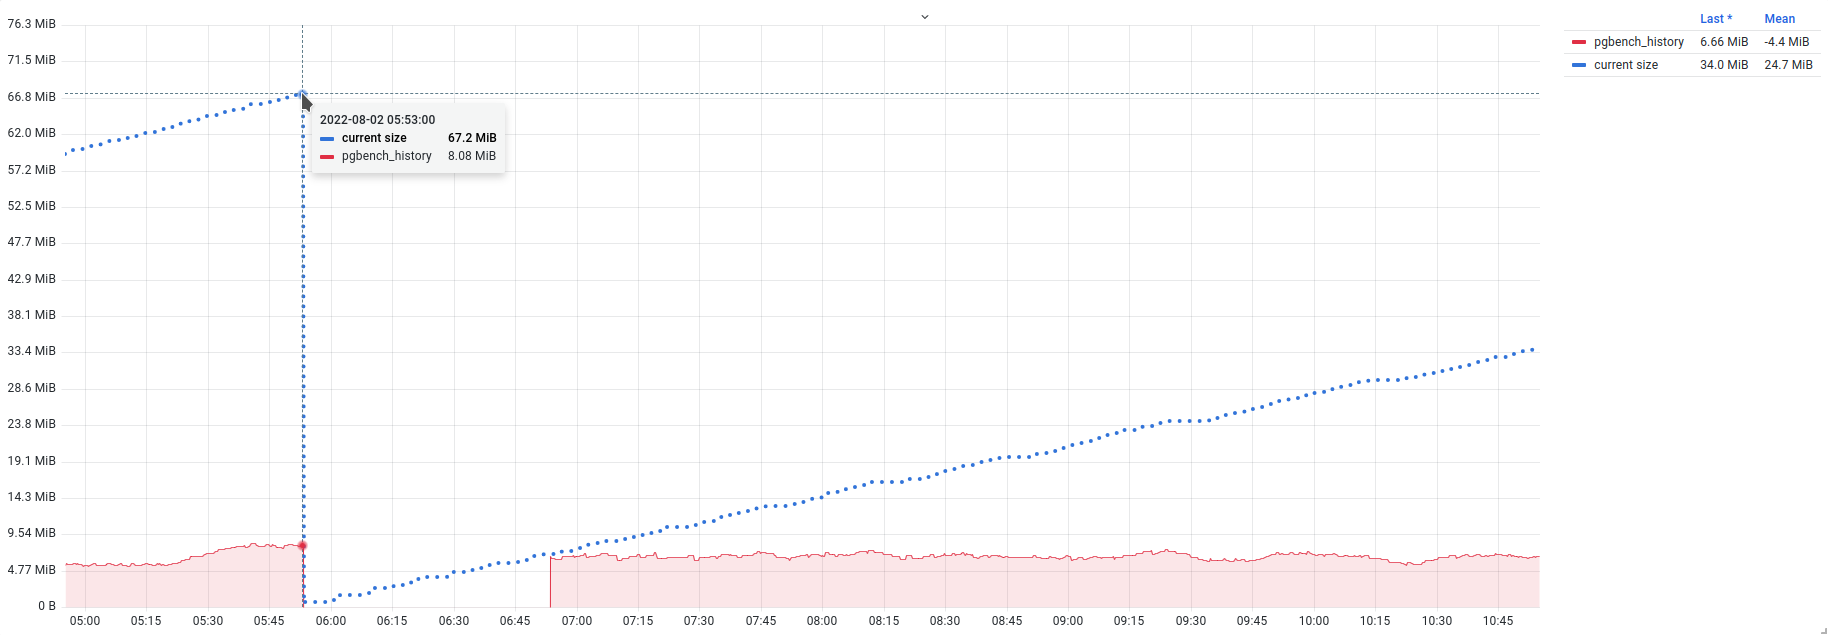
В этом запросе используется функция delta, которая считает разницу в значениях за интервал в один час. Следует аккуратно подходить к выбору интервала: даже один час может оказаться слишком длинным интервалом и сглаживать резкие изменения в размерах за короткие периоды. График, построенный по этой функции, показан на рис. 4.8:
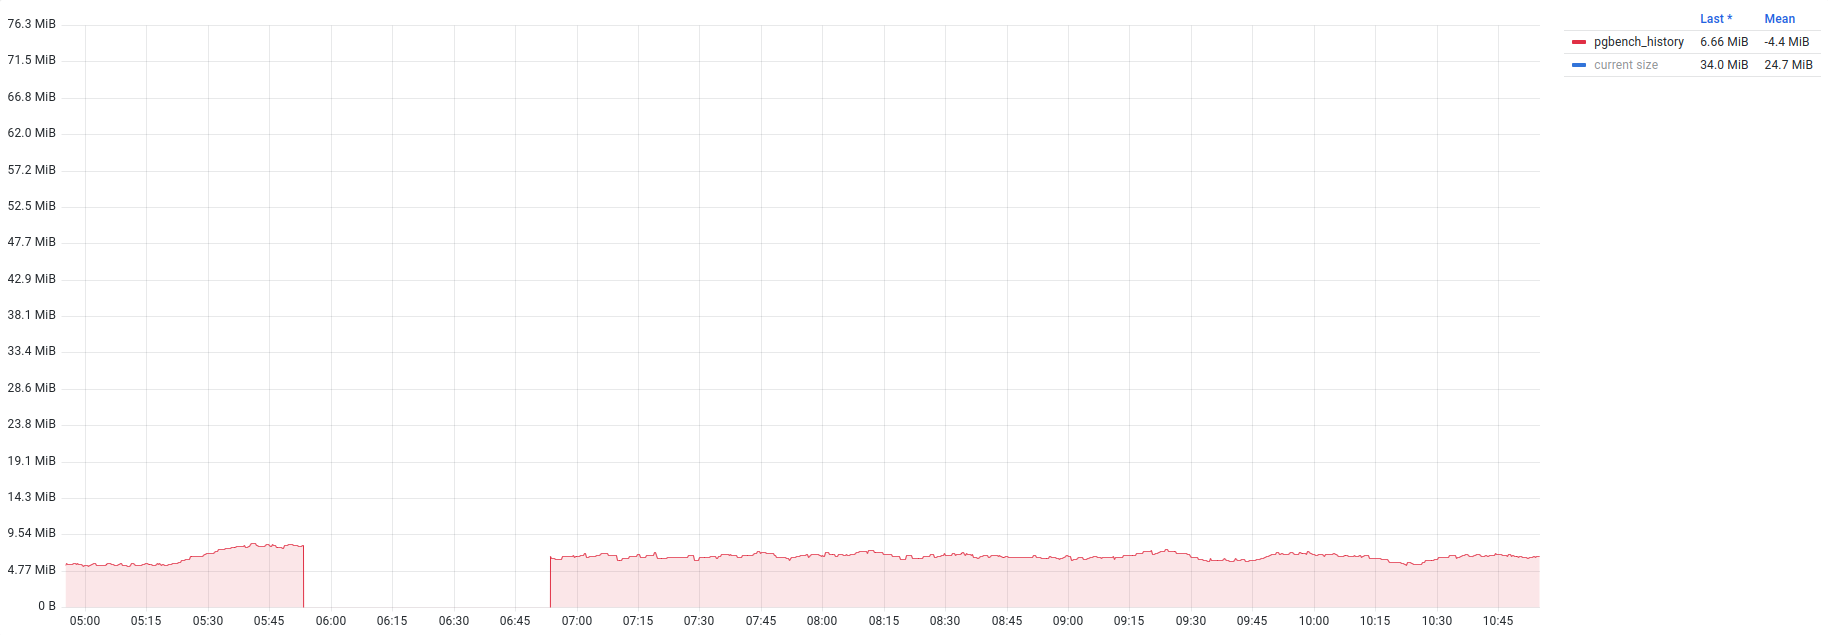
В этом примере видно, что таблица очищается и затем стабильно растет примерно на 5 МБ в час. Для большей наглядности на график можно наложить размер самой таблицы (рис. 4.9):
Размещение объектов в файловой системе
В некоторых случаях приходится обращаться к физическому уровню хранения таблиц и индексов, для чего необходимо найти физическое размещение объектов в файловой системе. Часто это бывает нужно в задачах анализа повреждений и восстановления данных. Для этого предназначено несколько функций:
pg_relation_filenode— принимает идентификатор OID или имя объекта и возвращает номер так называемого файлового узла (filenode), который связан с указанным объектом. Файловым узлом называется основной компонент имени файла, используемого для хранения данных. Для большинства таблиц этот номер совпадает со значениемpg_class.relfilenode, но для некоторых системных каталогов это значение равно нулю, и, чтобы узнать действительное значение, нужно использовать эту функцию. Если указанное отношение не хранится на диске, как, например, представления, данная функция возвращаетNULL;pg_relation_filepath— возвращает путь к файлу отношения относительно основного каталога данных;pg_filenode_relation— является функцией, обратнойpg_relation_filenode, и используется для поиска таблиц по номеру файлового узла (взятого из имени файла). Она возвращает идентификатор OID отношения по заданному OID табличного пространства и файловому узлу. Для таблицы в табличном пространстве по умолчанию в первом параметре можно передать ноль.
Помимо объектов, занятых в хранении пользовательских данных, есть и другие объекты СУБД, которые также хранятся на диске и при некоторых обстоятельствах могут занимать значительный объем. Для их просмотра и анализа также есть набор функций:
pg_ls_logdir— содержимое каталога, где хранится журнал сообщений СУБД;pg_ls_waldir— содержимое каталога pg_wal, где хранятся сегменты WAL-журнала;pg_ls_archive_statusdir— содержимое каталога pg_wal/archive_status, где хранятся статусы архивирования отдельных WAL-сегментов;pg_ls_tmpdir— содержимое каталога, используемого для хранения временных файлов;pg_ls_logicalmapdir— содержимое каталога pg_logical/mappings;pg_ls_logicalsnapdir— содержимое каталога pg_logical/snapshots;pg_ls_replslotdir— содержимое отдельного каталога слота репликации в pg_replslot;pg_ls_dir— универсальная команда для вывода содержимого любого каталога (включая и те, что находятся за пределами основного каталога данных).
Наиболее универсальной из всех перечисленных в этом списке функций является pg_ls_dir. Функция выводит имена всех файлов и каталогов в указанном каталоге и, следовательно, позволяет просматривать любые каталоги на сервере, где запущена СУБД, включая и системные (в рамках прав доступа пользователя, под которым запущена СУБД):
Хоть pg_ls_dir и является универсальной, остальными функциями пользоваться удобнее, поскольку не требуется запоминать точное расположение каталогов.
Следующая не менее интересная функция — это pg_read_file. Функция читает указанный текстовый файл и возвращает его содержимое. В примере ниже мы просто выводим результат, но его, конечно, можно передать другой функции для дальнейшей обработки. В качестве дополнительных параметров можно задавать смещение и длину для более точного указания диапазона чтения.
Прочитанное содержимое обрабатывается в кодировке базы данных, и, если символы оказываются недопустимыми для этой кодировки, возникает ошибка. В качестве обхода этой проблемы можно использовать функцию pg_read_binary_file, которая также предназначена для чтения, но читает произвольные двоичные данные и возвращает результат в значении типа bytea, а не text и, следовательно, обходит проверки кодировки. В сочетании с convert_from эту функцию можно применять для чтения текста в указанной кодировке и преобразования в кодировку базы данных:
Следующая функция, заслуживающая особого внимания, — pg_stat_file, которая выводит атрибуты указанного объекта файловой системы:
размер в байтах;
время последнего обращения (atime, access time);
время последнего изменения (mtime, modification time);
время последнего изменения состояния (ctime, change time), только в Unix-системах;
время создания (creation time), только в Windows;
флаг, указывающий, что объект является каталогом.
Суммируем все сказанное выше: имея доступ к перечисленным функциям, можно прочитать содержимое любого каталога и файла в пределах прав пользователя, от имени которого запущена СУБД. По умолчанию доступ к функциям ограничен; при необходимости выдачи прав на эти функции риски безопасности следует серьезно взвесить и учесть.
Содержимое каталога с журналами сообщений СУБД. Функция pg_ls_logdir позволяет вывести содержимое каталога с журналами СУБД. Расположение каталога зависит от настроек конфигурации; использование функции позволяет сразу показать его содержимое в виде списка файлов и их атрибутов. Это довольно удобно, учитывая, что быстро определить, как и куда СУБД пишет журнал сообщений, — задача не совсем тривиальная, и ответ к тому же зависит от версии системы.
Функция выводит имя, размер и время последнего изменения (mtime) всех файлов (за исключением скрытых и специальных) в каталоге журналов сообщений СУБД. С точки зрения мониторинга можно получить полный объем, занимаемый журналами на диске:
Функция может вывести ошибку, если подсистема сбора журналов выключена (logging_collector = off) и каталога, указанного в log_directory, не существует. С некоторыми настройками журналы сообщений могут занимать много места, и, более того, они могут располагаться в каталоге кластера баз данных. Если журналы заполнят все свободное место в файловой системе, они станут причиной аварийной остановки СУБД.
По умолчанию доступ к функции pg_ls_logdir имеют только суперпользователи и члены группы pg_monitor, право на ее выполнение можно дать и другим пользователям.
Вывод содержимого каталога с WAL-журналами. Следующий каталог, не относящийся напрямую к пользовательским данным, но при этом имеющий тенденцию занимать много места, — это каталог WAL-журнала pg_wal. Обычно этот каталог размещается в основном каталоге кластера баз данных, но нередко его выносят наружу, а в самом каталоге кластера создают символическую ссылку. Делается это по соображениям производительности и использования места. Для вывода содержимого каталога WAL применяется функция pg_ls_waldir. Функция выводит имя, размер и время последнего изменения всех обычных файлов. Файлы с именами, начинающимися с точки, каталоги и другие специальные файлы не выводятся. По умолчанию доступ к этой функции имеют суперпользователи и члены группы pg_monitor, право на ее выполнение можно дать другим пользователям.
При настроенном архивировании WAL-журнала в каталоге pg_wal создается каталог archive_status, который хранит статусы архивирования всех сегментов (требующих архивирования). Для получения его содержимого используется функция pg_ls_archive_statusdir, которая также выводит имя, размер и время последнего изменения всех обычных файлов в каталоге (файлы с именами, начинающимися с точки, каталоги и другие специальные файлы не выводятся).
По умолчанию доступ к этой функции имеют только суперпользователи и члены группы pg_monitor, но право на ее выполнение можно дать и другим пользователям.
Обе функции — pg_ls_waldir и pg_ls_archive_statusdir — могут использоваться в целях мониторинга для получения информации о размере каталогов и очереди архивирования. Более подробно эта тема рассмотрена в главе 7, посвященной мониторингу репликации.
Вывод содержимого каталогов с временными файлами. Следующая функция предназначена для вывода содержимого каталогов с временными файлами. Функция pg_ls_tmpdir выводит имя, размер и время последнего изменения всех обычных файлов в каталоге для временных объектов. Таких каталогов может быть несколько, размещаются они в каталогах табличных пространств. Функция учитывает эту особенность и в качестве аргумента может принимать имя конкретного табличного пространства (если имя не указано, используется pg_default). Файлы с именами, начинающимися с точки, каталоги и другие специальные файлы не выводятся. По умолчанию доступ к функции имеют только суперпользователи и члены группы pg_monitor, но право на ее выполнение можно дать и другим пользователям.
Функция pg_ls_tmpdir может применяться в мониторинге для отслеживания временных файлов, однако есть несколько подходов и особенностей, которые следует учитывать. Более подробно тема мониторинга временных файлов рассмотрена в главе 5, посвященной вводу-выводу.
Прочие функции для вывода содержимого каталогов. Следующие функции относятся к выводу содержимого каталогов, задействованных в репликации и логическом декодировании (которое используется в логической репликации). Все следующие функции выводят имя, размер и время последнего изменения всех обычных файлов в целевых каталогах:
pg_ls_logicalmapdirвыводит содержимое pg_logical/mappings;pg_ls_logicalsnapdirвыводит содержимое pg_logical/snapshots;
pg_ls_replslotdirвыводит содержимое pg_replslot/slot_name, где slot_name — это имя конкретного слота репликации.
Перечисленные функции могут применяться для мониторинга при использовании логической репликации или слотов репликации. Как обычно, файлы с именами, начинающимися с точки, каталоги и другие специальные файлы не выводятся. По умолчанию доступ к функции имеют только суперпользователи и члены группы pg_monitor, но право на ее выполнение можно дать и другим пользователям.
Резюме
СУБД представляет множество абстракций для организации и хранения данных.
Кластер баз данных — это единый и неделимый набор баз данных.
Кластер баз данных, табличные пространства, таблицы и индексы являются каталогами и файлами в файловой системе.
Базы данных являются изолированными друг от друга «контейнерами».
Схемы являются пространствами имен для группировки объектов.
Таблицы состоят из основного хранилища данных и вспомогательных служебных слоев.
Таблицы имеют страничную организацию с фиксированным размером блока.
TOAST-таблицы являются дополнительными к основным таблицам и предназначены для хранения больших значений.
В каталоге кластера баз данных есть множество служебных каталогов, не связанных с хранением пользовательских данных.
СУБД предоставляет администратору набор функций для работы с ее объектами.
Статистика использования таблиц и индексов позволяет посмотреть на рабочую нагрузку еще с одной стороны.
В рабочей нагрузке могут возникать ошибки и нежелательные события.
Размер — важная характеристика объектов СУБД.
stackoverflow.com/questions/36900462/postgres-wont-start-after-deleting-pg-xlog-files ↩︎
www.depesz.com/2016/10/25/waiting-for-postgresql-10-rename-pg_xlog-directory-to-pg_wal ↩︎
postgrespro.ru/docs/postgresql/current/sql-createdatabase ↩︎
www.cybertec-postgresql.com/en/hot-updates-in-postgresql-for-better-performance ↩︎
postgrespro.ru/docs/postgresql/current/functions-admin#FUNCTIONS-ADMIN-DBOBJECT ↩︎
postgrespro.ru/docs/postgresql/current/functions-admin#FUNCTIONS-ADMIN-GENFILE ↩︎