# Выполнение запросов и функций
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
> [!NOTE]
> **В этой главе мы рассмотрим:**
>
> - зачем нужен мониторинг запросов;
>
> - расширение `pg_stat_statements`;
>
> - метаданные запроса;
>
> - статистику планирования и исполнения запросов;
>
> - практические примеры использования `pg_stat_statements`;
>
> - сквозную идентификацию запросов по всем источникам статистики;
>
> - примеры отчетов на основе `pg_stat_statements`;
>
> - представление `pg_stat_statements_info`;
>
> - представление `pg_stat_user_functions`.
В предыдущей главе мы рассмотрели клиентские процессы и сеансы, связанную с ними статистику и примеры ее использования для задач мониторинга. Далее, в этой главе, мы заглянем внутрь клиентских сеансов и рассмотрим способы анализа рабочей нагрузки. Запросы, отправляемые клиентом, определяют рабочую нагрузку; ее эффективное выполнение сервером СУБД определяет общую производительность системы. Статистика СУБД дает администратору возможность рассматривать нагрузку с разных точек зрения и разбирать общий поток рабочей нагрузки на отдельные запросы. Рассматривая запросы по отдельности, мы можем наметить отправные точки их оптимизации, что в итоге положительно скажется на общей производительности СУБД.
## 3.1. Зачем нужен мониторинг запросов {#mon-section-3-1}
После установки соединения и настройки сеанса СУБД готова выполнять команды клиента. Посредством команд клиент может запрашивать и изменять данные (DML-команды), управлять объектами схемы (DDL-команды), выполнять служебные операции и т. п. Полный список команд можно найти в официальной документации[^mon-72-1]. Базовой единицей выполнения в рабочей нагрузке можно считать *запросы* (queries) — это, как правило, команды на извлечение и изменение данных: `SELECT`, `INSERT`, `UPDATE`, `DELETE`.
> [!NOTE]
>
>
> **Команда, оператор, запрос?**
>
> Помимо термина *запрос*, в документации можно встретить термин *оператор* (statement). Это понятие имеет более широкий смысл: «оператор» охватывает весь диапазон существующих команд, в то время как «запрос» — это подмножество команд, которые возвращают результат или изменяют данные. Далее в этой главе вместо слов «команда» и «оператор» я буду использовать более привычный термин «запрос».
Запросы, их количество и типы, а также участвующие в них объекты БД формируют индивидуальный для каждой СУБД профиль рабочей нагрузки, для выполнения которой требуются ресурсы. Оптимизируя отдельные типы запросов, можно в конечном счете оптимизировать использование ресурсов самой СУБД и добиться существенного увеличения производительности (или сокращения избыточно выделенных ресурсов, которые ранее были необходимы).
Часто на практике приходится быть свидетелем попыток решить проблемы производительности поиском *магического* параметра в настройках, включение которого ускорит все и сразу. К сожалению, «ускорения», вызванные такими параметрами, жертвуют стабильностью или надежностью системы, так что нужно заранее хорошо оценивать риски. Более того, таким способом нельзя добиться качественного улучшения производительности и того вау-эффекта (ускорения на порядки), которого можно достичь только с помощью оптимизации запросов. Наиболее правильный путь — это рефакторинг запроса или в простом случае добавление индекса под конкретный тип запроса. Поэтому понимание того, какие запросы выполняются в системе, является ключевым пунктом для будущей оптимизации производительности.
Для оценки профиля рабочей нагрузки и выполняемых запросов используется несколько представлений:
- `pg_stat_statements` — представление с кумулятивной статистикой по запросам, предоставляемое одноименным расширением;
- `pg_stat_user_functions` — представление со статистикой выполнения пользовательских функций.
Помимо этих стандартных средств, есть и другие инструменты, которые разрабатываются сообществом на основе `pg_stat_statements`:
- `pg_stat_kcache`[^mon-73-1] — расширение собирает статистику о фактическом использовании системных ресурсов отдельными запросами клиентских процессов. Для учета статистики используется системный вызов `getrusage`[^mon-73-2], и это может накладывать некоторые ограничения на платформы, отличные от Linux;
- `pg_stat_monitor`[^mon-73-3] — расширение позиционируется как дополнение к `pg_stat_statements`, в котором есть расширенные средства для оценки запросов: агрегация статистики по интервалам, сбор планов, учет таблиц, участвующих в запросах, и многое другое.
Расширения добавляют отдельные представления, которые дополняют функциональность `pg_stat_statements` новыми возможностями. Однако я оставлю их рассмотрение в качестве домашнего задания читателю.
## 3.2. Расширение pg\_stat\_statements {#mon-section-3-2}
Представление `pg_stat_statements` является одним из основных источников статистики по всем запросам, которые выполняются в СУБД. Представление служит интерфейсом к одноименному расширению, которое отслеживает стадии выполнения запросов и хранит накопленную статистику. Расширение сохраняет статистику по всем успешно выполненным запросам. В случаях, когда запрос завершился ошибкой (или был прерван администратором), статистика о нем не будет сохранена, что, пожалуй, можно считать некоторым недостатком при учете ресурсов.
По умолчанию расширение `pg_stat_statements` выключено, однако рекомендуется всегда его включать. Сделать это можно следующим образом:
1. Указать расширение в параметре *shared\_preload\_libraries*, после чего перезапустить сервер. Это необходимо для резервирования места в общей памяти, инициализация которой выполняется только при старте; получить место в уже выделенной общей памяти на лету во время работы СУБД невозможно.
2. После перезапуска СУБД расширение нужно установить в конкретной базе. Для этого подходит любая база: можно использовать базу данных `postgres`, которая всегда создается по умолчанию. Несмотря на то что расширение устанавливается в конкретную базу, сбор статистики осуществляется глобально для всех запросов независимо от того, в каких базах они работают. Установка выполняется с помощью команды `CREATE EXTENSION pg_stat_statements;`.
В тестовом окружении расширение `pg_stat_statements` уже установлено и настроено, поэтому дополнительного ничего делать не нужно. После установки расширения сбор статистики начинается автоматически. Убедиться в этом можно простым запросом к `pg_stat_statements` с подсчетом количества строк в представлении:
```text {label="psql" .source-commands hl_lines="1"}
# SELECT count(*) FROM pg_stat_statements;
count
-------
113
```
На данный момент уже накоплена статистика по 113 *типам* запросов. Запросы, даже очень похожие друг на друга, могут отличаться значениями параметров. Хранить в статистике запросы со всеми значениями параметров избыточно — запросы могут содержать сотни и тысячи параметров и уникальных значений. Поэтому в процессе сбора для каждого запроса выполняется *нормализация* — конкретные параметры заменяются пронумерованными заполнителями вида `$1`, `$2`, `$3` и т. д. Нормализация позволяет отнести запрос к некоторому типу и учитывать объем использованных ресурсов для этого типа.
Вместе с основным представлением устанавливается еще одно — `pg_stat_statements_info` с метаданными о работе самого расширения; оба представления основаны на одноименных функциях. Вместе с представлениями в составе расширения есть служебная функция `pg_stat_statements_reset`, предназначенная для сброса накопленной статистики.
Помимо обязательного указания в *shared\_preload\_libraries*, расширение имеет несколько параметров конфигурации, которые позволяют подстраивать работу расширения под различные условия эксплуатации СУБД:
- *pg\_stat\_statements.max* — максимальное количество типов запросов, отслеживаемых расширением, что соответствует количеству строк в представлении. При регистрации большого количества запросов реже обновляемая часть статистики может быть удалена. Факты удаления можно отследить с помощью `pg_stat_statements_info.dealloc`. Значение параметра устанавливается только при старте сервера. На практике значения по умолчанию (5000) обычно достаточно, но на производственных серверах с большим разнообразием запросов его имеет смысл сразу увеличивать как минимум вдвое, чтобы избежать перезапуска СУБД в будущем.
- *pg\_stat\_statements.track* — уровень отслеживаемых запросов. Возможные значения:
— `top` — отслеживать вызовы верхнего уровня, то есть запрошенные клиентом. Включено по умолчанию;
— `all` — отслеживать все вызовы, включая вложенные в функции и процедуры;
— `none` — отключить сбор и хранение статистики.
При наличии хранимых процедур и функций имеет смысл устанавливать значение `all`, что позволит иметь более детальную статистику о выполняемой рабочей нагрузке.
- *pg\_stat\_statements.track\_utility* — отслеживать ли статистику для служебных команд, отличных от DML-запросов вроде `SELECT`, `INSERT`, `UPDATE` и `DELETE`. Если на основе представления `pg_stat_statements` строятся отчеты производительности, включение этого параметра позволит получить более полную и точную картину о рабочей нагрузке. Но важно помнить, что отслеживаемые служебные команды также будут занимать место в памяти и может возникнуть риск удаления статистики из-за достижения *pg\_stat\_statements.max*.
- *pg\_stat\_statements.track\_planning* — собирать ли статистику о планировании запросов. По умолчанию сбор выключен, так как может приводить к снижению производительности, особенно в случае, когда запросы с одинаковой структурой выполняются множеством клиентов (что характерно для OLTP-нагрузки), поскольку это вызывает конкуренцию за обновление одних и тех же элементов статистики.
- *pg\_stat\_statements.save* — сохранять ли статистику при перезапусках или выключении сервера. По умолчанию включено, и обычно эту настройку можно оставить без изменений.
Перечисленные параметры можно указать в основной конфигурации, в файле `postgresql.conf`, и для вступления в силу большинства из них достаточно перечитать конфигурацию (для изменения *pg\_stat\_statements.max* требуется перезапуск).
Больше подробностей, относящихся к работе расширения, можно найти в официальной документации[^mon-76-1].
Всю статистику в `pg_stat_statements` можно условно разделить на несколько категорий:
- запрос и его метаданные;
- статистика планирования (доступна с PostgreSQL 13 и `pg_stat_statements` 1.8);
- статистика выполнения;
- статистика использования ресурсов — здесь речь идет об использовании ресурсов с точки зрения СУБД, а с точки зрения операционной системы она может иметь несколько иной вид, о чем я упомяну отдельно;
- статистика записи в WAL-журнал (доступна с PostgreSQL 13 и `pg_stat_statements` 1.8);
- статистика JIT-компилятора (доступна с PostgreSQL 15 и `pg_stat_statements` 1.10).
Можно заметить, что разная статистика появляется в разных версиях расширения. При обновлениях основной версии СУБД следует также обновлять и расширения.
В следующих разделах мы шаг за шагом рассмотрим все категории статистики.
## 3.3. Метаданные запроса {#mon-section-3-3}
Текст запроса и его метаданные позволяют отличать одни запросы от других и дают отправную точку поиска приложения, отправившего запрос. Запрос и его метаданные представлены несколькими полями:
- `userid` — идентификатор пользователя, от имени которого был выполнен запрос. Имя можно найти с помощью соединения с `pg_user` или функцией `pg_get_userbyid`;
- `dbid` — идентификатор базы данных, в которой был выполнен запрос. Имя можно найти с помощью соединения с `pg_database`. Функция для получения имени базы данных идентификатору отсутствует;
- `queryid` — идентификатор запроса, вычисляемый на основе его текста. На него не влияют имя пользователя или базы, и если аналогичный запрос выполняется в других базах или другими пользователями, то значения `queryid` для таких запросов будут совпадать;
- `query` — нормализованный текст запроса. Нормализация объединяет множество однотипных запросов с разными значениями параметров в один общий тип запроса, где конкретные значения заменены пронумерованными аргументами;
- `toplevel` — уровень вызова запроса: `true` для вызовов верхнего уровня и `false`, если вызов был вложен в процедуру или функцию. Если *pg\_stat\_statements.track* установлен в значение `top`, поле всегда равно `true`. При создании отчетов производительности этот флаг позволяет отфильтровать вложенные вызовы и не учитывать их статистику, поскольку она уже учтена в статистике запросов верхнего уровня. Без использования этого флага статистика может быть посчитана несколько раз, и отчет получится неверным.
С помощью метаданных появляется возможность выделить и сгруппировать статистику по отдельным пользователям, базам данных или группам:
```text {label="psql" .source-commands hl_lines="1 2 3 4"}
# SELECT pg_get_userbyid(s.userid) AS username, d.datname, count(*)
FROM pg_stat_statements s, pg_database d
WHERE s.dbid = d.oid
GROUP BY 1,2 ORDER BY 3 DESC;
username | datname | count
----------+----------+-------
stats | postgres | 31
pgbench | pgbench | 12
stats | pgbench | 10
maru | pgbench | 9
classic | pgbench | 9
serral | pgbench | 9
postgres | postgres | 6
```
## 3.4. Планирование запроса {#mon-section-3-4}
Планирование — это отдельный этап, предшествующий выполнению запроса. На этом этапе планировщик рассматривает набор планов, которые могут отличаться сложностью исполнения и *стоимостью* (cost) — оценкой количества вычислительных ресурсов, необходимых для выполнения запроса. Стоимость измеряется в условных единицах, за базу принята стоимость чтения одной страницы при последовательном доступе. Среди построенных планов выбирается наиболее оптимальный, то есть имеющий наименьшую стоимость, согласно которому и будет выполнен запрос. В общем случае план зависит от сложности запроса, наличия подходящих индексов, настроек планировщика и того, насколько статистика соответствует реальным данным. Статистика планирования в `pg_stat_statements` позволяет отслеживать количество планирований и общее время, затраченное на планирование. Однако, как уже замечено, по умолчанию сбор статистики планирования выключен ввиду возможного снижения производительности при видах рабочей нагрузки, схожих с OLTP.
Статистика планирования в `pg_stat_statements` представлена следующими полями:
- `plans` — количество планирований запроса;
- `total_plan_time` — общее время, затраченное на планирование запросов данного типа;
- `min_plan_time` — наименьшая продолжительность планирования;
- `max_plan_time` — наибольшая продолжительность планирования;
- `mean_plan_time` — средняя продолжительность планирования;
- `stddev_plan_time` — величина стандартного отклонения для времени, затраченного на планирование.
Все значения времени указываются в миллисекундах.
Наибольший интерес в этой статистике вызывают время планирования и факты его значительных изменений, особенно в бóльшую сторону, когда запрос стал планироваться дольше при более или менее постоянном количестве планирований. Такое случается на практике, но, к счастью, это большая редкость.
Сценариев использования статистики планирования не так много, отправными точками могут служить следующие варианты:
- время планирования отдельных типов запросов может быть полезно для отслеживания аномалий планирования в случаях, когда объем выполняемых запросов не изменяется;
- величина стандартного отклонения показывает, насколько сильно время планирования «гуляет» относительно среднего времени планирования.
Давайте рассмотрим в качестве примера первый вариант. Для этого нам потребуется следующий запрос:
```text {label="PromQL" .source-commands hl_lines="1 2 3 4 5 6 7"}
# topk_avg(5,
sum by (queryid,query) (
rate(postgres_statements_time_seconds_total{
service_id="primary",mode="planning"
}[1m]) + on(database,user,queryid) group_left(query)
0 * postgres_statements_query_info{service_id="primary"}
), "other")
```
Подобные запросы будут и дальше использоваться в этой главе, поэтому его стоит детально разобрать:
- в качестве основной величины берется некоторая конкретная метрика, в данном случае это `postgres_statements_time_seconds_total`;
- относительно этой метрики считается частота изменений в минуту;
- для получения метки с текстом запроса (`query`) выполняется соединение с метрикой `postgres_statements_query_info` на основе общих меток `database`, `user`, `queryid`;
- величина `postgres_statements_query_info` равна единице, поэтому умножаем ее на ноль, чтобы не прибавлять лишнюю единицу к величине основной метрики;
- полученные метрики с частотой изменения суммируются с группировкой по меткам `queryid` и `query`, поскольку в тестовом окружении есть несколько пользователей, которые совместно выполняют одни и те же запросы;
- функция `topk_avg` считает средние величины за выбранный интервал временнóго ряда, сортирует их по убыванию и берет первые *K* значений (в данном случае пять), а остальные суммирует в шестую метрику с меткой `other`.
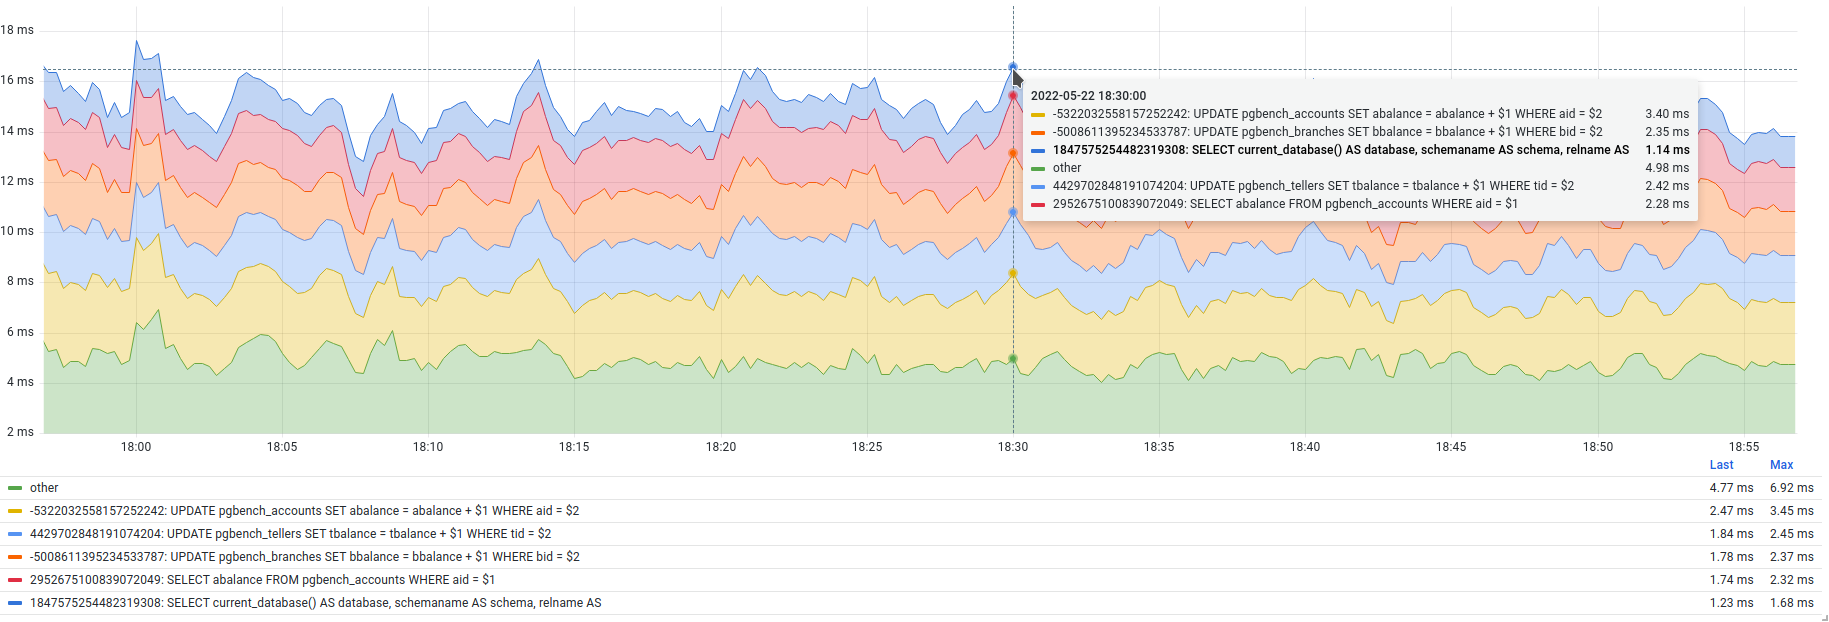
Полученный запрос выводит статистику по времени планирования (метка `mode=`"`planning`") пяти запросов, которые планировались наиболее долго. Время планирования остальных запросов объединено в шестой метрике с меткой `other`.
На основе запроса можно построить так называемый *график top-K* (рис. [3.1](/ru/03-queries-and-functions/#mon-figure-caption-61)), который будет довольно часто появляться на протяжении всей книги. Удобство этого графика заключается в том, что он позволяет вывести и наибольшие величины, и сумму оставшихся.
{#fig-3.1 num="3.1" caption="Время планирования запросов" width=1829 height=622}
Каждая строка легенды содержит идентификатор и текст запроса, а также последнее и максимальное значение метрики. Для каждого типа запросов график показывает, сколько *машинного* времени СУБД тратит на планирование в одну секунду *реального* времени. В машинном времени суммируется продолжительность работы всех ядер, поэтому в нагруженных системах с многоядерными процессорами машинное время за одну реальную секунду легко может секунду превышать. График отображает изменение частоты именно *суммарного* времени планирования всех запросов конкретного типа, и эту особенность очень важно понимать. На графике отмечена конкретная точка — 18:30:00, и в эту секунду реального времени на планирование всех запросов всеми ядрами в сумме было затрачено около 16 миллисекунд (более подробная детализация приведена во всплывающей подсказке).
График времени планирования важно рассматривать вместе с графиком количества планирований на основе `pg_stat_statements.plans`. Поскольку величина затраченного времени прямо пропорциональна количеству планирований, при уменьшении (или увеличении) числа планирований затраченное время также уменьшится (или увеличится). Подозрительными можно считать случаи, когда время планирования изменилось, а количество планирований осталось прежним или вообще изменилось в обратную сторону.
## 3.5. Исполнение запроса {#mon-section-3-5}
Стадия исполнения — это основной этап жизни запроса, в котором СУБД, используя системные ресурсы, выполняет его согласно плану и возвращает результат пользователю. Результатом может быть набор строк или тег (command tag). От скорости выполнения напрямую зависят текущая производительность и время отклика, ведь чем быстрее выполнится запрос и чем больше их можно выполнить за единицу времени, тем больше и общая производительность СУБД. Статистика исполнения запросов является наиболее полезной и востребованной, так как позволяет найти аномалии при выполнении запросов и сразу же начать оптимизацию (рефакторинг запроса, добавление индекса и т. п.), не погружаясь при этом глубоко в детали использования ресурсов.
Статистика исполнения представлена несколькими полями:
- `calls` — количество успешно исполненных запросов. По смыслу это поле близко к `plans`, однако оба поля являются независимыми, считаются отдельно друг от друга и могут содержать разные значения. Успешное планирование не гарантирует, что исполнение не завершится ошибкой. И наоборот, из успешного исполнения не следует, что перед ним выполнялось планирование: в случае подготовленных запросов (prepared statements) на этапе подготовки план выполнения может кешироваться;
- `rows` — общее количество строк, которое было возвращено (`SELECT`) или затронуто (`INSERT`, `UPDATE`, `DELETE`) в результате выполнения всех запросов данного типа;
- `total_exec_time` — общее время, затраченное на исполнение запросов данного типа. Это время включает в себя и время ожидания блокировок и событий;
- `min_exec_time` — наименьшая продолжительность исполнения;
- `max_exec_time` — наибольшая продолжительность исполнения;
- `mean_exec_time` — средняя продолжительность исполнения;
- `stddev_exec_time` — величина стандартного отклонения продолжительности исполнения;
- `blk_read_time` — общее время, затраченное на чтение данных и размещение их в буферном кеше;
- `blk_write_time` — общее время, затраченное на запись данных.
> [!NOTE]
> **Время планирования**
>
> До версии `pg_stat_statements` 1.9 поля, показывающие время выполнения, назывались иначе и не содержали в своем имени слова `exec`. Переименование вызвано внедрением отслеживания планирования, из-за чего потребовалось добавить новые поля, а существующие переименовать. Например, поле `total_time` было переименовано в `total_exec_time`.
После включения и установки расширения сбор статистики осуществляется автоматически, за исключением статистики времени, затраченного на чтение и запись в буферный кеш (`blk_read_time` и `blk_write_time`). Для учета времени ввода-вывода необходимо включить параметр *track\_io\_timing*. Как и во всех остальных случаях, время выполнения считается в миллисекундах.
Статистика, связанная с исполнением запросов, позволяет понять состав рабочей нагрузки — типы запросов и их долю в общем объеме. Имея представление о запросах, можно сразу переходить к их оптимизации. Далее мы рассмотрим некоторые практические примеры использования статистики исполнения.
**Запросы с наибольшим количеством вызовов.** Количество вызовов можно получить в поле `calls` и с его помощью определить текущую производительность. Для ее вычисления нужно суммировать значения `calls` всех запросов:
```text {label="psql" .source-commands hl_lines="1 2"}
# SELECT sum(calls) AS total_calls
FROM pg_stat_statements;
total_calls
-------------
173438464
```
На выходе получилось довольно большое число. Напомню, что статистика `pg_stat_statements` накапливается в течение определенного периода, и полученное число — это количество выполненных запросов за все время накопления статистики. Значение производительности всегда определяется за какой-то период и выражается, например, в запросах в секунду или минуту. Для подсчета производительности достаточно простой арифметики, и в контексте PostgreSQL ее можно вычислить с помощью SQL и функции `\watch` клиента psql. Другой вариант — использовать функции, которые предлагает язык запросов системы мониторинга:
```text {label="PromQL" .source-commands hl_lines="1"}
# sum(rate(postgres_statements_calls_total{service_id="primary"})[1m])
```
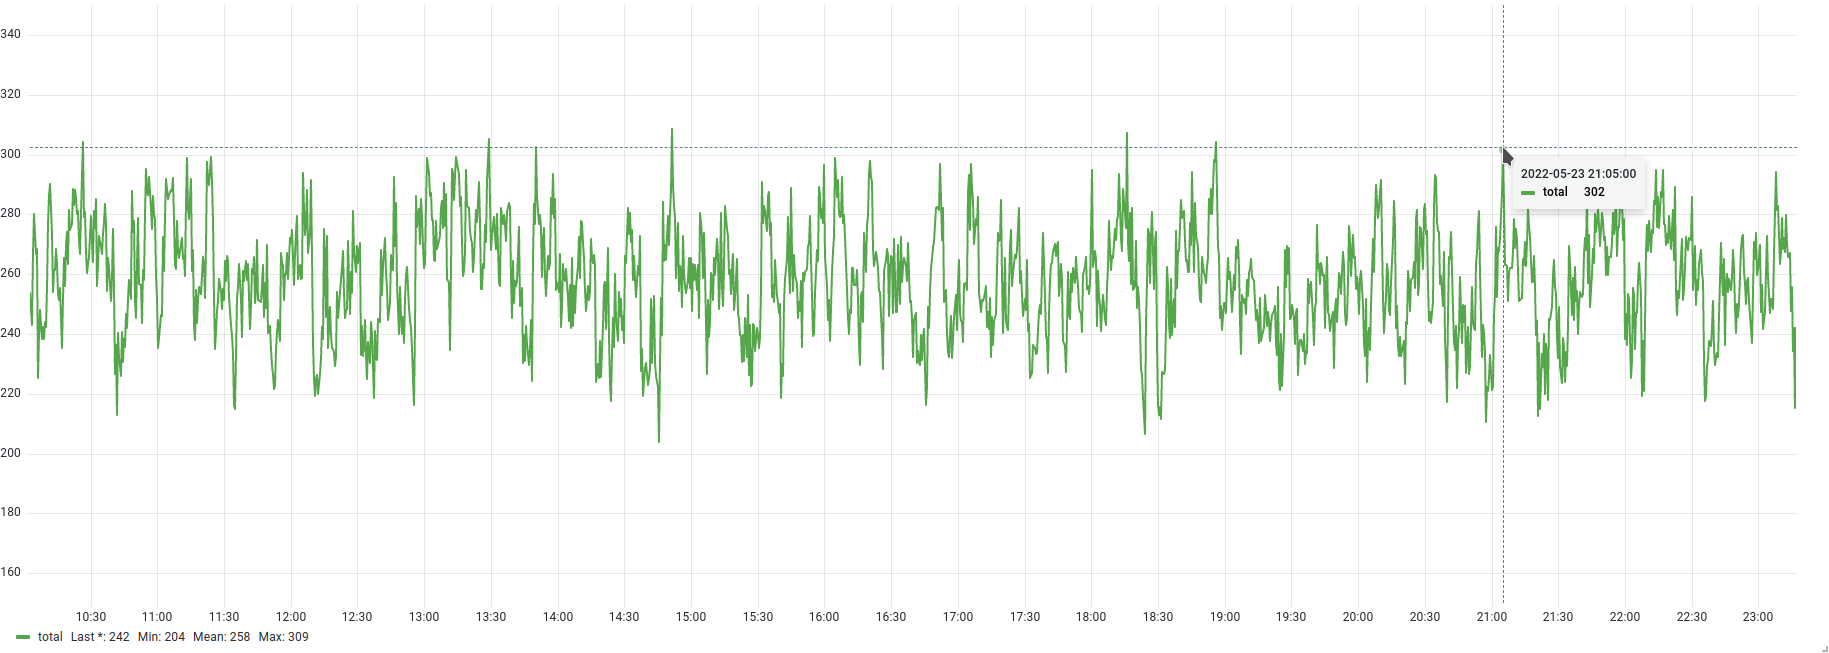
Функция `rate` считает частоту изменения величины `postgres_statements_calls_total` в указанном интервале (одна минута). Затем подсчитывается сумма для всех метрик (на каждый тип запроса — отдельная метрика). Результатом запроса будет график, показанный на рис. [3.2](/ru/03-queries-and-functions/#mon-figure-caption-63).
На графике изображена динамика изменения частоты выполнения запросов, в легенде внизу подсчитаны агрегаты для интервала. Так, например, средняя частота выполнения — 258 запросов в секунду примерно за 12 часов.
Такой график дает поверхностное представление о текущей рабочей нагрузке, и при ее изменении можно увидеть и изменение в производительности, особенно в случае значительных колебаний. Исключив общее суммирование, можно получить подробную детализацию и определить долю отдельных типов запросов в общей производительности. Это дает понимание того, какие запросы выполняются чаще остальных и на каких запросах стоит сосредоточиться при оптимизации.
{#fig-3.2 num="3.2" caption="Текущая производительность" width=1829 height=653}
Средствами SQL аналогичный результат можно получить следующим запросом:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7"}
# SELECT
sum(calls) AS total_calls,
left(query, 64) AS query_trunc
FROM pg_stat_statements
GROUP BY query
ORDER BY sum(calls) DESC
LIMIT 10;
total_calls | query_trunc
-------------+------------------------------------------------------------------
24525219 | SELECT abalance FROM pgbench_accounts WHERE aid = $1
24525219 | BEGIN
24525219 | UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE aid =
24525219 | UPDATE pgbench_tellers SET tbalance = tbalance + $1 WHERE tid =
24525217 | UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid =
24525213 | INSERT INTO pgbench_history (tid, bid, aid, delta, mtime) VALUES
24525213 | END
270642 | SELECT setting FROM pg_settings WHERE name = $1
225535 | SELECT datname FROM pg_database WHERE NOT datistemplate AND data
135321 | SELECT extnamespace::regnamespace FROM pg_extension WHERE extnam
```
Результат запроса показывает десять наиболее часто выполняемых запросов. Однако здесь мы снова видим «большие» цифры, которые указывают на общую статистику, накопленную за весь период сбора. Это может быть полезно для построения отчетов, но в оперативной ситуации нагрузка непостоянна, и важно видеть изменение частоты выполнения запросов.
С помощью графиков можно увидеть эту картину в динамике, и для начала можем воспользоваться следующим запросом:
```text {label="PromQL" .source-commands hl_lines="1 2 3 4 5 6"}
# topk_avg(5,
sum by (queryid,query) (
rate(postgres_statements_calls_total{service_id="primary"}[1m])
+ on(database,user,queryid) group_left(query)
0 * postgres_statements_query_info{service_id="primary"}
), "other")
```
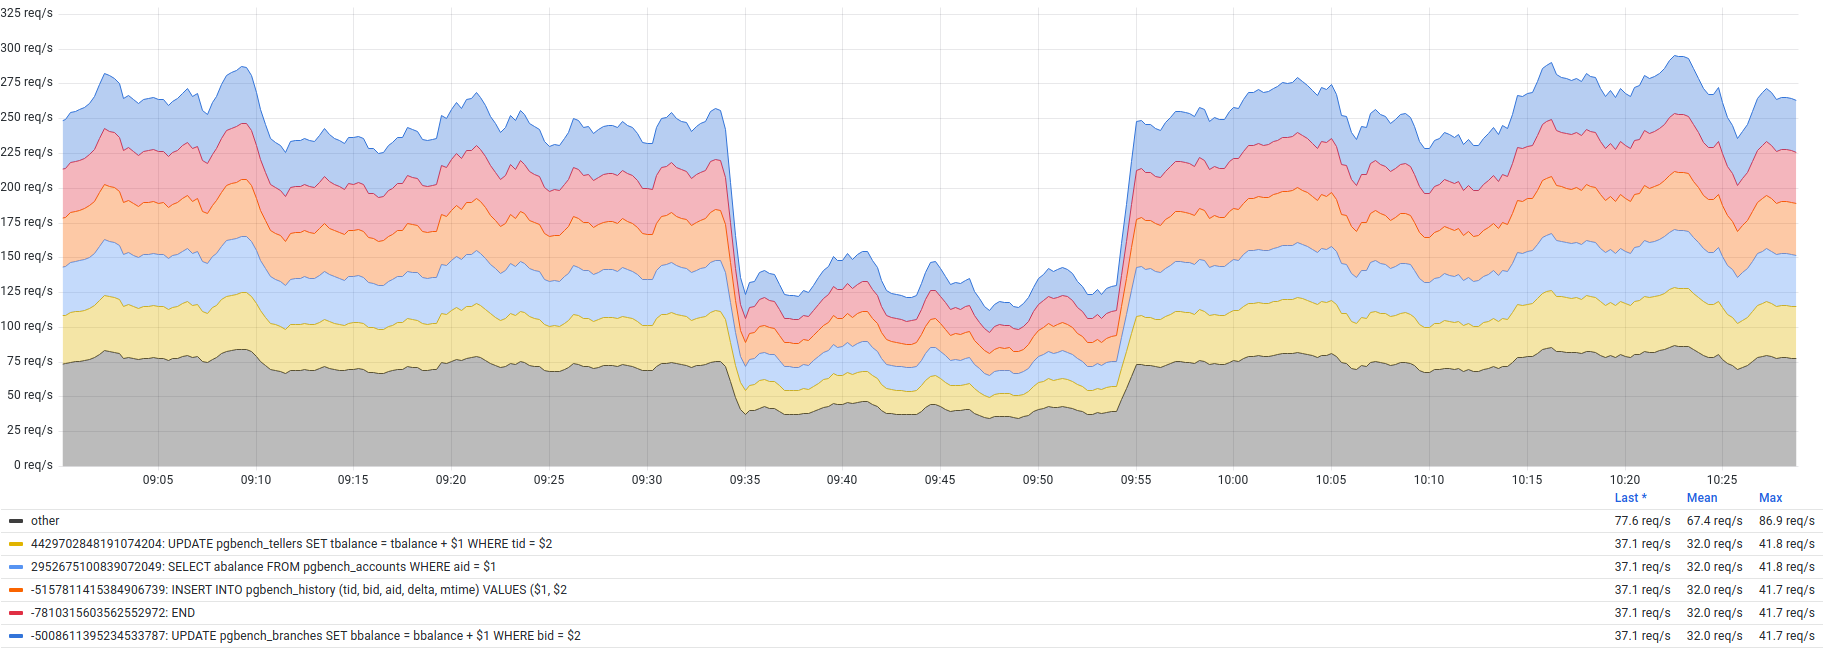
На основе запроса получается следующий график (рис. [3.3](/ru/03-queries-and-functions/#mon-figure-caption-64)):
{#fig-3.3 num="3.3" caption="Наиболее вызываемые запросы" width=1829 height=652}
На этом графике тоже показана текущая производительность, но уже с большей детализацией. Здесь видны те запросы, которые занимают наибольшую долю рабочей нагрузки и выполняются чаще остальных. Остальные запросы также присутствуют на графике в виде объединенной метрики с меткой `other`. В случае количественного изменения рабочей нагрузки, например при изменении количества экземпляров приложений (или одновременно работающих пользователей), это изменение будет заметно: просадка на графике — это следствие выключения одного из приложений. Однако важно понимать, что большое количество выполненных запросов не означает большого потребления ресурсов, и далее мы рассмотрим примеры, как получить информацию и об использовании ресурсов, и о тех запросах, что занимают существенную долю в рабочей нагрузке.
**Запросы с наибольшим количеством затронутых строк.** Сортировка запросов по количеству затронутых строк полезна при анализе OLTP-нагрузки. При таком виде нагрузки запросы обычно возвращают немного строк. Если запросы возвращают большое количество строк (тысячи и более), это может быть признаком ошибки в дизайне приложения: маловероятно, что клиенту, который выполнил запрос, нужны все эти тысячи строк. Возможно, в запросе не указано ключевое слово `LIMIT`, либо приложение обрабатывает строки своими силами, хотя это можно было сделать на стороне СУБД. Выявить такие запросы можно следующим образом:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7"}
# SELECT
sum(rows) AS total_rows,
left(query, 64) AS query_trunc
FROM pg_stat_statements
GROUP BY query
ORDER BY sum(rows) DESC
LIMIT 10;
total_rows | query_trunc
------------+------------------------------------------------------------------
27968942 | UPDATE pgbench_tellers SET tbalance = tbalance + $1 WHERE tid =
27968942 | UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE aid =
27968942 | SELECT abalance FROM pgbench_accounts WHERE aid = $1
27968940 | UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid =
27968936 | INSERT INTO pgbench_history (tid, bid, aid, delta, mtime) VALUES
17857314 | SELECT name, setting, unit, vartype FROM pg_show_all_settings()
5415236 | SELECT d.datname AS database, pg_get_userbyid(p.userid) AS user,
2768140 | SELECT coalesce(usename, backend_type) AS user, datname AS datab
2000000 | update pgbench_accounts set abalance = abalance + $1
514620 | SELECT datname FROM pg_database WHERE NOT datistemplate AND data
```
Как и в случае с сортировкой по количеству выполненных запросов, в поле `total_rows` видим большие значения. В мониторинге можно увидеть эту картину в динамике с помощью запроса:
```text {label="PromQL" .source-commands hl_lines="1 2 3 4 5 6"}
# topk_avg(5,
sum by (queryid,query) (
rate(postgres_statements_rows_total{service_id="primary"}[1m])
+ on(database,user,queryid) group_left(query)
0 * postgres_statements_query_info{service_id="primary"}
), "other")
```
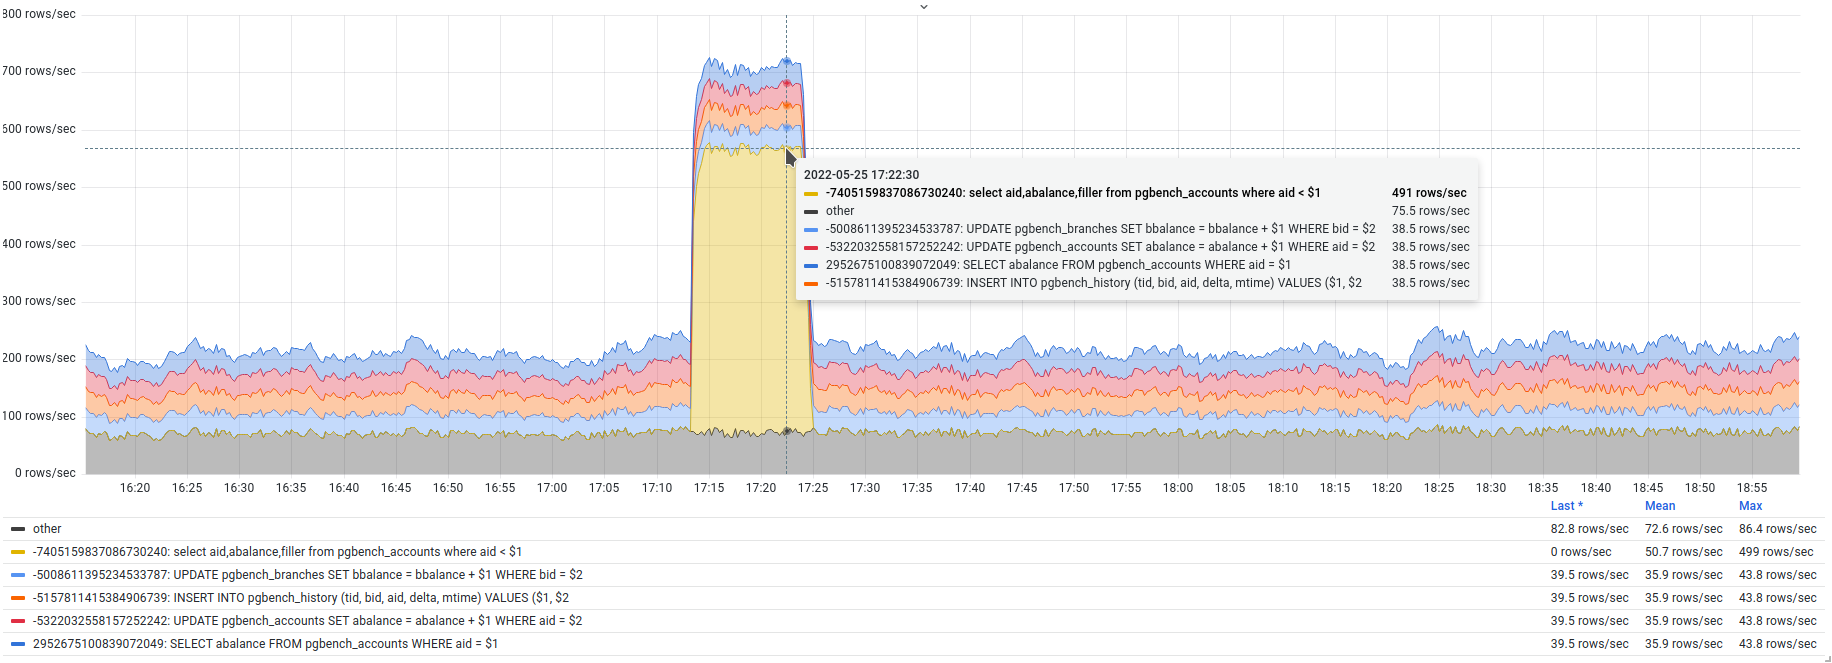
На рис. [3.4](/ru/03-queries-and-functions/#mon-figure-caption-66) показан соответствующий график:
{#fig-3.4 num="3.4" caption="Запросы, затрагивающие наибольшее количество строк" width=1832 height=663}
При стабильной рабочей нагрузке без сильных колебаний этот график может выглядеть более или менее ровно, при этом практически любой аномальный запрос выделяется довольно хорошо. В данном примере это можно наблюдать по простому запросу, который был запущен в цикле с помощью команды `\watch 1` в psql:
```text {label="psql" .source-commands hl_lines="1 2"}
# SELECT aid, abalance, filler
FROM pgbench_accounts WHERE aid < 500;
```
Этот запрос возвращает примерно 490 строк в секунду, в то время как его ближайшие соседи — в среднем по 35 строк, и это хорошо заметно на графике. На практике так обычно выглядят запросы с забытым ключевым словом `LIMIT`. В запросе, например, может использоваться сортировка, и для выполнения условий запроса и последующей сортировки СУБД просканирует большое количество строк и, более того, отправит их клиенту, что вызовет избыточный расход ресурсов не только на стороне СУБД, но и на стороне приложения. Если это какой-то регулярно выполняемый запрос, а не разовая задача, то нужно проанализировать запрос и его соответствие техническому заданию. Если запрос написан именно так, как и задумано, стоит проверить бизнес-требования функции, для которой используется этот запрос, — насколько оправданно обращение к такому большому количеству строк (даже для разбиения на страницы есть способы читать ровно столько, сколько нужно).
**Запросы с наибольшим временем исполнения.** Время исполнения является наиболее важной характеристикой запроса как элемента рабочей нагрузки. Уменьшение времени исполнения запроса приведет к увеличению производительности СУБД: за счет высвободившихся ресурсов можно будет выполнить дополнительные запросы. Для получения запросов, на выполнение которых было затрачено больше всего времени, можно использовать запрос, подобный тому, что использовался в предыдущих разделах:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7"}
# SELECT
to_char(
interval '1 millisecond' * sum(total_exec_time), 'HH24:MI:SS'
) AS exec_time,
left(query, 64) AS query_trunc
FROM pg_stat_statements
GROUP BY query ORDER BY sum(total_exec_time) DESC LIMIT 10;
exec_time | query_trunc
-----------+------------------------------------------------------------------
105:41:06 | UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid =
14:14:38 | UPDATE pgbench_tellers SET tbalance = tbalance + $1 WHERE tid =
04:00:12 | UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE aid =
00:53:14 | SELECT current_database() AS database, schemaname AS schema, fun
00:45:37 | SELECT current_database() AS database, s1.schemaname AS schema,
00:43:06 | SELECT current_database() AS database, schemaname AS schema, rel
00:26:14 | SELECT coalesce(datname, $1) AS database, xact_commit, xact_roll
00:25:45 | SELECT checkpoints_timed, checkpoints_req, checkpoint_write_time
00:25:44 | SELECT pg_is_in_recovery()::int AS recovery, wal_records, wal_fp
00:25:17 | SELECT archived_count, failed_count, extract($1 from now() - las
```
Напомню, что поле `total_exec_time` хранит время в миллисекундах, и в этом запросе оно для удобства преобразовано в привычный формат представления времени. Также для учета можно дополнительно включить и время планирования `total_plan_time`, получив суммарное время выполнения запроса, включая планирование.
В результате можно заметить существенно выделяющийся запрос: его суммарное время выполнения составило примерно 105 часов с отрывом от второго места в семь раз. Выполнение этого запроса и занимает большую часть рабочей нагрузки. Однако важным нюансом, который остался за кадром, является ответ на вопрос: а за какой интервал времени представлена эта статистика? Ведь 105 машинных часов в рамках одного дня или одного месяца — это совершенно разная рабочая нагрузка. Для получения ответа на этот вопрос можно обратиться к `pg_stat_statements_info.stats_reset`:
```text {label="psql" .source-commands hl_lines="1"}
# SELECT now() - stats_reset FROM pg_stat_statements_info;
?column?
-------------------------
17 days 08:11:35.489621
```
В данном случае статистика накоплена за 17 дней; получается, что интересующий нас запрос в течение суток выполнялся примерно шесть часов. В принципе, это немного, учитывая, что остается 18 часов, а если умножить часы на количество доступных процессорных ядер, то и еще больше.
Давайте перейдем к мониторингу и получим время выполнения запросов в динамике:
```text {label="PromQL" .source-commands hl_lines="1 2 3 4 5 6 7"}
# topk_avg(5,
sum by (queryid,query) (
rate(postgres_statements_time_seconds_total{
service_id="primary",mode="executing"
}[1m]) + on(database,user,queryid) group_left(query)
0 * postgres_statements_query_info{service_id="primary"}
), "other")
```
На основе запроса можно получить график, изображенный на рис. [3.5](/ru/03-queries-and-functions/#mon-figure-caption-68).
График показывает изменение времени выполнения (метка `mode=`"`executing`") для отдельных запросов, и по нему видно, что бóльшую часть времени СУБД занята выполнением однотипных запросов. На выполнение остальных требуется существенно меньше времени. Также здесь следует обратить внимание на сильное колебание времени. Для интересующего нас запроса оно находится в диапазоне от 83 до 1900 миллисекунд, и это подозрительно. В более или менее стабильной рабочей нагрузке диапазон изменений времени выполнения должен быть существенно меньшим (стандартное отклонение всей выборки должно быть близко к нулю). Дело в том, что время выполнения включает в себя и время ожидания, а из предыдущей главы мы знаем, что в тестовой рабочей нагрузке у нас довольно часто возникают ожидания блокировок. Из-за ожидания соседних транзакций время выполнения запросов сильно колеблется, что и отражается на графике.
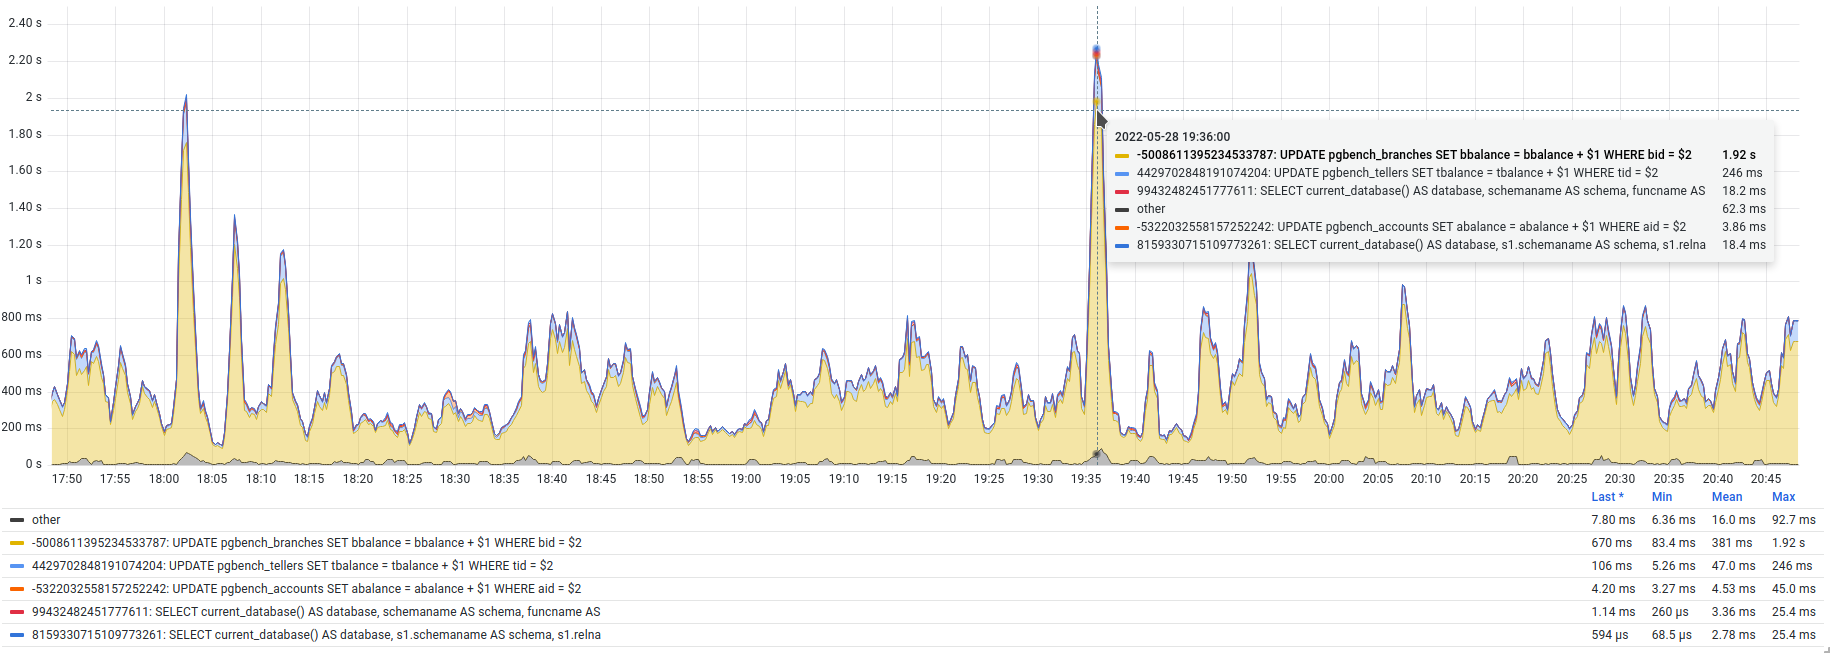
{#fig-3.5 num="3.5" caption="Запросы с наибольшим временем выполнения" width=1831 height=654}
На практике этот график является одним из наиболее востребованных, поскольку позволяет быстро выявить запросы, которые требуют внимания, и сразу приступить к их оптимизации. Часто время выполнения запроса удается значительно сократить, просто построив индекс. В более сложных случаях приходится делать рефакторинг запроса или, как в случае с тестовой нагрузкой, предпринимать меры для уменьшения конкуренции за ресурсы.
**Запросы с наибольшим временем ввода-вывода.** Время, затраченное на блочный ввод-вывод, является еще одной важной характеристикой рабочей нагрузки. Она, в числе прочего, показывает, сколько времени СУБД тратит на чтение данных в буферный кеш (shared buffers) и на запись данных из него, и в какой-то мере говорит о том, насколько вообще достаточно буферного кеша. Если данных нет в кеше, СУБД обратится к операционной системе, что, скорее всего, приведет к чтению с диска. Обращение к диску будет медленнее, чем обращение к кешу в памяти, и это негативно отразится на времени выполнения запроса. Есть шанс, что нужные данные окажутся в страничном кеше (page cache), и тогда их чтение также будет быстрым, хоть и с некоторыми накладными расходами.
В `pg_stat_statements` есть несколько полей, которые отображают время, затраченное на блочный ввод-вывод:
- `blk_read_time` и `blk_write_time` учитывают время ввода-вывода, связанного со страницами в общем и локальных кешах;
- `temp_blk_read_time` и `temp_blk_write_time` учитывают время ввода-вывода, связанного со страницами во временных файлах.
Учет статистики ведется только при включенном параметре *track\_io\_timing*. По опыту, всегда рекомендуется его включать (однако накладные расходы могут быть на уровне 1 %). За счет этой статистики появляется возможность выявить те запросы, которым регулярно требуется доступ к диску, и запланировать оптимизацию или увеличение ресурсов.
Можно вычислять как отдельные статистики по чтению и записи, так и одну общую. Обычно на практике используется второй вариант:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12"}
# SELECT
to_char(
interval '1 millisecond' * sum(
blk_read_time + blk_write_time + temp_blk_read_time + temp_blk_write_time
), 'HH24:MI:SS.MS'
) AS io_time,
left(query, 64) AS query_trunc
FROM pg_stat_statements
WHERE blk_read_time + blk_write_time + temp_blk_read_time + temp_blk_write_time > 0
GROUP BY query
ORDER BY sum(blk_read_time + blk_write_time + temp_blk_read_time + temp_blk_write_time) DESC
LIMIT 5;
io_time | query_trunc
--------------+------------------------------------------------------------------
01:25:08.755 | UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE aid =
00:00:02.125 | INSERT INTO pgbench_history (tid, bid, aid, delta, mtime) VALUES
00:00:00.121 | truncate pgbench_history
00:00:00.050 | UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid =
00:00:00.003 | SELECT current_database() AS database, schemaname AS schema, fun
```
Бóльшую часть времени ввод-вывод выполняется на одном типе запросов. Это другой запрос, не тот, что встретился в предыдущей части и на выполнение которого тратилось больше всего времени. Рассматривая подобные запросы, нужно учитывать частоту их выполнения. Например, обращение к диску может быть приемлемо для запросов, которые выполняются редко и затрагивают холодные (архивные) данные. К регулярно выполняющимся запросам, наподобие запроса, обнаруженного в тестовом окружении, такое постоянное обращение к диску может считаться накладным и увеличивать время выполнения запросов. Устранив обращения к диску или хотя бы уменьшив время обращения, можно ускорить выполнение запросов. В зависимости от характера обращений есть различные варианты: увеличить буферный кеш, так, чтобы все необходимые горячие данные полностью помещались в него; модернизировать системные ресурсы (увеличить память, использовать более производительный накопитель, виртуальную машину и т. п.). Самый лучший вариант, конечно же, провести анализ запроса и оптимизацию.
В мониторинге запросы с наибольшим временем блочного ввода-вывода можно получить следующим запросом:
```text {label="PromQL" .source-commands hl_lines="1 2 3 4 5 6 7"}
# topk_avg(5,
sum by (queryid,query) (
rate(postgres_statements_time_seconds_total{
service_id="primary",mode=~"ioread|iowrite"
}[1m]) + on(database,user,queryid) group_left(query)
0 * postgres_statements_query_info{service_id="primary"}
), "other")
```
Обратите внимание, что в запросе для метки `mode` используется перечисление значений `ioread` и `iowrite`; при необходимости можно получить время только чтения или только записи.
Используя этот запрос, можно увидеть ввод-вывод в динамике (рис. [3.6](/ru/03-queries-and-functions/#mon-figure-caption-70)):
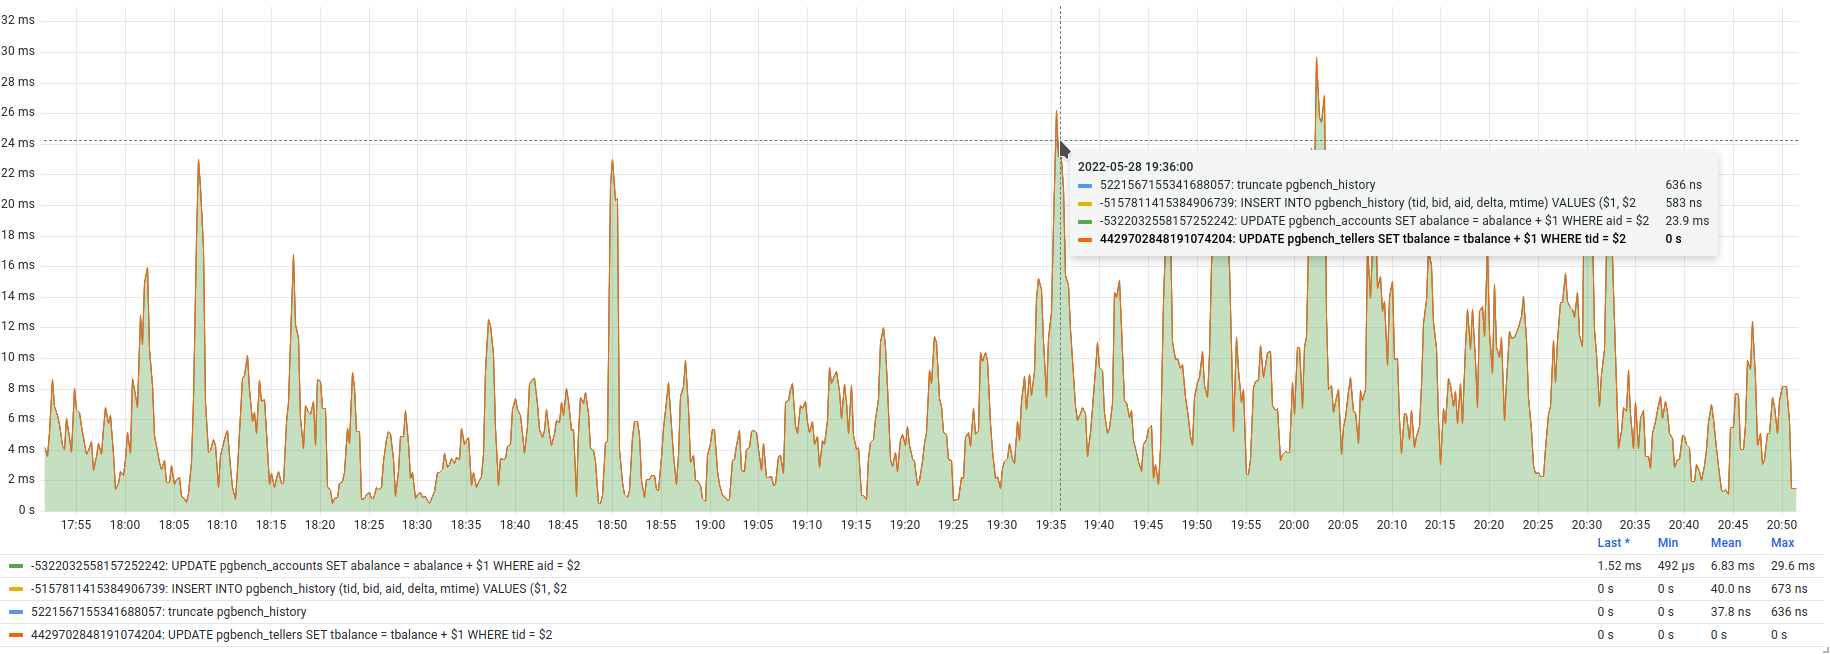
{#fig-3.6 num="3.6" caption="Запросы с наибольшим временем ввода-вывода" width=1830 height=654}
Картина на графике сходится с результатом SQL-запроса. Только одному запросу постоянно требуется время на ввод-вывод, и в среднем это 6,83 миллисекунды за одну секунду реального времени. Может показаться, что это не так уж и много, однако стоит помнить, что дешевые обращения к страничному кешу ОС также расцениваются как блочный ввод-вывод. Можно провести эксперимент: сбросить страничный кеш и посмотреть, как изменится время ввода-вывода, когда СУБД будет вынуждена действительно обращаться к диску. В ОС Linux сбросить кеш можно следующей командой, выполненной от пользователя root (не делайте этого в производственных окружениях, это негативно скажется на производительности):
```text {label="text" .source-commands hl_lines="1"}
# echo 3 > /proc/sys/vm/drop_caches
```
Через пару минут, когда данные попадут в мониторинг, можно увидеть, как выросло время ввода-вывода до 1,16 секунды в пике (рис. [3.7](/ru/03-queries-and-functions/#mon-figure-caption-71)). По мере продолжения рабочей нагрузки и наполнения буферного и страничного кешей время ввода-вывода будет постепенно уменьшаться и в какой-то момент окончательно придет к значению, которое было до сброса страничного кеша.
**Запросы с наибольшим временем выполнения без учета ввода-вывода.** Учитывая возможность получить время, потраченное на блочный ввод-вывод, можно с помощью простой арифметики получить и время, условно потраченное процессором на выполнение запроса. Условно, потому что полученная статистика хоть и будет указывать на время выполнения, но все-таки она не будет являться точным отражением того, сколько времени процессор провел в активном состоянии, выполняя этот тип запроса. Другой важный момент: это время будет включать в себя и время ожидания. Точную статистику по использованию процессора можно получить
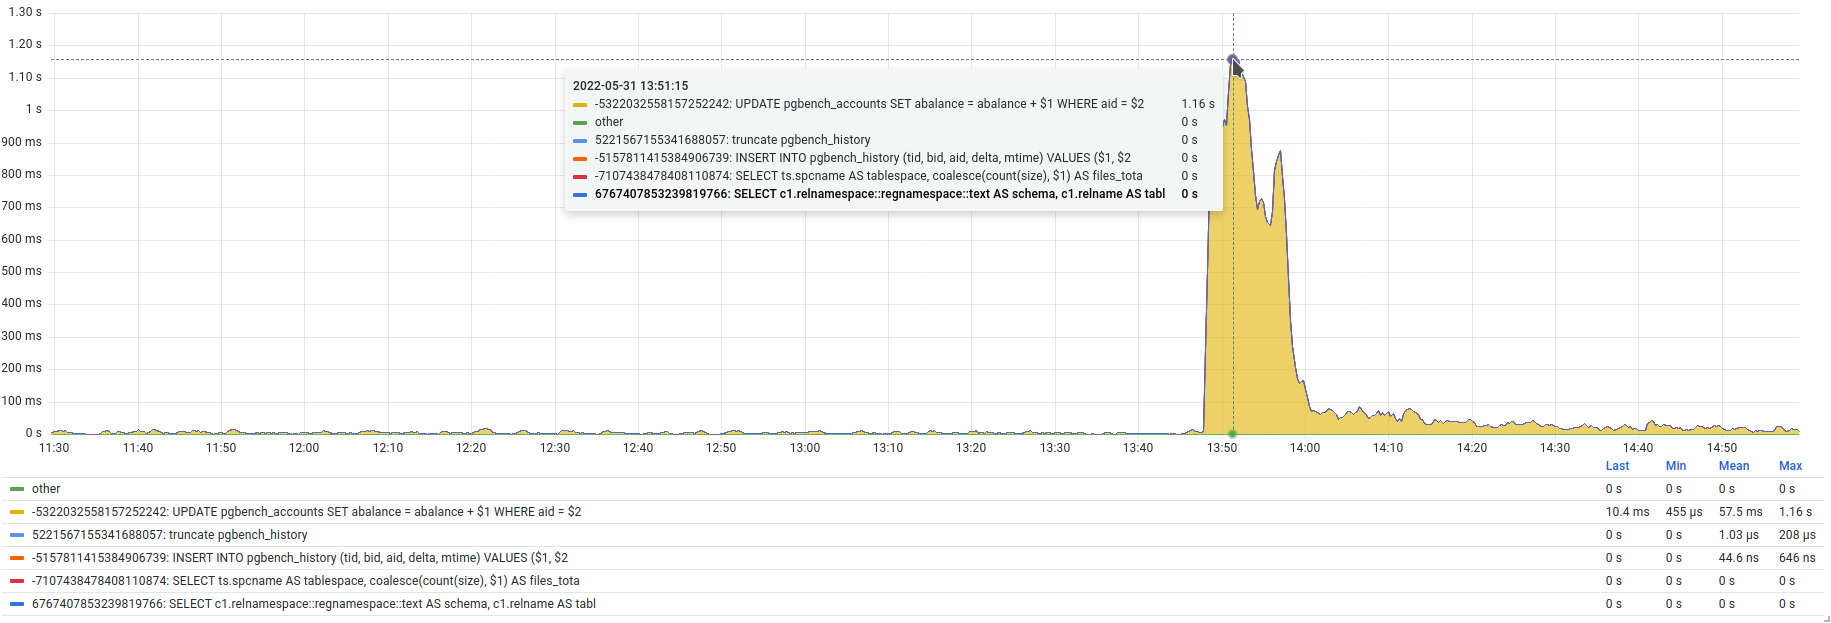
{#fig-3.7 num="3.7" caption="Время ввода-вывода после сброса страничного кеша" width=1831 height=623}
с помощью модуля `pg_stat_kcache`, использующего системный вызов `getrusage`. Однако это расширение не является официальным и устанавливается как отдельный пакет.
Итак, для получения статистики следует из общего времени `total_exec_time` вычесть время, потраченное на блочный ввод-вывод:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11"}
# SELECT
to_char(
interval '1 millisecond' * sum(total_exec_time - (
blk_read_time + blk_write_time + temp_blk_read_time + temp_blk_write_time)),
'HH24:MI:SS') AS cpu_time,
left(query, 64) AS query_trunc
FROM pg_stat_statements
GROUP BY query
ORDER BY sum(total_exec_time - (
blk_read_time + blk_write_time + temp_blk_read_time + temp_blk_write_time)
) DESC LIMIT 10;
cpu_time | query_trunc
-----------+------------------------------------------------------------------
105:41:06 | UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid =
14:14:38 | UPDATE pgbench_tellers SET tbalance = tbalance + $1 WHERE tid =
02:35:03 | UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE aid =
00:53:14 | SELECT current_database() AS database, schemaname AS schema, fun
00:45:37 | SELECT current_database() AS database, s1.schemaname AS schema,
00:43:06 | SELECT current_database() AS database, schemaname AS schema, rel
00:26:14 | SELECT coalesce(datname, $1) AS database, xact_commit, xact_roll
00:25:45 | SELECT checkpoints_timed, checkpoints_req, checkpoint_write_time
00:25:44 | SELECT pg_is_in_recovery()::int AS recovery, wal_records, wal_fp
00:25:17 | SELECT archived_count, failed_count, extract($1 from now() - las
```
Здесь процессорное время практически совпадает с общим. Это значит, что СУБД тратит на блочный ввод-вывод относительно немного времени, всего около 1 %:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7"}
# SELECT
sum(blk_read_time + blk_write_time + temp_blk_read_time + temp_blk_write_time
) / sum(total_exec_time) AS io_percent,
sum(total_exec_time -
(blk_read_time + blk_write_time + temp_blk_read_time + temp_blk_write_time)
) / sum(total_exec_time) AS cpu_percent
FROM pg_stat_statements;
io_percent | cpu_percent
---------------------+--------------------
0.01101825786144295 | 0.9889817421385566
```
При использовании SQL для оценки времени выполнения запроса всегда полезно выводить обе статистики вместе, чтобы видеть, на что именно тратится время.
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16"}
# SELECT
to_char(
interval '1 millisecond' * sum(total_exec_time),
'HH24:MI:SS'
) AS exec_time,
(100 * sum(
blk_read_time + blk_write_time +
temp_blk_read_time + temp_blk_write_time
) / sum(total_exec_time))::numeric(5,2)::text || ' / ' ||
(100 * sum(total_exec_time - (
blk_read_time + blk_write_time +
temp_blk_read_time + temp_blk_write_time)
) / sum(total_exec_time))::numeric(5,2) AS "io / cpu, %",
left(query, 48) AS query_trunc
FROM pg_stat_statements
GROUP BY query ORDER BY sum(total_exec_time) DESC LIMIT 10;
exec_time | io / cpu, % | query_trunc
-----------+---------------+--------------------------------------------------
105:50:01 | 0.00 / 100.00 | UPDATE pgbench_branches SET bbalance = bbalance
14:15:46 | 0.00 / 100.00 | UPDATE pgbench_tellers SET tbalance = tbalance +
04:00:25 | 35.47 / 64.53 | UPDATE pgbench_accounts SET abalance = abalance
00:53:21 | 0.00 / 100.00 | SELECT current_database() AS database, schemanam
00:45:44 | 0.00 / 100.00 | SELECT current_database() AS database, s1.schema
00:43:12 | 0.00 / 100.00 | SELECT current_database() AS database, schemanam
00:26:18 | 0.00 / 100.00 | SELECT coalesce(datname, $1) AS database, xact_c
00:25:49 | 0.00 / 100.00 | SELECT checkpoints_timed, checkpoints_req, check
00:25:48 | 0.00 / 100.00 | SELECT pg_is_in_recovery()::int AS recovery, wal
00:25:21 | 0.00 / 100.00 | SELECT archived_count, failed_count, extract($1
```
Здесь сразу видно отношение времени, затраченного на ввод-вывод и CPU относительно друг друга, и запрос, в котором на ввод-вывод тратится примерно треть от общего времени выполнения, довольно хорошо бросается в глаза. Если этому типу запроса дать возможность находить нужные данные в буферном кеше, то из четырех часов суммарного выполнения высвободится примерно 80 минут. Это время можно потратить на выполнение других запросов и увеличить производительность.
Статистика планирования и выполнения — это не единственное, что есть в `pg_stat_statements`. В этом представлении также можно найти статистику ввода-вывода и записи WAL, однако ее рассмотрение мы продолжим в других главах.
## 3.6. Сквозная идентификация с queryid {#mon-section-3-6}
Информацию по выполняемым в СУБД запросам можно получить из нескольких источников:
- `pg_stat_activity` — запросы, выполняемые в сеансах;
- `pg_stat_statements` — кумулятивная статистика по успешно выполненным запросам;
- журнал сообщений — запросы независимо от статуса их завершения (успех или ошибка);
- вывод команды `EXPLAIN` — план выполнения запроса.
Однако долгое время эти источники не были связаны друг c другом. Чтобы получить целостную картину о конкретном типе запроса, необходимо обработать данные из всех источников. Но в `pg_stat_activity` и журналах сообщений указываются полные тексты запросов, а в `pg_stat_statements` сохраняются нормализованные запросы, и сопоставить их было непростой задачей. Расширение `pg_stat_statements` умеет рассчитывать идентификатор запроса `queryid`, и начиная с версии 14 этот идентификатор стал доступен в остальных источниках — теперь выполнять идентификацию запроса по всем возможным источникам стало гораздо проще.
Расчет идентификатора зависит от параметра *compute\_query\_id*. Значение по умолчанию `auto` разрешает расширению `pg_stat_statements` (и аналогичным) автоматически вычислять идентификаторы. При включении *compute\_query\_id* идентификатор запроса будет отображаться в `pg_stat_activity`, журналировании через `csvlog` (или при указании формата в *log\_line\_prefix*) и в выводе `EXPLAIN VERBOSE`.
При реализации сквозной идентификации имена полей в представлениях получились разными — `pg_stat_activity.query_id` и `pg_stat_statements.queryid`.
## 3.7. Построение отчетов на основе pg\_stat\_statements {#mon-section-3-7}
Для оценки эксплуатации системы за длительные периоды могут быть полезны сводные или суммарные отчеты. Как правило, эти отчеты в разных проекциях показывают, насколько эффективно система справляется с рабочей нагрузкой. С их помощью можно не только быстро оценить состояние системы, но и отследить динамику относительно предыдущих периодов. Такие отчеты можно строить на основе статистики по запросам из `pg_stat_statements`, учитывая ее накопительный характер.
Концепция такого отчета довольно проста: нужно определить суммарное использование ресурсов по каждой проекции в `pg_stat_statements` и затем для каждого отдельного запроса определить его вклад в эту сумму. Полученные доли использования ресурсов следует отсортировать по какому-либо критерию, например, по суммарному времени выполнения запроса.
Примеры скриптов для создания подобных отчетов можно найти в репозитории DataEgret[^mon-93-1]. Отчет содержит список запросов, выполнение которых заняло больше всего времени, обогащенный подробной информацией из `pg_stat_statements`. Вот пример такого отчета по запросам в тестовом окружении:
```text {label="text" .source-commands hl_lines="1"}
# \i /var/lib/postgresql/scripts/query_stat_total.sql
Output format is unaligned.
?column?
total time: 11:50:59 (IO: 1.29%)
total queries: 25,411,617 (unique: 62)
report for all databases, version 0.9.5 @ PostgreSQL 15beta1
tracking all 5000 queries, utilities on, logging 500ms+ queries
```
```text {label="text"}
=============================================================================================================
pos:1 total time: 05:12:05 (43.9%, CPU: 44.5%, IO: 0.0%) calls: 1,800,650 (7.09%) avg_time: 10.40ms (IO: 0.0%)
user: classic db: pgbench rows: 1,800,650 (8.37%) query:
UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid = $2
```
```text {label="text"}
=============================================================================================================
pos:2 total time: 02:53:43 (24.4%, CPU: 24.8%, IO: 0.0%) calls: 996,873 (3.92%) avg_time: 10.46ms (IO: 0.0%)
user: maru db: pgbench rows: 996,873 (4.64%) query:
UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid = $2
```
```text {label="text"}
=============================================================================================================
pos:3 total time: 00:50:08 (7.1%, CPU: 7.1%, IO: 0.0%) calls: 496,689 (1.95%) avg_time: 6.06ms (IO: 0.0%)
user: pgbench db: pgbench rows: 496,689 (2.31%) query:
UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid = $2
```
```text {label="text"}
... остальной вывод опущен ...
```
Отчет состоит из двух частей. Первая часть показывает общую информацию:
- суммарное время, затраченное на успешное выполнение всех запросов, причем отдельно отмечена доля ввода-вывода;
- общее количество успешно выполненных запросов с указанием количества уникальных типов запросов;
- версия отчета и версия PostgreSQL;
- настройки `pg_stat_statements`.
Вторая часть показывает запросы, отсортированные по общему времени выполнения. Каждый запрос сопровождается дополнительной информацией:
- вклад запроса в общее время выполнения с разделением на CPU и ввод-вывод;
- количество вызовов запроса с указанием доли в общем объеме всех вызовов;
- среднее время выполнения запроса с отдельным учетом ввода-вывода;
- информация о пользователе, базе данных и количестве затронутых строк;
- нормализованный текст запроса.
Полученной информации достаточно, чтобы оценить доли запросов в рабочей нагрузке и при необходимости перейти к анализу производительности и рефакторингу. При желании скрипт можно модифицировать и добавить другую необходимую информацию, например период, за который взята статистика, идентификаторы запросов, использование ресурсов, объем сгенерированных журнальных записей и т. д.
В качестве другого примера можно взять вывод отчета из pgcenter, где для любого интересующего запроса из `pg_stat_statements` можно получить сводную информацию:
```text {label="text"}
summary:
total queries: 25,421,767
total rows: 21,512,607
total WAL: 25 GB
total_time: 11:51:10, 100%
total_plan_time: 00:26:34, 3.74%
total_cpu_time: 11:15:27, 94.98%
total_io_time: 00:09:08, 1.29%
```
```text {label="text"}
query info:
queryid: 2368592290184574017
username: classic,
database: pgbench,
calls (relative to total): 1,801,358, 7.09%,
rows (relative to total): 1,801,358, 8.37%,
WAL usage (relative to total):
records: 2,011,320, 10.88%
full-page images: 849, 0.03%
bytes: 144 MB, 0.56%
total times (relative to total): 05:12:10.007, 43.89%
planning: 00:01:40.461, 6.30%
cpu: 05:10:29.546, 45.97%
io: 00:00:00.000, 0.00%
average times (in-query distribution): 10.40ms, 100%
planning: 0.06ms, 0.54%
cpu: 10.34ms, 99.46%
io: 0.00ms, 0.00%
```
```text {label="text"}
query text:
UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid = $2
```
В фокусе отчета pgcenter находится всего лишь один выбранный запрос. В первой, верхней части отчета приведена сводная информация, а во второй части показаны статистика по выбранному запросу и его вклад в общую рабочую нагрузку:
- количество вызовов и затронутых строк с соответствующими долями;
- объем сгенерированных журнальных записей с детализацией по количеству записей, байтам и FPI-страницам (см. *full\_page\_writes*[^mon-95-1]);
- суммарное время выполнения всех запросов этого типа с детализацией по планированию, выполнению и вводу-выводу;
- среднее время выполнения запросов этого типа с детализацией;
- нормализованный текст запроса.
Сравнивая оба отчета, можно заметить, что они различаются предназначением. Отчет DataEgret предлагает более полную картину о том, что выполняется в СУБД, и больше подходит для роли сводного отчета. Отчет pgcenter предлагает оценку использования ресурсов конкретным запросом и больше ориентирован на оперативный анализ и выявление деталей по подозрительным запросам.
При построении подобных отчетов и расчете суммарного использования ресурсов важно помнить, что расширение `pg_stat_statements` может собирать статистику выполнения не только верхнеуровневых, но и вложенных запросов, и это поведение регулируется параметром *pg\_stat\_statements.track*. В случае более детального отслеживания со значением `all` есть риск посчитать часть статистики дважды, например, при наличии запросов с функциями, внутри которых выполняются другие запросы или функции. Подсчет общей статистики будет включать статистику как самой функции, так и всех вложенных в нее запросов, что может сильно исказить результат. Для исключения этой проблемы следует учитывать флаг `toplevel`, который указывает на уровень выполнения и помогает исключить вложенные запросы (`toplevel = false`). К сожалению, флаг `toplevel` появился в версии 14, поэтому в более ранних версиях для отчетов рекомендуется установить *pg\_stat\_statements.track* `= top`.
## 3.8. Представление pg\_stat\_statements\_info {#mon-section-3-8}
В дополнение к основному представлению у расширения есть еще одно небольшое служебное представление — `pg_stat_statements_info`, состоящее всего из одной строки с двумя полями:
- `dealloc` — количество раз, когда расширение было вынуждено частично удалить статистику из-за достижения ограничения *pg\_stat\_statements.max*. При этом возникает риск потери некоторой статистики, что может искажать данные отчетов. В качестве обходного пути источником данных может быть система мониторинга. Если ограничение еще не достигнуто, проблему можно решить на уровне конфигурации СУБД, увеличив значение *pg\_stat\_statements.max*, но это потребует перезапустить сервер.
- `stats_reset` — отметка времени последнего сброса статистики. Позволяет четко представлять, за какой интервал времени накоплена статистика по запросам.
Пример вывода:
```text {label="psql" .source-commands hl_lines="1"}
# SELECT dealloc, now() - stats_reset AS age FROM pg_stat_statements_info;
dealloc | age
---------+-------------------------
0 | 18 days 11:51:27.117115
```
В приведенном примере видно, что существующей емкости достаточно и удаления статистики не происходило (как минимум за последние 18 дней).
## 3.9. Выполнение процедур и функций {#mon-section-3-9}
Для реализации сложной логики при обработке данных можно использовать функции. Такие функции могут быть написаны на SQL и могут объединять в себе несколько запросов. Кроме SQL поддерживаются и такие процедурные языки (procedural language, PL), как PL/pgSQL, PL/Tcl, PL/Perl и PL/Python. Когда в рабочей нагрузке присутствуют запросы с вызовами функций, перед администратором возникает задача поиска медленных функций и их оптимизации. Для простейшего анализа производительности функций СУБД есть представление `pg_stat_user_functions`, которое содержит необходимый минимум статистики по выполнению функций. Для более детального профилирования функций придется использовать сторонние инструменты.
Основной сценарий использования `pg_stat_user_functions` — это оптимизация производительности не отдельных запросов, а приложений. С помощью представления можно выявить наиболее горячие функции, которые чаще всего вызываются целевым приложением, и оптимизировать их, тем самым улучшая производительность приложения.
Совместно с `pg_stat_user_functions` можно использовать и `pg_stat_statements`. Во втором представлении можно найти запросы, в которых вызывается функция, и по имеющимся полям получить информацию о времени выполнения и используемых ресурсах.
Для управления сбором статистики выполнения функций в конфигурации есть параметр *track\_functions*, который может принимать одно из следующих значений (для вступления изменений в силу достаточно перезагрузки конфигурации):
- `none` — выключает отслеживание статистики (значение по умолчанию);
- `pl` — включает отслеживание только функций на процедурных языках;
- `all` — включает отслеживание всех функций, включая функции на языках SQL и С.
Стоит отметить, что SQL-функции, которые встраиваются (inline) в вызываемый запрос, не отслеживаются при любом значении параметра.
Представление `pg_stat_user_functions` содержит относительно небольшой объем данных:
- `funcid` — уникальный идентификатор функции;
- `schemaname` — имя схемы, которой принадлежит функция;
- `funcname` — имя функции, которое может быть неуникальным внутри схемы, поскольку допускаются перегруженные функции, отличающиеся набором входных параметров;
- `calls` — общее количество вызовов функции;
- `total_time` — общее время выполнения функции (в миллисекундах), включая и время выполнения вложенных функций, если таковые имеются;
- `self_time` — общее время выполнения самой функции (в миллисекундах) без учета времени выполнения вложенных функций.
Как я уже отмечал, основной сценарий использования этой статистики — это определение наиболее часто вызываемых функций и функций, выполнение которых занимает больше всего времени. В тестовой нагрузке на основе стандартного сценария pgbench отсутствуют вызовы функций, поэтому статистики будет немного и она будет включать в себя только вызовы функций из расширений:
```text {label="psql" .source-commands hl_lines="1"}
# SELECT * FROM pg_stat_user_functions;
funcid | schemaname | funcname | calls | total_time | self_time
--------+------------+-------------------------+-------+------------+------------
16398 | public | pg_stat_statements_info | 1 | 0.006 | 0.006
16409 | public | pg_stat_statements | 14751 | 14246.418 | 14246.418
16416 | public | pg_buffercache_pages | 28936 | 122401.529 | 122401.529
```
В этом запросе нет дополнительных условий или сортировок, так как я заранее знаю, что в статистике немного данных. Есть статистика только по трем функциям, принадлежащим двум расширениям: `pg_buffercache` и `pg_stat_statements`. Две из них запрашиваются агентом мониторинга, и в поле `calls` отражается количество вызовов. Время `total_time` и `self_time` для обеих функций совпадает, поскольку в них не используются вложенные вызовы других пользовательских функций. Суммарное время выполнения функций составило примерно 122 и 14 секунд. Функция `pg_buffercache_pages` вызывается в два раза чаще, однако ее общее время выполнения больше примерно в 8,5 раза, то есть ее выполнение обходится СУБД дороже.
Используя такой подход и сравнивая время выполнения функций, можно находить наиболее долгие. Следующим запросом можно получить статистику из мониторинга:
```text {label="PromQL" .source-commands hl_lines="1"}
# increase(postgres_function_total_time_seconds_total{service_id="primary"}[1m])
```
В запросе используется `increase` вместо `rate`. Поскольку эти функции вызываются только агентом мониторинга, то очевидно, что вызовы происходят относительно редко, несколько раз в минуту, поэтому с этой точки зрения удобнее видеть, сколько времени тратится на выполнение функций за одну минуту (вместо одной секунды). В случае же производственных нагрузок, где выполнение функций может происходить чаще и конкурентно в нескольких сеансах, использование `rate` может быть более предпочтительным.
На рис. [3.8](/ru/03-queries-and-functions/#mon-figure-caption-73) отражается то, что можно было видеть в выводе запроса к `pg_stat_user_functions`, — выполнение функции `pg_buffercache_pages` занимает бóльшую часть времени:
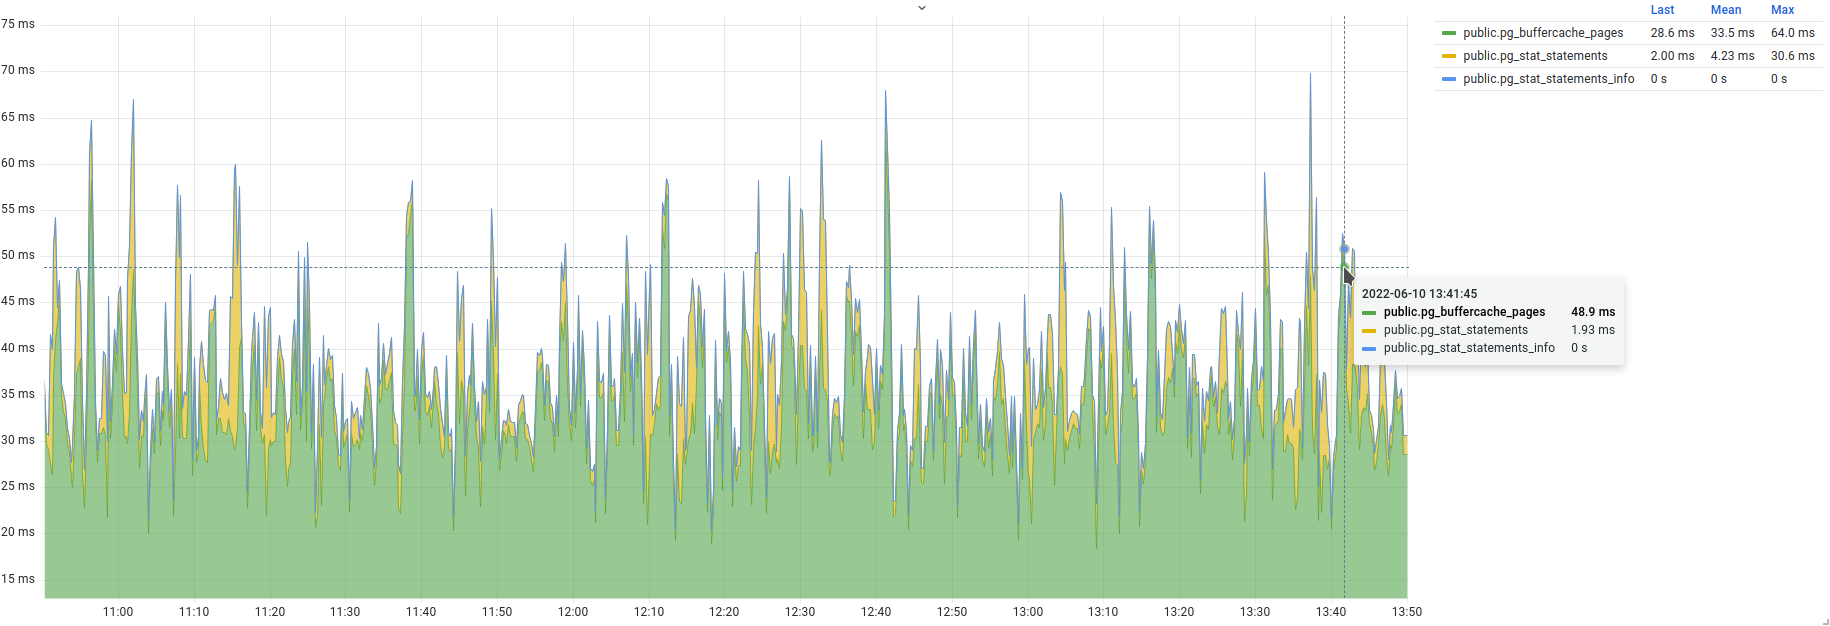
{#fig-3.8 num="3.8" caption="Функции с наибольшим временем выполнения" width=1830 height=626}
В среднем за минуту выполнение этой функции занимает 33 миллисекунды, против 4 миллисекунд для функции `pg_stat_statements`.
## Резюме {#mon-p98-h499}
- Запросы являются базовой единицей выполнения рабочей нагрузки.
- Мониторинг запросов обязателен и важен для понимания рабочей нагрузки.
- Для анализа рабочей нагрузки используется расширение `pg_stat_statements`, которое выключено по умолчанию.
- Представление `pg_stat_statements` содержит статистику по планированию и выполнению запросов, утилизации ресурсов, времени ввода-вывода, генерации WAL.
- Представление `pg_stat_statements` является важным источником данных для графиков мониторинга и отчетов о работе СУБД.
- СУБД предоставляет сквозную идентификацию запросов для анализа статистики из разных источников.
- Представление `pg_stat_statements_info` содержит полезную информацию о работе расширения `pg_stat_statements`.
- Статистика выполнения пользовательских функций находится в `pg_stat_user_functions`.
[^mon-72-1]: [postgrespro.ru/docs/postgresql/current/sql-commands.html]()
[^mon-73-1]: [github.com/powa-team/pg\_stat\_kcache]()
[^mon-73-2]: [man7.org/linux/man-pages/man2/getrusage.2.html]()
[^mon-73-3]: [github.com/percona/pg\_stat\_monitor]()
[^mon-76-1]: [postgrespro.ru/docs/postgresql/current/pgstatstatements.html]()
[^mon-93-1]: [github.com/dataegret/pg-utils/blob/master/sql/global\_reports/query\_stat\_total\_13.sql]()
[^mon-95-1]: [postgrespro.ru/docs/postgrespro/current/runtime-config-wal#GUC-FULL-PAGE-WRITES]()