2 Статистика активности
В этой главе мы рассмотрим:
клиентскую активность;
транзакционную активность;
представления
pg_stat_activity,pg_locksиpg_stat_database;основные состояния клиентских сеансов;
ожидание и блокировки;
бездействующие (idle) транзакции;
как определять длительность запросов и транзакций;
как определять время ожидания блокировок;
дерево блокировок.
Статистика активности является ключевым элементом, необходимым для понимания происходящего в СУБД. С точки зрения операционной системы СУБД выглядит как черный ящик. Операционная система ничего не знает о таких внутренних сущностях СУБД, как пользователи, базы, сеансы, транзакции и т. п. Статистика активности позволяет заглянуть внутрь этого ящика и лучше понять происходящее внутри. Активность подразумевает любые процессы в СУБД, вызванные как внутренним взаимодействием подсистем, так и обслуживанием внешних клиентов. В этой главе мы подробно рассмотрим клиентские сеансы и все, что с ними связано: взаимодействие клиента и сервера, установка сеанса, выполнение запросов и транзакций, основные состояния сеанса и негативные сценарии, которые могут возникать во время сеанса, такие как бездействующие транзакции и блокировки. Умение отслеживать процессы, протекающие в СУБД, — это важный навык, необходимый для успешной эксплуатации приложений и СУБД. Для этого мы рассмотрим основные источники статистики и примеры ее использования.
2.1. Ключ к пониманию происходящего в СУБД
Я люблю говорить, что СУБД — это сервис. СУБД часто воспринимается как нечто большое и сложно устроенное внутри, но можно представить СУБД как небольшой и легко развертываемый микросервис (столь привычный веб-разработчикам). С этой точки зрения главная задача СУБД — принять и обработать запрос от клиента. Внутреннее взаимодействие сложных компонентов можно считать второстепенным, так как оно не предполагает прямых действий со стороны клиента. В таком упрощенном случае есть лишь клиент и сервер. В качестве клиента выступает программа: это может быть приложение на Go, Python или Ruby, задание от Airflow или Celery или любимая IDE разработчика. В общем, что угодно, что может подключаться к СУБД и общаться с ней по ее протоколу. Сервером выступает СУБД, выполняющая команды клиента. Активность, создаваемая клиентом, формирует рабочую нагрузку. Объем рабочей нагрузки, с которой может справиться СУБД, определяет пропускную способность и, как следствие, общую производительность. Активность в СУБД можно измерить и проанализировать и в результате выявить аномалии, устранив которые можно увеличить производительность СУБД и приложений.
При анализе активности с точки зрения администрирования важно иметь количественную и качественную информацию о подключенных клиентах, например:
сколько установлено сеансов и откуда они установлены;
от имени каких пользователей и к каким базам установлены сеансы;
в каких состояниях находятся сеансы;
как долго сеансы находятся в этих состояниях;
сколько выполняется запросов, от каких пользователей и в каких базах;
как долго выполняются запросы;
какие конкретно запросы выполняются в сеансах.
Вопросы к тому, что происходит в СУБД, могут быть самыми разными, в зависимости от задач администратора, его осведомленности и гипотез, выдвинутых в процессе поиска и устранения проблем. Вопросы могут затрагивать не только обработку запросов клиентов, но и работу фоновых служб. Ответы, полученные с помощью статистики активности, позволяют устранить проблемы или оптимизировать работу приложений для достижения более надежной работы и большей производительности.
2.2. Взаимодействие клиента и сервера
Для более полного понимания того, что представляет собой активность, давайте рассмотрим, как взаимодействуют между собой клиенты и СУБД. Взаимодействие строится по классической схеме «клиент — сервер». Сервер работает постоянно в фоновом режиме и ожидает подключений от клиентов. Клиент, будь то приложение или пользователь, подключается к серверу и после успешного подключения, следуя внутренней логике или желанию пользователя, формирует и отправляет команды серверу, ожидает их выполнения, получает ответ и обрабатывает его.
Со стороны PostgreSQL сервером выступает специальный процесс, который исторически принято называть postmaster. В задачи процесса входит прослушивание интерфейсов на предмет клиентских подключений, создание сеансов и запуск фоновых процессов для обслуживания баз данных. При подключении клиента postmaster создает новый, дочерний процесс, внутри которого выполняются необходимая настройка и подготовка к сеансу. Когда сеанс готов, клиент может начинать отправку запросов.
Режимы работы
В зависимости от реализации клиента сеанс может подразумевать синхронный и асинхронный режимы работы. Большинство реализаций используют синхронный режим: клиент отправляет команду, ждет результат его выполнения и в это время не может отправлять другие команды. Возможен и асинхронный режим работы, но его реализация зависит от драйвера. Например, такая функциональность имеется в штатном драйвере libpq1.
Ниже показаны процессы сервера СУБД, выведенные утилитой ps, с точки зрения операционной системы.
Процессы выведены в виде дерева «родитель — потомок». Главным из них является postmaster, который приходится родителем всем остальным процессам. Среди процессов-потомков есть процессы фоновых служб и процессы клиентских соединений, так называемые бэкенды (backend). Для наблюдения за работой СУБД со стороны операционной системы хорошо подходят такие утилиты, как top, htop и atop. С их помощью можно наблюдать за тем, как процессы операционной системы используют системные и операционные ресурсы, такие как CPU, память, дисковый и сетевой ввод-вывод, пространство на диске. Стоит обратить внимание и на утилиты vmstat, dstat, nicstat и pidstat, iostat, входящие в состав пакета sysstat, — эти утилиты также могут быть полезны в оценке использования системных ресурсов.
Во время сеанса клиент общается с сервером посредством команд. SQL-запросы являются частным случаем таких команд и часто могут организовываться в транзакции. Транзакция представляет собой последовательность из нескольких запросов, которая в целом должна восприниматься как одна логическая операция. Начало транзакции объявляется командой BEGIN, для завершения могут использоваться команды COMMIT (END) или ROLLBACK. Транзакции являются важным механизмом СУБД, обеспечивающим возможность конкурентной работы множества клиентов. Транзакции обладают свойствами атомарности, изоляции и согласованности. Атомарность определяет, что в результате транзакции все ее операции выполняются вместе либо не выполняются совсем. В случае ошибки или отката транзакции результат всех операций отменяется до состояния, которое предшествовало началу транзакции. Здесь же проявляется и свойство согласованности, которое устанавливает, что атомарно выполненная (или отмененная) транзакция сохраняет базу данных в непротиворечивом, согласованном состоянии. Отдельные запросы (выполняемые без объявления блока BEGIN и END) на самом деле также являются транзакциями, но состоящими из одной команды. Свойство изоляции заключается в том, что результаты транзакции не видны другим, соседним транзакциям, до тех пор пока эта транзакция не будет зафиксирована, и то в зависимости от используемого уровня изоляции. Для более полного понимания этого вопроса следует ознакомиться с презентацией Брюса Момджяна MVCC Unmasked2.
Несмотря на свойство изоляции, нельзя думать, что транзакции полностью независимы друг от друга. Возможность конкурентной работы подразумевает вероятность одновременного доступа к одним и тем же данным (строкам в таблице) со стороны нескольких транзакций. В случае операций чтения все просто, поскольку конкурентное чтение не вызывает конфликтов, почти3. С записью все становится чуть сложнее: конкурентная запись может вызывать конфликты, и такие операции должны быть сериализованы, то есть выстроены в строгую последовательность. Для сериализации доступа к объектам БД используются блокировки. Механизм блокировок позволяет ограничивать или запрещать одновременный доступ к ресурсу. Работа блокировок прозрачна для пользователя и в большинстве случаев не требует от него явных действий. Однако возможны ситуации, когда одновременно несколько клиентов пытаются установить несовместимую блокировку на один и тот же ресурс. В таком случае только один клиент сможет установить блокировку, а остальные образуют очередь и будут вынуждены ждать, когда блокировка будет снята.
В качестве промежуточного итога можно сделать вывод, что природа конкурентного доступа, свойства транзакций, механизм блокировок и некоторое стечение обстоятельств в совокупности могут приводить к ситуациям с негативными последствиями для СУБД и приложений. В зависимости от важности эксплуатируемой БД такие ситуации могут расцениваться как аварийные, так как могут привести к снижению производительности или к остановке запросов.
Одной из задач администратора БД является отслеживание, выяснение причин и предотвращение таких ситуаций. Далее в этой главе мы рассмотрим эти ситуации более подробно.
2.3. Источники информации об активности
Мы начнем с представлений pg_stat_activity, pg_locks и pg_stat_database. С исторической точки зрения возможности отображения активности развивались постепенно и со временем пришли к тому виду, в котором они есть на данный момент. В ранних версиях эти три представления содержали информацию, которая тематически не была связана между собой. Представления pg_stat_activity и pg_locks могли дополнять друг друга, а pg_stat_database не содержала той статистики, что будет рассматриваться далее. Сейчас все три представления содержат различную информацию, которую объединяет одна тема — определение активности. Все три представления помогают составить общую картину происходящего в СУБД:
pg_stat_activity— статистика о процессах, подключенных клиентах и фоновых службах;pg_locks— статистика о блокировках, удерживаемых или ожидаемых активными процессами;pg_stat_database— кумулятивная статистика о клиентских сеансах в контексте отдельных баз данных.
Соглашение об именовании
Здесь и далее в тексте при указании представлений и их полей будет использоваться нотация представление.поле. Например, pg_stat_activity.pid указывает на поле pid в представлении pg_stat_activity.
Представление pg_stat_activity
Весь мой практический опыт поиска и устранения проблем говорит о том, что при возникновении самых разных подозрений на проблемы в работе СУБД pg_stat_activity — главный источник первичной информации. Если с точки зрения операционной системы администратор может увидеть только процессы, то pg_stat_activity помогает администратору заглянуть внутрь СУБД и посмотреть на работу этих же процессов, но с точки зрения самой PostgreSQL. В представлении содержится информация обо всех процессах СУБД, будь то клиентские процессы или фоновые службы, и каждая строка описывает отдельный серверный процесс. В ранних версиях PostgreSQL pg_stat_activity содержало информацию преимущественно о клиентских процессах. В следующих версиях была добавлена информация о фоновых службах. При этом клиентские процессы и фоновые службы отличаются характером работы с СУБД и часть информации, которая присуща клиентским процессам, для фоновых служб попросту отсутствует.
Но недостаток информации по фоновым процессам компенсируется другими представлениями, и pg_stat_activity остается наиболее ценным источником сведений о внутренней активности СУБД.
Посмотреть полное описание этого представления можно с помощью метакоманды \d+ pg_stat_activity.
Метакоманды
Клиент psql содержит набор метакоманд, полезных для получения справочной информации об объектах БД, как пользовательских, так и системных. Все метакоманды начинаются с символа обратной косой черты \, например \d. Для получения справки и списка всех метакоманд используйте метакоманду \?.
Ниже приведено сокращенное описание представления.
Вывод статистики в pg_stat_activity представляет собой таблицу на основе функции pg_stat_get_activity, где каждая строка описывает конкретный серверный процесс.
Давайте рассмотрим, какую полезную информацию можно получить из представления.
Информация о клиенте. Основные реквизиты соединения:
client_addr— сетевой адрес, с которого выполнено подключение. Если соединение установлено через UNIX-сокет, значение будет отсутствовать (NULL);client_port— номер порта в удаленной системе, с которого установлено соединение;usename— имя пользователя, используемое при подключении;datname— имя базы данных, к которой выполнено подключение.
Для лучшей идентификации клиент при подключении может обозначить себя через отдельный идентификатор application_name. Это удобный способ отличать приложения в случаях, когда они подключены с одинаковыми реквизитами и с одного адреса. Поле backend_type позволяет отличать клиентские процессы от фоновых служб. В ранних версиях СУБД этого поля не было, и для определения клиентских подключений приходилось прибегать к различным уловкам — например, указывать в SQL-запросе дополнительное условие datname IS NOT NULL.
Этот пример наглядно показывает различия между фоновыми службами (строки с 1-й по 7-ю) и клиентскими процессами (строки с 8-й по 15-ю). Во-первых, отличить их можно по значению поля backend_type. Во-вторых, для фоновых служб могут отсутствовать значения других полей, например client_addr, application_name, usename и datname, поскольку фоновые процессы могут запускаться локально или не устанавливать соединений к БД.
Продолжительность сеанса, транзакции, запроса. В представлении есть информация, относящаяся ко времени начала сеанса и той активности, что происходит в сеансе:
backend_start— время начала сеанса, то есть момент подключения клиента к СУБД;
xact_start— время начала текущей транзакции;query_start— время начала текущего запроса — на случай, если это не единственный запрос в транзакции.
С помощью этих полей можно выявлять длительные запросы и транзакции, нехарактерные для конкретной рабочей нагрузки.
Состояние сеанса. Сеанс в течение своего жизненного цикла может находиться в разных состояниях. По состоянию можно определить, все ли в порядке с сеансом, и принять меры, если с ним что-то не так. На состояние сеанса указывает поле state. Также в поле state_change доступно время перехода в текущее состояние, по которому можно определить его продолжительность. Далее по этим полям мы будем отслеживать потенциально опасную активность в БД и ее продолжительность.
Ожидания и блокировки. Внутренняя механика СУБД предполагает использование разных механизмов синхронизации; хорошим примером являются блокировки, которые используются для сериализации доступа к объектам. Следствием использования таких механизмов является риск возникновения ожиданий на разных участках выполнения кода. Для отслеживания ожиданий СУБД предоставляет поля wait_event и wait_event_type, которые детально идентифицируют место, где возникло ожидание. С помощью полей state, wait_event_type и wait_event можно определять узкие места в работе СУБД, где происходит ожидание вместо выполнения полезной работы.
Идентификатор и текст запроса. В поле query указаны тексты выполняющихся в СУБД запросов. Поле ограничено размером буфера, который регулируется параметром track_activity_query_size (по умолчанию 1 КБ). Текст выявленного медленного запроса дает администратору отправную точку для оптимизации производительности. Запрос можно воспроизвести, получить план выполнения, проанализировать производительность и в результате наметить действия по оптимизации. Дополнительно для каждого запроса формируется уникальный идентификатор queryid, который в сочетании с полями usesysid и datid можно использовать для соединения с представлением pg_stat_statements, в результате чего будут получены дополнительные сведения о том, сколько ресурсов было использовано этим запросом и ему подобными.
Идентификаторы процессов. Все процессы в pg_stat_activity являются процессами операционной системы и имеют присвоенный ею уникальный идентификатор pid. Этот идентификатор доступен в статистике и является ключом, с помощью которого можно соединять pg_stat_activity с другими представлениями. Например, это может понадобиться для получения расширенной информации о блокировках или ходе выполнения отдельных операций.
СУБД умеет распределять выполнение частей запроса между несколькими процессами, ускоряя выполнение запросов и увеличивая эффективность использования многоядерных систем. При наблюдении важно отделять группу процессов, занятых выполнением параллельного запроса от всех остальных процессов или групп. Для этой цели служит поле leader_pid, которое у всех дочерних процессов указывает на pid родительского процесса.
Идентификаторы транзакций и горизонта видимости транзакций. Два идентификатора, указывающие на присвоенный номер транзакции backend_xid и транзакционный горизонт видимости backend_xmin, могут быть полезны при расследовании причин ненормального увеличения размеров таблиц и индексов из-за неэффективной работы автоочистки. Более подробно случаи использования этой статистики мы рассмотрим в главе 8, посвященной очистке.
Представление pg_locks
Представление pg_locks содержит информацию об удерживаемых блокировках. Оно может рассматриваться как самостоятельное, однако на практике часто используется совместно с pg_stat_activity, и оба представления обогащают итоговый результат.
Каждая строка pg_locks содержит информацию об объекте, на который установлена блокировка или для которого требуется установка блокировки, и о том, кто ее затребовал. Когда несколько процессов пытаются взять блокировку одного и того же объекта, этот объект будет показан в представлении несколько раз. При снятии блокировки с объекта информация из представления убирается. Объектами блокировки могут быть таблицы, отдельные строки или даже страницы в таблицах, идентификаторы транзакций, общие объекты СУБД. Некоторые действия, требующие блокировки, представлены отдельными объектами, например увеличение файлов таблицы или обновление таких метаданных, как pg_database.datfrozenxid. Также в представлении отображаются рекомендательные блокировки (advisory lock), смысл и назначение которых определяют сами приложения, но нет информации по легким блокировкам (lightweight lock, LWLock), которые работают на более низком уровне для контроля доступа к служебным структурам в памяти.
Посмотреть полное описание pg_locks можно с помощью метакоманды \d+ pg_locks, а выше приведено его сокращенное описание. Это представление показывает табличную информацию на основе функции pg_lock_status.
Объект блокировки. С помощью следующего набора полей можно идентифицировать объект, связанный с блокировкой:
relation,page,tuple— отношение, номер страницы и номер строки внутри страницы;virtualxid,transactionid— виртуальный и фактический номера транзакций;classid,objid,objsubid— идентификаторы объекта блокировки внутри системного каталога в случае, когда этот объект нереляционный.
В зависимости от объекта блокировки значения в некоторых полях могут отсутствовать (NULL).
Детали блокировки. Поля с дополнительной информацией играют важную роль в определении процессов, ожидающих получения блокировки:
locktype— тип блокировки, который позволяет отличать блокировки друг от друга4;database— идентификатор (OID) базы данных, в которой возникла блокировка;virtualtransaction— идентификатор виртуальной транзакции, которая удерживает или ждет блокировку;pid— идентификатор процесса ОС. Чаще всего это поле используется для соединения сpg_stat_activityи получения такой дополнительной информации, как имя пользователя, время начала запроса или транзакции, текст запроса, маркеры ожидания и т. д.;mode— режим блокировки, который позволяет определять совместимость с другими блокировками. Полный список режимов доступен в документации5;granted— флаг, указывающий на факт удерживания блокировки (значениеtrue) или ожидания ее получения (значениеfalse);waitstart— время перехода в ожидание блокировки. Это поле является единственным источником достоверной информации о том, сколько времени процесс находится в ожидании блокировки. Однако стоит учитывать, что даже после того как началось ожидание блокировки (granted = false), значение поля в течение очень короткого периода может отсутствовать (NULL);fastpath— флаг, указывающий на факт взятия блокировки через интерфейс fast-path. Этот интерфейс давно объявлен устаревшим, и это поле актуально только в случаях эксплуатации приложений, которые его используют.
С помощью деталей блокировки можно отсеивать лишние блокировки и фокусироваться только на тех, что напрямую относятся к исследуемой проблеме, например связаны с конкретным сеансом, или имеют определенный тип, или находятся в ожидании дольше допустимого времени. Соединение с pg_stat_activity позволяет получить дополнительную информацию, которая будет полезна для анализа и исправления проблемы на стороне прикладных приложений (имя пользователя и приложения, текст запроса).
Особенности pg_stat_activity и pg_locks
У обоих представлений, pg_stat_activity и pg_locks, есть одна важная особенность, которую я привык рассматривать скорее как недостаток. О ней всегда следует помнить при реализации мониторинга на основе этих представлений. Выводимая статистика отражает текущий момент и не является кумулятивной. Данные, взятые из этих представлений, являются снимками того, что происходило в момент обращения к представлениям. Неизвестно, что происходило в интервале между двумя снимками. На практике можно встретить системы, которые обслуживают десятки и сотни тысяч запросов в секунду. В промежутках между снимками может возникать большое количество кратковременных ожиданий, которые не попадут в снимки и не будут видны в мониторинге, но эти ожидания могут негативно сказываться на времени выполнения запросов. Так, отсутствие информации создает неполную картину о происходящем. При построении систем мониторинга и накоплении статистики на основе таких снимков объективность картины начинает сильно зависеть от частоты опроса статистики. На практике такой опрос выполняется с интервалом в несколько секунд и наиболее часто встречаются значения между 15 и 60 секундами. Но даже профилирование с частотой 1–10 миллисекунд не гарантирует полноты картины, к тому же добавляет накладные расходы на выполнение самого профилирования. Резюмируем: глядя на графики, построенные на основе представлений pg_stat_activity или pg_locks, вы должны помнить об этой особенности. Некоторые другие представления устроены подобным образом, и в дальнейшем, рассматривая их, я буду отмечать это отдельно.
Представление pg_stat_database
Каждая строка представления pg_stat_database содержит статистику об использовании конкретной базы данных. Также в представлении есть отдельная строка, которая содержит статистику по разделяемым, общим для всех баз объектам (часть из них принадлежат так называемому системному каталогу). Представление основано на семействе функций с префиксом pg_stat_get_db_, которые принимают в качестве аргумента идентификатор БД и возвращают одну метрику. Полное описание представления можно получить с помощью метакоманды \d+ pg_stat_database. Часть полей этого представления можно отнести к статистике клиентских подключений, что может помочь при мониторинге активности СУБД.
Представление хоть и содержит информацию о базах данных, однако некоторые сведения можно рассматривать в контексте, связанном с клиентами и их сеансами. С помощью этой информации можно отслеживать и количество подключенных клиентов, и то, насколько нормально приложения работают с СУБД. Воспользоваться можно следующими полями:
numbackends— количество клиентских процессов, подключенных к БД. В строке со статистикой по разделяемым объектам значение будет отсутствовать (NULL). Это единственное поле в представлении, которое показывает текущее значение. Все остальные поля содержат кумулятивную статистику за определенный период;xact_commit— количество транзакций, завершившихся фиксацией (COMMIT). Счетчик также учитывает успешное выполнение одиночных запросов в рамках неявных транзакций;xact_rollback— количество транзакций, завершившихся обрывом (ROLLBACK), в том числе по причине ошибок;sessions_abandoned— количество сеансов, принудительно завершенных по причине того, что соединение оставлено клиентом. Это может указывать на ситуации, когда клиентское приложение забывает о соединении и не закрывает его как положено (graceful close). Другой причиной могут быть сетевые проблемы, такие как ошибки передачи и потери пакетов, приводящие к нарушению работы TCP-сеансов;sessions_fatal— количество сеансов, которые были принудительно завершены по причине возникновения фатальных ошибок и невозможности продолжения работы. Такие ошибки могут происходить во время выполнения запросов или вызываться исключительными ситуациями на стороне сервера при взаимодействии между клиентом и сервером. В таком случае сервер не может продолжить сеанс и завершает его. Примером такого сценария может быть завершение сеанса из-за превышения тайм-аута, настроенного параметром idle_in_transaction_session_timeout;sessions_killed— количество сеансов, которые были принудительно завершены административным способом. Такое завершение сеанса может быть инициировано функциейpg_terminate_backendили самой СУБД, например при выключении или перезапуске сервера;sessions— суммарное количество сеансов, установленных с БД. Значение поля указывает на общее число установленных сеансов независимо от статуса их завершения, то есть включает в себя все значения и по остальным возможным статусам.
Начало и завершение сеанса обычно происходит по инициативе клиента. Часть рассматриваемых полей как раз указывают на количество сеансов, завершение которых было инициировано сервером СУБД. Завершение сеансов, таким образом, в некоторых ситуациях можно считать ненормальным. В процессе сеанса клиент отправляет отдельные команды или может объединять их в транзакции. Эти команды формируют рабочую нагрузку, и по полям xact_commit и xact_rollback можно в количественном выражении вычислить величину нагрузки в СУБД.
Другая полезная информация о работе сеансов относится к их продолжительности в разных состояниях. Речь о тех состояниях, что коротко упоминались при рассмотрении pg_stat_activity и более подробно рассмотрены чуть дальше. Однако набор полей является неполным, и часть информации придется вычислить с помощью простых арифметических операций. Нас интересуют следующие поля:
session_time— суммарное время, проведенное всеми сеансами. Учет времени имеет некоторую особенность: время увеличивается только при переходе между состояниями. Поэтому можно ожидать появления больших скачков при наличии сеансов, которые могут подолгу пребывать в одном и том же состоянии. Хорошим примером является оставленный надолго сеанс разработчика в IDE;active_time— время, проведенное сеансами в состоянияхactiveиfastpath function call, которые соответствуют выполнению запросов;idle_in_transaction_time— время, проведенное в состоянияхidle in transactionиidle in transaction (aborted).
Обратите внимание: среди перечисленных полей нет статистики о времени, проведенном в состоянии idle. Именно это значение придется считать самостоятельно, вычитая из общего времени время, проведенное в бездействующих транзакциях, и время выполнения запросов.
Все значения в этих полях выражаются в миллисекундах.
Статистика по базам данных, которую предоставляет pg_stat_database, имеет кумулятивный характер и накапливается с течением времени, что обеспечивает непрерывность ее учета без риска потерь, как это может быть в случае pg_stat_activity или pg_locks. С помощью отдельных функций администратор может сбрасывать статистику, чтобы начать процесс накопления заново. В представлении есть поле stats_reset, которое показывает время, когда статистика была сброшена. С его помощью можно вычислить, за какой интервал времени была накоплена статистика.
2.4. Подключенные клиенты
Сталкиваясь с новой ситуацией или незнакомым окружением, в первую очередь важно оценить общую картину происходящего, получить общее представление о том окружении, в котором предстоит найти и устранить возникшую проблему. Для меня в начале знакомства с СУБД важно понимать то, насколько активно используется система и кто ее пользователи. Обычно это информация о том, сколько и каких клиентов подключено к системе, из чего можно сделать примерный вывод о том, сколько ресурсов им может потребоваться, какую нагрузку они могут генерировать.
Есть два способа получить такую информацию. Первый способ — использовать представление pg_stat_database:
В выводе запроса для каждой базы можно увидеть текущее количество клиентских процессов, подключенных к ней. Однако представление pg_stat_database показывает информацию о подключенных клиентах только в контексте баз данных, что может быть недостаточно для более детального анализа. Также обратите внимание на строку с пустым именем в результате запроса: это служебная строка, объединяющая в себе статистику по разделяемым объектам, которые доступны во всех БД, но при этом не принадлежат ни одной из них. Все такие объекты принадлежат системному каталогу.
Системный каталог
Системный каталог — это набор таблиц со служебной информацией, которая используется самой СУБД. Служебные данные включают в себя информацию о таблицах, полях, индексах, типах данных и т. д. Практически все DDL-команды типа CREATE, ALTER, DROP как раз оперируют данными системного каталога6.
Второй способ получить информацию о подключенных клиентах, к тому же гораздо более подробную, — использовать представление pg_stat_activity:
В этом примере клиенты сгруппированы по адресу подключения, имени пользователя и имени БД. Можно сделать следующие выводы:
есть два адреса, откуда идет основная масса подключений;
наибольшая часть подключений приходится на базу pgbench;
c базой работают несколько пользователей.
Значение NULL для client_addr означает, что подключение выполнено через UNIX-сокет с того же узла, где запущен сервер СУБД, — скорее всего, это наше подключение через psql. Также можно видеть NULL-значения в полях usename и datname — обычно такие строки соответствуют фоновым службам. В полном выводе pg_stat_activity можно увидеть больше подобных строк.
Обычно для отсеивания фоновых служб и отображения только клиентских сеансов используется условие backend_type = 'client backend'.
Способ для ранних версий PostgreSQL
Поле backend_type появилось в PostgreSQL 10, а в более ранних версиях можно прибегнуть к условиям вроде datname IS NULL. Как правило, фоновые процессы не подключаются к базам данных, за исключением процессов автоочистки.
Используя дополнительное условие, можно исключить фоновые процессы из выборки и получить информацию только по клиентским процессам:
На практике при анализе проблем приходится использовать группировку и по другим полям и также применять разные условия в зависимости от поставленных вопросов и проверяемых гипотез.
Отслеживание клиентских сеансов
Получение информации с помощью SQL удобно, однако на практике часто приходится анализировать проблемы после того, как они уже исчезли, и нужны информация в исторической перспективе и динамика изменений во времени. Эти задачи решаются системами мониторинга, которые собирают, хранят и визуализируют статистику. С помощью мониторинга администратор имеет возможность рассматривать изменение статистики во времени с помощью графиков.
Для мониторинга необходимо всегда иметь в распоряжении информацию о подключенных клиентах, при этом информация должна быть достаточно подробной. Давайте рассмотрим практические примеры того, как может выглядеть статистика по клиентам и на какие вопросы она может ответить.
Для получения суммарного количества подключенных клиентов можно использовать следующий PromQL-запрос:
График, который можно построить на основе этого запроса, продемонстрирован на рис. 2.1.
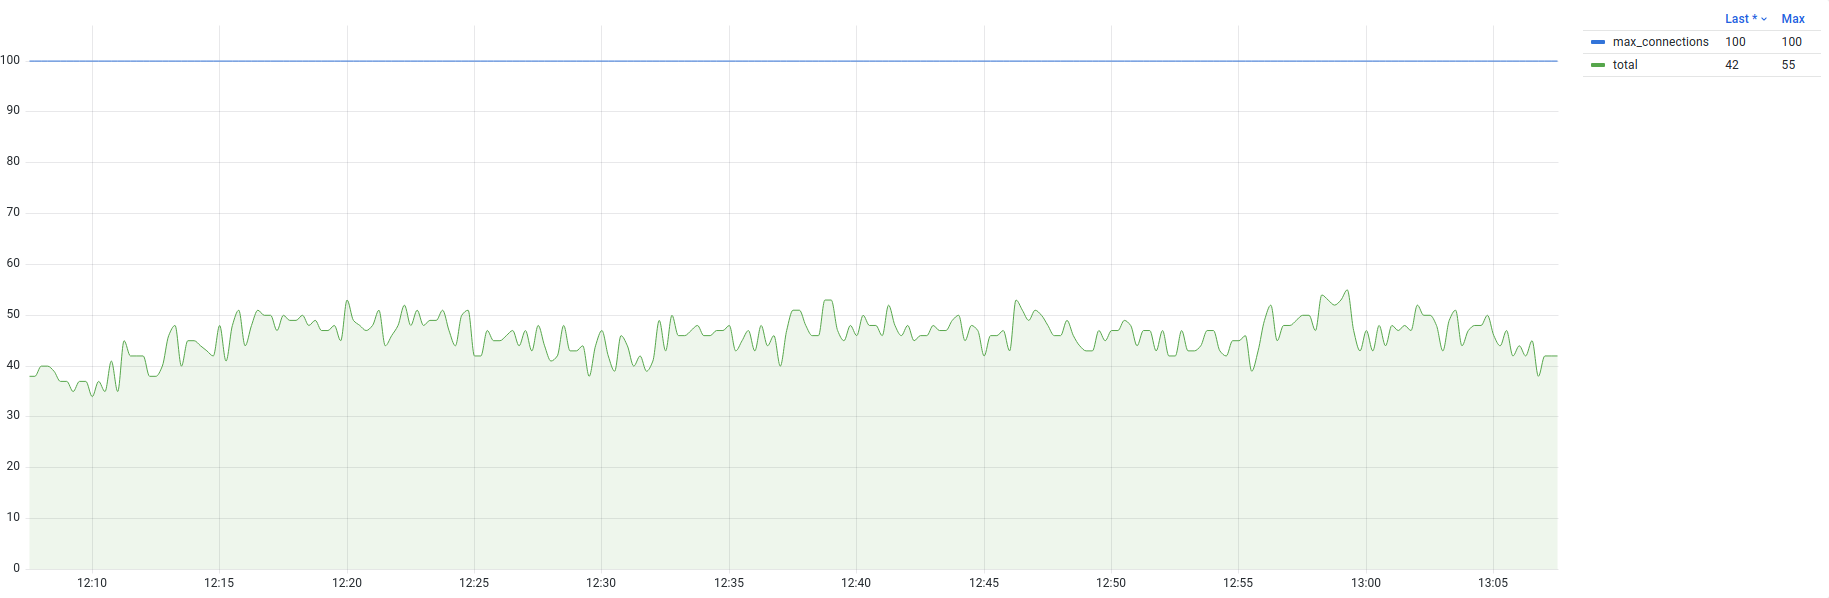
На графике видно, как менялось количество подключений за последний час. В дополнение к основным метрикам указано и ограничение количества одновременных подключений, что наглядно дает понять, сколько еще подключений можно установить до достижения предела. Ограничение количества подключений задается параметром max_connections и по умолчанию равно 100. Из графика можно сделать вывод, что установлено чуть меньше половины от разрешенного ограничения и запас еще имеется.
Метрики параметров конфигурации
Параметры СУБД тоже доступны в виде метрик. Например, с помощью метрики postgres_service_settings_info{name="max_connections"} можно получить значение параметра max_connections.
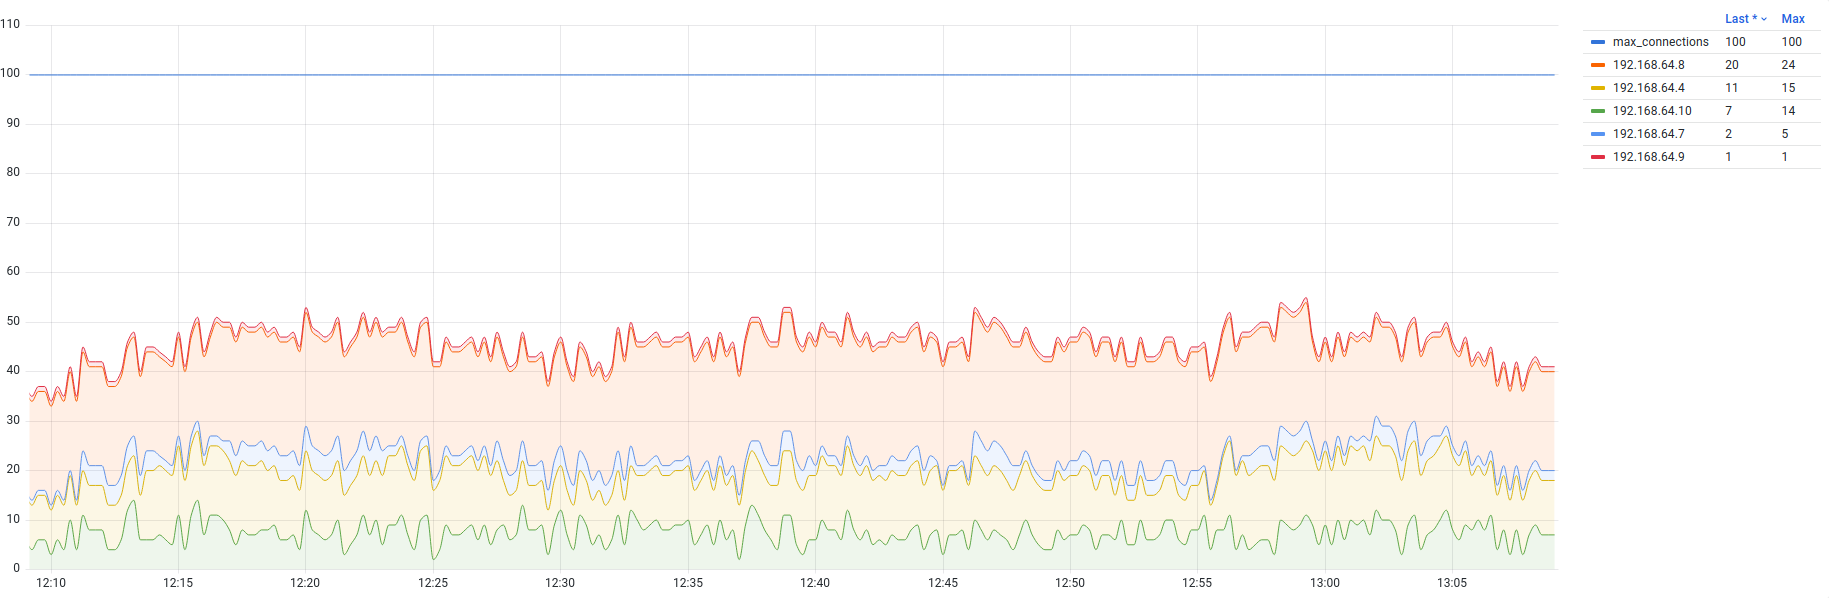
Метрика postgres_connected_clients_total содержит в себе метки address, user и database, группировкой по которым можно воспользоваться, чтобы получить статистику в разных проекциях. Начнем с группировки по адресам:
График будет выглядеть так, как показано на рис. 2.2. На нем видно, что бóльшая часть сеансов установлены с адресов 192.168.64.8 и 192.168.64.4. В окружениях с большим количеством экземпляров приложений такой график позволяет определять адреса, которые используют аномально много сеансов.
Теперь изменим условие группировки на имя пользователя, чтобы получить представление о том, какие пользователи подключаются к СУБД (рис. 2.3):
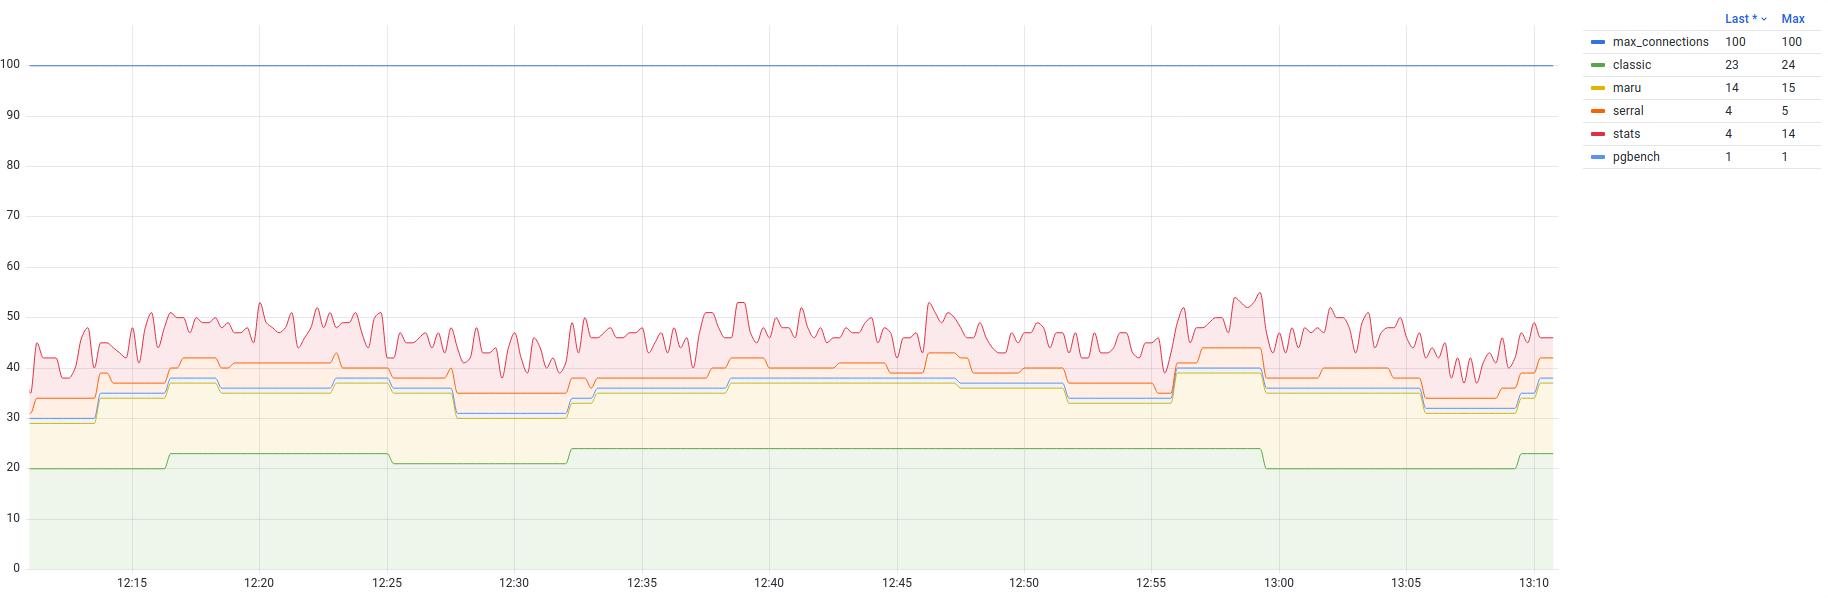
На графике видно, что большая часть сеансов выполнена от двух прикладных пользователей. Если присмотреться еще, то можно отметить, что выделяется пользователь stats. В тестовом окружении под этим пользователем подключается экспортер метрик для снятия статистики. Для экспортера, да и для любого другого агента мониторинга, такое количество соединений слишком велико, что является поводом для оптимизации кода.
Теперь взглянем на то, к каким базам данных выполнены подключения (рис. 2.4).
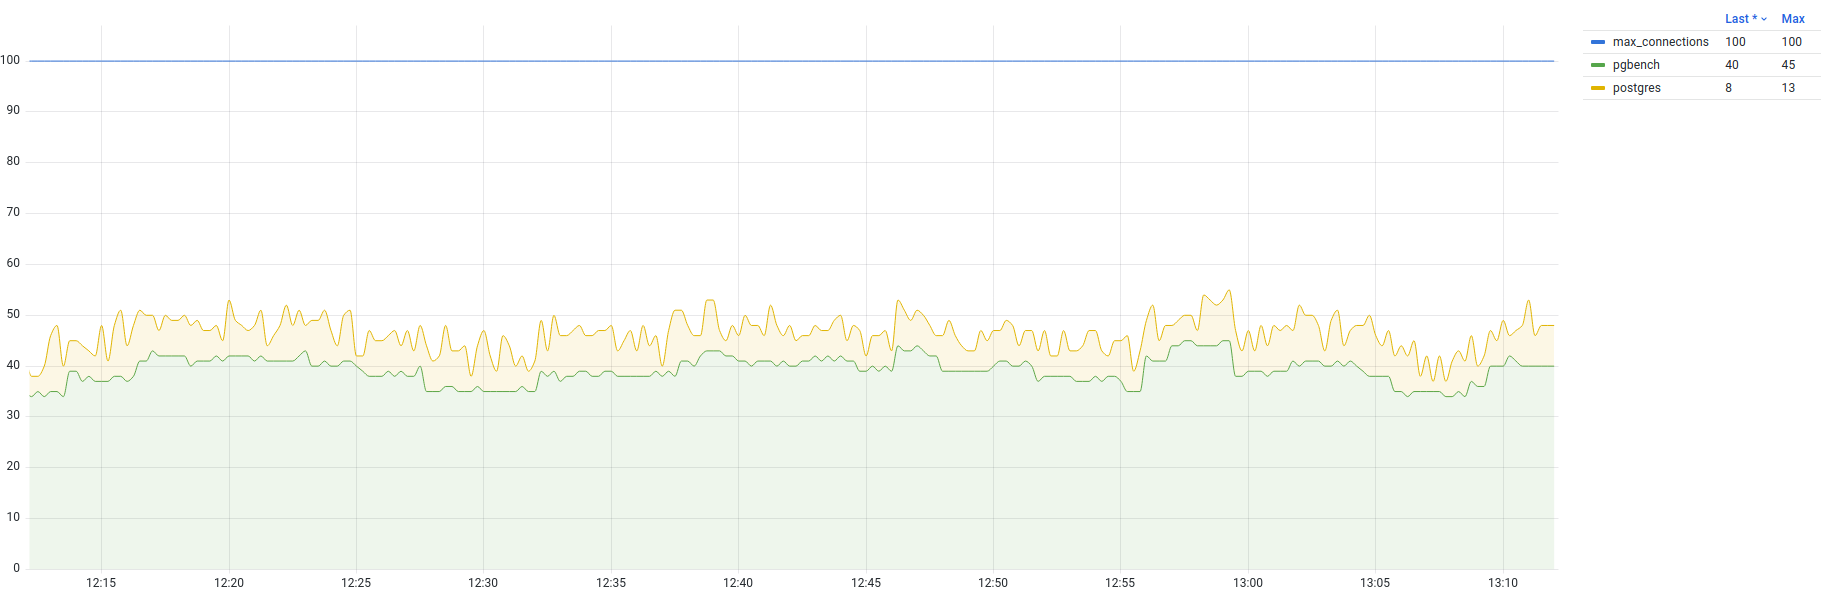
Из приведенного графика становится очевидным, что почти все соединения установлены к БД pgbench и это основная БД, на которой сосредоточена рабочая нагрузка. Совсем небольшая часть соединений установлена к БД postgres; скорее всего, эти соединения также устанавливаются экспортером метрик.
В зависимости от информативности метрик и используемых меток можно строить и другие проекции. Например, при широком использовании application_name со стороны прикладных приложений эту информацию можно также экспортировать в метках метрик и вывести соответствующий график.
Транзакционная активность
Запросы — это базовая единица рабочей нагрузки. Их можно объединять в транзакции, и транзакция выполняется как единое целое: ошибка даже в одном запросе воспринимается как ошибка всей транзакции целиком. Механизм транзакций устроен так, что даже один запрос, не обернутый явно в команды управления транзакциями (BEGIN и END), также является транзакцией (состоящей из одной команды).
По количеству выполняемых транзакций можно сделать выводы о том, насколько активно используется база данных. Найти необходимую информацию можно в pg_stat_database. Она включает в себя поля xact_commit и xact_rollback, которые показывают количество зафиксированных и оборванных транзакций. Сумма этих полей и показывает транзакционную активность в базе данных:
В тестовом окружении всего две активно используемые БД: pgbench и postgres. Также есть особая строка с отсутствующим именем базы данных, которая содержит статистику общих объектов системного каталога. Следующим запросом мы можем получить данные из мониторинга:
Запрос считает количество выполненных транзакций в секунду, на его основе можно получить график (рис. 2.5), который показывает эту картину в динамике. На нем наглядно видно, что объем выполняемых транзакций в БД pgbench в несколько раз больше, чем в БД postgres.
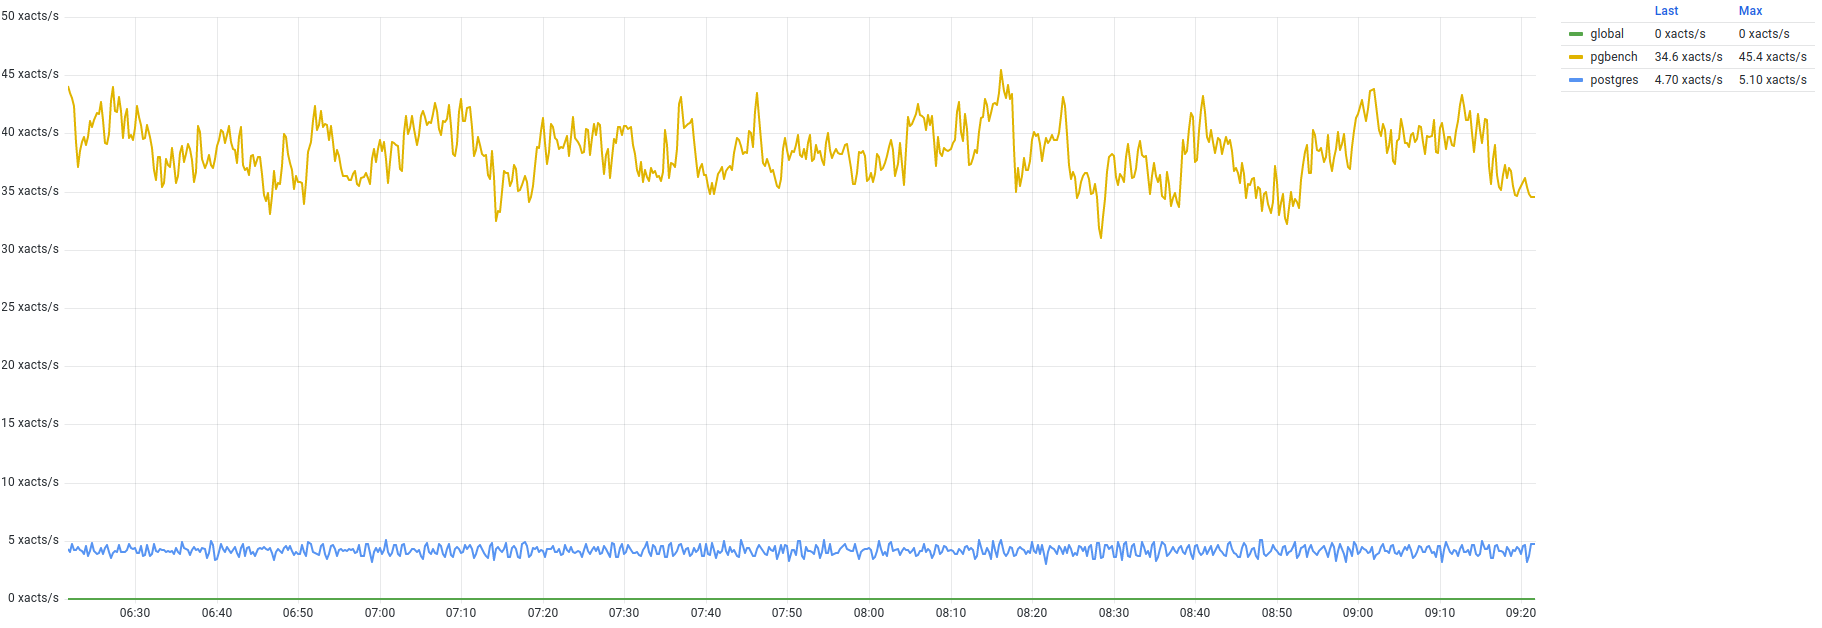
График транзакционной активности полезен для поверхностного анализа и понимания текущей активности в СУБД, он хорошо подходит в качестве сводного графика для дежурных инженеров. Сильные колебания обычно являются признаком изменения количества экземпляров приложений или изменения в объеме рабочей нагрузки, вследствие чего может измениться и использование ресурсов со стороны СУБД.
Подсчет транзакций с помощью pg_stat_statements
Информацию о транзакциях можно получить с помощью pg_stat_statements.query, отслеживая команды начала и завершения транзакций (BEGIN, COMMIT и пр.). Однако у этого способа есть несколько недостатков. Во-первых, должно быть включено отслеживание служебных команд (track_utility = on). Во-вторых, расширение регистрирует только прямые вызовы команды ROLLBACK, следовательно, невозможно отслеживать откаты транзакций, произошедшие из-за ошибок. В-третьих, не всегда возможно отследить начало транзакции. Например, если клиент использует \set AUTOCOMMIT off, транзакция будет открываться неявно сразу после первой выполненной команды. Поэтому учет с помощью pg_stat_statements хоть и возможен, но менее удобен.
Статусы завершения сеансов
Нормальная работа сеанса предполагает, что клиент устанавливает соединение с СУБД, отправляет запросы и, когда необходимость в подключении исчезает, закрывает соединение и отключается. Однако возможно и аномальное поведение, при котором сеанс будет прерван:
сброс соединения клиентом, СУБД или промежуточным сетевым устройством;
возникновение ошибки в сеансе, после которой продолжение сеанса невозможно;
принудительное завершение сеанса по инициативе администратора или СУБД.
Вполне возможны и другие, более экзотические варианты развития событий, но перечисленные выше причины встречаются наиболее часто. Аварийное завершение сеанса может происходить редко и незаметно — если сеанс прервется, СУБД запишет сообщение в журнал, приложение переустановит соединение и работа продолжится. Такое бывает из-за сетевых ошибок, тайм-аутов или потерь пакетов, когда нарушается работа TCP-соединения. Но есть и другая крайность: шквал ошибок, которые невозможно не заметить или игнорировать. Обычно это результат ошибок прикладного уровня, когда завершение сеанса происходит из-за ошибки в приложении. Например, после обрыва сеанса приложение может переустанавливать соединение и выполнять код с ошибкой, в результате чего сеанс сбрасывается и все повторяется снова без остановки. Такое поведение хорошо описывается термином crash loop, который не понаслышке знаком администраторам Kubernetes. При коротком (миллисекунды) интервале между ошибками приложение может создать шторм из попыток установки соединений. В лучшем случае это приведет к увеличению нагрузки на CPU на стороне СУБД (создание клиентских процессов обходится недешево). В худшем случае при наличии нескольких экземпляров приложения, которые ведут себя одинаково, можно исчерпать лимит подключений max_connections и сделать невозможным подключение других приложений к СУБД.
Статистика по статусам сеансов находится в pg_stat_database, получить ее можно следующим образом:
Напомню, что pg_stat_database содержит кумулятивную статистику, поэтому среди значений можно наблюдать большие числа. На что нужно обращать внимание в этой статистике, это наличие аномальных статусов: abandoned, fatal и killed. В данном примере таких сеансов не зафиксировано, и это указывает на то, что на уровне сеансов приложения работают корректно и без ошибок. В этом примере можно обратить внимание на то, что к служебной БД postgres выполнено гораздо больше соединений, чем к прикладной БД pgbench. С помощью следующего PromQL-запроса можно построить график и посмотреть картину во времени:
В данном запросе количество сеансов, находящихся в любых статусах, суммируется по двум интересующим нас БД. Статистика является кумулятивной, и для наглядности изменений во времени стоит применить функцию increase, которая показывает изменение метрики за указанный интервал (в этом примере — одна минута).
На графике (рис. 2.6) видно, что довольно большое количество сеансов — примерно 90 в минуту — устанавливается с БД postgres. Это объясняется рабочей нагрузкой, характерной для экспортера метрик. Экспортер устанавливает несколько сеансов на время сбора статистики,
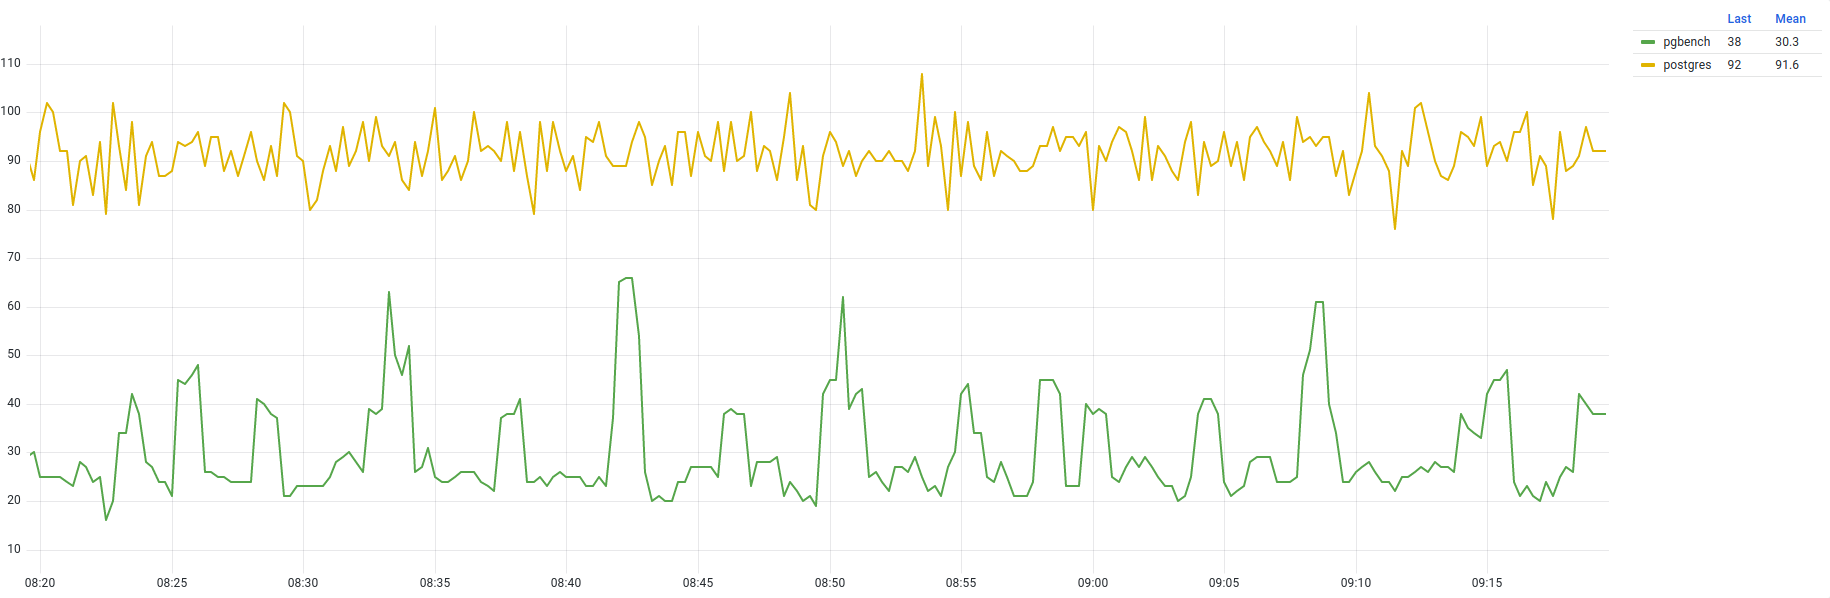
после чего завершает их. Такое поведение не очень эффективно в плане использования ресурсов, поскольку для каждого сеанса СУБД создает отдельный процесс и выполняет дорогостоящую инициализацию. С этой точки зрения выгодно установить и использовать несколько сеансов на постоянной основе, что является хорошей отправной точкой для оптимизации кода экспортера. Кроме экспортера в тестовом окружении работают прикладные приложения, которые перезапускаются каждые несколько минут с новыми параметрами нагрузки, и это заметно по резким пикам установки сеансов с БД pgbench. На практике реальные приложения могут перезапускаться редко, a установленные ими соединения могут продолжать работать в течение многих десятков минут и даже часов.
Пример из практики. Наличие аномальных статусов обычно является признаком проблемы или указывает на неэффективную работу приложения или окружения. Описываемый случай произошел, когда готовился материал этой главы.
Запрос на получение статусов сеансов показал, что значение в sessions_abandoned составляло 13 % от общего числа sessions и продолжало медленно увеличиваться. Это довольно большое значение, и я попытался выяснить причины такого количества оставленных сеансов. После отключения тестовой нагрузки счетчик продолжил расти, и подозрения упали на агента мониторинга. Эта проблема мне хорошо известна: она проявляется, если на стороне приложения не закрыть соединение должным образом. Имея доступ к исходному коду агента, я решил проверить все места, где открываются соединения. Нужно было убедиться, что соединения закрываются после использования, и я обнаружил одно из мест, где этого не делалось, что могло приводить к утечке соединений.
Для подтверждения постоянного характера проблемы я построил график (рис. 2.7) на основе следующего запроса:
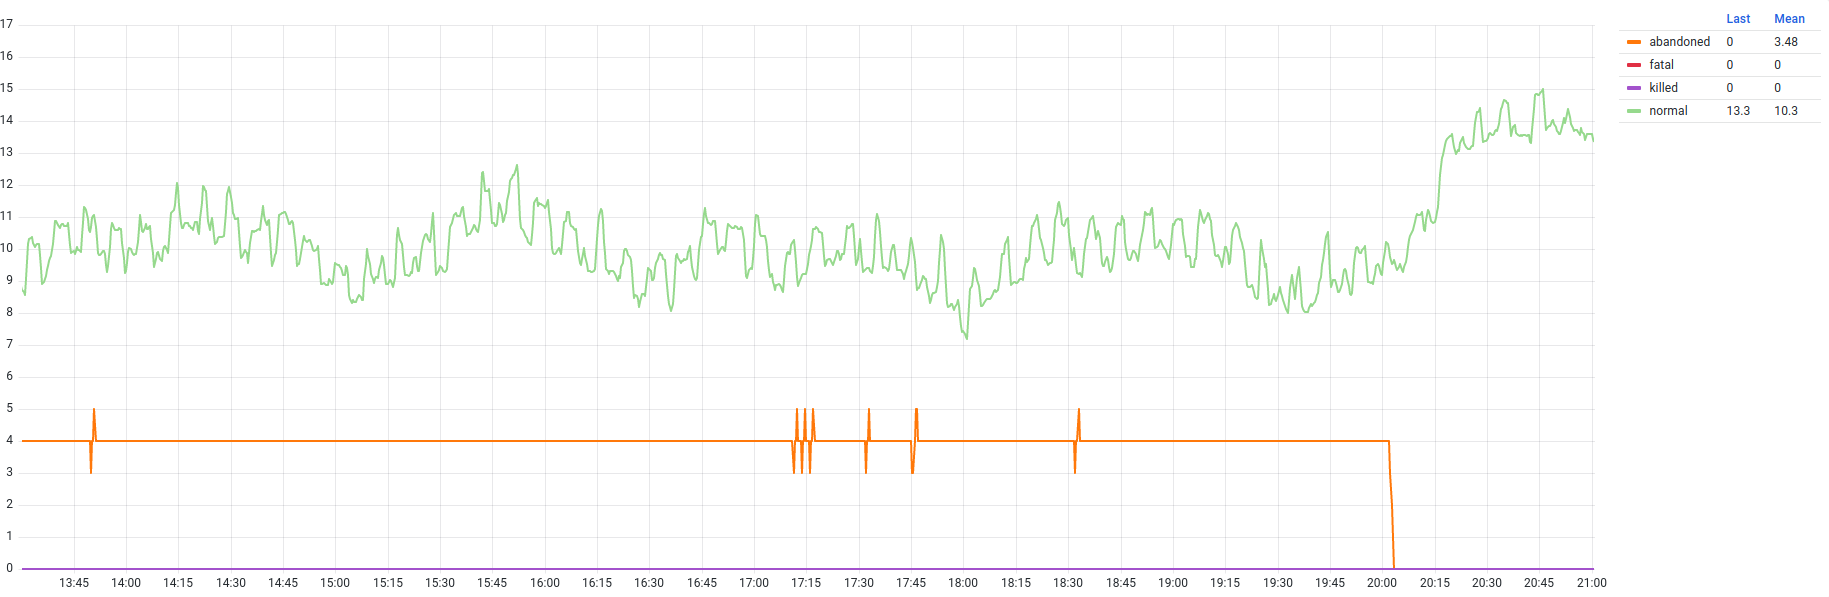
Результатом расследования стало исправление d0989237. Примерно в 20:00 версия приложения была обновлена, и проблема исчезла, что также подтвердилось графиком. Так мониторинг помог обнаружить и устранить ошибку в приложении агента.
2.5. Состояния сеансов
Клиентский процесс в своем жизненном цикле может находиться в разных состояниях, которые характеризуют происходящее в сеансе. Состояние процесса можно воспринимать как условный маркер, который помогает различать сеансы с нормальным и нежелательным поведением. Состояние отображается в pg_stat_activity.state, но при этом его можно увидеть только для клиентских соединений, а для фоновых процессов значение поля всегда отсутствует. Вероятно, это связано с тем, что «состояние» характеризует именно сеанс, а фоновые процессы не устанавливают сеансов, следовательно, и отображать нечего. Вполне возможно, в будущих версиях PostgreSQL ситуация изменится и появится какая-то информация о состоянии фоновых процессов. Давайте рассмотрим все состояния, в которых может находиться сеанс:
idleуказывает на состояние простоя. Если клиент не выполняет отправку команд, а сервер не занят выполнением запроса, то сеанс находится в холостом режиме и сервер ждет команды от клиента. В этом состоянии сеанс может находиться бóльшую часть своего времени.activeуказывает на активное состояние. Приняв команду от клиента, процесс начинает ее выполнение и переходит в активное состояние. Здесь важно отметить, что такое состояние включает в себя и состояние ожидания, когда процесс приостанавливает работу и ждет определенного события.idle in transactionуказывает на состояние открытой транзакции, в которой ничего не происходит и процесс ждет от клиента команду на выполнение. Открыв транзакцию, приложение должно выполнить в ней набор команд и закрыть ее, однако по каким-то внутренним причинам между командами возникает пауза. Такое состояние в зависимости от характера выполняемых команд потенциально может привести к блокировкам и раздуванию таблиц и индексов из-за отложенной автоочистки. Следует отслеживать такие транзакции и устранять причины, приводящие к такому состоянию. Более подробно о бездействующих транзакциях можно узнать на с. 56.idle in transaction (aborted)указывает на состояние незавершенной транзакции, внутри которой произошла ошибка. Хорошим тоном считается, когда приложение полностью контролирует ход выполнения транзакции. Если выполнение любой из команд в транзакции привело к ошибке, приложение должно откатить транзакцию. При отсутствии управления транзакциями в таких ситуациях возникает риск утечки ресурсов (в виде слотов пула транзакций на стороне драйвера БД в приложении). Для самой СУБД пребывание сеанса в таком состоянии является менее вредными, так как после ошибки все ресурсы и блокировки освобождаются, а вот для приложения это может быть чувствительно и способно привести к исчерпанию соединений во внутреннем пуле или появлению ошибок. Более подробно о бездействующих транзакциях можно узнать в подразделе на с. 56.fastpath function callуказывает на выполнение функции через интерфейс fast-path8. Этот способ выполнения считается устаревшим, и использовать его не рекомендуется. На практике мне не приходилось встречаться с подобным состоянием, но допускаю, что давно разработанные и оставшиеся без поддержки приложения могут использовать эту функциональность.disabledне определяет конкретное состояние процесса, а лишь указывает на то, что отслеживание состояний сеансов отключено в конфигурации СУБД. Отслеживание обычно включено по умолчанию, и не рекомендуется выключать его, так как это снижает наблюдаемость и возможности мониторинга и отладки.
Существует еще одно важное состояние, которое при этом не отражается в поле state. Это ожидание. Это состояние неявно включено в состояние active, хотя, на мой взгляд, эти два состояния должны быть разделены и их следует рассматривать отдельно друг от друга. Активное состояние подразумевает действие и использование ресурсов, в то время как ожидание подразумевает бездействие и удерживание ресурсов от использования. Из этого следует, что активное состояние — это нормальное рабочее состояние системы, а ожидание — ненормальное, и администратор должен предпринимать действия, которые уменьшали бы ожидание.
Отслеживание состояний
Мониторинг клиентских сеансов по состояниям позволяет отслеживать выполнение рабочей нагрузки и появление в ней разных аномалий. Просмотреть все клиентские процессы и их состояния можно с помощью следующего SQL-запроса:
В этом примере с синтетической нагрузкой видно, что бо́льшая часть соединений простаивает. В момент обращения к pg_stat_activity всего три процесса выполняют запросы, а один клиент открыл транзакцию и ожидает получения команды от клиента. Однако напоминаю, что состояние active неявно включает в себя и возможное ожидание, поэтому из результата непонятно точное состояние сеанса. Далее мы рассмотрим природу ожиданий и блокировок и варианты более точного определения состояния сеансов.
Ожидания и блокировки
Принцип блокировок заключается в ограничении или запрете одновременного доступа к ресурсу. В конкурентной среде следствием использования блокировок является появление очередей на доступ к заблокированному ресурсу. Нахождение в такой очереди напрямую влияет на время выполнения запроса или транзакции — выполнение будет заблокировано до тех пор, пока доступ не будет получен, а произойдет это только после того, как пройдет вся очередь и блокировка будет снята. Ожидание блокировок при выполнении запросов негативно сказывается на производительности: вместо того чтобы делать полезную работу, СУБД и приложения вынуждены ждать. Администратор обязан отслеживать, когда система тратит время на ожидание вместо полезной работы.
В случае клиентских процессов ожидание означает невозможность выполнять свою работу до тех пор, пока не освободится ресурс (объект) или не появится ожидаемое событие. Объектами могут являться таблицы или отдельные строки; легкие блокировки устанавливаются на ресурсы более низкого уровня. В качестве событий может выступать дисковый или сетевой ввод-вывод — синхронизация файлов, передача данных по сети и т. п.
Для отслеживания ожиданий используется представление pg_stat_activity. В СУБД потенциально очень много мест, где процесс может встать в ожидание. Вместо одного общего состояния важно знать, что именно стало причиной ожидания, поэтому поле state не очень подходит для этой задачи. В качестве инструмента СУБД предлагает так называемые события ожидания (wait event): они указывают на конкретные событие или ресурс, в ожидании которых находится процесс. В pg_stat_activity такие события ожидания представлены двумя полями:
wait_event_type— общий тип ожидания, или, иными словами, обозначение группы, к которой относится ожидание;wait_event— конкретное событие или ресурс, в ожидании которых находится процесс.
Событие ожидания указывает на зафиксированный факт ожидания процессом определенного события или ресурса, однако они появились в версии 9.6. В более ранних версиях ожидание можно было определить по флагу pg_stat_activity.waiting, который указывал только на один из частных случаев ожидания — ожидание блокировки. События ожиданий расширили охват регистрируемых событий, которые могут стать причиной ожиданий, и заменили собой этот более простой флаг. Полный список всех регистрируемых ожиданий можно найти в документации в разделе, посвященном pg_stat_activity9. В качестве небольшого примера разберем результат запроса в тестовом окружении.
Условием запроса исключены фоновые службы, их покрытие событиями ожиданий не самое большое, и в этом примере они нам не очень интересны. Для удобства работы с событиями ожиданий значения этих двух полей можно объединить в одно с помощью разделителя, например точки, так, чтобы оно сразу показывало и тип ожидания, и конкретное событие. Такое объединенное значение можно назвать маркером ожидания. В тестовом окружении есть несколько приложений, которые генерируют синтетическую нагрузку, и в приведенном результате запроса мы видим снимок ожиданий при выполнении этой нагрузки:
Client.ClientRead— процесс ждет получения команды от клиента. Это обычное состояние для простаивающих процессов, в таком ожидании процессы могут находиться бóльшую часть своего существования.LWLock.WALWrite— ожидание легкой блокировки, необходимой для записи страницы WAL-журнала из буфера в памяти на диск. Запись в WAL осуществляется последовательно и часто это становится узким местом в производительности СУБД при высокой конкурентной нагрузке на запись.Lock.transactionid— ожидание завершения соседней транзакции. Часто случается, если транзакции пытаются изменить одни и те же данные.IO.WALSync— ожидание синхронизации записи WAL-сегмента на диск.
Из этого небольшого примера видно, что варианты ожиданий могут быть самыми разными и, более того, их влияние на синтетическую нагрузку тоже может быть разным. Например, в зависимости от производительности дисков (HDD, SSD, NVMe) скорость записи и синхронизации WAL будет разной, и это отразится на времени ожидания. Ожидание соседних транзакций зависит от характера рабочей нагрузки, количества конкурентных транзакций и продолжительности как самих транзакций, так и составляющих их команд. А вот ожидание команды от клиента никак не сказывается на нагрузке, сеанс находится в холостом режиме и может быть использован приложением немедленно, без задержек, как только потребуется. Таким образом, маркеры ожидания подсказывают администратору, куда тратится время, и дают отправную точку для возможных оптимизаций системы.
Однако маркеров ожидания довольно много, и не все из них следует воспринимать как критичное состояние, требующее немедленной реакции. Как я уже отметил, Client.ClientRead — это вполне безобидное ожидание, которое не нарушает работу системы.
За годы практики я и некоторые мои коллеги пришли к тому, что среди всех типов событий ожидания есть особая группа, которую можно выделить среди остальных и рассматривать как отдельное состояние, равноценное значениям из pg_stat_activity.state. Речь о группе событий с типом Lock: ожидания этой группы указывают на то, что выполнение команды остановлено и ожидает получения тяжелой блокировки. Группа включает в себя несколько ожиданий, которые более точно определяют причину ожидания. Одним из примеров может служить ожидание transactionid, указывающее на ожидание завершения соседней конкурентной транзакции. События группы Lock прямо указывают, что как процесс, так и клиентское приложение вместо выполнения полезной работы находятся в ожидании, и это само по себе негативно влияет на производительность приложения и СУБД.
Отслеживание состояний с учетом ожиданий
Для учета состояния ожиданий блокировок есть два способа. Первый и предпочтительный заключается в использовании событий ожидания. С помощью условия wait_event_type = 'Lock' процессы можно идентифицировать как находящиеся в ожидании блокировок:
Второй способ чуть сложнее и представляет, скорее, академический интерес. Способ заключается в соединении с pg_locks и использовании флага granted. Однако следует учесть, что для одного процесса в pg_locks будет несколько блокировок (несколько строк) и учитывать нужно только те, которые не захвачены:
Результаты двух вариантов не совсем совпадают, потому что выполнены в разное время. Но первый вариант проще, поскольку позволяет обойтись без соединения.
Есть как минимум два способа реализовать метрики, показывающие состояние клиентов для мониторинга:
Отдельно показывать состояния на основе поля
stateи количество процессов со значениемLockв полеwait_event_state. В таком случае состояниеactiveбудет включать в себя процессы, находящиеся в ожидании блокировок.Исключать процессы, находящиеся в ожидании с типом события
Lock, из числа процессов в состоянииactive.
Внутренняя реализация метрики postgres_activity_connections_in_flight использует второй способ и включает в себя метку state. Помимо стандартных состояний, метка может содержать и дополнительное состояние waiting, которое как раз указывает на процессы, находящиеся в ожидании блокировок:
На рис. 2.8 изображен пример графика на основе этого запроса.
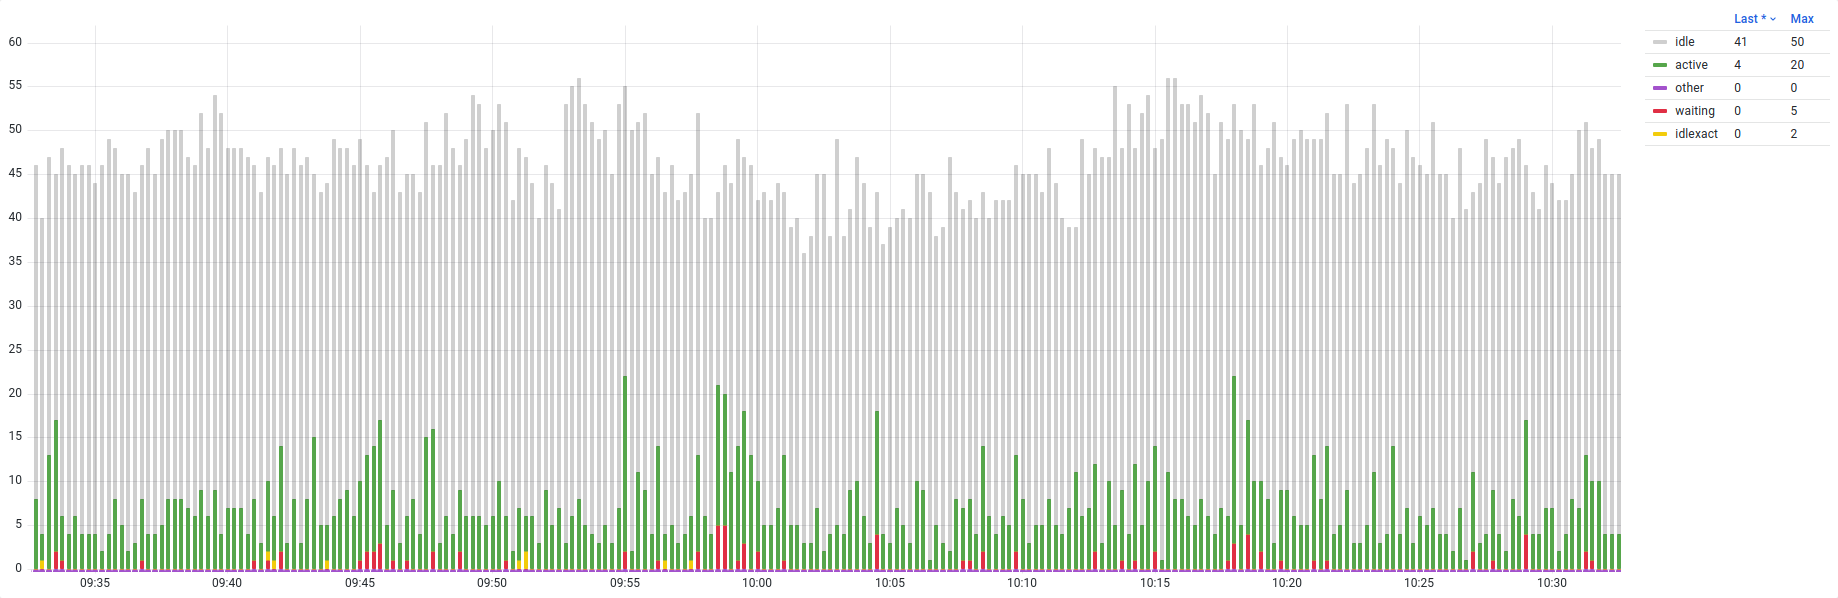
На графике есть процессы почти во всех возможных состояниях, в том числе и в ожидании блокировок. Объединяя возможности полей state и wait_event_type, можно собрать воедино информацию о состоянии клиентских сеансов.
Взаимоблокировки
Взаимоблокировка (deadlock) — это ситуация из нескольких блокировок, которая не может разрешиться сама собой, поскольку ее участники дошли до тупикового состояния, в котором все они заблокированы друг другом, перешли в ожидание и не могут продолжать работу. Для разрешения ситуации необходимо освободить часть блокировок путем принудительного завершения одного из участников взаимоблокировки.
В случае обычных блокировок ожидание может длиться непредсказуемо долго. Со взаимоблокировками все намного проще: их обнаружение и разрешение выполняется автоматически, без необходимости вмешательства со стороны администратора. Если блокировку не удалось взять за время deadlock_timeout (по умолчанию одна секунда), сеанс проверяет, не является ли он участником взаимоблокировки. В ходе проверки определяются участники конфликта. Если среди участников есть процесс очистки, то ему будет отправлен сигнал о завершении. Исключение составляют процессы очистки с целью предотвращения зацикливания счетчика транзакций (to prevent wraparound). Если процессов очистки нет, то сеанс, начавший проверку, принудительно отменяет выполнение своего собственного запроса, ради которого и потребовалось взять блокировки. Если запрос выполнялся в транзакции, вся транзакция становится ошибочной и ее следует завершить откатом. Остальные участники взаимоблокировки могут дальше продолжить работу, однако нет гарантий, что взаимоблокировка не возникнет снова.
На практике в самом простом варианте взаимоблокировки возникают при перекрестной попытке взять блокировки на одни и те же ресурсы из разных сеансов. Например, первая транзакция пытается захватить блокировку на ресурс, захваченный второй транзакцией, а вторая транзакция пытается захватить ресурс, взятый первой транзакцией. Основной вред взаимоблокировок заключается в том, что при их постоянном возникновении существенно уменьшается производительность (из-за снижения конкурентности) и появляется необходимость в повторе операции (запроса или транзакции) из-за ее принудительной отмены. Однако, учитывая автоматический характер разрешения взаимоблокировок, наносимый ими вред существенно меньше, чем в случае обычных блокировок, которые могут останавливать работу соседних сеансов на непредсказуемо долгое время.
К сожалению, универсального решения со стороны СУБД не существует, поскольку проблема заключается в неоптимальном порядке выполнения команд при конкурентной работе приложения с СУБД. Чтобы полностью решить проблему, необходимо изменить подход в работе с данными со стороны именно приложения.
Для отслеживания взаимоблокировок используют счетчик pg_stat_database.deadlocks, свой для каждой БД. В случае возникновения взаимоблокировки информация о ней записывается в журнал активности:
В зависимости от значения log_line_prefix содержимое журнала может дополняться и другой полезной информацией (время, пользователь, база данных, идентификаторы транзакций и пр.). В выводе есть ключевое сообщение о том, что зафиксировано появление взаимоблокировки — deadlock detected. Далее следуют информация о том, какой процесс находился в ожидании, каким процессом была вызвана блокировка, и тексты запросов, которые выполнялись в обоих сеансах в момент обнаружения взаимоблокировки. Здесь стоит учитывать, что это текущие запросы, а в реальности конфликтующая блокировка могла быть захвачена другим запросом той же транзакции, выполнение которого предшествовало текущему. Для полного анализа необходимо включать протоколирование всех запросов (log_statement = all или log_min_duration_statement = 0), полностью записывать ход выполнения запросов в транзакции и проверять порядок их выполнения.
Бездействующие транзакции
В идеальном случае последовательность команд, составляющих транзакцию, должна выполняться непрерывно, без пауз или задержек — клиент, получив результат, должен немедленно отправить следующую команду. Однако на практике получается, что между отправкой команд приложение выполняет какую-то работу, в то время как СУБД ожидает от него продолжения (маркер ожидания Client.ClientRead). Транзакция в состоянии ожидания команды от клиента называется бездействующей (idle) транзакцией. Состояние простоя idle in transaction в абсолютном большинстве случаев возникает из-за клиента и лишь в редких случаях из-за окружения, в котором работает приложение (операционная система или сетевое окружение). С точки зрения приложения паузы между отправкой команд могут быть вызваны такими причинами, как:
вычисления на основе результатов предыдущих команд;
обращение к удаленному сервису (кеш, очередь, БД, API и т. п.);
недостаток системных ресурсов и их выделение операционной системой (память);
приостановка приложения при исчерпании установленного ограничения на использование ресурсов (Kubernetes requests/limits);
возникновение ошибок и обработка исключений.
Это неполный список, и причины, по которым могут появляться простои в транзакциях, могут быть самыми разными и не всегда очевидными. В большинстве случаев ответственность за образование бездействующих транзакций возлагается на приложение. Хороший пример — обработка ошибок. В случае ошибки правильным действием со стороны приложения является завершение транзакции откатом. В худшем случае может возникать утечка транзакций — ситуация, когда приложение теряет контроль над транзакцией и она остается незавершенной в течение неопределенно долгого времени. Возможны и другие сценарии. Например, пользователь подключается к БД и выполняет какие-то команды. Пользователю может потребоваться начать транзакцию, выполнить в ней команду и затем сделать откат. Или IDE, в которой работает пользователь, при выполнении команд может неявно открывать транзакцию. Пользователь отвлекается на другую задачу, и ранее открытая транзакция остается незавершенной.
Пребывание клиентских сеансов в состоянии idle in transaction имеет свои негативные эффекты, и некоторые из них в зависимости от условий эксплуатации СУБД могут привести к аварии:
Удерживание соединения с БД. Когда приложение открывает транзакцию, предполагается, что оно будет выполнять последовательность команд. В случае использования пулов соединений на стороне приложения соединение с открытой транзакцией не может использоваться другим потоком выполнения. При достижении ограничения на число одновременно открытых соединений на стороне пула, приложение заблокируется до освобождения хотя бы одного соединения.
Устаревшие версии строк, эффект раздувания и падение производительности. При высокой интенсивности на запись размер таблиц и индексов растет из-за появления нескольких версий одних и тех же строк. Устаревшие версии строк не только занимают место на диске, но и негативно влияют на производительность. При чтении и поиске данных процессу приходится обрабатывать больше страниц в поисках нужной версии строки, что приводит к замедлению запроса и избыточному использованию ресурсов CPU, памяти и ввода-вывода. Для регулярного удаления устаревших версий строк и освобождения места используется автоочистка. Рабочие процессы автоочистки сканируют таблицы и индексы, находят версии строк, которые не нужны ни одной из транзакций, и удаляют их. Но старые версии строк могут понадобиться долгим транзакциям (в том числе бездействующим), поэтому автоочистка пропускает удаление таких версий. В случае же успешного удаления освобожденное место продолжает принадлежать таблице (или индексу). Получается, что размер таблиц и индексов увеличивается, но после очистки не уменьшается — это и называется эффектом раздувания. В особо запущенных случаях объем освобожденного пространства внутри таблиц и индексов может превышать общий объем полезных данных.
Блокировки, исчерпание доступных подключений к СУБД. При высокой интенсивности на запись команды в транзакции могут удерживать блокировки строк. Соседние транзакции могут захотеть получить доступ к этим же строкам и при попытке взять блокировку будут ждать, пока блокировку не отпустит бездействующая транзакция. Ожидающие процессы не могут использоваться приложением. При высокой нагрузке приложение будет пытаться открыть новые соединения, что может привести к росту очереди ожидающих и достижению ограничения на одновременно разрешенные подключения. При достижении этого ограничения приложение не сможет подключиться к БД, что приведет к невозможности работы и приложения, и СУБД, и других приложений, которые также хотели бы установить соединение с СУБД.
Таким образом, состояние idle in transaction является потенциально опасным, и долгое пребывание процессов в этом состоянии может привести к негативным последствиям. Такие транзакции нужно отслеживать и устранять. В тактическом плане такие транзакции можно завершать автоматически через включение тайм-аута idle_in_transaction_session_timeout в настройках СУБД. Эту настройку можно сделать как глобально, на уровне общей конфигурации СУБД, так и индивидуально, на уровне отдельных пользователей или баз данных. Другим вариантом может быть периодический запуск скриптов на основе функции pg_terminate_backend средствами утилиты cron. Такое решение может быть предпочтительным в случае, когда возможностей idle_in_transaction_session_timeout недостаточно и требуется более тонкая настройка тайм-аутов. Пример использования связки pg_terminate_backend и pg_stat_activity:
Такой запрос достаточно вызвать из psql. При необходимости список полей в SELECT или условия можно переопределить, а вывод результата сохранять, например, для анализа.
clock_timestamp vs now
Для определения длительности обычно принято вычитать отметку времени из текущего времени. В любой СУБД есть функция, которая выводит текущее время. В PostgreSQL такой функцией является хорошо известная now, однако ее особенностью является то, что она показывает время начала транзакции. Попробуйте вызвать now в транзакции несколько раз. Для целей же мониторинга рекомендуется использовать clock_timestamp, которая всегда показывает текущую отметку времени.
2.6. Время выполнения запросов и транзакций
Рабочая нагрузка состоит из постоянного потока запросов и транзакций, и чем быстрее они выполняются, тем больше пропускная способность системы. Наблюдая за рабочей нагрузкой можно сфокусироваться на отдельных единицах выполнения — транзакциях и запросах, и отслеживать появление продолжительных запросов и транзакций, нехарактерных для этой рабочей нагрузки. Оптимизация времени выполнения положительно сказывается на производительности независимо от типа рабочей нагрузки. Неважно, OLTP, OLAP или HTAP, оптимизация всегда направлена на сокращение времени выполнения запросов и уменьшение объема ресурсов, необходимых для их выполнения. Время выполнения запросов зависит от таких факторов, как количество требуемых ресурсов, доступные СУБД ресурсы, сложность запроса, его параметры и план выполнения и т. п. Долгое выполнение команд может указывать на самые разные проблемы. Например, выбор планировщиком неэффективного плана может выражаться в долгом выполнении и избыточном использовании ресурсов. Долгие транзакции могут быть следствием плохого дизайна и проблем в управлении транзакциями на стороне приложения. С точки зрения приложений долгое выполнение операций в СУБД может приводить к тайм-аутам обработки запросов в самом приложении или эффекту зависания (если тайм-ауты не настроены), исчерпанию соединений к СУБД и аварийной остановке приложения. В регулярные задачи администратора входит отслеживание времени выполнения команд, расследование и устранение причин долгой работы. Зачастую устранением причин DBA занимается совместно с командами разработки приложений.
Для отслеживания продолжительности выполнения команд и транзакций в pg_stat_activity есть несколько полей:
xact_start— время начала транзакции. Значение может отсутствовать (NULL), если в данный момент нет активной транзакции или в транзакции произошла ошибка и при этом транзакция не была закрыта, — состояниеidle in transaction (aborted);query_start— время начала текущего запроса (состояниеactive) или последнего выполненного запроса в сеансе (все прочие состояния).
Для получения информации о длительности выполнения запросов и транзакций можно использовать такой вариант запроса:
В этом запросе есть несколько особенностей, на которые стоит обратить внимание:
Для определения состояния применяется расширенная логика с использованием событий ожидания. Процессы с типом события
wait_event_type = 'Lock'расцениваются как процессы, ожидающие завершения конкурентных транзакций.Условие запроса отбирает именно транзакции, а не отдельные запросы: левая часть условия
ORищет активные транзакций, правая часть — отмененные (aborted), но не закрытые транзакции. И вот почему: запросы, даже если они выполняются отдельно, вне транзакций, на самом деле также используют транзакционный механизм и, по сути, являются транзакциями, состоящими из одной команды. В таком случае даже для обычных запросов заполняется полеxact_start(которое в этом случае равно значениюquery_start). Поэтому нет смысла концентрироваться на поиске запросов, они попадут в результат в любом случае.В правом от
ORусловии для поиска отмененных транзакций используется полеstate. Смысл его использования заключается в том, что в случае возникновения ошибки внутри транзакции значениеxact_startустанавливается вNULL, но сама транзакция при этом остается открытой. Чтобы не потерять такие транзакции, следует ориентироваться наquery_start— время запроса, который завершился ошибкой.Изменяя значение в интервале, можно исключать из результата совсем короткие транзакции.
С помощью метрики postgres_activity_max_seconds можно получить максимальную длительность транзакции. Метрика содержит в себе несколько меток:
user— пользователь, вызвавший активность;database— база данных, к которой подключен клиент;type— тип активности: пользовательский запрос или фоновое обслуживание (в случае автоочистки или сбора статистики для планировщика);state— состояние сеанса, согласно полюstateс учетом состоянияwaiting.
С помощью меток можно выполнить агрегацию нескольких метрик в необходимой проекции. Например, следующим запросом можно отобразить долгую активность по конкретным пользователям независимо от типа активности, базы данных и состояния:
На рис. 2.9 изображен пример графика на основе этого запроса. Из графика видно, что бóльшая часть запросов укладывается в интервал до 500 миллисекунд. Отдельно отметился процесс автоочистки, который выполнялся на тот момент около четырех секунд. Важно отметить, что эта метрика и график на ее основе показывают не абсолютно всю активность, происходящую в СУБД, а лишь ту, что была в момент опроса pg_stat_activity.
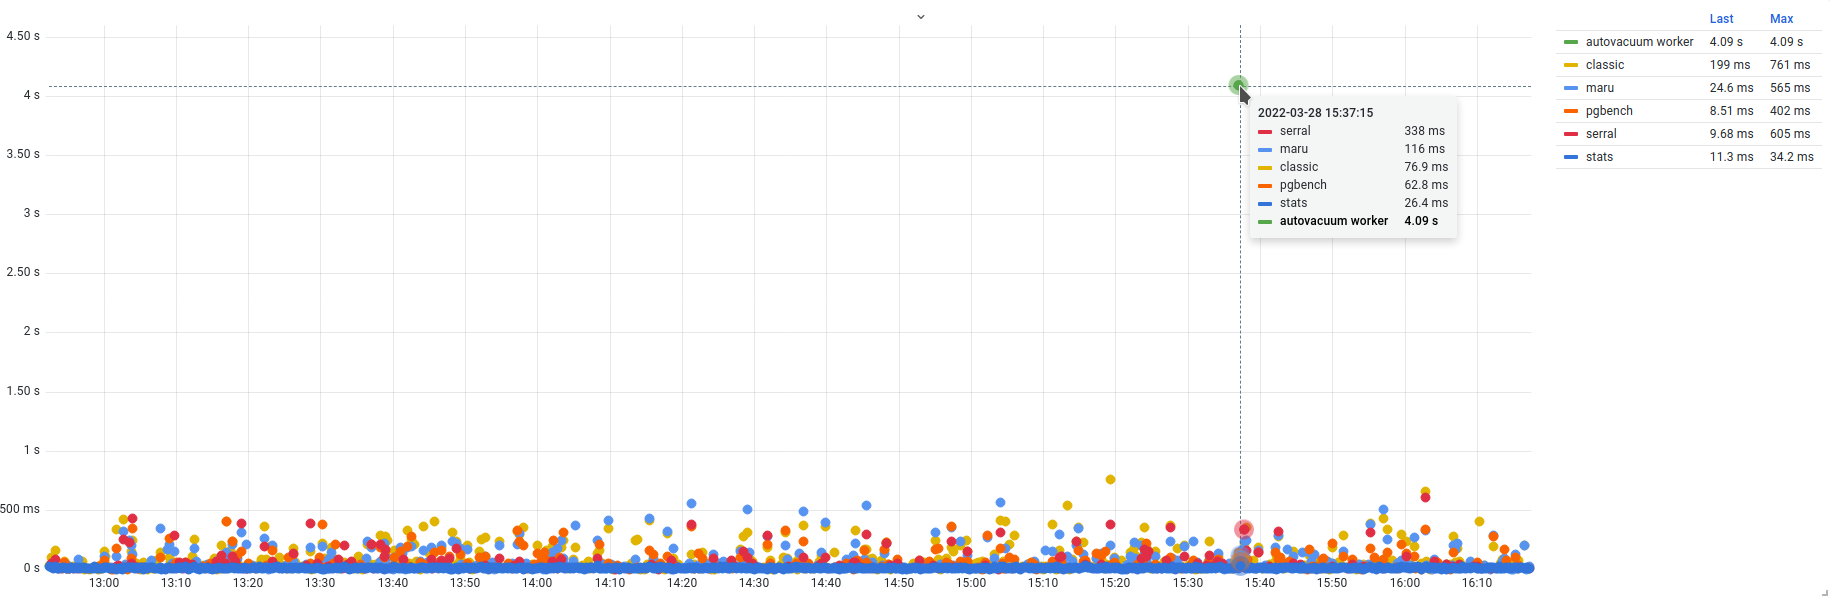
2.7. Отслеживание времени ожидания блокировок
Во время ожидания процесс не может выполнять полезную работу до тех пор, пока не исчезнет причина ожидания. Продолжительное ожидание само по себе неэффективно с точки зрения использования ресурсов и времени. Выявляя и устраняя участки, в которых происходит ожидание, можно ускорить выполнение рабочей нагрузки и общую производительность системы. Далее речь пойдет о времени, проведенном на блокировках, поскольку нет гарантированно точного способа определить время ожидания конкретного события.
Использование pg_locks.waitstart
Для оценки времени ожидания понадобится поле pg_locks.waitstart. Если процесс не находится в ожидании, то значение этого поля будет отсутствовать. Если процесс не смог взять блокировку, он переходит в ожидание, и это поле показывает время перехода в ожидание. Здесь есть неявная связь с другим полем этого же представления: на ожидание блокировки указывает не только waitstart, но и флаг granted. Однако они не полностью согласованы, и waitstart может в течение короткого периода содержать NULL, когда поле granted уже установлено в false.
При оценке времени ожидания можно использовать как минимум два подхода к расчету (на практике можно встретить и больше). Время ожидания всех процессов на текущий момент можно получить следующим запросом:
Первый вариант подсчета сводится к суммированию всех ожиданий всех процессов. В этом случае получается общее время ожидания, и чем оно больше, тем хуже ситуация, особенно в системах с большой конкурентностью. Вариант подходит для общей оценки того, сколько времени СУБД тратит на ожидание.
Второй вариант — это учет лишь максимального времени ожидания среди всех процессов. В этом случае получится картина только по одному процессу, который ждет дольше всех остальных. Вариант подходит для оперативного мониторинга, чтобы понимать, что в конкретный момент есть (или был) конкретный процесс, который находился в ожидании конкретный интервал времени.
Убрав в исходном запросе лишние поля и обернув его в CTE, можно получить оба значения и заодно посчитать количество ждущих процессов:
В этом выводе видно, что в момент опроса было шесть процессов в ожидании, самый долгий ждал около 284 миллисекунд, а суммарно все клиенты СУБД прождали примерно одну секунду. В контексте синтетической нагрузки тестового окружения такие цифры могут казаться незначительными, однако в реальных окружениях значения могут быть совсем другого порядка. Своевременное обнаружение и сокращение времени ожидания позволит увеличить производительность приложений и СУБД.
Текущая реализация используемого агента по умолчанию собирает максимальное время ожидания среди всех процессов. Статистику ожиданий и график (рис. 2.10) можно получить с помощью запроса:
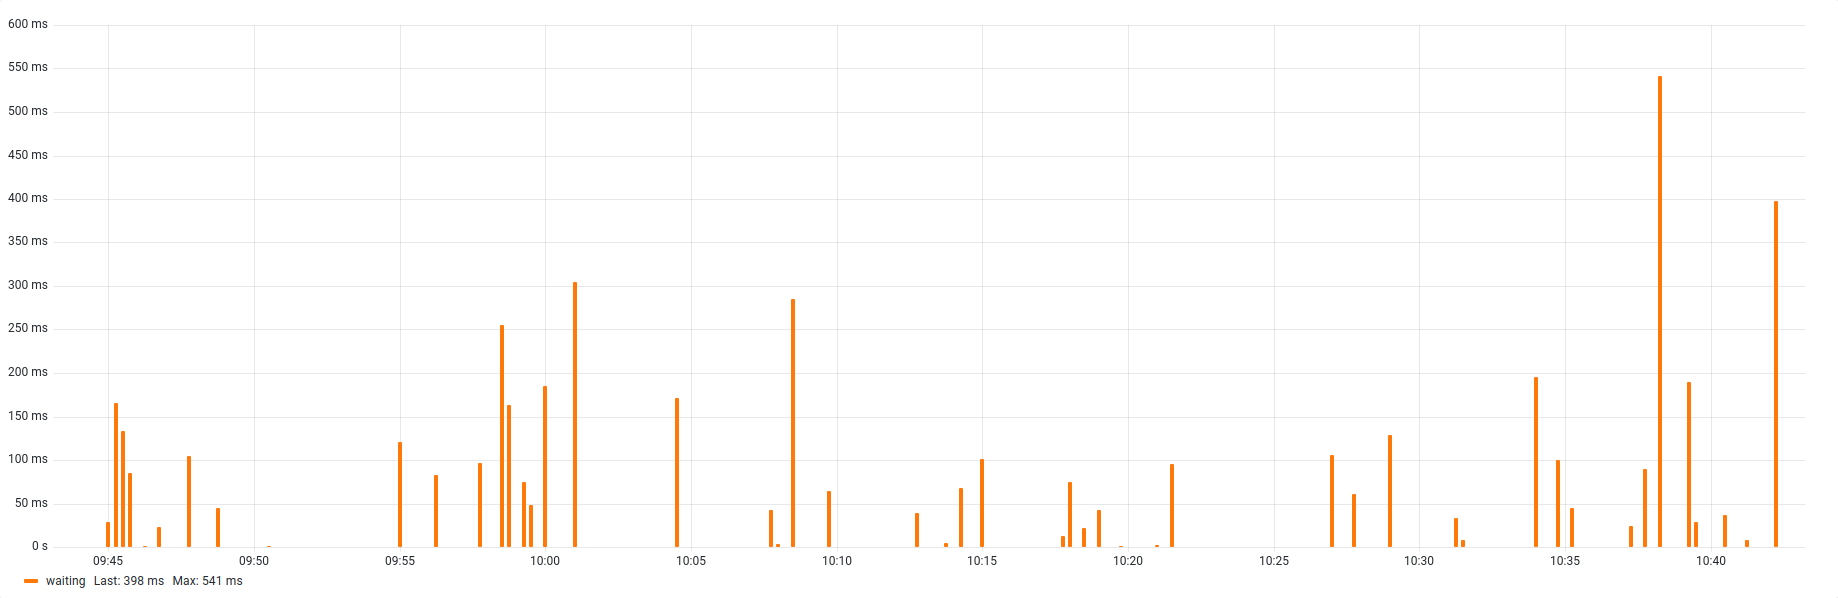
Ожидания блокировок не превышают секунды, и для тестового окружения это приемлемо. Но есть высокая вероятность, что на самом деле ситуация чуть хуже, чем это представляется из графика, так как pg_locks не аккумулирует статистику и исключает возможность получить полную картину по блокировкам.
Использование pg_stat_activity.state_change
В PostgreSQL до версии 14 отсутствовало поле pg_locks.waitstart, однако необходимость в отслеживании времени ожидания была всегда. В этих версиях СУБД можно использовать менее точный способ с использованием поля pg_stat_activity.state_change. Поле содержит отметку времени перехода состояния с предыдущего на текущее. Если ожидание включено в активное состояние, то при наличии у процесса маркера ожидания можно учесть время, проведенное в активном состоянии, как время, проведенное в ожидании. Недостаток способа заключается в том, что после перехода в активное состояние ожидание может начаться не сразу, а спустя какое-то время, но весь период будет зачтен как проведенный в ожидании. Это легко продемонстрировать на версии 14, где есть правильный источник pg_locks.waitstart.
Для демонстрации потребуется небольшая таблица, например та, что создается стандартным сценарием pgbench. В эксперименте эта таблица содержит 50 000 строк. Понадобится открыть три сеанса к СУБД: первый и второй сеансы — для воспроизведения тестового сценария с блокировкой запроса, третий — для отслеживания статистики. В первом сеансе нужно открыть транзакцию и обновить последнюю строку в тестовой таблице. Транзакцию при этом следует оставить открытой:
Во втором сеансе понадобится предварительно узнать pid процесса, после чего запустить полное обновление всей таблицы.
В третьем сеансе следует взять статистику из pg_stat_activity и pg_locks. В качестве условия указываем вывод строк только для второго сеанса с идентификатором 2291758. Для удобства отслеживания после первого выполнения запроса стоит запустить метакоманду \watch 1, которая будет повторять запрос раз в секунду.
В выводе запроса нас интересуют поля state_age и wait_age, которые и будут демонстрировать отличие способов в подсчете времени ожидания процесса. Полное обновление таблицы будет выполняться до тех пор, пока не будет достигнута последняя строка, которая ранее была обновлена во все еще незакрытой транзакции.
Здесь видно, что у процесса состояние active и время смены состояния state_age увеличивается. Значение granted = true указывает на то, что ожидания блокировок нет и запрос работает. Через какое-то время выполнение запроса остановится, и можно будет увидеть примерно следующее:
Появилась строка для блокировки, которую не удалось взять, с состоянием granted = false и отсчетом, начавшимся в wait_age. При этом значение state осталось прежним, state_age не сбросился и продолжает отсчитываться. В этом примере получается, что запрос выполнял полезную работу примерно девять секунд до начала ожидания блокировки. Фактически ожидание началось после девяти секунд работы запроса. Это поведение и демонстрирует отличие способов учета с помощью waitstart и state_change. Если вы решите повторить эксперимент, не забудьте в конце отменить или закрыть транзакцию, это позволит запросу во втором сеансе завершиться.
Используя учет времени на основе state_change, следует помнить о таком поведении. Например, в OLTP-нагрузке, преимущественно состоящей из коротких и быстрых запросов, оно не сильно исказит статистику, и этот способ подсчета может показаться приемлемым. А вот в случае более долгих OLAP-запросов (как в эксперименте выше) статистика может оказаться неточной, время ожидания будет несправедливо включать в себя время выполнения полезной работы, и способ подсчета может оказаться сомнительным.
2.8. Дерево блокировок
На практике часто бывает так, что в определенные моменты довольно много процессов находятся в ожидании блокировок, причем часть процессов оказываются заблокированы другими процессами. Если в такой ситуации найти источник блокировки и устранить его, то с высокой вероятностью остальные процессы смогут нормально продолжить работу. Однако, не имея подготовленных средств, в такой ситуации довольно сложно точно идентифицировать процесс, который стал причиной всех блокировок. Можно анализировать непосредственно вывод pg_stat_activity и pg_locks, но это неудобно и может занять много времени. Для определения источников блокировок нужно выявить зависимости между процессами и построить дерево зависимостей между заблокированными и блокирующими процессами. Такая визуализация позволит быстро определить источник блокировки и устранить его. Подход к решению таких проблем не является новым, и на просторах интернета можно найти разные реализации, которые позволяют выводить дерево блокировок. Такие запросы основываются на pg_stat_activity и pg_locks и, как правило, занимают несколько страниц, поэтому я не буду приводить их здесь. Такие запросы для удобства использования лучше всего оборачивать в представления.
В качестве отправной точки я взял этот запрос10 и немного модифицировал его. Итоговый запрос можно найти в репозитории книги, в файле playground/scripts/locktree.sql11. Ключевой особенностью запроса является использование функции pg_blocking_pids. Функция принимает идентификатор процесса и возвращает список процессов, которые его блокируют. Это довольно удобно и позволяет избежать использования pg_locks, однако, согласно документации, частый вызов этой функции может негативно сказываться на производительности СУБД, так как функция получает кратковременный исключительный доступ к общему состоянию менеджера блокировок. Так или иначе, функция удобная, и использование ее в редких случаях поиска не должно быть проблемой. Не следует применять ее регулярно для нужд мониторинга, например для снятия метрик. В определенных условиях эксплуатации (высокая нагрузка, требования к задержкам), когда эта особенность даже для целей отладки оказывается неприемлемой, вместо pg_blocking_pids можно использовать pg_locks12.
Давайте рассмотрим пару примеров получения дерева блокировок в тестовом окружении.
Блокировки, представленные в первом примере, часто возникают при конкурентном обновлении данных. Каждая строка вывода описывает отдельный процесс и детализацию сеанса на основе pg_stat_activity. Давайте рассмотрим поля этого запроса:
pid— идентификатор процесса;blocked_by— список процессов, которые блокируют текущий процесс. Рассчитывается на основе функцииpg_blocking_pids;state— состояние процесса с дополненным псевдосостояниемwaitingна основе условияwait_event_type = 'Lock';wait— маркер ожидания, составленный изwait_event_typeиwait_event;wait_age— длительность ожидания процесса на основеpg_locks.waitstart;tx_age— длительность транзакции;
usename— имя пользователя;datname— имя базы данных;blkd— количество других процессов, заблокированных данным;query— текст запроса. Содержит идентификатор процесса и его уровень в своей ветви дерева блокировок.
Все процессы можно условно разделить на группы, в которых есть основной источник блокировки, который никем не блокируется, и есть заблокированные процессы, которые могут также блокировать других участников группы. Давайте более внимательно рассмотрим последнюю группу, где главным процессом, который заблокировал остальных участников, является процесс с идентификатором 2072424. По тексту запроса видно, что это фиксация транзакции (END, или COMMIT), сам процесс находится в активном состоянии и его маркер ожидания — LWLock.WALWrite. Это указывает на то, что происходит запись в WAL-журнал, и пока она не завершится, клиент не получит возможность отправлять другие команды или открывать транзакции. Такое поведение характерно в режиме синхронной фиксации (см. synchronous_commit), который используется по умолчанию. По полю blkd можно увидеть, что фиксация транзакции блокирует еще четыре процесса, которые описаны в строках ниже. По полям pid и blocked_by можно проследить взаимосвязи процессов и кто кого блокирует. Также глубину блокировки удобно отслеживать по символу точки в поле query. По тексту запроса в этом же поле видно, что три процесса пытаются обновить одну и ту же строку по условию WHERE bid = 8. Вероятней всего, эта строка была обновлена в транзакции, которая фиксируется в данный момент, чем и вызвана очередь ожидания. Поля state и wait указывают на то, что все четыре процесса находятся в ожидании блокировок. Судя по полю wait_age, время ожидания составляет меньше одной секунды — это вполне приемлемо для тестовой рабочей нагрузки, а вот в производственной нагрузке даже такие короткие ожидания могут стать причиной задержек в приложениях. Поля usename и datname указывают, от имени каких пользователей и в какой базе данных возникли блокировки.
Рассмотрим еще один пример дерева блокировок, который может возникнуть в тестовом окружении.
В этом примере источником блокировки выступает процесс с командой опустошения таблицы (TRUNCATE). Это довольно быстрая операция, заключающаяся в замене файла данных на пустой, однако сначала ей нужно дождаться завершения ранее запущенных запросов к целевой таблице. В момент опустошения таблица блокируется, поэтому все процессы, обращающиеся в нее, должны дождаться завершения команды. Поле blkd показывает, что процесс TRUNCATE (pid = 161) блокирует выполнение еще двадцати процессов. Примерно половина из них пытаются вставить строки в опустошаемую таблицу — у всех этих процессов в поле blocked_by указан идентификатор процесса TRUNCATE. Другая часть процессов — это операции обновления, которые, в свою очередь, ожидают выполнения вставок. Подтвердить это можно, сопоставив значения идентификаторов blocked_by с полем pid процессов, выполняющих вставку. Также можно сопоставить значения поля bid в запросах — оно будет совпадать в отдельных цепочках ожидающих запросов: например, процесс 955 обновляет строку с bid = 20 и ожидает завершения вставки в процессе 1942, который сам ожидает завершения команды TRUNCATE. Состояние и маркеры ожидания процесса, выполняющего команду TRUNCATE, показывают, что процесс активен и синхронизирует WAL-сегмент с файлом на диске (вызовом fsync или другим способом, который указан в параметре wal_sync_method). Еще одним способом определения причин ожиданий является исследование записей о блокировках в журнале сообщений СУБД (при условии, что включен параметр log_lock_waits и ожидание составило больше, чем значение параметра deadlock_timeout, по умолчанию равное одной секунде).
Оба рассмотренных случая относятся к рабочей нагрузке в тестовом окружении, которое характеризуется короткими транзакциями и такими же короткими блокировками. На практике все может быть намного сложнее, особенно если источником блокировок выступают бездействующие транзакции, которые могут удерживать блокировки непредсказуемо долго и потенциально приводить к аварийным ситуациям. Порядок действия в таких ситуациях, как правило, сводится к принудительному завершению процессов. В критической ситуации важно быстро сориентироваться и найти тот корневой процесс, завершение которого разрешит ситуацию. При недостатке информации часто приходится без разбора завершать множество процессов. В случае же использования запросов, подобных рассмотренному, можно с большей точностью определить и устранить источник блокировки, позволив остальным процессам продолжить работу.
Резюме
Статистика клиентской активности позволяет понять, что происходит в СУБД.
СУБД предоставляет три важных источника данных о клиентской активности: представления
pg_stat_activity,pg_locksиpg_stat_database.И администраторы БД, и инструменты мониторинга получают данные из представлений с помощью SQL-запросов.
Клиентский сеанс в процессе существования может пребывать в разных состояниях.
Транзакционная активность помогает быстро оценить нагрузку в кластере баз данных.
Важно вовремя отслеживать и устранять опасные ожидания и блокировки.
Следует устранять или минимизировать нахождение транзакций в бездействующем состоянии.
Продолжительность клиентской активности прямо влияет на производительность.
Ожидание блокировок снижает производительность СУБД и приложений.
Дерево блокировок позволяет быстро выявить источник блокировок.
postgrespro.ru/docs/postgresql/current/sql-select#SQL-FOR-UPDATE-SHARE ↩︎
postgrespro.ru/docs/postgresql/current/monitoring-stats#WAIT-EVENT-LOCK-TABLE ↩︎
postgrespro.ru/docs/postgresql/current/explicit-locking#LOCKING-TABLES ↩︎
github.com/lesovsky/pgscv/commit/d098923caef2d1a839df76ad9f441893640faed5 ↩︎
postgrespro.ru/docs/postgresql/current/monitoring-stats#MONITORING-PG-STAT-ACTIVITY-VIEW ↩︎
github.com/lesovsky/postgresql-monitoring-book/blob/main/playground/scripts/locktree.sql ↩︎