1 Обзор статистики
В этой главе мы рассмотрим:
внутреннее устройство PostgreSQL;
важность статистики активности;
особенности статистики активности.
В этой главе дается общее представление о статистике активности и о том, почему эта статистика так важна. На примере внутреннего устройства PostgreSQL объясняется необходимость статистики для понимания работы внутренних процессов в СУБД и эффективного наблюдения за ними. Статистика, которую мы будем рассматривать на протяжении всей книги, является фундаментом для построения большинства инструментов мониторинга PostgreSQL.
1.1. «Postgres — это сервис»
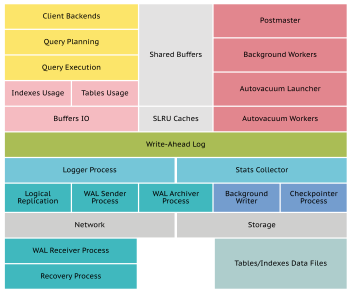
Первую главу я хотел бы начать так же, как обычно начинаю свои доклады про мониторинг PostgreSQL. СУБД PostgreSQL — это продукт с долгой историей. За все время существования в нее было добавлено множество функций, и, конечно, это отразилось на ее внутреннем устройстве, которое схематично изображено в моем вольном представлении на рис. 1.1. Из схемы видно, что СУБД состоит из множества компонентов. Мало того, эти компоненты связаны между собой и постоянно взаимодействуют друг с другом в процессе обработки данных.
Если все сильно упростить, то СУБД можно рассматривать как сервис, который предоставляет две основные услуги:
Надежное хранение данных. Пользователи и сервисы загружают в СУБД свои данные и задача СУБД — обеспечить их прием и сохранность.
Обеспечение доступа к данным. Пользователям и сервисам могут потребоваться данные и СУБД предоставляет язык запросов для работы с ними.
Основные услуги могут расширяться дополнительными:
разнообразие типов данных и гибкая организация схемы доступа;
быстрый доступ к данным за счет индексов;
- конкурентный транзакционный доступ к данным с гарантиями атомарности, согласованности и изоляции (эти свойства входят в известную аббревиатуру ACID1).
Для реализации этих и многих других услуг СУБД опирается на различные подсистемы и механизмы.
1.2. Внутреннее устройство PostgreSQL
Давайте поверхностно, с минимально необходимым погружением в детали, рассмотрим основные подсистемы СУБД и работу внутренних процессов при выполнении таких регулярных задач, как:
установка соединений и обслуживание сеансов;
планирование и выполнение запросов;
ввод-вывод при работе с данными;
журналирование изменений;
репликация и архивирование журнала транзакций;
фоновая синхронизация данных;
журнал сообщений;
автоочистка.
Установка соединений и работа сеансов
В своем обычном режиме СУБД работает как служба (программа-сервер) и ожидает подключений со стороны клиентов. Клиентом может быть как приложение, так и пользователь, подключающийся через клиентскую программу (psql, pgAdmin, DataGrip и др.). Для каждого клиента сервером СУБД создаются отдельные процессы операционной системы, которые в привычной для администраторов терминологии называются бэкендами (backend). В каждом таком процессе между клиентом и сервером СУБД устанавливается сеанс — двухсторонняя связь, позволяющая клиенту взаимодействовать с СУБД. В процессе создания сеанса СУБД выполняет аутентификацию клиента согласно указаниям в pg_hba.conf, инициализирует внутренние рабочие структуры и применяет различные настройки, влияющие на дальнейшую работу. Когда сеанс готов, клиент может отправлять серверу команды, включающие в себя как команды SQL, так и системные управляющие команды2.
При эксплуатации СУБД важно иметь представление о подключенных клиентах, установленных сеансах и том, что происходит в этих сеансах. Поведение клиента и состояние сеанса в некоторых обстоятельствах могут негативно влиять на работу и производительность СУБД.
Запросы как базовая единица рабочей нагрузки
Запросы являются подмножеством команд и представляют собой базовую единицу рабочей нагрузки. Рабочую нагрузку можно представить как весь объем запросов, отправляемый всеми приложениями и выполняемый на стороне СУБД. Чтобы справляться с рабочей нагрузкой, серверу требуются ресурсы, такие как CPU, память, ввод-вывод и пространство на диске. В эксплуатации СУБД важно иметь точное представление о том, какие запросы исполняются СУБД и достаточно ли ресурсов для их эффективного выполнения. Статистика дает ответ на этот вопрос и предоставляет отправную точку для оптимизации запросов и производительности.
Планирование и выполнение запросов
Получив команду от клиента, сервер проверяет ее корректность. Чаще всего командой является SQL-запрос; в таком случае СУБД начинает его планирование. Планирование заключается в составлении оптимального плана для доступа к данным. Доступ и промежуточная обработка данных могут стоить по-разному (в смысле использования системных ресурсов), и задача планирования сводится к составлению и выбору наиболее дешевого плана. План обычно принято представлять в виде графа, где каждый узел является вполне конкретной операцией над данными.
СУБД способна планировать параллельное выполнение некоторых операций, например чтение из таблицы или индекса. Если планом предполагается параллельное выполнение, для этого будут автоматически запущены вспомогательные процессы (background workers), которые возьмут на себя часть работы. После выполнения операции вспомогательные процессы также автоматически будут завершены.
Когда план выбран, сервер приступает к выполнению запроса согласно этому плану. Каждый узел плана — это конкретная операция над данными (например, над строками из таблиц). Когда запрос выполнен, результат возвращается клиенту. В качестве результата может выступать набор строк или тег команды (command tag), сообщающий об успешности выполнения. В случае запросов на изменение данных результат запроса должен быть записан в журнале транзакций (Write-Ahead Log, WAL). В зависимости от настроек СУБД это может происходить в синхронном или асинхронном режиме. В любом случае после выполнения запроса СУБД передает управление клиенту, и он может отправлять следующий запрос.
Ввод-вывод при выполнении запросов
При выполнении запросов практически вся работа с данными является буферизованной и происходит в памяти, выделенной процессам системой. Вся память, выделяемая СУБД, представляет собой набор сегментов, которые с точки зрения использования самой СУБД можно разделить на два типа областей памяти — локальные и общие.
Локальные области памяти — это сегменты, которые выделяются индивидуально для каждого процесса (в рамках сеанса), при этом процессы не имеют доступа к локальным сегментам друг друга. Среди таких сегментов можно выделить следующие характерные области:
рабочая память процессов (см. параметр work_mem) — выделяется при необходимости для оперативного размещения данных при выполнении некоторых промежуточных операций в запросе (сортировка, исключение дубликатов (
DISTINCT), соединение таблиц по алгоритмам merge join и hash join и др.). Если для выполнения операции рабочей памяти становится недостаточно, на диске создаются временные файлы, которые удаляются после завершения операции;временные буферы (см. параметр temp_buffers) — используются для работы с данными временных таблиц (temporary tables), которые существуют в рамках сеанса или вообще транзакции. Такие таблицы являются нежурналируемыми и часто применяются для сохранения промежуточных результатов;
рабочая память для операций обслуживания (см. параметр maintenance_work_mem) — выделяется для таких операций, как
VACUUM,CREATE INDEX,REINDEXи др. Фоновые процессы автоочистки используют собственную отдельную рабочую память (см. параметр autovacuum_work_mem).
Параметры конфигурации СУБД
В этой и следующих главах часто будут встречаться параметры конфигурации. Полный список всех параметров доступен в документации по адресу: postgrespro.ru/docs/postgresql/current/runtime-config.
Общая память (shared memory) — это один и, как правило, достаточно большой сегмент памяти, который выделяется один раз при запуске СУБД. Доступ к общей памяти имеют все процессы СУБД. В области общей памяти размещаются:
буферный кеш для страниц таблиц и индексов;
буферы WAL-журнала;
данные журнала, который хранит состояние всех транзакций (commit log) и используется правилами видимости многоверсионного управления конкурентным доступом;
служебные структуры для управления доступом (тяжелые и легкие блокировки, семафоры и т. п.);
служебные структуры транзакций, необходимые для точек сохранений (savepoint)3 и двухфазного подтверждения (two-phase commit)4, при котором становится возможным успешное подтверждение даже в случае аварийного сбоя, предшествующего подтверждению;
служебные структуры фоновых служб;
серверная статистика;
и многое другое.
Буферный кеш
Здесь и далее под термином «буферный кеш» мы будем называть именно общий буферный кеш, известный как shared buffers. В контексте повествования, где упоминаются локальные буферные кеши, это отмечено отдельно.
Кроме основной общей памяти, также могут создаваться и небольшие сегменты общей памяти для взаимодействия вспомогательных процессов в случае параллельного выполнения некоторых операций. Существование таких сегментов ограничено временем жизни вспомогательных процессов, а размер зависит от объемов передаваемых данных.
Работа с пользовательскими данными происходит примерно одинаково независимо от типа области данных, локального или общего. СУБД использует страничную организацию данных со страницами (page) фиксированного размера (8 КБ по умолчанию), что определяет минимальный объем ввода-вывода. В случае операций чтения или изменения данных процесс проверяет наличие необходимых данных в буфере, неважно, в локальном или общем. Если они есть, это считается успешной попыткой доступа (hit). Если данных в кеше не нашлось, то для продолжения работы их требуется загрузить с диска в кеш; это считается промахом кеша (miss, или read). Если к данным обращались ранее, они могут оказаться в страничном кеше операционной системы (page cache), откуда взять их будет быстрее, чем прочитать из основного хранилища. В случае обновления (INSERT, UPDATE, DELETE) страницы изменяются в кеше; такие страницы считаются грязными (dirtied), что указывает на необходимость их синхронизации с файлом данных в основном хранилище. Обычно синхронизацией страниц занимаются два фоновых процесса — checkpointer и background writer, но в некоторых случаях это может делать и клиентский процесс. Так бывает, когда процессу требуются страницы, которых нет в кеше, и, чтобы прочитать их с диска, процессу нужны свободные буферы, которых тоже нет. Чтобы освободить буфер под целевую страницу, процесс начинает поиск и вытеснение страницы, к которой давно не было обращений. Найденная страница может оказаться грязной, и тогда процесс сначала синхронизирует ее (written) и только потом освобождает буфер. В общем, получается не самая дешевая операция, особенно если приходится делать это часто.
Всего получаются четыре возможных случая:
hit — наиболее быстрая и дешевая, но все-таки не бесплатная операция: страница находится в общей памяти;
miss, или read — более дорогая операция: страницу необходимо прочитать в лучшем случае из страничного кеша, а в худшем — с диска;
dirtied — также дорогая операция: страницу впоследствии нужно будет синхронизировать с основным хранилищем;
written — еще одна дорогая операция: вместо отложенной фоновой синхронизации страница должна быть синхронизирована немедленно клиентским процессом (который выполняет запрос).
Описанная выше модель работы одинакова как для общего, так и для локального кеша. При работе с обычными и временными таблицами страницы в кеше всегда ассоциированы с файлом таблицы на диске. В случае использования рабочей памяти такого файла нет ровно до тех пор, пока не будет превышено ее ограничение (параметр work_mem). В этом случае создается временный файл, который удаляется после завершения операции. При нехватке рабочей памяти для операций обслуживания (автоочистка, создание индексов) СУБД повторно использует уже выделенную память без создания дополнительных файлов.
С точки зрения производительности очень хорошо, когда бóльшая часть данных находится в памяти и на любое обращение страницу можно найти в кеше, и хуже, когда приходится регулярно читать данные из основного хранилища или же вытеснять грязные страницы для освобождения буферов под новые страницы.
Журнал упреждающей записи — Write-Ahead Log
Перед тем как вернуть результат запроса, направленного на изменение данных, СУБД записывает эти изменения в журнал предзаписи (Write-Ahead Log). Еще можно встретить термин журнал транзакций, однако чаще всего просто используется аббревиатура WAL. Запись в журнал требуется для обеспечения надежности и сохранения порядка всех изменений над данными и возможности восстановления после аварийного завершения СУБД. В таком случае при последующем запуске СУБД, используя журнал, воспроизведет последовательность изменений над теми данными, которые не были сброшены из буферного кеша в основное хранилище. Производительность СУБД зависит в том числе и от скорости работы с WAL-журналом, которую можно узнать с помощью статистики.
Журнал сообщений СУБД
После того как команда завершилась, клиенту передается результат выполнения, будь то набор строк, тег или вообще ошибка. Здесь может выполняться протоколирование, то есть сохранение служебной информации о выполнении команды. Эта информация может включать в себя данные о клиенте, текст и параметры запроса и т. п. Протоколирование дополняет статистику и также является важным источником информации о работе СУБД. Далее сервер готов к получению и выполнению следующей команды.
Репликация изменений
Помимо основной работы с клиентами, СУБД выполняет ряд служебных задач. Для этого существуют отдельные процессы, которые работают в фоновом режиме. Одной из таких задач является физическая репликация, которая построена на основе журнала упреждающей записи. Все изменения данных, которые попадают в журнал, читаются процессом walsender и по протоколу репликации передаются на реплики. На репликах процессы walreceiver принимают данные журнала и сохраняют содержимое на диск. Другой фоновый процесс — startup — читает полученные данные журнала и воспроизводит последовательность изменений на локальной копии данных. После этого изменения, пришедшие с основного сервера, становятся видимыми для запросов, выполняющихся на реплике.
Кроме физической репликации, PostgreSQL поддерживает и логическую. Физическая репликация предполагает передачу и применение всех изменений, в то время как логическая позволяет выборочно передавать данные на уровне отдельных таблиц и даже операций. Использование репликации может преследовать разные цели, например распределение рабочей нагрузки или отказоустойчивость и быстрое переключение при сбоях. Поэтому важно отслеживать состояние всех узлов, и в этом снова нам помогает статистика.
Архивирование журнала предзаписи
Похожей на репликацию является задача архивирования WAL-журнала. С точки зрения операционной системы WAL-журнал — это всего лишь последовательность файлов, называемых WAL-сегментами. Как только запись в очередной WAL-сегмент завершена, специальный процесс archiver может поместить этот сегмент в архив. Под архивом подразумевается отдельное от СУБД хранилище, которое используется для задач резервного копирования и аварийного восстановления.
Фоновая синхронизация данных
Есть и другие фоновые задачи. Одна из них — это синхронизация измененных данных из буферного кеша с основным хранилищем. Для этого задействованы два процесса: background writer и checkpointer. Первый в непрерывном цикле ищет грязные страницы и записывает их на диск. Второй, checkpointer, выполняет контрольные точки. Контрольная точка — это отметка в WAL-журнале, которая указывает на то, что все изменения до этой отметки уже записаны в надежное хранилище. При выполнении контрольной точки процесс checkpointer записывает все грязные данные в отличие от background writer, который делает это выборочно. Другими словами, checkpointer, так же как и background writer, синхронизирует изменения из буферного кеша с диском, но дополнительно ставит особую отметку в WAL-журнале о том, что синхронизированы все грязные данные.
Поскольку журнал предзаписи — это история всех изменений, возникает вопрос: как долго следует хранить эту историю? Ответ дает процесс checkpointer: установка контрольной точки означает, что все предыдущие изменения надежно записаны в основное хранилище и все сегменты журнала, предшествующие этой контрольной точке, могут быть удалены. Таким образом, объем журнала предзаписи сохраняется более или менее постоянным и WAL-сегменты не накапливаются.
Автоочистка
Еще одной регулярной фоновой задачей является очистка таблиц и индексов от устаревших версий строк, так называемая автоочистка (autovacuum). Необходимость автоочистки является следствием реализации операций обновления данных и конкурентного доступа к ним. При изменении данных и конкурентной работе нескольких клиентов в таблицах могут возникать несколько версий одних и тех же строк. Со временем самые старые версии строки становятся неактуальными и могут быть удалены. Их удалением и занимается процесс автоочистки. Фоновый процесс autovacuum launcher с определенной периодичностью (см. autovacuum_naptime) запускает рабочие процессы autovacuum worker, которые выполняют очистку. Дополнительно рабочие процессы могут собирать статистику для планировщика о качественных и количественных характеристиках данных в таблицах. Эта статистика нужна для построения планов запросов. Неэффективная работа автоочистки в перспективе негативно влияет на производительность, и с помощью статистики активности можно наблюдать за работой не только очистки, но и других фоновых процессов.
Подводя итог, можно сказать, что в PostgreSQL есть много сложных процессов, которые влияют друг на друга и связаны между собой. При возникновении проблем администратору БД нужна информация о том, как работают те или иные процессы. Для отслеживания различных событий СУБД имеет внутренние инструменты, которые ведут учет и хранят статистику в специальной области в общей памяти. До версии PostgreSQL 15 получением и хранением статистики занимался отдельный процесс stats collector. Статистика передавалась ему бэкендами по протоколу UDP, и затем она сохранялась на диск. С версии 15 статистика сохраняется сразу в общей памяти5 и необходимость в отдельном процессе отпала. На протяжении всей книги мы будем использовать эту статистическую информацию для понимания работы СУБД, идентификации и устранения проблем.
1.3. Интерфейс статистики
Подсистема сбора статистики накапливает различную информацию, которая может понадобиться при устранении проблем. Чтобы воспользоваться этой информацией, достаточно иметь под рукой любой SQL-клиент, который поддерживает подключение к PostgreSQL. В качестве примера можно привести psql — это официальный клиент для PostgreSQL. Также можно использовать клиенты, которые являются частью продвинутых инструментов с расширенным набором функций для работы с СУБД. Примерами таких инструментов являются pgAdmin, DBeaver или DataGrip.
Вся статистика представлена в виде служебных данных СУБД, и для доступа к ней не нужно предпринимать дополнительных действий. Получить статистику можно с помощью служебных функций. Однако пользоваться ими не всегда удобно, поэтому получение статистики из функций организовано через системные представления (view), к которым можно выполнять SQL-запросы. Такие представления аналогичны таблицам, но не имеют физического слоя хранения данных, и при работе с ними пользователю доступны почти все (кроме записи) возможности языка SQL: соединения, агрегации, оконные функции, подзапросы и т. д.
Со временем при работе со статистикой у пользователя могут появиться «любимые» запросы, которые расширены дополнительной логикой, — в одном запросе может использоваться несколько представлений, возможно, в сочетании с функциями, результаты могут преобразовываться и форматироваться. С помощью SQL такие запросы можно оформить в отдельные представления. В дальнейшем это избавляет от необходимости искать или вспоминать текст запроса, писать его заново: достаточно лишь сделать запрос к представлению и получить готовый результат.
Одной из сильных сторон PostgreSQL является возможность создания расширений (extensions), специальных модулей, устанавливаемых в СУБД с целью добавления новой функциональности, без необходимости изменения основного исходного кода системы. Используя этот механизм, разработчики могут создать недостающую функциональность, а пользователи — относительно легко подключить ее и использовать. Часть статистики распространяется в виде расширений. Можно подключить эти расширения и дополнить статистику новыми данными. В некоторых главах мы будем также рассматривать статистику, поставляемую через расширения, что будет отмечено отдельно.
1.4. Статистика как отправная точка инструментов мониторинга
Статистика, поставляемая в виде функций и представлений, является прочным фундаментом, на основе которого можно строить более продвинутые инструменты для мониторинга и наблюдения за СУБД. Самый простой вариант — это такие же представления с расширенной статистикой, отформатированные для более удобного восприятия человеком. Примерами могут служить различные репозитории с SQL-скриптами6. Более сложные варианты могут встраивать в себя клиентское подключение к PostgreSQL и обеспечивать сбор, обработку, передачу и предоставление информации. По сути, это реализовано практически во всех агентах мониторинга и утилитах для администраторов БД. Задача таких агентов сводится к подключению к СУБД, снятию информации с помощью заготовленных запросов и отправке ее в систему мониторинга или отображению в собственном пользовательском интерфейсе. Пользователю лишь остается запустить агента и указать реквизиты подключения к СУБД (и, возможно, дополнительные параметры работы, специфичные для агента). Примерами таких инструментов являются pgAdmin, pgcenter, pg_activity, pgstats7.
1.5. Особенности статистики
Простота интерфейса статистики влечет за собой и некоторые особенности. Одна из основных — это порог вхождения. Для использования статистики необходимо знание языка SQL на базовом уровне, чтобы делать простейшие SELECT-запросы. Для более сложных приемов, например для извлечения статистики из нескольких представлений, потребуется использование соединений, подзапросов и более продвинутых возможностей SQL. Другая особенность — это большой набор представлений и функций, что может вызвать сложности в запоминании имен представлений и их содержимого. Особенно сложно вспоминать имена и названия в аварийной ситуации, когда счет может идти на секунды. Также работа со статистикой усложняется тем, что пользователь должен работать в командном режиме: следует написать и отправить запрос, получить и проанализировать результат, при необходимости повторить. Обычно этот недостаток компенсируют организацией репозитория с набором скриптов, которые всегда под рукой или заранее установлены в БД.
Помимо psql PostgreSQL не предоставляет собственного продвинутого инструмента для работы со статистикой и представлениями. Его отсутствие является причиной появления множества сторонних инструментов работы со статистикой для администраторов БД. У каждого автора есть свое видение того, как следует отображать статистику, что и приводит к большому разнообразию среди инструментов и функциональности.
Отдельной особенностью и даже недостатком является отсутствие статистики по журналам сообщений. Чтобы работать с журналами, пользователю необходимо иметь к ним доступ. Чаще всего это файлы в операционной системе, где запущена СУБД. Некоторые расширения пытаются решить эту проблему, но, к сожалению, они не имеют официальной поддержки разработчиков PostgreSQL, что уменьшает их распространенность и усложняет использование.
1.6. Тестовое окружение
В приложении приведены описание и инструкция по развертыванию тестового окружения. Тестовое окружение используется на протяжении всей книги для практических задач и примеров. На основе тестового окружения будет демонстрироваться использование статистики и будут объясняться важные особенности. Тестовое окружение также будет полезно любознательным читателям, желающим поэкспериментировать, усвоить материал книги на практике и выйти за рамки основного повествования. При желании установку тестового окружения можно пропустить без значительного ущерба для понимания материала.
Резюме
PostgreSQL — это сложное по внутреннему устройству ПО, состоящее из разных подсистем.
При эксплуатации всегда есть риск возникновения различных проблем.
Статистика активности позволяет отслеживать работу СУБД и дает администратору возможность упреждать проблемы.
Статистика доступна с помощью SQL-функций и представлений.
Для работы со статистикой потребуется знание языка SQL.
Минималистичный интерфейс статистики является причиной многообразия инструментов для администраторов БД.
Для рассмотрения практических аспектов статистики можно воспользоваться тестовым окружением.