PostgreSQL 监控
PostgreSQL 监控
Алексей Лесовский(Alexey Lesovsky)
Москва · Бумба · 2024
ISBN 978-5-907754-42-3
本地简体中文译稿已按原书顺序完成初翻、校对与精校,并接入完整书籍页面。本译稿是本地工作成果,不是出版社发行的中文版。
目录
插图
- 图 1.1 — PostgreSQL 数据库管理系统的内部结构
- 图 2.1 — 客户端总数
- 图 2.2 — 按连接地址统计的客户端数量
- 图 2.3 — 按用户名统计的客户端数量
- 图 2.4 — 连接到各数据库的数量
- 图 2.5 — 事务活动:每秒事务数
- 图 2.6 — 按数据库统计的每分钟会话建立频率
- 图 2.7 — 按状态分组的每分钟会话建立频率
- 图 2.8 — 按状态划分的客户端数量
- 图 2.9 — 事务执行时长
- 图 2.10 — 锁等待时长
- 图 3.1 — 查询规划时间
- 图 3.2 — 当前性能
- 图 3.3 — 调用最频繁的查询
- 图 3.4 — 影响行数最多的查询
- 图 3.5 — 执行耗时最多的查询
- 图 3.6 — I/O 耗时最多的查询
- 图 3.7 — 清空页缓存后的 I/O 时间
- 图 3.8 — 执行耗时最多的函数
- 图 4.1 — 受影响行(fetched、returned)的变化趋势
- 图 4.2 — 插入、更新和删除行的变化趋势
- 图 4.3 — 顺序访问
- 图 4.4 — 更新行数最多的表
- 图 4.5 — 插入行数最多的表
- 图 4.6 — 错误和不良事件
- 图 4.7 — 大小最大的表
- 图 4.8 — 大小变化最大的表
- 图 4.9 — 大小变化最大的表(包含当前大小)
- 图 5.1 — 共享缓存中的缓冲区使用情况
- 图 5.2 — 读取和写入块所耗费的时间
- 图 5.3 — 各表的读取量
- 图 5.4 — pgbench_history 表的读取量
- 图 5.5 — pgbench_accounts 表的输入/输出量
- 图 5.6 — postgres 数据库中的临时文件
- 图 5.7 — 检查点执行情况
- 图 5.8 — 检查点执行时长
- 图 5.9 — 不同进程写入的缓冲区数量
- 图 6.1 — 写入日志的普通记录和 FPI 页面的数量
- 图 6.2 — 日志写入量(字节)
- 图 6.3 — 从 WAL 缓冲区写入的操作次数、段同步次数和已提交事务数
- 图 6.4 — 日志写入和段同步所耗费的时间
- 图 6.5 — 日志写入量较大的查询
- 图 6.6 — 日志段归档的成功与失败尝试
- 图 6.7 — 距离上次成功归档日志段的时间
- 图 6.8 — 归档队列(字节)
- 图 7.1 — 副本的字节滞后
- 图 7.2 — 副本的秒级滞后
- 图 7.3 — 复制槽保留的日志量
- 图 8.1 — 清理和分析操作的执行频率
- 图 8.2 — 可用事务 ID 的数量
- 图 8.3 — 执行清理的进程数量
- 图 8.4 — 清理操作的执行时长
关于本译稿
本译稿根据 Алексей Лесовский 的俄文原版《Мониторинг PostgreSQL》(2024)翻译。译文保留原书章节顺序、正文、示例、插图、脚注、索引、版本说明与版权信息。
© ООО «ППГ», текст, оформление, 2024. © ООО «Бумба», издание, 2024. 原书版权声明见出版信息;俄文原版见俄文站点。
扉页与版权信息
Алексей Лесовский
PostgreSQL 监控
Москва
2024
УДК 004.65
ББК 32.972.134
Л50
Лесовский А. B.
Л50 PostgreSQL 监控 / А. B. Лесовский。— М.:Бумба,2024。— 247 页。
ISBN 978-5-907754-42-3
PostgreSQL 监控是管理员工作的重要组成部分,有助于回答许多与性能相关的问题。本书全面介绍了这一广泛主题,将工具参考资料、工具使用的实践方法以及对所得数据的解读方式融为一体。通过本书了解 PostgreSQL 的内部结构及监控特点,从长远来看,有助于更有效地运维数据库管理系统,并成功处理工作中遇到的任务。
适合数据库管理员、系统管理员和可靠性工程师阅读。
本书网站:github.com/lesovsky/postgresql-monitoring-book。
УДК 004.65
ББК 32.972.134
版权所有。未经 ООО «ППГ» 书面许可,不得以任何形式或任何手段复制本书的任何部分。
ISBN 978-5-907754-42-3
© ООО «ППГ», текст, оформление, 2024
© ООО «Бумба», издание, 2024
简目与目录
简目
- 前言 — 7
- 关于本书 — 9
- 第 1 章 统计信息概览 — 15
- 第 2 章 活动统计信息 — 27
- 第 3 章 查询与函数的执行 — 71
- 第 4 章 数据库 — 99
- 第 5 章 共享内存与输入/输出 — 129
- 第 6 章 预写式日志 — 157
- 第 7 章 复制 — 173
- 第 8 章 清理 — 195
- 第 9 章 操作进度 — 221
- 附录:测试环境 — 235
- 主题索引 — 239
目录
前言
我偶然走上了 PostgreSQL 管理这条路。那时,我在叶卡捷琳堡一家公司的 Web 开发部门担任系统管理员,负责维护几个重要的 Ruby on Rails Web 项目。这些项目使用了许多复杂而有趣的技术,其中就包括 PostgreSQL。
在那家公司工作期间,我很少需要深入了解数据库管理系统的运行细节。我遇到的第一个重要任务,是在系统承受负载、应用不能停机的情况下,把数据库管理系统从 9.0 升级到 9.2。当时我经常在博客中记录自己的技术实践,这项任务完成后,我也写了一篇文章。
过了一段时间,我到了另一家公司工作,那里的数据库服务器由一家承包公司单独维护。不过,凭借此前积累的 PostgreSQL 使用经验,我会主动承担一部分工作,自己完成一些任务。后来,这家承包公司邀请我加入他们;我也从系统管理员转为数据库管理员。从那以后,我的每个工作日都与 PostgreSQL 相关。
我的另一项优势是熟悉 Linux 操作系统。这些知识对我后来深入学习 PostgreSQL 很有帮助。我一直对监控很感兴趣,也一直喜欢观察系统的运行方式。成为数据库管理员后,我的观察兴趣转向了 PostgreSQL,并开始研究如何跟踪数据库管理系统的运行特征。最终,我创建了各种各样的工具,从简单的 SQL 脚本,到监控系统插件和命令行工具。还有数不清的博客文章。它们通常彼此没有关联,只是因为共同的监控主题而联系在一起。意识到博客文章难以长久保存,而且散落在互联网上,我希望把它们整合成一份完整材料。于是,我产生了写书的想法。
写这本书的一年半时间里,我分析了自己的经验,做了大量实验,进行归纳,并把许多材料汇集到一处。不过,PostgreSQL 也没有停下脚步,而是在持续发展。数据库管理系统不断出现新的监控手段,例如,每次发布新版本后,我都不得不补充已经写好的章节。
最终,这本书把工具参考资料、工具使用的实践方法和解读所得数据的方式结合在了一起。所有这些知识,都是多年 PostgreSQL 运维实践中积累的经验浓缩而成的。如果你学会监控 PostgreSQL,就能更深入地理解它的运行方式和内部发生的过程,也能提高数据库管理、问题定位与解决以及性能优化方面的能力。
对于负责 PostgreSQL 运维的专业人员来说,了解数据库管理系统提供的工具,掌握工具的使用方法并理解其应用细节,会很有帮助。如今,数据库管理系统的性能优化是大型系统运维中最重要的任务之一,而监控知识和技能能够帮助我们成功完成这项任务。
对于那些有足够时间和意愿去搜索、筛选并理解信息的人来说,网络上有大量可用资料。阅读新文章、了解以前不知道的细节,是一件很愉快的事。尤其是关注 commitfest.postgresql.org 的变化,阅读提交消息,在正式发布之前就尽早了解数据库管理系统中即将出现的新特性,更是如此。不过,监控主题十分广泛,只有书籍这种容量和深度,才能让我完整解释 PostgreSQL 监控,涉及与之相关的主题;如果某些内容引起了你的兴趣,也能提供继续学习的链接。希望我在这本书中实现了自己的目标。
关于本书
我写这本书,是为了通过易于理解的真实示例,解释 PostgreSQL 监控在实践中是如何工作的。PostgreSQL 官方文档中关于内置观察和监控工具的内容通常写得比较简略,因此本书的目标是通过每位数据库管理员都能理解的示例,解释其中的各种细节。
谁应该读这本书?
本书面向数据库管理员、系统管理员、可靠性工程师,以及所有对 PostgreSQL 管理感兴趣的人。本书试图涵盖监控主题的所有细节。博客中有许多相关文章,但大多数只会深入讨论其中的某个方面。本书全面介绍 PostgreSQL 监控,帮助读者了解数据库管理系统内置的大量工具。几乎所有监控的目标,都是发现异常、预防事故并预测系统未来的行为。借助监控,我们可以更好地理解系统的工作方式,然后通过调整配置和优化工作负载来提高性能。因此,任何关注性能优化的人都一定能从本书中获得有用信息,不仅能得出自己的结论,还可能为所管理系统的改动制定计划,并取得有价值的结果。
本书的组织方式
本书由九章组成。
第 1 章概括介绍数据库管理系统的活动统计信息是什么、为什么它如此重要,以及它为什么是 PostgreSQL 监控的基础。这是一章介绍理论基础的入门章节。
第 2 章讨论描述数据库管理系统内部进程和事件的统计信息,这些进程和事件由工作负载执行以及服务客户端所触发。
第 3 章详细讨论客户端会话,并分析应用程序产生的工作负载。
第 4 章从数据库管理系统对象及其相关事件的交互角度介绍活动统计信息。
第 5 章讨论共享内存与输入/输出,即数据在不同子系统之间移动的过程。
第 6 章讨论预写式日志及其相关统计信息。
第 7 章讨论复制、使用复制时可能遇到的问题,以及跟踪复制状态的工具。
第 8 章讨论数据库清理过程,每个 PostgreSQL 管理员都曾接触过这个过程。
第 9 章介绍跟踪长时间运行操作进度的工具,这些操作在数据库管理系统运维过程中需要定期执行。
读完本书,读者将清楚了解 PostgreSQL 监控、数据库管理系统中可用于监控的工具,以及如何最有效地使用这些工具。本书还将帮助读者了解如何查找和解决 PostgreSQL 运维相关的问题。
本书面向的读者
本书面向具备高于入门水平知识的读者。为了控制篇幅,书中省略了某些次要内容的详细说明,希望读者已经熟悉这些内容,或者能够通过搜索引擎或 ChatGPT 找到答案。假定读者具备以下知识或技能:
了解数据库管理系统的基本结构,例如,大致知道 ACID 缩写中的每个字母代表什么,并且知道事务与查询的区别;
掌握 SQL 语言的基本用法,能够不查阅文档编写带有条件、连接或子查询的简单 SELECT 查询;能够阅读并理解“别人写的”查询;
具备 PostgreSQL 方面的基础知识,并大致了解这一数据库管理系统的主要组件,例如缓冲区缓存(shared buffers)、预写式日志、复制等;如果读者读过 The Internals of PostgreSQL 一书,那就更好了;
至少掌握编写 PromQL/MetricsQL 查询的基本技能3,因为本书除了 SQL 查询外,还会使用 PromQL 和 MetricsQL 查询示例;
掌握 Grafana 的基本使用方法;最好能够基于 PromQL/MetricsQL 查询创建简单的图表面板,并能够编辑图例、度量单位、显示参数、颜色等;
掌握 Linux 操作系统的基本使用技能,例如在终端中工作、安装软件包和运行程序;
掌握 Docker 和 Docker Compose 工具的基本使用技能;最好能够启动和停止容器、连接容器并检查其状态。
代码示例
书中经常给出 SQL 和 PromQL/MetricsQL 语言的查询示例,有时也会给出需要在 shell 或 psql 客户端中执行的命令。为了把查询示例与普通文本区分开,查询使用等宽字体,命令使用粗体排版。配置参数名称使用斜体排版。
还有疑问?
你可以在下面的资料中寻找答案:
关于 PostgreSQL 内置监控工具的俄文官方文档主页:www.postgrespro.ru/docs/postgresql/current/monitoring。
关于 PostgreSQL 内置监控工具的英文官方文档主页:www.postgresql.org/docs/current/monitoring.html。
关于 PostgreSQL 各种监控工具的官方 Wiki 页面:wiki.postgresql.org/wiki/Monitoring。
反馈与建议
我很乐意听到读者的反馈。请告诉我你对本书的看法,哪些内容让你喜欢,哪些内容也许不尽如人意。反馈对我很重要,也会帮助我准备本书的更新。你可以在 github.com/lesovsky/postgresql-monitoring-book/issues 提交反馈或建议。发现错别字、需要修正不准确之处等情况时,也可以使用同一地址。
侵犯版权
互联网盗版(无论有意还是无意)仍然是一个紧迫的问题。如果你发现本书被非法发布,请把相关互联网资源的链接发给我,以便我联系其所有者。你可以在 github.com/lesovsky/postgresql-monitoring-book/issues 留下可疑材料的链接。
关于作者
Алексей Лесовский(Alexey Lesovsky)是一名专业数据库管理员、系统管理员、软件开发人员和 DevOps 工程师。他从事大型复杂系统的运维、软件设计与开发工作已有近 20 年。你可以在 GitHub 上通过 github.com/lesovsky 找到 Алексей Лесовский。
致敬
Танюша,这本书献给你。你不仅是我的妻子,更是最棒的人!我们是最好的搭档 ;)
Роман Алексеевич,请记住:孩子的任务,就是比父母更优秀。更快、更高、更强。你真棒,我为你骄傲!
Маруся,你是我的小珍珠。谢谢你的笑容、爽朗的笑声和好心情。你永远在我心里。
Андрей Фефелов,你是我坚韧不屈、意志坚定的榜样,能成为你的朋友是我的荣幸。
我把这本书献给所有亲人和挚友,献给家人和父母,感谢你们的支持与信任。感谢社区中的朋友和同事。感谢所有来听我演讲、在 YouTube 上观看我视频,以及在会场和评论区提出棘手问题的人。感谢会议组织者给我在现场发言的机会——那是令人难忘的经历。感谢读过我的博客文章并希望我写得更多、更勤的人。我写的不只是一篇文章。也谢谢你,读者,这一切都是为你而写。
特别感谢 Егор Рогов 在本书准备过程中给予的宝贵帮助。起初一切都很困难,在协调过程中,我经历了从否认到接受的各种情绪,但最终我对结果非常满意。希望我们今后还能再次合作。
1 统计信息概览
本章将介绍:
PostgreSQL 的内部结构;
活动统计信息的重要性;
活动统计信息的特点。
本章概括介绍活动统计信息,以及它为什么如此重要。我们将以 PostgreSQL 的内部结构为例,说明为什么需要统计信息来理解数据库管理系统(DBMS)内部进程的运行方式,并对这些进程进行有效监控。本书将一直讨论的统计信息,是构建大多数 PostgreSQL 监控工具的基础。
1.1. “Postgres 是一项服务”
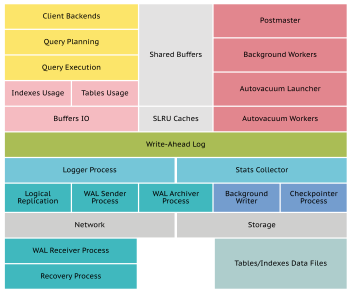
我想像平时开始 PostgreSQL 监控演讲那样,来开始第一章。PostgreSQL 数据库管理系统是一款历史悠久的产品。在它存在的整个过程中,人们为它加入了许多功能,这当然也反映在它的内部结构上。图 1.1 以我个人的粗略理解画出了这套结构。从图中可以看出,数据库管理系统由许多组件组成。不仅如此,这些组件彼此相连,并且在处理数据的过程中持续相互交互。
如果把问题大幅简化,数据库管理系统可以看成一种提供两项基本服务的服务程序:
可靠地存储数据。用户和服务会把数据加载到数据库管理系统中,而数据库管理系统的任务就是接收并保存这些数据。
提供数据访问。用户和服务可能需要读取数据,数据库管理系统则提供了用于处理这些数据的查询语言。
基本服务还可以扩展出一些附加服务:
多种数据类型,以及灵活组织访问模式的方式;
借助索引快速访问数据;
- 具有原子性、一致性和隔离性保证的并发事务数据访问(这些性质构成了著名的 ACID 缩写1)。
为了实现这些服务以及许多其他服务,数据库管理系统依赖各种子系统和机制。
1.2. PostgreSQL 的内部结构
下面让我们以尽可能少的细节,粗略了解数据库管理系统的主要子系统,以及执行以下常规任务时内部进程的工作方式:
建立连接并维护会话;
规划和执行查询;
处理数据时进行输入/输出;
记录变更;
复制并归档事务日志;
在后台同步数据;
记录服务器日志;
自动清理。
建立连接与会话运行
在通常模式下,数据库管理系统作为服务(服务器程序)运行,等待客户端连接。客户端可以是应用程序,也可以是通过客户端程序(psql、pgAdmin、DataGrip 等)连接的用户。数据库管理系统服务器会为每个客户端创建独立的操作系统进程;按照管理员熟悉的术语,这些进程称为后端进程(backend)。在每个这样的进程中,客户端与数据库管理系统服务器之间会建立一个会话,这是一条允许客户端与数据库管理系统交互的双向连接。建立会话时,数据库管理系统会根据 pg\_hba.conf 中的配置对客户端进行身份验证,初始化内部工作结构,并应用影响后续运行的各种设置。会话准备好后,客户端就可以向服务器发送命令,其中既可以是 SQL 命令,也可以是系统控制命令2。
在运维数据库管理系统时,了解已连接的客户端、已建立的会话以及这些会话中正在发生的事情非常重要。在某些情况下,客户端的行为和会话状态可能会对数据库管理系统的运行和性能产生负面影响。
查询是工作负载的基本单位
查询是命令的一个子集,也是工作负载的基本单位。可以把工作负载理解为所有应用程序发送、并在数据库管理系统一侧执行的全部查询。服务器要处理这些工作负载,需要 CPU、内存、输入/输出和磁盘空间等资源。在运维数据库管理系统时,准确了解数据库管理系统正在执行哪些查询,以及是否有足够资源高效执行这些查询,非常重要。统计信息可以回答这些问题,并为查询优化和性能优化提供起点。
查询规划与执行
服务器收到客户端命令后,会检查命令是否正确。最常见的命令是 SQL 查询;在这种情况下,数据库管理系统会开始对它进行规划。规划就是为访问数据制定最优计划。访问和中间数据处理的成本(也就是系统资源的使用量)可能各不相同,因此规划的任务,就是制定并选择成本最低的计划。通常会把计划表示成一张图,其中每个节点都是对数据执行的一项具体操作。
数据库管理系统能够规划某些操作的并行执行,例如从表或索引中读取数据。如果计划要求并行执行,系统会自动启动辅助进程(background workers),由它们承担一部分工作。操作完成后,辅助进程也会自动结束。
计划选定后,服务器便按照计划开始执行查询。计划中的每个节点都是一项具体的数据操作(例如对表中的行进行操作)。查询完成后,结果会返回给客户端。结果可以是一组行,也可以是表示执行成功的命令标签(command tag)。如果查询修改了数据,查询结果必须写入事务日志(Write-Ahead Log,WAL)。根据数据库管理系统的设置,这个过程可以同步进行,也可以异步进行。无论采用哪种模式,查询执行完成后,数据库管理系统都会把控制权交还给客户端,客户端可以发送下一个查询。
查询执行期间的输入/输出
执行查询时,几乎所有数据操作都经过缓冲,在系统为进程分配的内存中完成。数据库管理系统分配的所有内存都由若干段组成;从数据库管理系统自身的使用方式来看,可以将这些内存分成两类:本地内存和共享内存。
本地内存区域是为每个进程(在会话范围内)单独分配的内存段,各进程不能访问彼此的本地内存段。其中有以下几种典型区域:
进程工作内存(见参数 work_mem):在需要时为查询中的一些中间操作临时存放数据而分配,例如排序、去重(
DISTINCT)、使用 merge join 和 hash join 算法连接表等。如果工作内存不足以完成操作,系统会在磁盘上创建临时文件,并在操作结束后删除这些文件;临时缓冲区(见参数 temp_buffers):用于处理临时表(temporary tables)的数据。临时表的生命周期可以是整个会话,甚至只是一个事务。这类表不写入日志,常用于保存中间结果;
维护操作工作内存(见参数 maintenance_work_mem):为
VACUUM、CREATE INDEX、REINDEX等操作分配。自动清理后台进程使用自己单独的工作内存(见参数 autovacuum_work_mem)。
共享内存(shared memory)是一个通常规模相当大的内存段,在数据库管理系统启动时分配一次。数据库管理系统的所有进程都可以访问共享内存。共享内存中包含:
表和索引页的缓冲区缓存;
WAL 日志缓冲区;
保存所有事务状态的日志数据(事务提交状态日志,commit log),以及多版本并发控制的可见性规则所使用的数据;
用于管理访问的内部结构(重量级锁、轻量级锁、信号量等);
用于保存点(savepoint)3和两阶段提交(two-phase commit)4的事务内部结构。两阶段提交使事务即使在提交前发生灾难性故障,也有可能成功提交;
后台服务的内部结构;
服务器统计信息;
以及其他内容。
缓冲区缓存
本书在这里以及后文中所说的“缓冲区缓存”,特指称为 shared buffers 的共享缓冲区缓存。如果叙述中提到本地缓冲区缓存,会明确说明。
除了主要共享内存外,在某些操作并行执行时,还可能创建较小的共享内存段,供辅助进程相互通信。这些内存段的存在时间受辅助进程生命周期限制,其大小取决于需要传输的数据量。
无论数据区域是本地区域还是共享区域,处理用户数据的方式大致相同。数据库管理系统使用分页的数据组织方式,采用固定大小的页(page)(默认大小为 8 KB),这决定了输入/输出的最小单位。执行数据读取或修改操作时,进程会检查所需数据是否存在于缓冲区中,无论该缓冲区是本地的还是共享的。如果数据存在,这就算一次成功的访问(hit)。如果缓存中没有数据,就需要从磁盘把数据加载到缓存中才能继续工作,这称为缓存未命中(miss,也就是 read)。如果此前访问过这些数据,它们可能位于操作系统的页缓存(page cache)中,从那里取出数据会比从主存储读取更快。更新(INSERT、UPDATE、DELETE)时,缓存中的页会发生变化;这样的页称为脏页(dirtied),表示需要把它们同步到主存储中的数据文件。通常由两个后台进程——检查点进程(checkpointer)和后台写入进程(background writer)——负责同步页面,但某些情况下后端进程也可能执行这项工作。如果进程需要读取缓存中不存在的页面,而从磁盘读取这些页面又需要空闲缓冲区,但缓存中同样没有空闲缓冲区,就会出现这种情况。为了给目标页面腾出缓冲区,进程会开始搜索并淘汰长时间没有被访问的页面。找到的页面可能是脏页;这时进程必须先将它同步(written),然后才能释放缓冲区。总的来说,这不是一项成本很低的操作,尤其是在需要频繁执行时。
总共有四种可能情况:
hit:最快、成本最低,但仍然不是免费的操作,因为页面位于共享内存中;
miss,也就是 read:成本更高的操作,页面最好能从页缓存中读取,最差的情况则必须从磁盘读取;
dirtied:同样是成本较高的操作,因为页面随后还需要同步到主存储;
written:另一种成本较高的操作;页面不能等待后台延迟同步,而必须由后端进程(执行查询的进程)立即同步。
上述工作模型对共享缓存和本地缓存都适用。使用普通表和临时表时,缓存中的页面始终与磁盘上的表文件相关联。使用工作内存时,在工作内存的限制(参数 work_mem)尚未超出之前,并不存在这样的文件。超过限制后,系统会创建一个临时文件,并在操作完成后删除。维护操作(自动清理、创建索引)缺少工作内存时,数据库管理系统会重复使用已经分配的内存,而不会创建额外文件。
从性能角度看,绝大多数数据位于内存中、每次访问都能在缓存中找到页面,是非常理想的情况。如果经常需要从主存储读取数据,或者为了给新页面腾出缓冲区而淘汰脏页,情况就会更差。
预写式日志——Write-Ahead Log
在返回修改数据的查询结果之前,数据库管理系统会把这些变更写入预写式日志(Write-Ahead Log)。你还可能看到事务日志这一称呼,但更常用的是缩写 WAL。写入日志是为了保证可靠性,保存所有数据变更的顺序,并支持数据库管理系统异常终止后的恢复。数据库管理系统随后重新启动时,会使用日志重放那些尚未从缓冲区缓存刷入主存储的变更。数据库管理系统的性能也取决于 WAL 日志的处理速度,而这一速度可以通过统计信息了解。
数据库管理系统的服务器日志
命令执行结束后,客户端会收到执行结果,可以是一组行、一个标签,甚至是一条错误消息。系统还可以执行日志记录,即保存命令执行的内部信息。这些信息可能包括客户端信息、查询文本和参数等。日志记录补充了统计信息,也是了解数据库管理系统运行情况的重要信息来源。之后,服务器便准备好接收并执行下一条命令。
变更复制
除了处理客户端的主要工作外,数据库管理系统还会执行一些内部任务。为此,系统会运行若干独立进程,并在后台完成这些任务。其中一项任务是基于预写式日志实现的物理复制。所有进入日志的数据变更都会由 walsender 进程读取,并通过复制协议发送到副本。在副本上,walreceiver 进程接收日志数据并把内容保存到磁盘。另一个后台进程 startup 会读取收到的日志数据,并在本地数据副本上重放变更序列。这样,主服务器传来的变更就会对副本上执行的查询可见。
除了物理复制,PostgreSQL 还支持逻辑复制。物理复制会传输并应用所有变更,而逻辑复制则允许在单独的表甚至单独的操作层面选择性地传输数据。使用复制可以出于不同目的,例如分散工作负载,或者实现容错并在故障时快速切换。因此,跟踪所有节点的状态非常重要,而统计信息在这里同样能提供帮助。
预写式日志归档
与复制相似,WAL 日志也需要归档。从操作系统的角度看,WAL 日志只是一系列称为 WAL 段的文件。当一个 WAL 段完成写入后,专用的 archiver 进程可以把这个段放入归档。归档是一个与数据库管理系统分离的存储,用于备份和灾难恢复。
后台数据同步
系统还会执行其他后台任务。其中一项是把缓冲区缓存中已变更的数据同步到主存储。这里会用到两个进程:background writer 和 checkpointer。前者持续查找脏页并将它们写入磁盘;后者,即 checkpointer,负责执行检查点。检查点是 WAL 日志中的一个标记,表示在该标记之前的所有变更都已经写入可靠存储。执行检查点时,checkpointer 进程会写入所有脏数据,而 background writer 只会选择性地写入。换句话说,checkpointer 和 background writer 一样,会把缓冲区缓存中的变更同步到磁盘;除此之外,它还会在 WAL 日志中设置一个特殊标记,表示所有脏数据都已经同步。
既然预写式日志记录了所有变更,就会产生一个问题:这段历史应该保留多久?checkpointer 进程给出了答案:设置检查点意味着此前的所有变更都已可靠地写入主存储,早于该检查点的所有日志段都可以删除。因此,预写式日志的规模会大致保持稳定,WAL 段不会不断累积。
自动清理
另一项常规后台任务,是清理表和索引中过时的行版本,这个过程称为自动清理(autovacuum)。自动清理的必要性,源于数据更新操作及并发访问的实现方式。数据发生变更、多个客户端并发工作时,同一行可能在表中产生多个版本。随着时间推移,最老的行版本会失去效用,可以被删除。删除这些行版本的正是自动清理进程。后台进程 autovacuum launcher 按一定周期(见 autovacuum_naptime)启动 autovacuum worker 工作进程,由它们执行清理。此外,工作进程还可以为规划器收集表中数据质量和数量特征的统计信息。这些统计信息用于构建查询计划。自动清理工作不当,长远来看会对性能产生负面影响;借助活动统计信息,可以跟踪清理工作,也可以跟踪其他后台进程。
总结来说,PostgreSQL 中有许多复杂的进程,它们相互影响、彼此关联。发生问题时,数据库管理员需要了解相关进程是如何运行的。为了跟踪不同事件,数据库管理系统提供了内部工具,在共享内存中的一个特殊区域记录并保存统计信息。在 PostgreSQL 15 之前,统计信息由独立的 stats collector 进程收集并保存。后端进程通过 UDP 协议把统计信息传给它,然后由它把信息保存到磁盘。从版本 15 开始,统计信息会直接保存在共享内存中5,因此不再需要独立的进程。本书将始终利用这些统计信息来理解数据库管理系统的运行方式、识别问题并解决问题。
1.3. 统计信息接口
统计信息收集子系统会积累各种可能用于解决问题的信息。要使用这些信息,只需准备一个支持连接 PostgreSQL 的 SQL 客户端即可。psql 就是一个例子,它是 PostgreSQL 的官方客户端。也可以使用包含在高级工具中的客户端,这些工具为数据库管理系统提供了更多操作功能,例如 pgAdmin、DBeaver 或 DataGrip。
所有统计信息都以数据库管理系统的内部数据形式存在,访问它们不需要额外操作。可以通过内部函数获取统计信息。不过,直接使用函数并不总是方便,因此系统还通过系统视图(view)组织函数返回的统计信息,用户可以对这些视图执行 SQL 查询。这些视图与表类似,但没有实际的数据存储层;用户在操作它们时,几乎可以使用 SQL 的所有功能(写入除外),包括连接、聚合、窗口函数、子查询等。
随着时间推移,用户在处理统计信息时可能会形成一些“常用”查询,并在其中加入额外逻辑:一条查询可能使用多个视图,也可能结合函数;结果还可以被转换和格式化。可以使用 SQL 把这些查询定义为独立视图。以后就不必再查找、回忆或重新编写查询文本,只需查询这个视图即可获得准备好的结果。
PostgreSQL 的一个优势,是可以创建扩展(extensions),即安装到数据库管理系统中的特殊模块,用于增加新功能,而不需要修改系统的核心源代码。借助这一机制,开发人员可以补充缺少的功能,用户也可以相对轻松地安装并使用这些功能。有一部分统计信息就是以扩展形式发布的。安装这些扩展后,就可以用新的数据补充统计信息。后续章节还会讨论通过扩展提供的统计信息,届时会特别说明。
1.4. 统计信息是监控工具的起点
以函数和视图形式提供的统计信息,是构建更高级数据库管理系统监控和观察工具的坚实基础。最简单的做法,是使用同样的视图提供扩展后的统计信息,并以更便于人阅读的方式格式化。例如,各种 SQL 脚本仓库6就属于这一类。更复杂的工具可以内置 PostgreSQL 客户端连接,负责收集、处理、传输和提供信息。实际上,几乎所有监控代理和数据库管理员工具都采用了这种方式。这类代理的任务,就是连接数据库管理系统,使用预先准备好的查询获取信息,然后将信息发送到监控系统,或者在自己的用户界面中展示。用户只需启动代理,提供数据库管理系统的连接参数(以及代理可能需要的其他特定运行参数)。这类工具包括 pgAdmin、pgcenter、pg_activity 和 pgstats7。
1.5. 统计信息的特点
统计信息接口简单,但也因此带来了一些特点。其中一个主要特点是入门门槛。要使用统计信息,至少需要掌握 SQL 的基础知识,能够编写最简单的 SELECT 查询。要使用更复杂的方法,例如从多个视图中提取统计信息,则需要使用连接、子查询和更高级的 SQL 功能。另一个特点,是视图和函数数量很多,这可能使人难以记住视图的名称及其内容。在事故场景中,尤其难以想起这些名称,因为时间可能按秒计算。统计信息的使用方式还会带来另一个问题:用户必须以命令行方式工作,即编写并发送查询,取得并分析结果,必要时再重复这一过程。通常可以通过建立脚本仓库来弥补这一不足,把脚本随时放在手边,或者预先安装到数据库中。
除了 psql 之外,PostgreSQL 没有提供自己的高级工具来操作统计信息和视图。正因为缺少这样的工具,才出现了大量面向数据库管理员的第三方统计信息工具。每位作者都有自己展示统计信息的方式,这也导致工具和功能呈现出很大的多样性。
统计信息的另一个特点,甚至可以说是一个缺点,是没有关于服务器日志的统计信息。要处理日志,用户必须能够访问日志文件。它们通常位于运行数据库管理系统的操作系统中。某些扩展试图解决这个问题,但遗憾的是,它们没有得到 PostgreSQL 开发人员的官方支持,因此传播范围较小,使用起来也更复杂。
1.6. 测试环境
附录中给出了测试环境的说明和部署指南。全书的实践任务和示例都会使用这个测试环境。我们将以它为基础演示统计信息的使用方法,并解释重要特点。对于希望进行实验、把书中内容付诸实践并超越正文范围的好奇读者,测试环境也会很有帮助。如果愿意,也可以跳过测试环境的安装,这不会明显影响对书中内容的理解。
小结
PostgreSQL 的内部结构复杂,由不同的子系统组成。
在运维过程中,始终存在发生各种问题的风险。
活动统计信息能够跟踪数据库管理系统的运行,并让管理员有机会提前发现问题。
可以通过 SQL 函数和视图获取统计信息。
要使用统计信息,需要掌握 SQL 语言。
统计信息接口的极简特性,促成了面向数据库管理员的众多工具。
可以使用测试环境来研究统计信息的实践层面。
2 活动统计
本章将介绍:
客户端活动;
事务活动;
pg_stat_activity、pg_locks和pg_stat_database视图;客户端会话的主要状态;
等待与锁;
处于空闲状态的事务;
如何确定查询和事务的持续时间;
如何确定等待锁的时间;
锁树。
活动统计信息是理解数据库管理系统中正在发生什么的关键要素。从操作系统的角度看,数据库管理系统像一个黑盒。操作系统不了解数据库管理系统内部的用户、数据库、会话、事务等实体。活动统计信息可以让我们看到这个黑盒内部,从而更好地理解其中发生的事情。活动包括数据库管理系统中的各种进程,这些进程既可能由子系统之间的内部交互引起,也可能由服务外部客户端引起。本章将详细讨论客户端会话以及与之相关的所有内容:客户端与服务器的交互、会话建立、查询和事务执行、会话的主要状态,以及会话期间可能出现的异常场景,例如空闲事务和锁。跟踪数据库管理系统中各项活动的过程,是成功运维应用和数据库管理系统所需的一项重要技能。为此,我们将介绍主要的统计信息来源及其使用示例。
2.1. 理解数据库管理系统中正在发生什么的关键
我喜欢说,数据库管理系统是一项服务。人们常常把数据库管理系统看成内部规模庞大、结构复杂的东西,但也可以把它想象成一种小型且易于部署的微服务(这对 Web 开发人员来说十分熟悉)。从这个角度看,数据库管理系统的主要任务就是接收并处理客户端的查询。内部复杂组件之间的交互可以视为次要部分,因为它不需要客户端直接采取行动。在这个简化的模型中,只有客户端和服务器。客户端是一种程序:可以是 Go、Python 或 Ruby 应用,也可以是 Airflow 或 Celery 任务,还可以是开发人员喜欢的 IDE。总之,任何能够连接数据库管理系统并通过其协议与之通信的东西都可以充当客户端。服务器则是执行客户端命令的数据库管理系统。客户端产生的活动构成工作负载。数据库管理系统能够处理的工作负载量决定了它的吞吐量,进而决定整体性能。数据库管理系统中的活动可以被测量和分析;找出并消除异常后,就能提高数据库管理系统和应用的性能。
从管理角度分析活动时,重要的是获得有关已连接客户端的定量和定性信息,例如:
已建立多少个会话,以及这些会话从哪里建立;
会话以哪些用户身份、连接到哪些数据库建立;
会话处于哪些状态;
会话处于这些状态的时间有多长;
正在执行多少个查询,分别来自哪些用户和数据库;
查询执行了多长时间;
会话中具体执行的是什么查询。
关于数据库管理系统中发生了什么,管理员可能会提出各种各样的问题,具体取决于管理员的任务、掌握的信息,以及在排查和解决问题过程中提出的假设。这些问题不仅可能涉及客户端查询的处理,也可能涉及后台服务的工作。借助活动统计信息得到的答案,可以消除问题,或优化应用的工作方式,从而实现更可靠的运行和更高的性能。
2.2. 客户端与服务器的交互
为了更完整地理解活动是什么,让我们看看客户端与数据库管理系统如何相互交互。这种交互遵循经典的“客户端—服务器”模式。服务器持续在后台运行,等待客户端连接。客户端无论是应用还是用户,都会连接到服务器;连接成功后,客户端按照自身的内部逻辑或用户的意愿生成并向服务器发送命令,等待命令执行,接收响应并处理响应。
在 PostgreSQL 中,服务器由一个专用进程承担,这个进程按照历史习惯称为 postmaster。该进程负责监听各个接口上的客户端连接,创建会话,并启动用于维护数据库的后台进程。客户端连接时,postmaster 会创建一个新的子进程,在其中完成会话所需的配置和准备。会话准备好后,客户端就可以开始发送查询。
运行模式
根据客户端的实现方式,会话可以采用同步或异步运行模式。大多数实现使用同步模式:客户端发送命令,等待命令执行结果,在此期间不能发送其他命令。异步运行模式也是可能的,但其实现取决于驱动程序。例如,标准驱动程序 libpq 就提供了这种功能1。
下面从操作系统的角度,展示使用 ps 工具输出的数据库管理系统服务器进程。
这些进程以“父进程—子进程”树的形式输出。其中最主要的是 postmaster,它是其他所有进程的父进程。子进程中既有后台服务进程,也有客户端连接进程,这些进程通常称为后端进程(backend)。从操作系统角度观察数据库管理系统的运行,可以使用 top、htop 和 atop 等工具。借助这些工具,可以观察操作系统进程如何使用 CPU、内存、磁盘和网络输入/输出、磁盘空间等系统资源。还应注意 vmstat、dstat、nicstat、pidstat,以及属于 sysstat 软件包的 iostat;这些工具也有助于评估系统资源的使用情况。
在会话期间,客户端通过命令与服务器通信。SQL 查询是这类命令的一个特例,并且通常可以组织成事务。事务由多个查询组成,整体上应被视为一个逻辑操作。事务由 BEGIN 命令声明,结束时可以使用命令 COMMIT(END)或 ROLLBACK。事务是数据库管理系统的重要机制,使多个客户端能够并发工作。事务具有原子性、隔离性和一致性。原子性意味着,事务中的所有操作要么一起执行,要么全部不执行。如果事务出错或回滚,所有操作的结果都会被撤销,恢复到事务开始之前的状态。一致性也体现在这里:它规定,原子执行(或回滚)的事务会使数据库保持无矛盾且一致的状态。不使用 BEGIN 和 END 声明事务块而执行的单个查询,实际上也属于事务,只不过事务中只有一条命令。隔离性意味着,在事务提交之前,一个事务的结果对其他相邻事务不可见;具体情况还取决于所使用的隔离级别。要更完整地理解这一问题,可以阅读 Bruce Momjian 的演讲《MVCC Unmasked》2。
尽管事务具有隔离性,也不能认为事务彼此完全独立。并发工作意味着多个事务可能同时访问同一份数据(表中的行)。对于读操作,情况比较简单,因为并发读取几乎不会产生冲突3。写入则复杂一些:并发写入可能引起冲突,而这类操作必须被串行化,也就是排成严格的顺序。数据库对象的访问通过锁来串行化。锁机制可以限制或禁止对资源的并发访问。锁的工作方式对用户是透明的,在大多数情况下不需要用户显式操作。不过,有时多个客户端会同时尝试在同一资源上建立不兼容的锁。此时只有一个客户端能够建立锁,其他客户端会排成队列,必须等待锁被释放。
作为阶段性小结,可以得出这样的结论:并发访问的性质、事务属性、锁机制以及某些偶然因素共同作用,可能给数据库管理系统和应用带来不良后果。根据所运行数据库的重要程度,这些情况可能被视为事故,因为它们可能导致性能下降,甚至使查询停止执行。
数据库管理员的任务之一,就是跟踪这些情况、查明原因并加以预防。本章接下来将更详细地讨论这些情况。
2.3. 活动信息的来源
我们将从 pg_stat_activity、pg_locks 和 pg_stat_database 视图开始。从历史角度看,活动展示能力是逐步发展起来的,最终形成了今天的样子。在早期版本中,这三个视图包含的信息在主题上并不相关。pg_stat_activity 和 pg_locks 视图可以相互补充,而 pg_stat_database 并不包含后文将要讨论的那些统计信息。如今,这三个视图包含不同的信息,但共同围绕一个主题:确定活动。三个视图共同帮助我们了解数据库管理系统中正在发生什么:
pg_stat_activity—— 关于进程、已连接客户端和后台服务的统计信息;pg_locks—— 关于活动进程持有或等待的锁的统计信息;pg_stat_database—— 以单个数据库为上下文的客户端会话累计统计信息。
命名约定
下文在指出视图及其字段时,将使用*视图.字段*这种记法。例如,pg_stat_activity.pid 表示视图 pg_stat_activity 中的 pid 字段。
pg_stat_activity 视图
我在排查和解决问题方面的全部实践经验都表明,当对数据库管理系统的运行产生各种怀疑时,pg_stat_activity 是最主要的初始信息来源。从操作系统角度看,管理员只能看到进程;而 pg_stat_activity 可以帮助管理员从 PostgreSQL 自身的角度进入数据库管理系统内部,查看这些进程的工作情况。该视图包含数据库管理系统所有进程的信息,无论是后端进程还是后台服务;其中每一行描述一个独立的服务器进程。在 PostgreSQL 的早期版本中,pg_stat_activity 主要包含后端进程的信息。后续版本加入了后台服务的信息。不过,后端进程和后台服务与数据库管理系统交互的方式不同,因此后端进程所具有的一部分信息对后台服务来说根本不存在。
后台进程的信息不足可以由其他视图补充,pg_stat_activity 仍然是了解数据库管理系统内部活动最有价值的信息来源。
可以使用元命令 \d+ pg_stat_activity 查看此视图的完整说明。
元命令
psql 客户端包含一组元命令,可用于获取用户对象和系统对象的帮助信息。所有元命令都以反斜杠 \ 开头,例如 \d。如需获取帮助并列出全部元命令,请使用元命令 \?。
下面给出该视图的简要说明。
pg_stat_activity 中的统计信息输出,是一个基于 pg_stat_get_activity 函数的表,其中每一行描述一个具体的服务器进程。
让我们看看可以从该视图中获得哪些有用信息。
客户端信息。 连接的主要属性如下:
client_addr—— 建立连接的网络地址。如果连接通过 UNIX 套接字建立,该值将不存在(NULL);client_port—— 远程系统上建立连接所使用的端口号;usename—— 连接所使用的用户名;datname—— 连接到的数据库名称。
为了更好地识别客户端,客户端连接时可以通过单独的标识符 application_name 标明自身。当多个应用使用相同的连接属性并且来自同一地址时,这是区分应用的便捷方法。backend_type 字段可以区分后端进程和后台服务。在数据库管理系统的早期版本中没有这个字段,确定客户端连接只能采用各种变通办法,例如在 SQL 查询中增加条件 datname IS NOT NULL。
这个例子清楚展示了后台服务(第 1 至 7 行)与后端进程(第 8 至 15 行)的区别。首先,可以根据 backend_type 字段的值区分它们。其次,后台服务的其他字段可能没有值,例如 client_addr、application_name、usename 和 datname,因为后台进程可能在本地启动,也可能不建立数据库连接。
会话、事务和查询的持续时间。 该视图包含与会话开始时间以及会话中正在发生的活动相关的时间信息:
backend_start—— 会话开始时间,也就是客户端连接到数据库管理系统的时刻;
xact_start—— 当前事务的开始时间;query_start—— 当前查询的开始时间;如果事务中不止一个查询,这个字段尤其有用。
借助这些字段,可以发现与特定工作负载不相称的长时间运行查询和事务。
会话状态。 会话在生命周期内可能处于不同的状态。根据状态,可以判断会话是否一切正常,并在出现问题时采取措施。state 字段指示会话状态。state_change 字段还提供了切换到当前状态的时间,据此可以确定会话处于该状态的持续时间。接下来,我们将利用这些字段跟踪数据库中潜在危险的活动及其持续时间。
等待与锁。 数据库管理系统的内部机制需要使用各种同步机制;用于串行化对象访问的锁就是一个很好的例子。使用这些机制的结果之一,是在代码执行的不同位置产生等待的风险。为跟踪等待,数据库管理系统提供了 wait_event 和 wait_event_type 字段,它们可以详细标识产生等待的位置。借助 state、wait_event_type 和 wait_event 字段,可以确定数据库管理系统工作中的瓶颈,即进程在这些位置等待,而不是执行有用的工作。
查询标识符和文本。 query 字段包含数据库管理系统中正在执行的查询文本。该字段受缓冲区大小限制,而缓冲区大小由参数 track_activity_query_size 控制(默认值为 1 KB)。发现慢查询的文本后,管理员就有了优化性能的起点。可以重放查询、获取执行计划、分析性能,并据此制定优化措施。此外,每个查询还会生成唯一标识符 queryid;将它与 usesysid 和 datid 字段结合起来,可以和 pg_stat_statements 视图连接,从而获得关于该查询及其同类查询使用了多少资源的更多信息。
进程标识符。 pg_stat_activity 中的所有进程都是操作系统进程,都有操作系统分配的唯一标识符 pid。统计信息中提供了这个标识符,它也是将 pg_stat_activity 与其他视图连接起来的键。例如,获取有关锁或某项操作执行进度的详细信息时,就可能需要用到它。
数据库管理系统可以把查询的一部分分配给多个进程执行,从而加快查询执行,并提高多核系统的使用效率。观察时,重要的是把执行并行查询的进程组与其他进程或进程组区分开来。leader_pid 字段就是为此服务的:所有子进程中的该字段都指向父进程的 pid。
事务标识符和事务可见性界限。 两个标识符分别表示已分配的事务号 backend_xid 和事务可见性界限 backend_xmin。在调查自动清理工作效率低下导致的表和索引大小异常增长时,这两个标识符可能很有用。关于这些统计信息的具体使用场景,我们将在介绍清理的第 8 章中详细讨论。
pg_locks 视图
pg_locks 视图包含有关已持有锁的信息。它可以单独使用,但实践中经常与 pg_stat_activity 一起使用,两个视图相互补充,形成更完整的结果。
pg_locks 的每一行都包含有关被加锁或等待加锁的对象,以及发起锁请求者的信息。当多个进程试图获取同一对象的锁时,该对象会在视图中出现多次。对象上的锁被释放后,相关信息就会从视图中删除。锁对象可以是表、单独的行,甚至是表中的页面、事务标识符和数据库管理系统的共享对象。某些需要锁的操作也以单独对象的形式出现,例如扩展表文件,或更新 pg_database.datfrozenxid 等元数据。该视图还显示建议锁(advisory lock);其含义和用途由应用自行决定,但不包含轻量级锁(lightweight lock,LWLock)的信息。轻量级锁在更低层次工作,用于控制对内存中内部结构的访问。
可以使用元命令 \d+ pg_locks 查看 pg_locks 的完整说明;上面给出的是简要说明。该视图基于 pg_lock_status 函数,以表格形式展示信息。
锁对象。 可以使用下面这组字段识别与锁相关的对象:
relation、page、tuple—— 关系、页面编号和页面内的行编号;virtualxid、transactionid—— 虚拟事务号和实际事务号;classid、objid、objsubid—— 当锁对象不是关系对象时,它在系统目录中的锁对象标识符。
根据锁对象的不同,某些字段可能没有值(NULL)。
锁的详细信息。 带有附加信息的字段,对于确定正在等待获取锁的进程十分重要:
locktype—— 锁类型,用于区分不同的锁4;database—— 发生锁的数据库标识符(OID);virtualtransaction—— 持有锁或等待锁的虚拟事务标识符;pid—— 操作系统进程标识符。这个字段最常用于与pg_stat_activity连接,以获取用户名、查询或事务的开始时间、查询文本、等待标记等附加信息;mode—— 锁模式,用于判断它与其他锁是否兼容。模式的完整列表见文档5;granted—— 标志,表示锁已被持有(值为true),还是正在等待获取(值为false);waitstart—— 进入等待锁状态的时间。这是能够可靠说明进程等待锁的时间长度的唯一来源。不过要注意,即使已经开始等待锁(granted = false),这个字段在很短的一段时间内仍可能没有值(NULL);fastpath—— 标志,表示是否通过 fast-path 接口获取锁。这个接口早已被宣布为过时,只有运行使用该接口的应用时,这个字段才有意义。
利用锁的详细信息,可以筛除无关的锁,只关注那些与正在调查的问题直接相关的锁,例如与特定会话有关、具有某种类型,或等待时间超过允许时长的锁。与 pg_stat_activity 连接后,还可以获得有助于分析和修复应用侧问题的附加信息,例如用户名、应用名称和查询文本。
pg_stat_activity 和 pg_locks 的特点
pg_stat_activity 和 pg_locks 两个视图有一个重要特点,我习惯把它看成一种缺点。基于这些视图实现监控时,始终应记住这一点。它们输出的统计信息反映当前时刻,并不是累计值。从这些视图取得的数据,是访问视图的那一刻所发生情况的快照。两个快照之间发生了什么,是未知的。实践中可能会遇到每秒处理数万甚至数十万个查询的系统。在两次快照之间,可能出现大量短暂的等待;这些等待不会进入快照,也不会在监控中显示出来,但可能对查询执行时间产生负面影响。这样一来,缺失的信息就造成了对实际情况的不完整认识。在基于这类快照构建监控系统并积累统计信息时,对情况的客观描述会严重依赖统计信息的采集频率。实践中通常每隔几秒采集一次,最常见的间隔在 15 到 60 秒之间。但即使以 1–10 毫秒的频率进行分析,也不能保证图景完整,而且还会增加分析本身的开销。总结一下:查看基于 pg_stat_activity 或 pg_locks 视图绘制的图表时,必须记住这个特点。其他一些视图也以类似方式工作;后文讨论它们时,我会单独指出这一点。
pg_stat_database 视图
pg_stat_database 视图的每一行都包含有关特定数据库使用情况的统计信息。该视图还有一行专门用于记录可共享、供所有数据库使用的对象的统计信息(其中一部分属于所谓的系统目录)。该视图建立在一组函数之上,这些函数的前缀是 pg_stat_get_db_,它们接收数据库标识符作为参数并返回一个指标。可以使用元命令 \d+ pg_stat_database 查看该视图的完整说明。该视图的部分字段可以归入客户端连接统计信息,这有助于监控数据库管理系统的活动。
虽然这个视图包含数据库信息,但其中一些信息也可以放在客户端及其会话的上下文中理解。借助这些信息,可以跟踪已连接客户端的数量,以及应用是否正常地使用数据库管理系统。可以使用以下字段:
numbackends—— 连接到数据库的后端进程数量。在可共享对象统计行中,该值不存在(NULL)。这是视图中唯一表示当前值的字段,其他字段都包含某个时间段内的累计统计信息;xact_commit—— 以提交(COMMIT)结束的事务数量。该计数器也会统计隐式事务中单个查询成功执行的次数;xact_rollback—— 以回滚(ROLLBACK)结束的事务数量,包括因错误而回滚的事务;sessions_abandoned—— 因客户端留下连接而被强制结束的会话数量。这可能说明客户端应用忘记了连接,没有按应有方式关闭连接(graceful close)。另一个原因可能是网络问题,例如传输错误和丢包,导致 TCP 会话无法正常工作;sessions_fatal—— 因发生致命错误且无法继续工作而被强制结束的会话数量。这类错误可能发生在查询执行期间,也可能由客户端与服务器交互时服务器侧的异常情况引起。此时服务器无法继续会话,只能结束会话。一个例子是,由参数 idle_in_transaction_session_timeout 设置的超时期限超过后,会话被结束;sessions_killed—— 以管理方式强制结束的会话数量。这种会话终止可能由pg_terminate_backend函数发起,也可能由数据库管理系统自身发起,例如服务器关闭或重启时;sessions—— 与数据库建立的会话总数。该字段的值表示已建立的会话总数,不论会话以何种状态结束,也就是说,它包含其他所有可能状态的数值。
会话通常由客户端发起并结束。上面列出的一些字段,正好表示由数据库管理系统服务器发起结束的会话数量。因此,在某些情况下,会话结束可以被视为异常。会话期间,客户端会发送单独的命令,也可以把命令组合成事务。这些命令构成工作负载,通过 xact_commit 和 xact_rollback 字段,可以定量计算数据库管理系统中的工作负载大小。
关于会话工作的另一项有用信息,是会话在不同状态下持续的时间。这些状态在介绍 pg_stat_activity 时曾简要提到,稍后还会更详细地讨论。不过,字段集合并不完整,有些信息需要通过简单的算术运算计算出来。我们关心以下字段:
session_time—— 所有会话累计花费的总时间。时间统计有一个特点:只有在状态切换时,时间才会增加。因此,如果某些会话长时间保持同一状态,就可能出现很大的跳变。开发人员在 IDE 中长时间留下的会话就是一个很好的例子;active_time—— 会话处于active和fastpath function call状态的时间,这两个状态都对应查询执行;idle_in_transaction_time—— 会话处于idle in transaction和idle in transaction (aborted)状态的时间。
注意,上述字段中没有统计处于 idle 状态的时间。这个值必须自行计算:从总时间中减去处于空闲事务状态的时间和查询执行时间。
这些字段的所有值都以毫秒表示。
pg_stat_database 提供的数据库统计信息具有累计性质,会随时间积累,从而可以连续记录,不会像 pg_stat_activity 或 pg_locks 那样存在丢失风险。管理员可以使用单独的函数重置统计信息,从头开始累计。该视图有一个 stats_reset 字段,表示统计信息重置的时间。借助它,可以计算统计信息累计覆盖的时间区间。
2.4. 已连接的客户端
遇到新情况或陌生环境时,首先要评估当前情况的全貌,了解即将排查和解决问题的环境。刚开始接触一个数据库管理系统时,我首先想知道系统的使用活跃程度以及它的用户是谁。通常需要了解系统连接了多少客户端、连接的是什么客户端,由此大致判断它们可能需要多少资源、会产生多大负载。
获取这类信息有两种方法。第一种方法是使用 pg_stat_database 视图:
在查询输出中,可以看到每个数据库当前连接的后端进程数量。不过,pg_stat_database 只在数据库上下文中展示已连接客户端的信息,这可能不足以进行更详细的分析。还要注意查询结果中名称为空的行:这是一个服务行,汇总了共享对象的统计信息。这些对象可供所有数据库使用,但不属于任何一个数据库;它们全部属于系统目录。
系统目录
系统目录是一组包含服务信息的表,由数据库管理系统自身使用。服务数据包括表、字段、索引、数据类型等信息。实际上,CREATE、ALTER、DROP 等几乎所有 DDL 命令,操作的正是系统目录中的数据6。
第二种方法是使用 pg_stat_activity 视图,得到的信息也详细得多:
在这个例子中,客户端按连接地址、用户名和数据库名称分组。可以得出以下结论:
有两个地址提供了绝大多数连接;
大部分连接都指向
pgbench数据库;有多个用户在使用该数据库。
client_addr 为 NULL 表示连接通过 UNIX 套接字从数据库管理系统服务器所在的同一节点建立,很可能就是我们通过 psql 建立的连接。在 usename 和 datname 字段中也可以看到 NULL,这类行通常对应后台服务。在 pg_stat_activity 的完整输出中,还能看到更多类似的行。
通常使用条件 backend_type = 'client backend' 来筛除后台服务,只显示客户端会话。
早期 PostgreSQL 版本的做法
backend_type 字段在 PostgreSQL 10 中出现;在更早的版本中,可以使用类似 datname IS NULL 的条件。通常,后台进程不会连接数据库,自动清理进程除外。
使用附加条件,可以从查询结果中排除后台进程,只获取后端进程的信息:
实践中分析问题时,还需要按其他字段进行分组,并根据所提出的问题和待验证的假设使用不同的条件。
跟踪客户端会话
使用 SQL 获取信息很方便,但实践中经常要在问题已经消失后再进行分析,这时需要历史视角下的信息以及随时间变化的趋势。这些任务由监控系统完成:监控系统采集、保存并可视化统计信息。借助监控,管理员可以通过图表观察统计信息随时间的变化。
监控系统必须始终掌握已连接客户端的信息,而且信息要足够详细。下面看一些客户端统计信息的实际例子,以及它们能够回答哪些问题。
要获取已连接客户端的总数,可以使用下面的 PromQL 查询:
根据这个查询可以绘制图表,如图 2.1 所示。
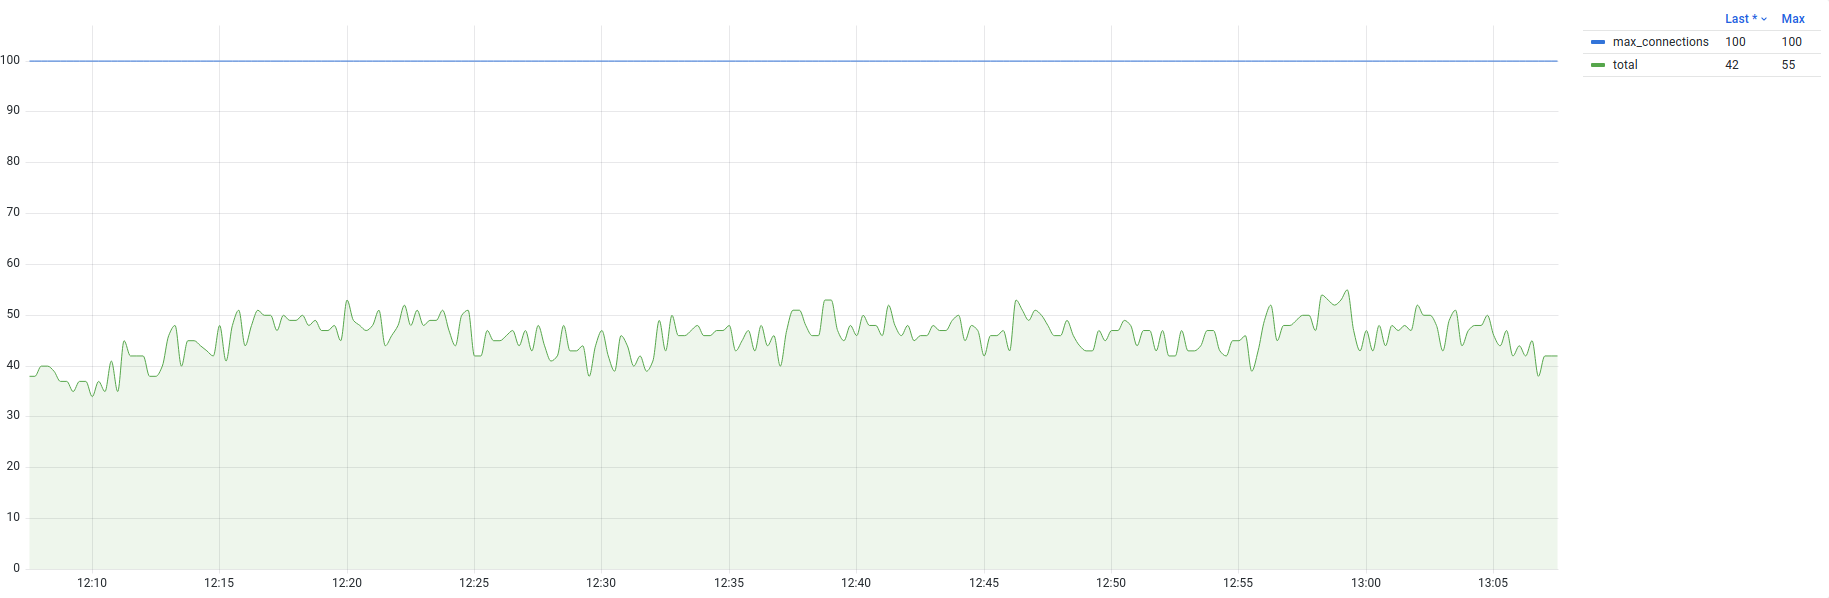
图中显示了最近一小时内连接数的变化。除了主要指标外,图中还给出了并发连接数上限,可以直观看出达到上限前还可以建立多少连接。连接数上限由参数 max_connections 设置,默认值为 100。从图中可以看出,当前连接数略少于允许上限的一半,仍有余量。
配置参数指标
数据库管理系统的参数也可以作为指标使用。例如,可以通过指标 postgres_service_settings_info{name="max_connections"} 获取参数 max_connections 的值。
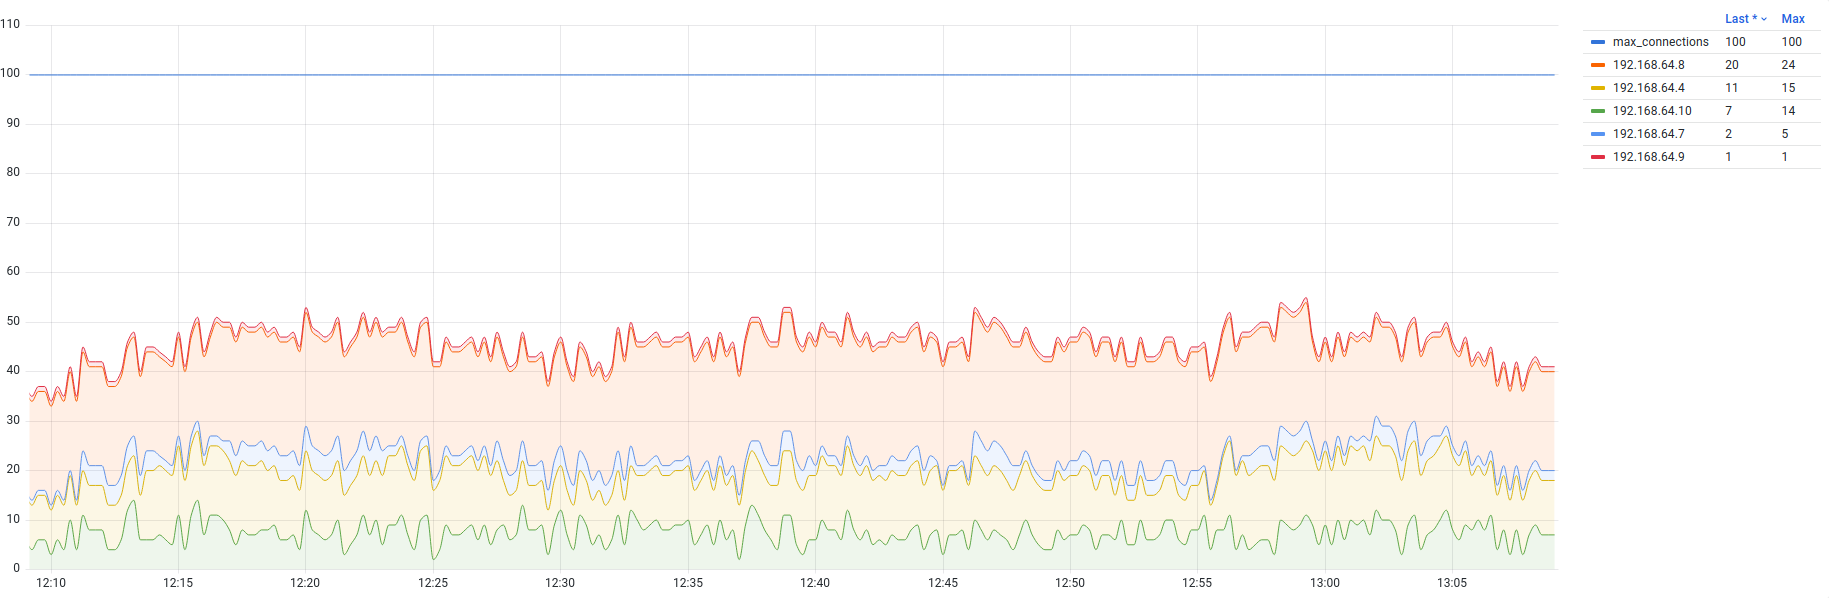
指标 postgres_connected_clients_total 包含 address、user 和 database 标签,可以按这些标签分组,从不同视角获得统计信息。先按地址分组:
图表将如图 2.2 所示。其中可以看到,大部分会话来自地址 192.168.64.8 和 192.168.64.4。在应用实例较多的环境中,这类图表可以帮助找出使用异常多会话的地址。
现在把分组条件改为用户名,就可以了解哪些用户正在连接数据库管理系统(图 2.3):
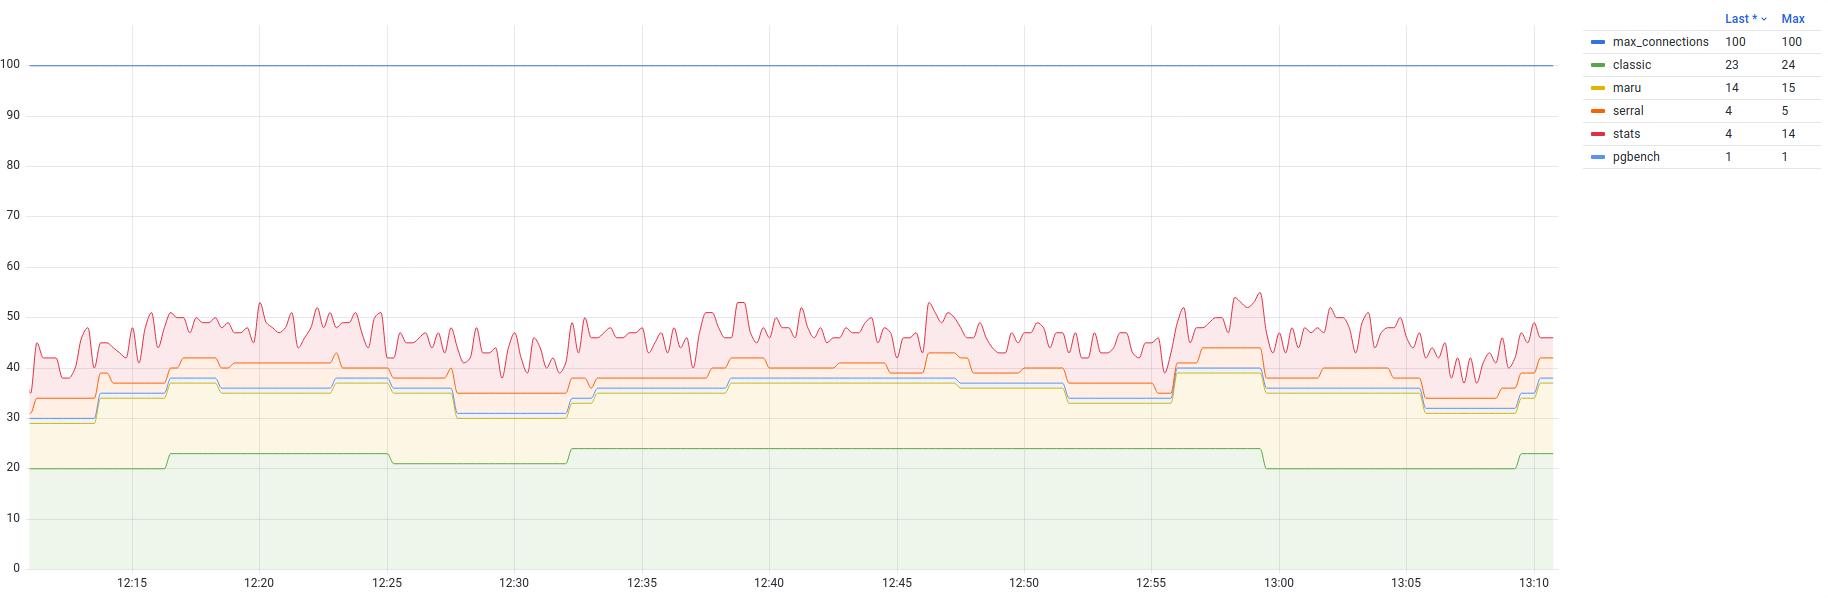
从图中可以看出,大部分会话来自两个应用用户。再仔细看,还可以发现 stats 用户比较突出。在测试环境中,指标导出器使用该用户建立连接以采集统计信息。对于导出器以及任何其他监控代理来说,这样多的连接都过多了,值得以此为起点优化代码。
现在看看连接指向哪些数据库(图 2.4)。
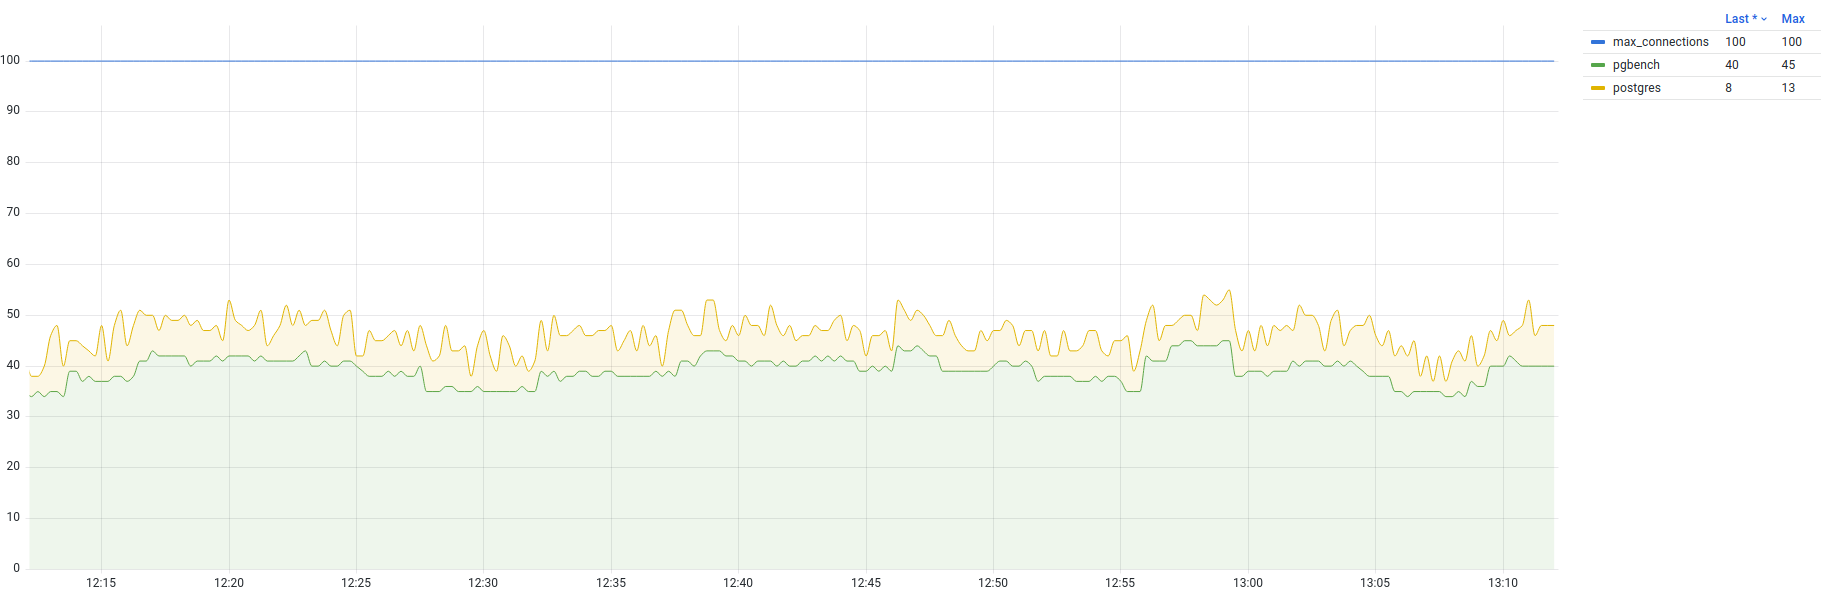
从图中可以清楚看到,几乎所有连接都指向 pgbench 数据库,它是工作负载集中的主要数据库。只有很少一部分连接指向 postgres 数据库;这些连接很可能同样由指标导出器建立。
根据指标的信息量和所使用的标签,还可以绘制其他视角的图表。例如,如果应用广泛使用 application_name,也可以把这项信息作为指标标签导出,并绘制相应的图表。
事务活动
查询是工作负载的基本单位。可以把查询组合成事务,而事务作为一个整体执行:即使只有一个查询出错,也会被视为整个事务出错。事务机制的设计方式决定了,即使没有显式包在事务控制命令(BEGIN 和 END)中的单个查询,也属于事务(只包含一条命令)。
通过所执行的事务数量,可以判断数据库的使用活跃程度。所需信息可以在 pg_stat_database 中找到。该视图包含 xact_commit 和 xact_rollback 字段,分别表示已提交和已回滚的事务数量。这两个字段的总和表示数据库中的事务活动:
测试环境中只有两个数据库在积极使用:pgbench 和 postgres。此外还有一个数据库名称为空的特殊行,其中包含系统目录共享对象的统计信息。下面的查询可以从监控系统中获得数据:
这个查询计算每秒执行的事务数,根据它可以绘制图表(图 2.5),以动态展示当前情况。图中可以直观看出,pgbench 数据库中的事务量是 postgres 数据库的数倍。
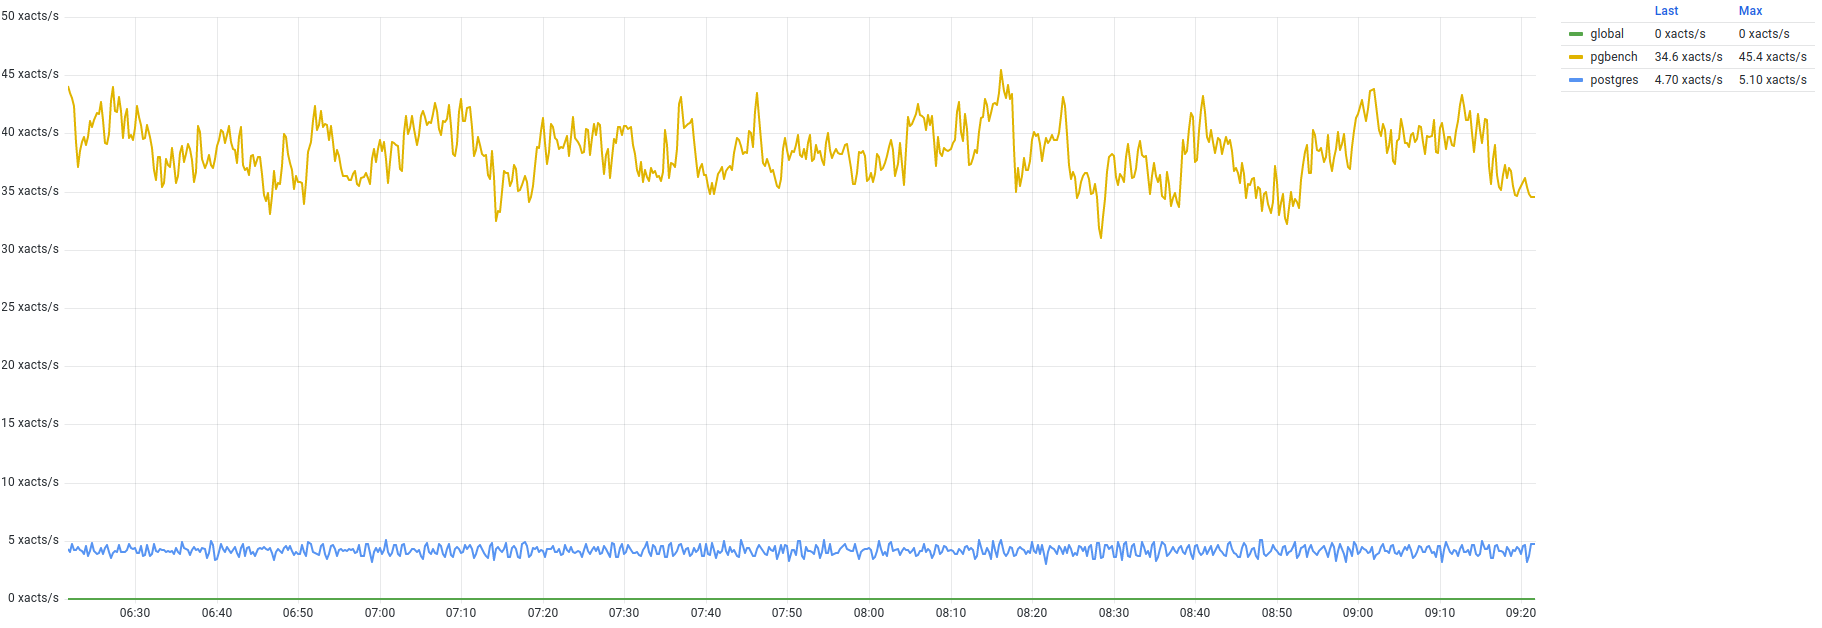
事务活动图表适合做粗略分析和了解数据库管理系统当前的活动,也很适合作为值班工程师查看的汇总图表。剧烈波动通常表示应用实例数量发生变化,或工作负载规模发生变化,进而可能导致数据库管理系统的资源使用发生变化。
使用 pg_stat_statements 统计事务
可以通过 pg_stat_statements.query 获取事务信息,跟踪事务开始和结束命令(BEGIN、COMMIT 等)。不过,这种方法有几个缺点。第一,必须启用实用命令跟踪(track_utility = on)。第二,该扩展只记录直接调用的 ROLLBACK 命令,因此无法跟踪因错误而发生的事务回滚。第三,事务开始并不总是能够被跟踪。例如,如果客户端使用 \set AUTOCOMMIT off,事务会在执行第一条命令后立即隐式打开。因此,虽然可以使用 pg_stat_statements 进行统计,但不太方便。
会话结束状态
会话正常工作时,客户端会连接数据库管理系统、发送查询;不再需要连接时,则关闭连接并断开连接。不过,会话也可能出现异常行为而被中断:
客户端、数据库管理系统或中间网络设备重置连接;
会话发生错误,之后无法继续会话;
管理员或数据库管理系统主动强制结束会话。
当然还可能有其他更为特殊的情况,但上面列出的原因最常见。会话异常结束有时很少发生,也不容易察觉:会话中断后,数据库管理系统把消息写入日志,应用重新建立连接,工作继续进行。网络错误、超时或丢包都可能造成这种情况,它们会破坏 TCP 连接的运行。但也可能出现另一个极端:错误成批出现,无法忽略。通常这是应用层错误的结果,会话因为应用中的错误而结束。例如,会话中断后,应用可能重新建立连接并执行有错误的代码,结果会话再次被重置,整个过程不停重复。这种行为很好地体现了 crash loop 这个术语,Kubernetes 管理员对此并不陌生。如果错误之间的间隔很短(只有几毫秒),应用可能造成连接建立尝试风暴。最好的情况下,这会增加数据库管理系统侧的 CPU 负载(创建后端进程的开销并不低)。最坏的情况下,如果多个应用实例表现相同,就可能耗尽连接上限 max_connections,使其他应用无法连接数据库管理系统。
会话状态统计位于 pg_stat_database 中,可以这样获取:
提醒一下,pg_stat_database 包含累计统计信息,因此其中可能出现很大的数值。需要关注的是是否存在异常状态:abandoned、fatal 和 killed。在这个例子中没有记录这类会话,说明应用在会话层面运行正常,没有错误。还可以注意到,与应用数据库 pgbench 相比,连接到服务数据库 postgres 的数量多得多。可以使用下面的 PromQL 查询绘制图表,查看随时间变化的情况:
在这个查询中,会话在所有状态下的数量按我们关心的两个数据库汇总。统计信息是累计值;为了直观看到随时间的变化,可以使用 increase 函数,它显示指定时间间隔内的指标变化(本例中为一分钟)。
图 2.6 显示,每分钟大约有 90 个会话连接到 postgres 数据库。原因是指标导出器特有的工作负载。导出器在采集统计信息期间建立多个会话,
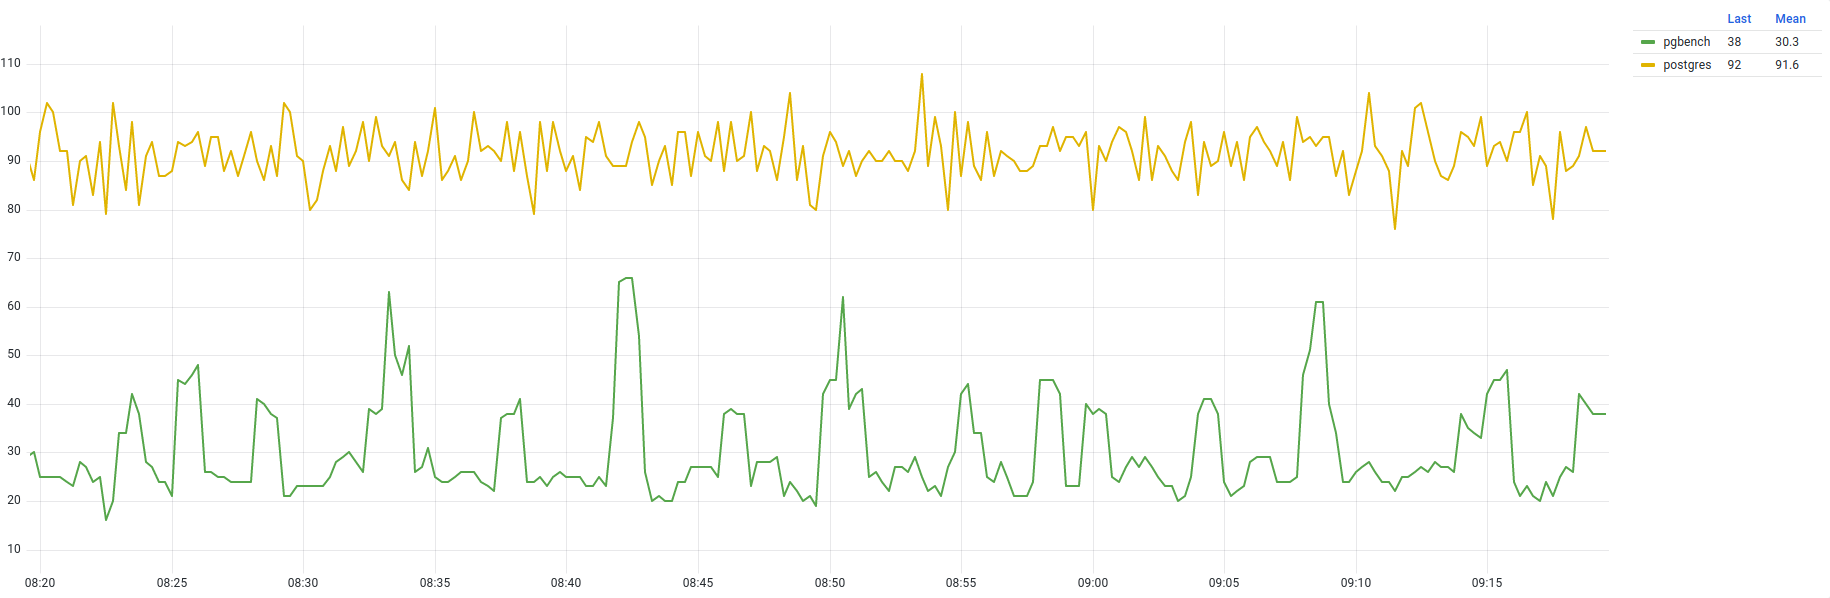
随后结束这些会话。就资源使用而言,这种做法效率不高,因为数据库管理系统要为每个会话创建独立进程,并执行成本高昂的初始化。从这个角度看,长期建立并使用几个会话更有利,这也是优化导出器代码的一个好起点。除了导出器,测试环境中还有一些应用,它们每隔几分钟就会带着新的负载参数重启,这一点从 pgbench 数据库建立会话时出现的尖峰就能看出来。在实际环境中,应用可能很少重启,而它们建立的连接可能持续运行几十分钟甚至数小时。
实践案例。 异常状态通常表示存在问题,或说明应用或环境的工作方式效率不高。下面的案例发生在准备本章材料时。
获取会话状态的查询显示,sessions_abandoned 的值占 sessions 总数的 13%,并且还在缓慢增加。这个数值相当大,因此我尝试查明遗留会话数量如此之多的原因。关闭测试负载后,计数器仍然继续增长,于是我怀疑问题出在监控代理上。这个问题我很熟悉:如果应用侧没有正确关闭连接,就会出现这种现象。我可以访问代理的源代码,于是检查了所有打开连接的位置。需要确认连接在使用后都被关闭;检查后,我发现有一个位置没有关闭连接,可能造成连接泄漏。
为了确认问题是否持续存在,我根据下面的查询绘制了图表(图 2.7):
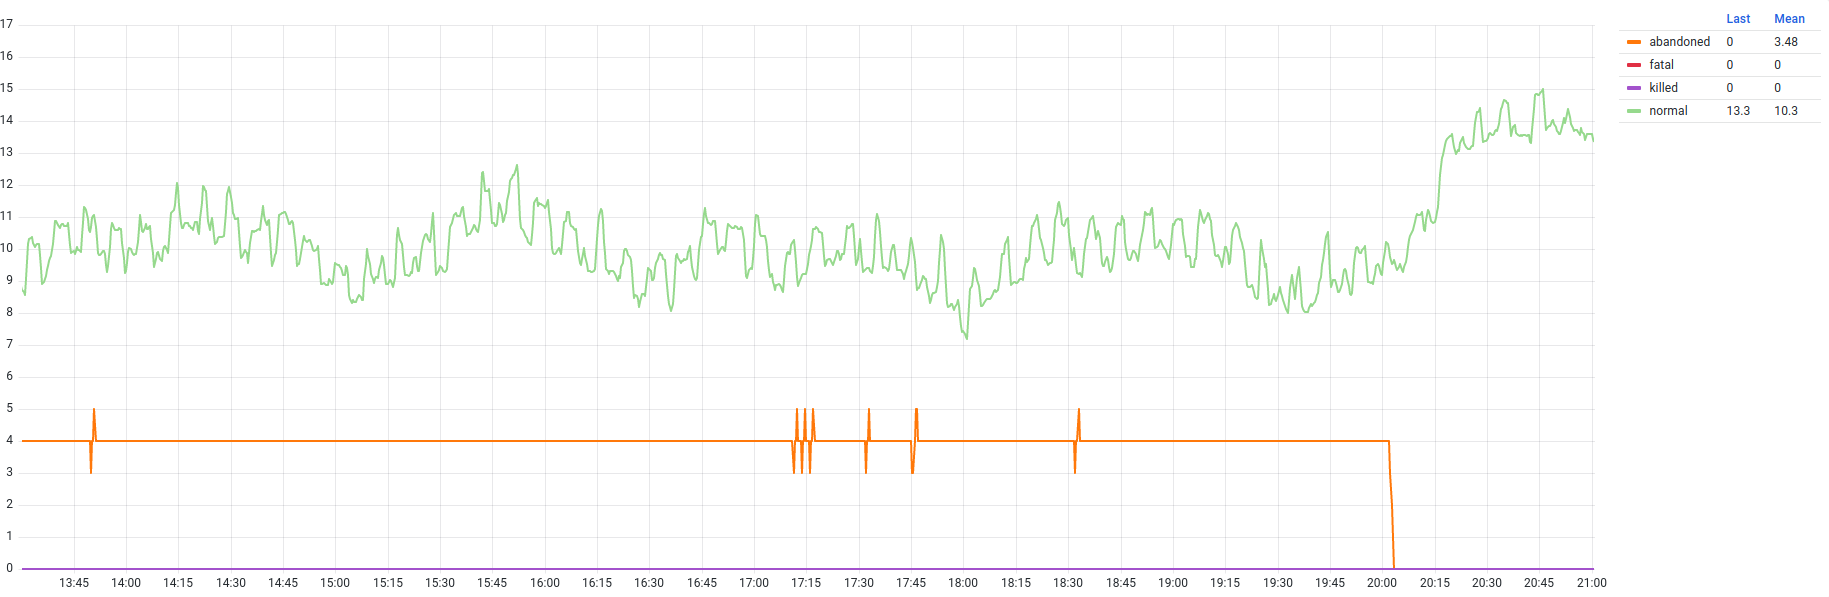
调查结果是修复了 d0989237。大约在 20:00,应用版本完成更新,问题消失,图表也证实了这一点。监控就这样帮助发现并解决了代理应用中的错误。
2.5. 会话状态
后端进程在其生命周期中可能处于不同状态,这些状态反映会话中正在发生的事情。可以把进程状态看作一个条件标记,用来区分行为正常和不符合预期的会话。状态显示在 pg_stat_activity.state 中,但只有客户端连接才会有这个状态;后台进程的该字段始终为空。这可能是因为“状态”描述的正是会话,而后台进程不会建立会话,因而也没有可供显示的内容。未来 PostgreSQL 版本的情况可能会改变,届时或许会提供某种关于后台进程状态的信息。下面看一看会话可能处于的所有状态:
idle表示空闲状态。如果客户端没有发送命令,服务器也没有忙于执行查询,那么会话就处于空闲模式,服务器正在等待客户端的命令。会话大部分时间都可能处于这种状态。active表示活动状态。进程接收到客户端命令后开始执行,并进入活动状态。需要注意,这个状态也包括等待状态:进程可能暂停工作,等待某个事件。idle in transaction表示事务已经打开,但其中没有任何活动,进程正在等待客户端发送要执行的命令。应用打开事务后,应该在其中执行一组命令并将其关闭,但由于某些内部原因,命令之间可能出现停顿。根据所执行命令的性质,这种状态可能导致锁,以及由于延迟自动清理而导致的表和索引膨胀。应当跟踪这类事务,并消除导致其进入这种状态的原因。关于空闲事务的更多信息,请参见第 56 页。idle in transaction (aborted)表示一个未完成的事务,事务内部发生过错误。良好的实践是让应用完全控制事务的执行过程。如果事务中的任何命令执行出错,应用都应回滚事务。如果缺乏事务管理,就会出现资源泄漏风险,例如应用中数据库驱动程序一侧的事务池槽位被占用。对于数据库系统本身,会话处于这种状态的危害较小,因为错误发生后所有资源和锁都会释放;但对应用来说,这种情况可能很敏感,可能耗尽内部池中的连接或引发错误。关于空闲事务的更多信息,请参见第 56 页。fastpath function call表示通过 fast-path 接口执行函数8。这种执行方式已经过时,不建议使用。实践中我没有遇到过这种状态,但可以设想,早期开发且已经无人维护的应用可能仍在使用这项功能。disabled不表示进程的某个具体状态,而只表示数据库系统配置中关闭了会话状态跟踪。跟踪通常默认开启,不建议关闭,因为这会降低可观测性,也会削弱监控和调试能力。
还有一种重要状态不会反映在 state 字段中,那就是等待。这个状态被隐含在 active 状态中,但在我看来,两者应该分开,并作为彼此独立的状态来考察。活动状态意味着正在执行操作并使用资源,而等待意味着进程不执行操作,却占用着本可供使用的资源。由此可见,活动状态是系统正常工作的状态,等待则是不正常的状态,管理员应采取措施减少等待。
状态跟踪
按状态监控客户端会话,可以跟踪工作负载的执行情况以及其中出现的各种异常。可以使用下面的 SQL 查询查看所有后端进程及其状态:
这个合成负载示例表明,大部分连接处于空闲状态。在查询 pg_stat_activity 的时刻,只有三个进程正在执行查询,另有一个客户端打开了事务并在等待客户端命令。不过要记住,active 状态隐含地包括可能的等待,因此从结果中无法判断会话的确切状态。下面我们考察等待和锁的本质,以及更准确地确定会话状态的方法。
等待与锁
锁的作用是限制或禁止对资源的并发访问。在并发环境中,使用锁会导致对被锁资源的访问排队。处于这种队列中会直接影响查询或事务的执行时间:在获得访问权之前,执行会一直被阻塞,而只有整个队列处理完、锁被释放后,访问才可能发生。执行查询时等待锁会损害性能:数据库系统和应用不得不等待,无法进行有用的工作。管理员必须跟踪系统何时把时间花在等待上,而不是有用工作上。
对于后端进程来说,等待意味着在资源(对象)释放或预期事件出现之前无法继续工作。对象可以是表或单独的行;轻量级锁则施加在更低层级的资源上。磁盘或网络 I/O,例如文件同步、网络传输等,都可能成为等待的事件。
可以使用 pg_stat_activity 视图跟踪等待。数据库系统中可能有很多位置会让进程停下来等待。相比一个笼统的状态,了解等待的具体原因更为重要,因此 state 字段并不十分适合这项任务。数据库系统提供了所谓的等待事件(wait event):它们指出进程正在等待的具体事件或资源。在 pg_stat_activity 中,这些等待事件由两个字段表示:
wait_event_type— 等待的总体类型,换句话说,是该等待所属组的标识;wait_event— 进程正在等待的具体事件或资源。
等待事件表示进程确实在等待某个事件或资源,而这项信息是在 9.6 版本中引入的。在更早版本中,可以通过 pg_stat_activity.waiting 标志判断等待;它只表示一种特定的等待情况,即等待锁。等待事件扩大了可记录事件的范围,覆盖可能造成等待的各种原因,并取代了这个更简单的标志。所有可记录等待的完整列表,请参见文档中关于 pg_stat_activity 的章节9。下面用测试环境中的一个查询结果做简单示例。
查询条件排除了后台服务;它们被等待事件覆盖的程度并不高,在这个例子中也不是我们关注的对象。为了便于处理等待事件,可以用分隔符(例如点号)把这两个字段合并为一个值,使其同时显示等待类型和具体事件。这样的合并值可以称为等待标记。测试环境中有多个应用生成合成负载,查询结果展示了该负载执行期间的等待快照:
Client.ClientRead— 进程正在等待接收客户端命令。这是空闲进程的常见状态,进程大部分生命周期都可能处于这种等待中。LWLock.WALWrite— 等待轻量级锁,以便把预写式日志页面从内存中的缓冲区写入磁盘。WAL 按顺序写入,在写入负载高度并发时,这经常会成为数据库系统性能的瓶颈。Lock.transactionid— 等待相邻事务完成。如果多个事务尝试修改相同数据,就经常会出现这种等待。IO.WALSync— 等待把 WAL 段的写入同步到磁盘。
从这个小例子可以看出,等待的形式可能非常多,而且它们对合成负载的影响也可能不同。例如,磁盘类型和性能(HDD、SSD、NVMe)不同,WAL 的写入和同步速度也不同,等待时间会随之变化。等待相邻事务取决于工作负载的性质、并发事务的数量,以及事务本身和其中各条命令的持续时间。至于等待客户端命令,它对负载没有影响:会话处于空闲模式,只要应用需要,就可以立即使用,不会产生延迟。因此,等待标记可以提示管理员时间花在了哪里,并为系统可能的优化提供起点。
不过,等待标记的数量很多,并非每一种都应被视为需要立即处理的关键状态。正如前面提到的,Client.ClientRead 是一种完全无害的等待,不会影响系统工作。
经过多年的实践,我和几位同事认为,在所有等待事件类型中有一组特殊事件,可以把它从其他事件中区分出来,并把它看作与 pg_stat_activity.state 中各值同等的一种独立状态。这就是类型为 Lock 的事件组:这一组等待表示命令执行已经停止,正在等待获取重量级锁。该组包含多个等待事件,可以更准确地指出等待原因。例如,transactionid 等待表示正在等待相邻并发事务完成。Lock 组中的事件明确说明,进程和客户端应用都没有在做有用工作,而是在等待,这本身就会损害应用和数据库系统的性能。
考虑等待的状态跟踪
跟踪锁等待状态有两种方法。第一种也是首选的方法是使用等待事件。通过条件 wait_event_type = 'Lock',可以把进程识别为正在等待锁:
第二种方法稍微复杂一些,更多是出于学术上的兴趣。它需要连接 pg_locks 并使用 granted 标志。不过要注意,对于一个进程,pg_locks 中会有多个锁(多行),因此只应统计尚未获取的锁:
两种方法的结果并不完全相同,因为它们是在不同时间执行的。不过第一种方法更简单,因为不需要连接。
至少有两种方法可以实现用于监控客户端状态的指标:
根据
state字段分别显示各状态,并显示wait_event_state字段值为Lock的进程数。在这种情况下,active状态会包含正在等待锁的进程。把等待类型为
Lock的进程从active状态的进程数中排除。
指标 postgres_activity_connections_in_flight 的内部实现采用第二种方法,并包含 state 标签。除了标准状态外,该标签还可能包含额外的 waiting 状态,它正是用来表示正在等待锁的进程:
图 2.8 展示了根据这个查询生成的图表示例。
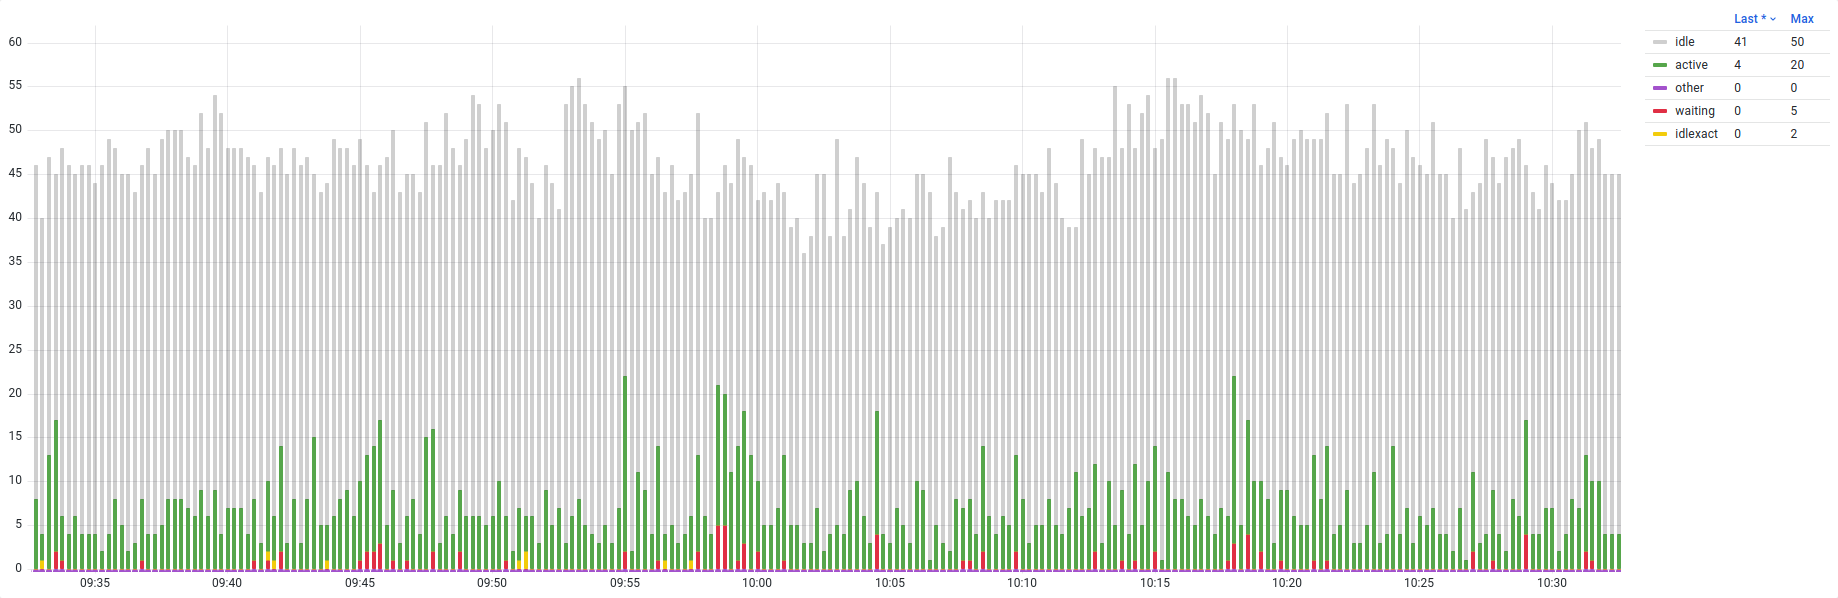
图中几乎包含所有可能状态的进程,其中也包括等待锁的进程。结合 state 和 wait_event_type 字段,就可以汇总出客户端会话的状态信息。
死锁
死锁(deadlock)是由多个锁形成的一种无法自行解决的情况:参与者陷入互相阻塞的僵局,进入等待状态,无法继续工作。要解决这种情况,必须强制结束死锁中的一个参与者,以释放部分锁。
普通锁的等待可能持续不可预测的长时间。死锁则简单得多:系统会自动检测并解决死锁,无需管理员干预。如果在 deadlock_timeout 时间内无法获取锁(默认是一秒),会话就会检查自己是否参与了死锁。检查过程中会确定冲突参与者。如果参与者中有清理进程,系统会向它发送终止信号,但为了防止事务计数器回绕(to prevent wraparound)而运行的清理进程除外。如果没有清理进程,会话会强制取消自己的查询;正是这个查询需要获取锁,因而触发了检查。如果查询在事务中执行,整个事务会进入错误状态,应当将其回滚结束。死锁中的其他参与者可以继续工作,但不能保证死锁不会再次出现。
实践中,最简单的死锁通常发生在不同会话交叉尝试获取相同资源的锁时。例如,第一个事务试图获取第二个事务已经持有的资源上的锁,而第二个事务又试图获取第一个事务已经持有的资源上的锁。死锁的主要危害在于:如果它们不断发生,系统性能会显著下降(并发性降低),而且由于操作被强制取消,还必须重试该操作(查询或事务)。不过,考虑到死锁会自动解决,它造成的危害仍然远小于普通锁;普通锁可能让相邻会话的工作不可预测地长时间停顿。
遗憾的是,数据库系统不存在通用的解决方案,因为问题在于应用与数据库系统并发工作时命令执行顺序不合理。要彻底解决问题,必须由应用本身改变处理数据的方式。
可以使用每个数据库各自的计数器 pg_stat_database.deadlocks 跟踪死锁。发生死锁时,相关信息会写入活动日志:
根据 log_line_prefix 的值,日志内容还可能补充其他有用信息(时间、用户、数据库、事务标识符等)。输出中最关键的信息是已经记录到死锁出现,即 deadlock detected。随后是关于哪个进程处于等待、哪个进程造成阻塞,以及检测到死锁时两个会话正在执行的查询文本。这里要注意,这些是当时的当前查询;实际上,冲突锁可能是由同一事务中更早执行的另一个查询获取的。要进行完整分析,必须启用所有查询的日志记录(log_statement = all 或 log_min_duration_statement = 0),完整记录事务中查询的执行过程,并检查它们的执行顺序。
空闲事务
理想情况下,组成事务的一系列命令应该连续执行,中间没有停顿或延迟:客户端收到结果后应立即发送下一条命令。但实际情况是,应用在发送命令之间执行某些工作,而数据库系统正在等待它继续(等待标记为 Client.ClientRead)。处于等待客户端命令状态的事务称为空闲(idle)事务。idle in transaction 空闲状态绝大多数情况下由客户端造成,只有少数情况下是运行应用的环境(操作系统或网络环境)造成的。从应用的角度看,命令之间的停顿可能由以下原因引起:
根据前面命令的结果进行计算;
访问远程服务(缓存、队列、数据库、API 等);
系统资源不足,以及操作系统分配资源(内存);
应用耗尽已设置的资源使用限制后被暂停(Kubernetes requests/limits);
发生错误并处理异常。
这不是完整列表,事务出现空闲的原因可能多种多样,而且并不总是显而易见。大多数情况下,造成空闲事务的责任在应用。错误处理就是一个很好的例子。发生错误时,应用正确的做法是回滚并结束事务。最糟糕的情况是出现事务泄漏:应用失去对事务的控制,而事务在不确定的长时间内保持未完成状态。还可能有其他场景。例如,用户连接到数据库并执行某些命令。用户可能需要开启事务,在其中执行一条命令,然后回滚。或者,用户使用的 IDE 在执行命令时可能隐式开启事务。用户转而处理其他任务,之前打开的事务就保持未完成状态。
客户端会话处于 idle in transaction 状态会产生负面影响,其中一些影响在特定数据库系统运行条件下可能导致故障:
占用数据库连接。应用打开事务时,通常意味着它将执行一系列命令。如果应用一侧使用了连接池,带有打开事务的连接就不能被其他执行线程使用。当连接池达到同时打开连接数上限时,应用会被阻塞,直到至少释放一个连接。
过时的行版本、膨胀效应和性能下降。在写入强度较高时,由于同一行出现多个版本,表和索引的大小会增长。过时的行版本不仅占用磁盘空间,还会损害性能。读取和查找数据时,进程必须处理更多页面来寻找所需的行版本,从而使查询变慢,并额外消耗 CPU、内存和 I/O 资源。数据库使用自动清理定期删除过时的行版本并释放空间。自动清理工作进程会扫描表和索引,找出任何事务都不再需要的行版本并删除它们。但长事务(包括空闲事务)可能仍需要旧的行版本,因此自动清理会跳过这些版本。即使删除成功,释放出的空间仍然属于表(或索引)。因此,表和索引的大小会增长,却不会在清理后缩小,这就称为膨胀效应。在极端情况下,表和索引内部的已释放空间可能超过有效数据的总量。
锁和数据库系统可用连接耗尽。在写入强度较高时,事务中的命令可能持有行锁。相邻事务可能希望访问同一行,并在尝试获取锁时等待空闲事务释放锁。等待中的进程无法供应用使用。在高负载下,应用会尝试打开新的连接,这可能导致等待队列增长,并达到同时允许的连接数上限。一旦达到这个上限,应用就无法连接数据库,从而使应用、数据库系统以及其他也想建立数据库连接的应用都无法工作。
因此,idle in transaction 是一种潜在危险的状态,进程长时间处于其中可能导致负面后果。应当跟踪并消除这类事务。作为临时措施,可以在数据库系统设置中启用 idle_in_transaction_session_timeout 超时,自动结束这类事务。该设置既可以在数据库系统的全局配置层面统一设置,也可以针对特定用户或数据库单独设置。另一种方案是使用 cron 工具定期运行基于 pg_terminate_backend 函数的脚本。当 idle_in_transaction_session_timeout 的能力不足、需要更精细的超时设置时,这种方案可能更合适。下面是 pg_terminate_backend 与 pg_stat_activity 配合使用的示例:
在 psql 中执行一次这个查询即可。如有需要,可以重新定义 SELECT 中的字段列表或条件,也可以保存结果输出,例如用于分析。
clock_timestamp vs now
通常,可以用当前时间减去时间戳来确定持续时间。任何数据库系统都有一个输出当前时间的函数。在 PostgreSQL 中,这个函数就是众所周知的 now,但它的特点是显示事务开始时间。可以在一个事务中多次调用 now 试试看。而对于监控,建议使用总是显示当前时间戳的 clock_timestamp。
2.6. 查询与事务的执行时间
工作负载由持续不断的查询和事务流组成,执行得越快,系统的吞吐量就越高。观察工作负载时,可以聚焦于单独的执行单位——事务和查询,并跟踪工作负载中出现的不常见长查询和长事务。无论工作负载属于哪种类型,优化执行时间都会改善性能。无论是 OLTP、OLAP 还是 HTAP,优化的目标始终是缩短查询执行时间,并减少执行查询所需的资源量。查询执行时间取决于所需资源数量、数据库系统可用资源、查询复杂度、查询参数和执行计划等因素。命令执行时间过长可能表明存在各种问题。例如,规划器选择了低效的计划,就可能表现为执行时间长且资源消耗过多。长事务可能源于应用设计不佳,以及应用一侧的事务管理存在问题。从应用角度看,数据库系统中的操作执行时间过长,可能导致应用自身处理查询超时,或者在没有配置超时时表现为卡死;还可能耗尽数据库连接并导致应用异常停止。管理员的日常工作包括跟踪命令执行时间、调查并消除运行缓慢的原因。DBA 往往需要与应用开发团队共同解决这些原因。
pg_stat_activity 中有几个字段可用于跟踪命令和事务的执行时长:
xact_start— 事务开始时间。如果当前没有活动事务,或者事务中发生了错误但事务没有关闭,即处于idle in transaction (aborted)状态,则该值可能为空(NULL);query_start— 当前查询开始的时间(active状态),或者会话中最近一次执行的查询开始时间(其他所有状态)。
可以使用下面这种查询获取查询和事务的执行时长:
这个查询有几点需要注意:
确定状态时使用了包含等待事件的扩展逻辑。事件类型为
wait_event_type = 'Lock'的进程会被视为正在等待并发事务完成的进程。查询条件筛选的是事务,而不是单独的查询:
OR左侧查找活动事务,右侧查找已取消(aborted)但尚未关闭的事务。原因如下:即使查询在事务之外单独执行,它实际上也使用事务机制,本质上是只包含一条命令的事务。在这种情况下,即使是普通查询也会填充xact_start字段(此时它等于query_start)。因此没有必要专门查找查询;它们无论如何都会出现在结果中。OR右侧用于查找已取消事务的条件使用了state字段。这样做是因为事务内部发生错误时,xact_start会被设置为NULL,但事务本身仍然保持打开。为了不漏掉这类事务,应依据query_start——即发生错误并结束的那个查询的开始时间。修改区间值可以把非常短的事务从结果中排除。
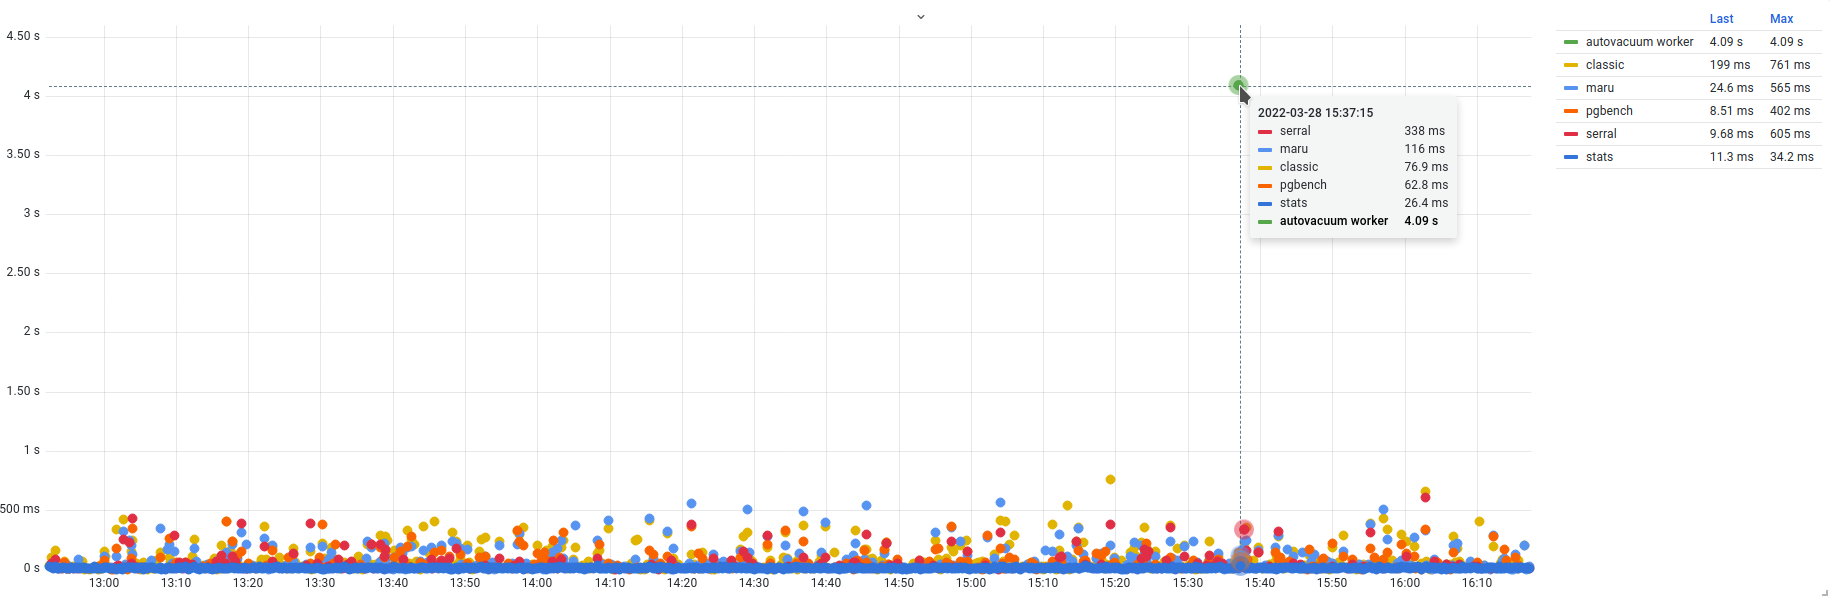
借助指标 postgres_activity_max_seconds 可以获取事务的最长持续时间。该指标包含多个标签:
user— 发起活动的用户;database— 客户端连接到的数据库;type— 活动类型:用户查询或后台维护(自动清理或收集规划器统计信息时);state— 会话状态,对应state字段,并考虑了waiting状态。
利用这些标签,可以按所需的维度聚合多个指标。例如,下面的查询可以按具体用户显示长时间活动,而不考虑活动类型、数据库和状态:
图 2.9 展示了根据这个查询生成的图表示例。从图中可以看出,大部分查询的执行时间不超过 500 毫秒。有一个自动清理进程比较突出,在当时已经运行了大约 4 秒。需要注意,这个指标及其图表并不显示数据库系统中发生的全部活动,而只显示查询 pg_stat_activity 时刻正在发生的活动。
2.7. 锁等待时间跟踪
进程在等待期间无法进行有用工作,直到等待原因消失。长时间等待本身就意味着资源和时间使用效率低下。找出并消除发生等待的环节,可以加快工作负载执行,提高系统整体性能。下面讨论锁上的耗时,因为目前没有一种能够保证准确确定特定事件等待时间的方法。
使用 pg_locks.waitstart
要评估等待时间,需要使用 pg_locks.waitstart 字段。如果进程没有处于等待状态,该字段的值就为空。如果进程无法获取锁,就会进入等待,该字段显示进程进入等待的时间。这里还存在与同一视图另一个字段的隐含联系:不仅 waitstart 表示正在等待锁,granted 标志也表示这一点。不过两者并不完全同步;当 granted 已经设置为 false 时,waitstart 仍可能在很短时间内保持为 NULL。
评估等待时间时,至少可以采用两种计算方法(实践中还可能遇到更多方法)。可以用下面的查询获取当前所有进程的等待时间:
第一种计算方法是把所有进程的所有等待相加。这样得到的是总等待时间;这个值越大,情况越糟,尤其是在并发性很高的系统中。这种方法适合总体评估数据库系统花费了多少时间等待。
第二种方法只统计所有进程中的最大等待时间。这样得到的情况只对应等待时间最长的一个进程。这种方法适合实时监控,用来了解某一时刻是否存在(或曾经存在)一个进程,它等待了特定的一段时间。
从原始查询中删去多余字段,并把它放入 CTE,就可以同时得到这两个值,还能计算等待进程的数量:
从输出可以看出,查询时刻有 6 个进程在等待,等待时间最长的约为 284 毫秒,所有数据库客户端合计等待了大约 1 秒。在测试环境的合成负载下,这些数字可能显得微不足道,但在真实环境中,数值可能会大得多。及时发现并缩短等待时间,可以提高应用和数据库系统的性能。
当前使用的代理的默认实现会收集所有进程中的最大等待时间。可以使用下面的查询获取等待统计信息和图表(图 2.10):
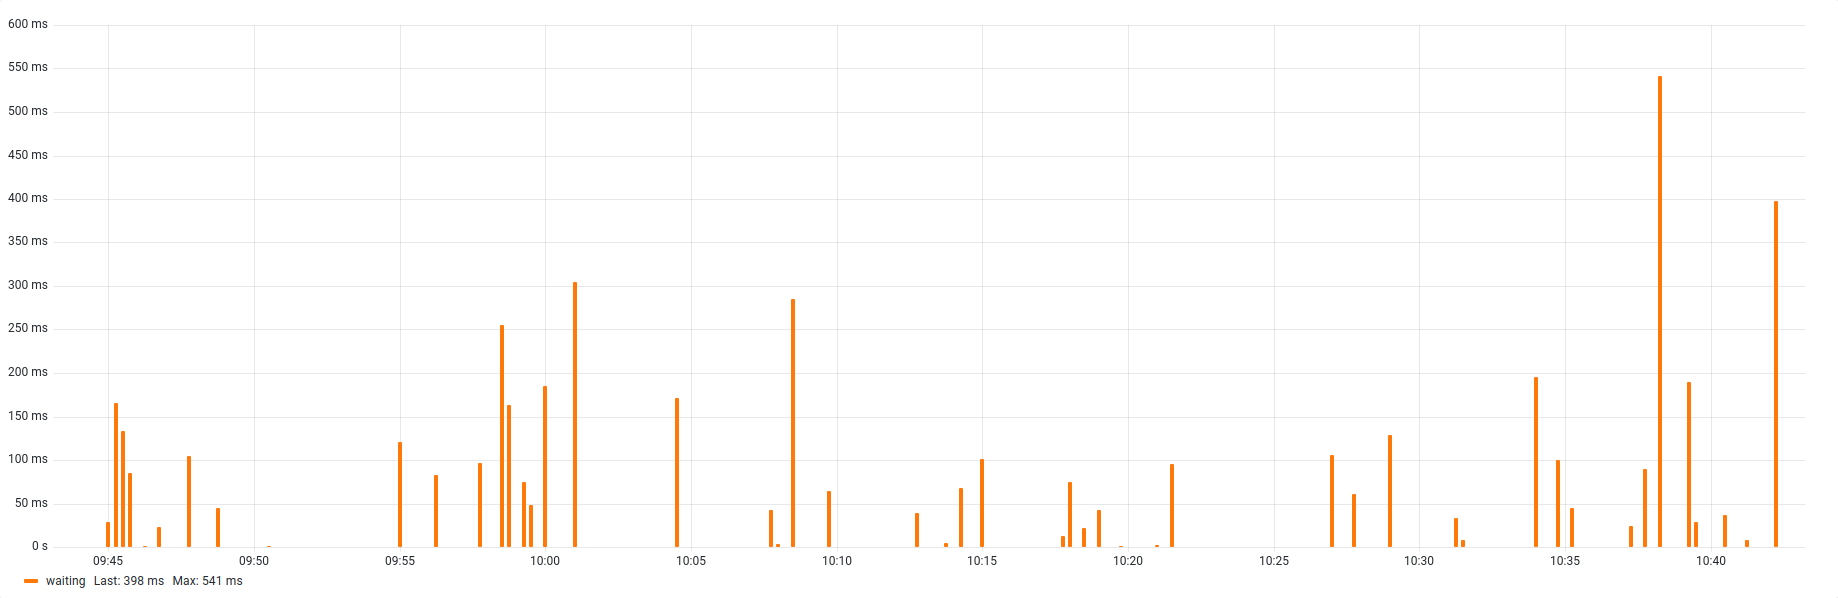
锁等待没有超过 1 秒,对测试环境来说可以接受。但实际情况很可能比图表显示的稍差,因为 pg_locks 不会累积统计信息,因此无法提供锁情况的完整视图。
使用 pg_stat_activity.state_change
在 PostgreSQL 14 以前,pg_locks.waitstart 字段不存在,但跟踪等待时间的需求一直存在。在这些数据库系统版本中,可以使用 pg_stat_activity.state_change 字段提供一种精度较低的方法。该字段保存状态从前一个状态切换到当前状态的时间戳。如果等待被包含在活动状态中,那么当进程具有等待标记时,可以把处于活动状态的时间视为等待时间。这种方法的缺点是,进程切换到活动状态后,等待可能不会立即开始,而是在一段时间后才开始,但整个期间都会被计入等待时间。在包含正确来源 pg_locks.waitstart 的 PostgreSQL 14 中,可以很容易演示这一点。
为了演示,需要一张小表,例如由标准 pgbench 脚本创建的表。在实验中,这张表包含 50,000 行。需要打开到数据库系统的三个会话:第一个和第二个会话用于重现查询被阻塞的测试场景,第三个会话用于跟踪统计信息。在第一个会话中,需要打开事务并更新测试表的最后一行,同时保持事务打开:
在第二个会话中,需要先获取进程的 pid,然后启动对整张表的更新。
在第三个会话中,应从 pg_stat_activity 和 pg_locks 获取统计信息。条件指定只输出进程标识符为 2291758 的第二个会话。为了便于跟踪,第一次执行查询后可以运行元命令 \watch 1,让查询每秒重复一次。
我们关注查询输出中的 state_age 和 wait_age 字段,它们将展示两种进程等待时间计算方法的差异。整张表的更新会持续执行,直到到达此前在仍未关闭的事务中已经更新过的最后一行。
这里可以看到,进程处于 active 状态,状态切换时间 state_age 在增加。granted = true 表示没有锁等待,查询正在工作。过一段时间后,查询执行会停下来,此时可能看到类似下面的结果:
输出中出现了一行未能获取的锁,其状态为 granted = false,并且 wait_age 开始计时。与此同时,state 的值保持不变,state_age 没有重置,仍在继续计时。这个例子表明,查询在开始等待锁之前进行了大约 9 秒的有用工作。实际上,等待是在查询运行 9 秒后才开始的。这种行为正体现了使用 waitstart 和 state_change 进行统计时的差异。如果决定重现实验,请不要忘记最后取消或关闭事务,这样第二个会话中的查询才能结束。
使用基于 state_change 的时间统计时,应记住这种行为。例如,在主要由短而快的查询组成的 OLTP 负载中,它不会严重扭曲统计信息,这种计算方法可能看起来可以接受。但对于更长的 OLAP 查询(如上面的实验),统计信息可能不准确,等待时间会不恰当地包含有用工作的执行时间,这种计算方法就可能值得怀疑。
2.8. 锁树
实践中经常会出现这样的情况:某些时刻有很多进程在等待锁,其中一部分进程又被其他进程阻塞。如果此时找到并消除锁的来源,其他进程很可能就能正常继续工作。然而,如果没有准备好的工具,很难准确识别出导致所有这些锁的进程。可以直接分析 pg_stat_activity 和 pg_locks 的输出,但这样做不方便,也可能耗费很长时间。要确定锁的来源,需要找出进程之间的依赖关系,并在被阻塞进程与阻塞进程之间建立依赖树。这样的可视化可以快速确定锁的来源并消除它。解决这类问题的方法并不新颖,在互联网上可以找到多种用于输出锁树的实现。这些查询都基于 pg_stat_activity 和 pg_locks,通常会占据数页篇幅,因此这里不再列出。为了便于使用,最好把这类查询封装成视图。
我以这个查询10为起点,并对它做了少量修改。最终查询位于本书代码仓库的 playground/scripts/locktree.sql 文件中11。该查询的关键特点是使用 pg_blocking_pids 函数。这个函数接收进程标识符,并返回阻塞该进程的进程列表。这样很方便,也可以避免使用 pg_locks;不过根据文档,频繁调用该函数可能损害数据库系统性能,因为函数会短暂地独占锁管理器的共享状态。无论如何,这个函数很实用,偶尔用于搜索问题通常不会有问题。但不应为了监控而定期使用它,例如用它采集指标。在某些运行条件下(负载很高、对延迟有要求),即使只为调试,这一特性也无法接受;此时可以使用 pg_locks12 代替 pg_blocking_pids。
下面看一看如何在测试环境中获取锁树的两个示例。
第一个示例中的锁经常出现在并发更新数据时。输出中的每一行描述一个进程,并根据 pg_stat_activity 展示该会话的详细信息。下面看一看这个查询中的字段:
pid— 进程标识符;blocked_by— 阻塞当前进程的进程列表。根据pg_blocking_pids函数计算;state— 进程状态;根据条件wait_event_type = 'Lock',其中补充了伪状态waiting;wait— 由wait_event_type和wait_event组成的等待标记;wait_age— 根据pg_locks.waitstart计算的进程等待时长;tx_age— 事务时长;
usename— 用户名;datname— 数据库名;blkd— 被该进程阻塞的其他进程数量;query— 查询文本。包含进程标识符,以及该进程在所属锁树分支中的层级。
可以把所有进程大致分成几组:每组都有一个没有被任何进程阻塞的主要锁来源,也有被阻塞的进程,而这些进程还可能阻塞组内的其他参与者。我们仔细看看最后一组,其中阻塞其他参与者的主要进程的标识符是 2072424。从查询文本可以看出,这是提交事务(END 或 COMMIT);该进程处于活动状态,等待标记为 LWLock.WALWrite。这表明系统正在写入 WAL,在写入完成之前,客户端无法发送其他命令或打开事务。这种行为符合默认使用的同步提交模式(参见 synchronous_commit)。从 blkd 字段可以看到,该事务提交还阻塞了下面几行所描述的另外 4 个进程。通过 pid 和 blocked_by 字段,可以跟踪进程之间的关系以及谁阻塞了谁。query 字段中的点号还可以方便地表示锁深度。同一字段中的查询文本显示,有 3 个进程试图根据条件 WHERE bid = 8 更新同一行。这一行很可能是在当前正在提交的事务中更新的,因此形成了等待队列。state 和 wait 字段表明,这 4 个进程都在等待锁。根据 wait_age 字段,等待时间不到 1 秒,这对测试工作负载来说完全可以接受;但在生产负载中,即使这么短的等待也可能导致应用延迟。usename 和 datname 字段指出了锁是以哪些用户的身份、在什么数据库中产生的。
再看一个可能出现在测试环境中的锁树示例。
这个示例中的锁来源是执行清空表命令(TRUNCATE)的进程。这是一个相当快的操作,实质是把数据文件替换为空文件;不过它首先必须等待此前针对目标表启动的查询完成。清空表时表会被锁定,因此所有访问该表的进程都必须等待命令完成。blkd 字段显示,TRUNCATE 进程(pid = 161)还阻塞了 20 个进程的执行。其中大约一半试图向被清空的表插入行,这些进程的 blocked_by 字段都包含 TRUNCATE 进程的标识符。另一部分进程是更新操作,它们又在等待插入完成。可以通过把 blocked_by 中的标识符与执行插入的进程的 pid 字段进行匹配来确认这一点。还可以匹配查询中的 bid 字段:它会在各条等待查询链中保持一致。例如,进程 955 更新 bid = 20 的行,并等待进程 1942 中的插入完成;而进程 1942 自己又在等待 TRUNCATE 命令完成。执行 TRUNCATE 的进程的状态和等待标记表明,该进程处于活动状态,正在把 WAL 段与磁盘上的文件同步(通过调用 fsync,或使用参数 wal_sync_method 指定的其他方法)。确定等待原因的另一种方法,是检查数据库系统服务器日志中的锁记录,前提是启用了 log_lock_waits 参数,且等待时间超过 deadlock_timeout 参数的值(默认是一秒)。
上面两个案例都属于测试环境中的工作负载,其特点是事务和锁都很短。实践中情况可能复杂得多,尤其是锁的来源为空闲事务时,它们可能不可预测地长时间持有锁,并可能导致故障。在这类情况下,通常的处理方式是强制结束进程。遇到关键情况时,重要的是快速判断并找到根进程,结束它就能解决问题。如果信息不足,往往只能不加区分地结束大量进程。而使用类似上面查询的工具,就可以更准确地确定并消除锁来源,让其他进程继续工作。
总结
客户端活动统计信息有助于了解数据库系统中正在发生什么。
数据库系统提供了三个关于客户端活动的重要数据源:
pg_stat_activity、pg_locks和pg_stat_database视图。数据库管理员和监控工具都通过 SQL 查询从这些视图中获取数据。
客户端会话在其生命周期中可能处于不同状态。
事务活动有助于快速评估数据库集簇中的负载。
必须及时跟踪并消除危险的等待和锁。
应消除事务处于空闲状态的情况,或将其保持时间降至最低。
客户端活动的持续时间会直接影响性能。
锁等待会降低数据库系统和应用的性能。
锁树可以快速找出锁的来源。
postgrespro.ru/docs/postgresql/current/sql-select#SQL-FOR-UPDATE-SHARE ↩︎
postgrespro.ru/docs/postgresql/current/monitoring-stats#WAIT-EVENT-LOCK-TABLE ↩︎
postgrespro.ru/docs/postgresql/current/explicit-locking#LOCKING-TABLES ↩︎
github.com/lesovsky/pgscv/commit/d098923caef2d1a839df76ad9f441893640faed5 ↩︎
postgrespro.ru/docs/postgresql/current/monitoring-stats#MONITORING-PG-STAT-ACTIVITY-VIEW ↩︎
github.com/lesovsky/postgresql-monitoring-book/blob/main/playground/scripts/locktree.sql ↩︎
3 查询与函数的执行
本章将讨论:
为什么需要监控查询;
pg_stat_statements扩展;查询元数据;
查询规划和执行统计信息;
pg_stat_statements的实际使用示例;在所有统计信息来源间进行跨来源查询识别;
基于
pg_stat_statements的报告示例;pg_stat_statements_info视图;pg_stat_user_functions视图。
上一章我们介绍了后端进程和会话、相关统计信息,以及利用这些统计信息进行监控的示例。本章将深入客户端会话内部,了解分析工作负载的方法。客户端发送的查询决定了工作负载;数据库服务器执行这些负载的效率决定了系统的整体性能。数据库系统的统计信息使管理员能够从不同角度考察负载,将工作负载中的查询流拆分为单条查询。逐条考察查询,可以找到优化的切入点,最终改善数据库系统的整体性能。
3.1. 为什么需要监控查询
建立连接并配置会话后,数据库系统就可以执行客户端命令。客户端可以通过命令查询和修改数据(DML 命令)、管理模式对象(DDL 命令)、执行实用操作等。完整的命令列表请参见官方文档1。可以将查询(queries)看作工作负载中的基本执行单位,它们通常是提取和修改数据的命令:SELECT、INSERT、UPDATE、DELETE。
命令、语句,还是查询?
除了查询这个术语外,文档中还会出现语句(statement)这个术语。它的含义更宽泛:“语句”涵盖所有现有命令,而“查询”只是其中返回结果或修改数据的命令子集。在本章后文中,我将用更熟悉的“查询”代替“命令”和“语句”。
查询、查询数量和类型,以及其中涉及的数据库对象,共同构成每个数据库系统独有的工作负载特征,而执行这些查询需要消耗资源。针对各类查询进行优化,最终可以改善数据库系统自身的资源使用,并显著提升性能(或者减少原先必不可少、优化后已显多余的资源分配)。
实践中经常可以看到这样的尝试:通过寻找设置中的某个神奇参数来解决性能问题,打开它就能让一切立刻加速。遗憾的是,这类参数带来的“加速”会牺牲系统的稳定性或可靠性,因此必须提前认真评估风险。更重要的是,这种方法无法带来性能质的提升,也无法达到只有优化查询才能实现的惊人效果(速度提升几个数量级)。最恰当的做法是重构查询;在简单情况下,则是针对特定查询类型添加索引。因此,了解系统执行了哪些查询,是未来优化性能的关键。
可以使用多个视图来评估工作负载特征和正在执行的查询:
pg_stat_statements— 由同名扩展提供的查询累计统计信息视图;pg_stat_user_functions— 用户定义函数执行统计信息视图。
除了这些标准工具外,社区还基于 pg_stat_statements 开发了其他工具:
pg_stat_kcache2 — 该扩展收集后端进程中各个查询实际使用系统资源的统计信息。统计信息通过系统调用getrusage3 进行收集,这可能会对 Linux 以外的平台造成一些限制;pg_stat_monitor4 — 该扩展定位为pg_stat_statements的补充,提供了更丰富的查询评估能力:按时间区间聚合统计信息、收集执行计划、统计查询涉及的表等。
这些扩展会添加单独的视图,用新的能力补充 pg_stat_statements 的功能。不过,我把对它们的研究留作读者的课后作业。
3.2. pg_stat_statements 扩展
pg_stat_statements 视图是数据库系统中所有查询统计信息的主要来源之一。该视图是同名扩展的接口,扩展跟踪查询执行阶段并保存累计统计信息。扩展会保存所有成功执行的查询的统计信息。如果查询执行出错(或被管理员中止),其统计信息就不会保存;这可以算作资源统计方面的一个缺点。
默认情况下,pg_stat_statements 扩展处于关闭状态,但建议始终启用它。可以按以下步骤操作:
在 shared_preload_libraries 参数中指定该扩展,然后重启服务器。这是为了预留共享内存空间;共享内存只在启动时初始化,数据库系统运行期间无法动态地从已经分配的共享内存中获取空间。
重启数据库系统后,需要在某个具体数据库中安装扩展。任何数据库都可以,例如默认情况下始终会创建的
postgres数据库。虽然扩展安装在一个具体数据库中,但它会全局收集所有查询的统计信息,与查询在哪个数据库中运行无关。使用命令CREATE EXTENSION pg_stat_statements;完成安装。
测试环境中已经安装并配置了 pg_stat_statements 扩展,因此不需要额外操作。安装扩展后,统计信息会自动开始收集。可以通过对 pg_stat_statements 执行一个统计视图行数的简单查询来确认:
目前已经积累了 113 个查询类型的统计信息。即使查询非常相似,其参数值也可能不同。把参数取值各不相同的查询逐一保存在统计信息中,会造成冗余,因为查询可能包含数百甚至数千个参数和不同的值。因此,收集过程中会对每个查询执行规范化:把具体参数替换为 $1、$2、$3 等形式的编号占位符。规范化可以把查询归入某个类型,并统计该类型使用的资源量。
除了主视图外,还会安装另一个视图 pg_stat_statements_info,其中包含扩展自身运行的元数据;两个视图都基于同名函数。扩展还提供了实用函数 pg_stat_statements_reset,用于重置累计统计信息。
除了必须在 shared_preload_libraries 中指定外,该扩展还有多个配置参数,可以根据数据库系统的不同运行条件调整扩展的工作方式:
pg_stat_statements.max — 扩展跟踪的查询类型最大数量,对应视图中的行数。当记录的查询数量很多时,不常更新的部分统计信息可能被删除。可以通过
pg_stat_statements_info.dealloc了解删除情况。该参数只能在服务器启动时设置。实践中默认值(5000)通常足够,但对于查询种类很多的生产服务器,最好一开始就至少增加一倍,以免将来重启数据库系统。pg_stat_statements.track — 要跟踪的查询层级。可选值:
— top — 跟踪顶层调用,即客户端请求的调用。默认开启;
— all — 跟踪所有调用,包括函数和过程中嵌套的调用;
— none — 关闭统计信息的收集和保存。
如果存在存储过程和函数,设置为 all 是有意义的,这样可以获得正在执行的工作负载的更详细统计信息。
pg_stat_statements.track_utility — 是否跟踪不同于
SELECT、INSERT、UPDATE和DELETE等 DML 查询的实用命令统计信息。如果基于pg_stat_statements视图构建性能报告,启用该参数可以更完整、更准确地展示工作负载。但要记住,被跟踪的实用命令也会占用内存,当达到 pg_stat_statements.max 时,统计信息可能被删除。pg_stat_statements.track_planning — 是否收集查询规划统计信息。默认关闭,因为它可能降低性能,尤其是在大量客户端执行结构相同的查询时(OLTP 负载就具有这种特征),因为这会造成对相同统计信息项更新的竞争。
pg_stat_statements.save — 是否在服务器重启或关闭时保存统计信息。默认开启,通常可以保持不变。
可以在主配置文件 postgresql.conf 中指定上述参数。大多数参数只需重新加载配置即可生效(修改 pg_stat_statements.max 需要重启)。
关于扩展运行方式的更多细节,请参见官方文档5。
pg_stat_statements 中的全部统计信息大致可以分为几类:
查询及其元数据;
规划统计信息(从 PostgreSQL 13 和
pg_stat_statements1.8 开始提供);执行统计信息;
资源使用统计信息 — 这里指从数据库系统角度看到的资源使用情况;从操作系统角度看,它可能呈现略有不同的形式,后文会单独提到;
WAL 写入统计信息(从 PostgreSQL 13 和
pg_stat_statements1.8 开始提供);JIT 编译器统计信息(从 PostgreSQL 15 和
pg_stat_statements1.10 开始提供)。
可以看到,不同统计信息会在扩展的不同版本中出现。升级数据库系统主版本时,也应同时升级扩展。
后续各节将逐步考察所有统计信息类别。
3.3. 查询元数据
查询文本及其元数据可以区分不同查询,也为查找发送查询的应用提供切入点。查询及其元数据由多个字段表示:
userid— 执行查询时所用用户的标识符。可以通过与pg_user连接,或使用pg_get_userbyid函数查找用户名;dbid— 执行查询所在数据库的标识符。可以通过与pg_database连接来查找数据库名,但没有根据数据库标识符获取数据库名的函数;queryid— 根据查询文本计算出的查询标识符。它不受用户名或数据库名影响;如果相同的查询在其他数据库中或由其他用户执行,这些查询的queryid值也会相同;query— 规范化后的查询文本。规范化会把参数值不同的多个同类查询合并为一个通用查询类型,其中具体值被编号参数替换;
toplevel— 查询调用层级:顶层调用为true,如果调用嵌套在过程中或函数中则为false。如果 pg_stat_statements.track 设置为top,该字段始终为true。创建性能报告时,可以用这个标志过滤嵌套调用,不统计它们的统计信息,因为这些信息已经包含在顶层查询的统计信息中。不使用这个标志可能导致统计信息被重复计算,报告也会因此错误。
译注:queryid 的适用边界
上文保留了原书对跨数据库查询标识符的表述。按 PostgreSQL 15 的实现,queryid 根据解析分析后的查询树计算,其中包含对象的内部标识符。因此,文本相同的查询在不同数据库中、或因 search_path 不同而引用不同对象时,不能保证得到相同的 queryid。参见 PostgreSQL 15 文档中的查询标识符说明。
借助元数据,可以按单独的用户、数据库或组提取并分组统计信息:
3.4. 查询规划
规划是查询执行前的一个独立阶段。在这个阶段,规划器会考察一组执行计划,这些计划的执行复杂度和代价(cost)可能不同;代价是执行查询所需计算资源量的估计值。代价以约定的单位度量,基准是顺序访问时读取一个页面的代价。在构建出的计划中,会选择最优的计划,也就是代价最低的计划,查询将按照该计划执行。一般来说,计划取决于查询复杂度、是否存在合适的索引、规划器设置,以及统计信息与实际数据的符合程度。pg_stat_statements 中的规划统计信息可以跟踪规划次数和规划耗时总量。不过,如前所述,默认关闭规划统计信息的收集,因为对于类似 OLTP 的工作负载,收集规划统计信息可能降低性能。
pg_stat_statements 中的规划统计信息由以下字段表示:
plans— 查询规划次数;total_plan_time— 该类型查询的总规划耗时;
min_plan_time— 最短规划时长;max_plan_time— 最长规划时长;mean_plan_time— 平均规划时长;stddev_plan_time— 规划耗时的标准差。
所有时间值都以毫秒表示。
这类统计信息中最值得关注的是规划时长及其显著变化,尤其是规划次数大致不变、但查询规划耗时变长的情况。这种情况在实践中确实会发生,但幸运的是并不常见。
规划统计信息的使用场景并不多,可以从以下方面入手:
当执行查询的数量没有变化时,各类查询的规划时长可用于跟踪规划异常;
标准差表示规划时长相对于平均规划时长的波动程度。
下面以第一种情况为例。需要使用以下查询:
本章后文还会继续使用类似查询,因此有必要详细拆解它:
首先取某个具体指标作为主要数值,这里是
postgres_statements_time_seconds_total;按一分钟的时间区间,计算该指标的变化速率;
为了获得包含查询文本的标签(
query),根据共同标签database、user、queryid与指标postgres_statements_query_info进行连接;postgres_statements_query_info的值为 1,因此把它乘以 0,避免给主要指标的数值额外加上 1;对得到的变化速率指标按
queryid和query标签分组求和,因为测试环境中有多个用户共同执行相同的查询;
topk_avg函数计算时间序列所选区间内的平均值,按降序排列并取前 K 个值(本例中为 5 个),再把其余值汇总到带有other标签的第六个指标中。
上述查询会输出规划耗时最长的 5 种查询的规划时间统计信息(标签 mode="planning")。其余查询的规划时间合并到带有 other 标签的第六个指标中。
可以根据该查询构建所谓的 top-K 图表(图 3.1),这种图表在全书中会经常出现。它的便利之处在于既能显示最大的数值,也能显示其余数值的总和。
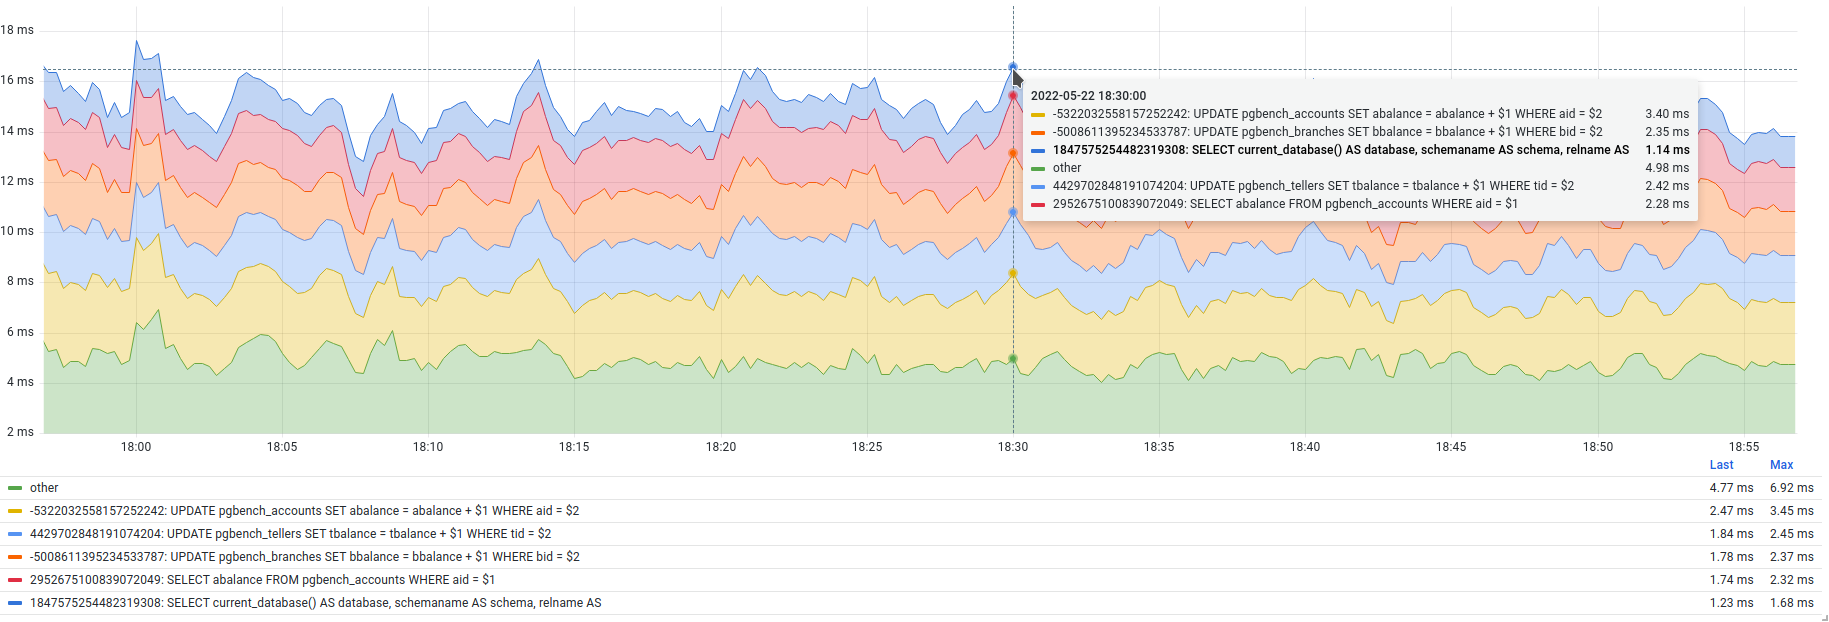
图例的每一行都包含查询标识符和文本,以及指标的最新值和最大值。对于每种查询类型,图表显示数据库系统在 1 秒实际经过时间内用于规划的机器时间。机器时间是所有 CPU 核心工作时长之和,因此在多核处理器的高负载系统中,1 秒实际经过时间内的机器时间很容易超过 1 秒。图表显示的是特定查询类型所有查询的总规划时间变化速率,理解这一点非常重要。图中标出了一个具体时刻——18:30:00;在这一秒实际经过时间内,所有核心为所有查询进行规划合计耗时约 16 毫秒(悬浮提示中给出了更详细的信息)。
译注:“机器时间”的统计口径
此处保留作者的“机器时间”称呼和解释。total_plan_time 实际累计的是各次规划从开始到结束的经过时间,并非操作系统测得的 CPU 运行时间;并发规划的累计耗时可以超过同一段实际经过时间,但不能据此直接推算 CPU 利用率。下文的 total_exec_time 同样属于执行经过时间统计,且包含等待时间,不能直接用于计算剩余 CPU 容量。依据为 PostgreSQL 15 的 规划与执行计时代码 和 区间计时实现。这里的 rate(...[1m]) 以一分钟为计算窗口,结果表示每秒的变化速率,参见 Prometheus 2.55 的 rate 说明。
规划时间图表应与基于 pg_stat_statements.plans 的规划次数图表一起考察。由于规划耗时与规划次数成正比,规划次数减少(或增加)时,耗时也会减少(或增加)。如果规划时间发生变化,而规划次数保持不变,甚至朝相反方向变化,就应当引起怀疑。
3.5. 查询执行
执行是查询生命周期中的主要阶段。在这个阶段,数据库系统利用系统资源,按照计划执行查询,并向用户返回结果。结果可以是一组行,也可以是命令标签(command tag)。执行速度直接影响当前性能和响应时间:查询执行得越快、单位时间内能执行的查询越多,数据库系统的整体性能也就越高。查询执行统计信息最有用,也最常用,因为它可以帮助我们发现查询执行过程中的异常,并立即着手优化(重构查询、添加索引等),而不必深入研究资源使用的细节。
执行统计信息由以下几个字段表示:
calls— 成功执行的查询次数。这个字段的含义与plans接近,但两个字段彼此独立,分别计数,因此数值可能不同。规划成功并不保证执行时不会出错。反过来,执行成功也不意味着此前进行了规划:对于预备语句(prepared statements),执行计划可能在准备阶段就已缓存;rows— 执行该类型的所有查询所返回(SELECT)或影响(INSERT、UPDATE、DELETE)的总行数;total_exec_time— 执行该类型查询所花费的总时间,其中也包括等待锁和事件的时间;min_exec_time— 最短执行时长;max_exec_time— 最长执行时长;mean_exec_time— 平均执行时长;stddev_exec_time— 执行时长的标准差;blk_read_time— 读取数据并将其放入缓冲区缓存所花费的总时间;blk_write_time— 写入数据所花费的总时间。
规划时间
在 pg_stat_statements 1.9 之前,表示执行时间的字段使用其他名称,其中不含 exec。引入规划跟踪后,需要添加新字段,并重命名已有字段。例如,total_time 字段更名为 total_exec_time。
译注:字段更名的扩展版本
原书此处写作 1.9,译文予以保留。PostgreSQL 13 随附的 pg_stat_statements 扩展版本为 1.8,其 1.7 → 1.8 升级脚本 已同时定义规划时间字段和带 exec 的执行时间字段,因此这次更名发生在扩展 1.8。这里的扩展版本号与 PostgreSQL 主版本号不同。
启用并安装扩展后,统计信息会自动收集,缓冲区缓存读写耗时的统计信息(blk_read_time 和 blk_write_time)除外。要统计 I/O 时间,需要启用参数 track_io_timing。与其他时间统计一样,执行时间的单位也是毫秒。
查询执行统计信息可以帮助我们了解工作负载的构成,即查询类型及其在总量中的占比。了解这些查询后,就可以直接着手优化。接下来,我们来看几个使用执行统计信息的实际例子。
调用次数最多的查询。 调用次数可以从 calls 字段取得,并用于计算当前性能。计算时,需要对所有查询的 calls 值求和:
输出的数字相当大。提醒一下,pg_stat_statements 的统计信息会在一段时间内不断累积,因此得到的是整个统计期间执行的查询总数。性能总是针对某个时间段来衡量,例如每秒或每分钟的查询数。通过简单的算术运算就能算出性能;在 PostgreSQL 中,可以使用 SQL 和 psql 客户端的 \watch 功能来计算。另一种办法是使用监控系统查询语言提供的函数:
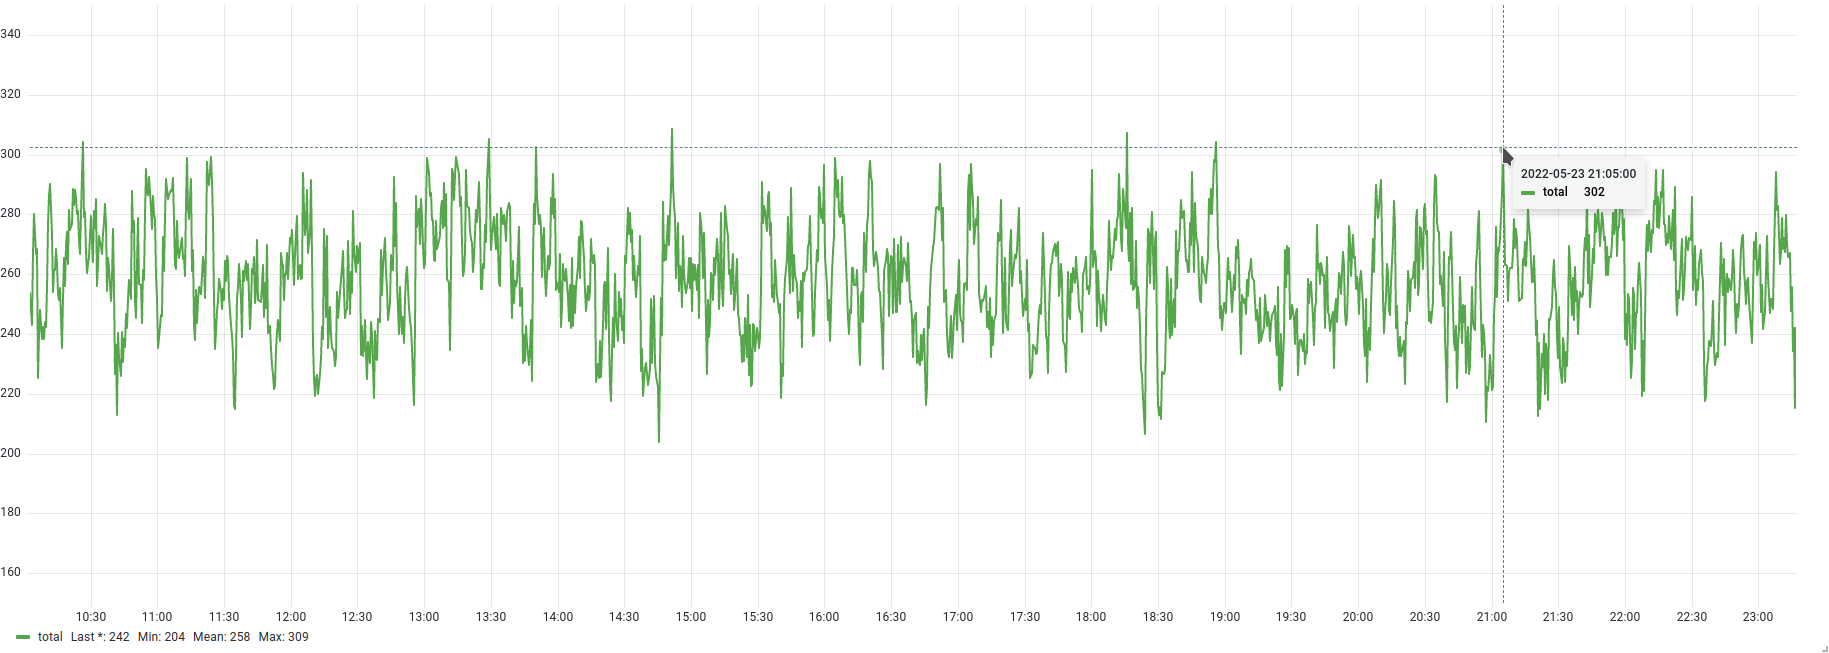
rate 函数计算 postgres_statements_calls_total 在指定时间区间(一分钟)内的变化速率,然后对所有指标求和(每种查询类型对应一个独立指标)。根据查询结果绘制的图表见图 3.2。
图表展示了查询执行频率的变化,下方图例给出了这段时间的聚合值。例如,在大约 12 小时内,平均执行频率为每秒 258 次查询。
这种图表能让我们大致了解当前的工作负载;工作负载发生变化时,也能看到性能的变化,尤其是波动较大的时候。去掉对所有指标求和的步骤,就能看到更详细的情况,确定各类查询在总执行量中的占比。这样便可以知道哪些查询执行得最频繁,以及优化时应重点关注哪些查询。
使用 SQL,也可以通过以下查询得到类似结果:
查询结果显示了执行最频繁的十种查询。不过,这里又出现了“大”数字,表示整个收集期间累积的统计总量。这些数字适合用于生成报告,但在实时监控中,负载并不恒定,重要的是能看到查询执行频率的变化。
图表可以展示这一情况的动态变化,我们先使用下面的查询:
根据这个查询,可以得到如下图表(图 3.3):
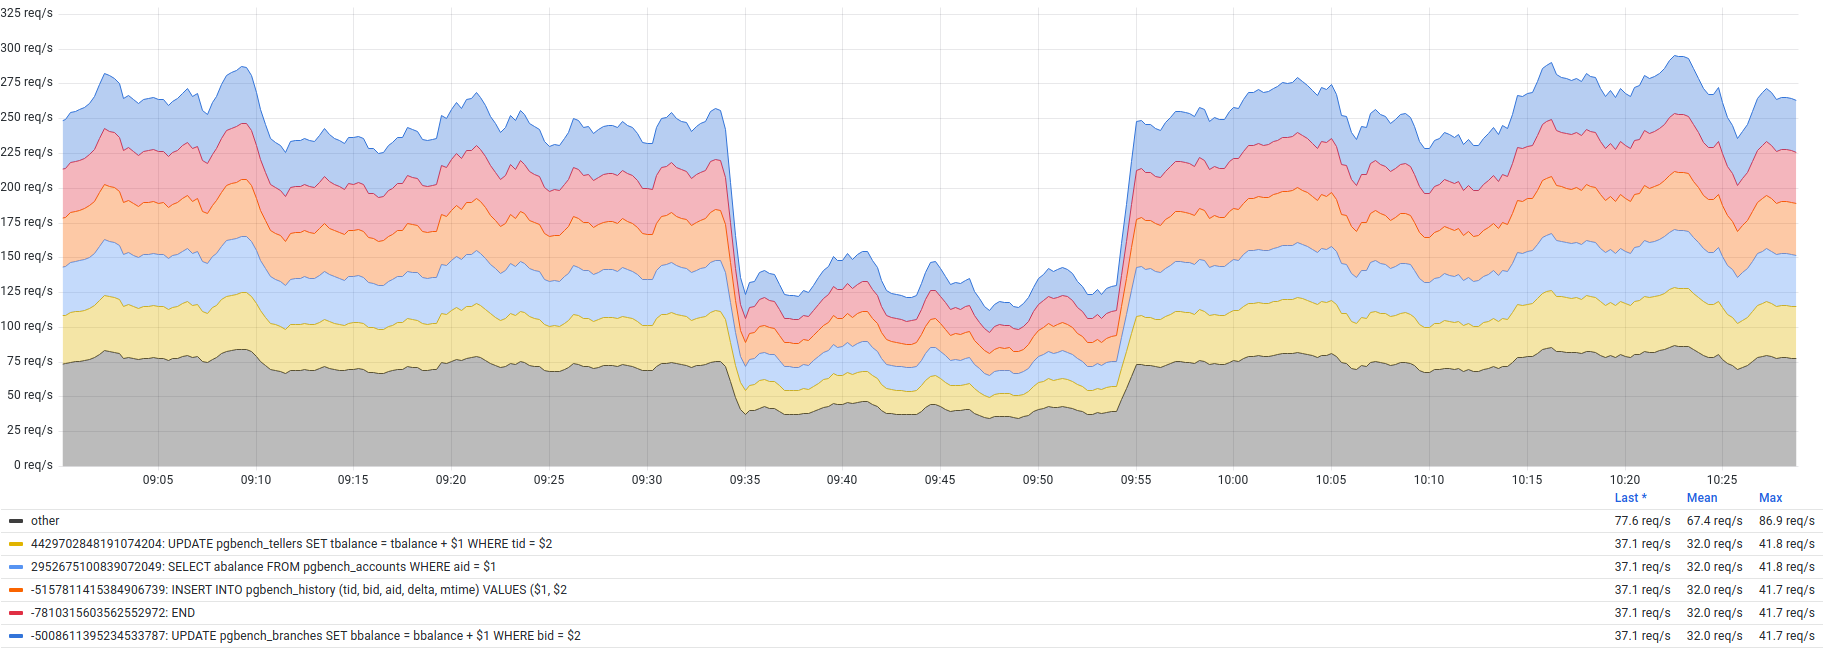
这张图同样展示了当前性能,但细节更多。可以看到哪些查询在工作负载中占比最大、执行最频繁。其余查询也出现在图中,合并为带有 other 标签的指标。工作负载的数量发生变化时,例如应用实例数(或同时工作的用户数)变化,图上就会有所体现:图中的下凹是关闭一个应用所致。不过,需要注意,查询执行次数多并不意味着资源消耗大。接下来,我们将通过例子说明,如何获取资源使用信息,并找出在工作负载中占据较大份额的查询。
影响行数最多的查询。 分析 OLTP 工作负载时,按影响行数对查询排序很有用。这类工作负载中的查询通常只返回少量行。如果查询返回大量行(数千行乃至更多),可能表明应用设计存在问题:执行查询的客户端不太可能需要这数千行中的全部数据。也许查询漏写了 LIMIT 关键字,也许应用自行处理这些行,而这些处理原本可以在数据库系统中完成。可以用以下方法找出这类查询:
与按查询执行次数排序时一样,total_rows 字段中也是很大的数值。使用以下查询,可以在监控中看到这一情况的动态变化:
对应的图表见图 3.4:
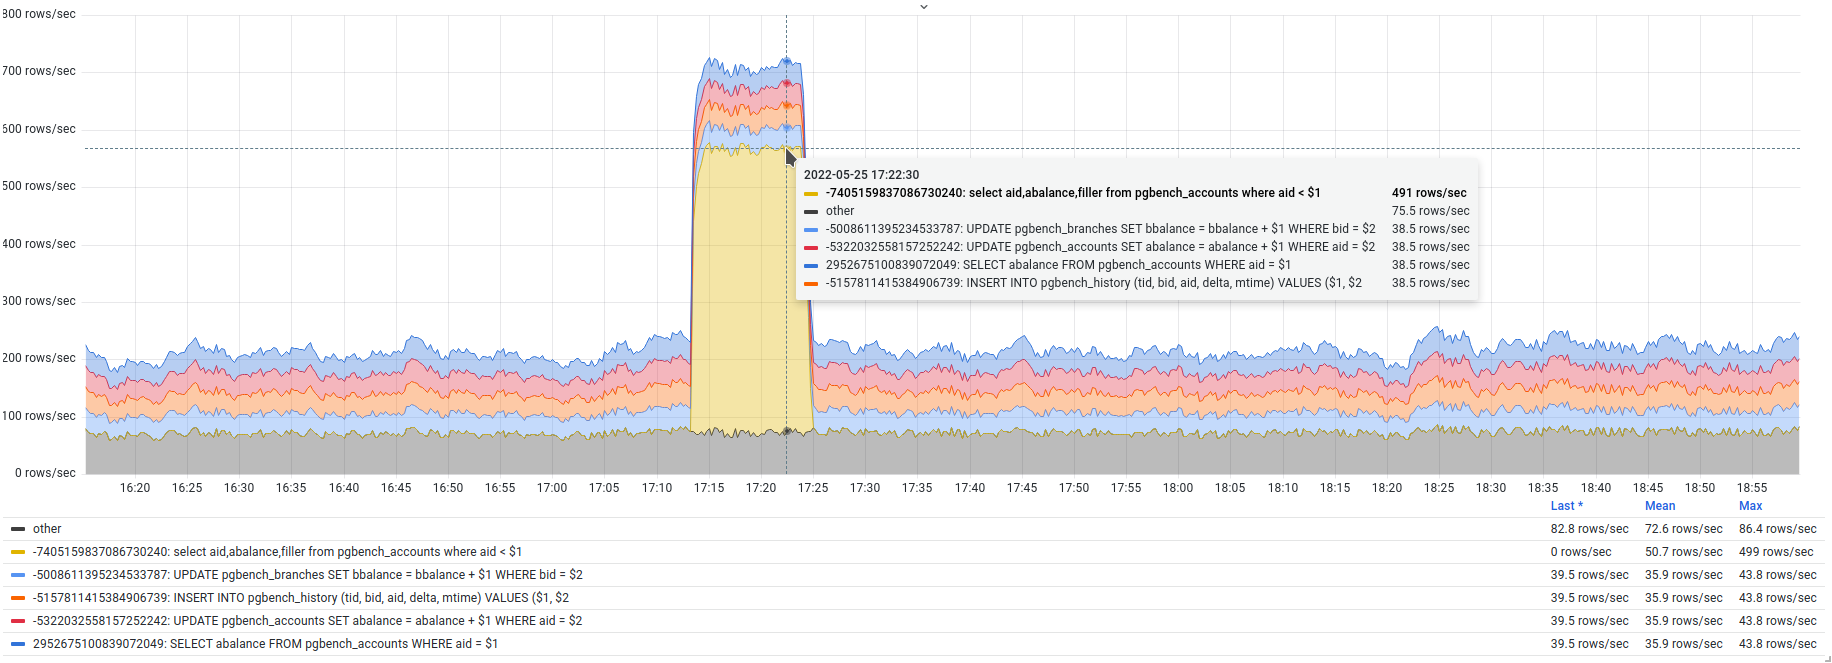
如果工作负载稳定、没有剧烈波动,这张图就会相对平稳,几乎任何异常查询都能明显地凸显出来。在这个例子中,可以通过一个简单查询观察到这一点;我们在 psql 中用 \watch 1 命令循环执行它:
这个查询每秒返回约 490 行,而与它最接近的其他查询平均只返回 35 行,图中的差别很明显。在实践中,漏写 LIMIT 关键字的查询通常就是这个样子。例如,查询可能使用排序;为了满足查询条件并进行后续排序,数据库系统会扫描大量行,还会把这些行发送给客户端,导致数据库系统和应用两侧都产生过量的资源消耗。如果这是一条定期执行的查询,而非一次性任务,就需要分析查询是否符合技术需求。如果查询的写法确实符合设计意图,则应检查使用该查询的功能所对应的业务需求,判断访问如此多的行是否合理(即使是分页,也有办法只读取所需的行)。
执行耗时最多的查询。 作为工作负载的组成部分,查询最重要的特征是执行时间。缩短查询执行时间可以提高数据库系统的性能:释放出来的资源可以用于执行更多查询。要找出执行耗时最多的查询,可以使用与前面类似的查询:
提醒一下,total_exec_time 字段以毫秒存储时间;为了方便阅读,这个查询将其转换成了常见的时间格式。还可以把规划时间 total_plan_time 加进来,得到包含规划在内的查询总耗时。
结果中有一条查询格外突出:它的累计执行时间约为 105 小时,是第二名的七倍。执行这个查询占据了工作负载的大部分。不过,有一个重要细节还没有体现出来:这些统计信息覆盖了多长时间?一天内累积 105 小时机器时间,与一个月内累积同样的时间,代表的工作负载完全不同。要回答这个问题,可以查看 pg_stat_statements_info.stats_reset:
这里的统计信息累积了 17 天,也就是说,我们关注的查询平均每天执行约六小时。考虑到一天还剩 18 小时,这个数字其实不大;如果再乘以可用的处理器核心数,可用的时间就更多了。
现在转向监控,观察查询执行时间的动态变化:
根据这个查询,可以得到图 3.5 所示的图表。
图表展示了各类查询执行时间的变化(标签 mode="executing")。可以看到,数据库系统的大部分时间都花在执行同一类型的查询上,执行其余查询所需的时间要少得多。这里还应注意时间的剧烈波动:我们关注的查询在 83 到 1900 毫秒之间波动,这值得怀疑。在相对稳定的工作负载中,执行时间的变化范围应当小得多(整个样本的标准差应接近零)。原因在于执行时间也包含等待时间,而上一章已经说明,测试工作负载中经常出现锁等待。等待其他事务会使查询的执行时间大幅波动,这一点反映在图中。
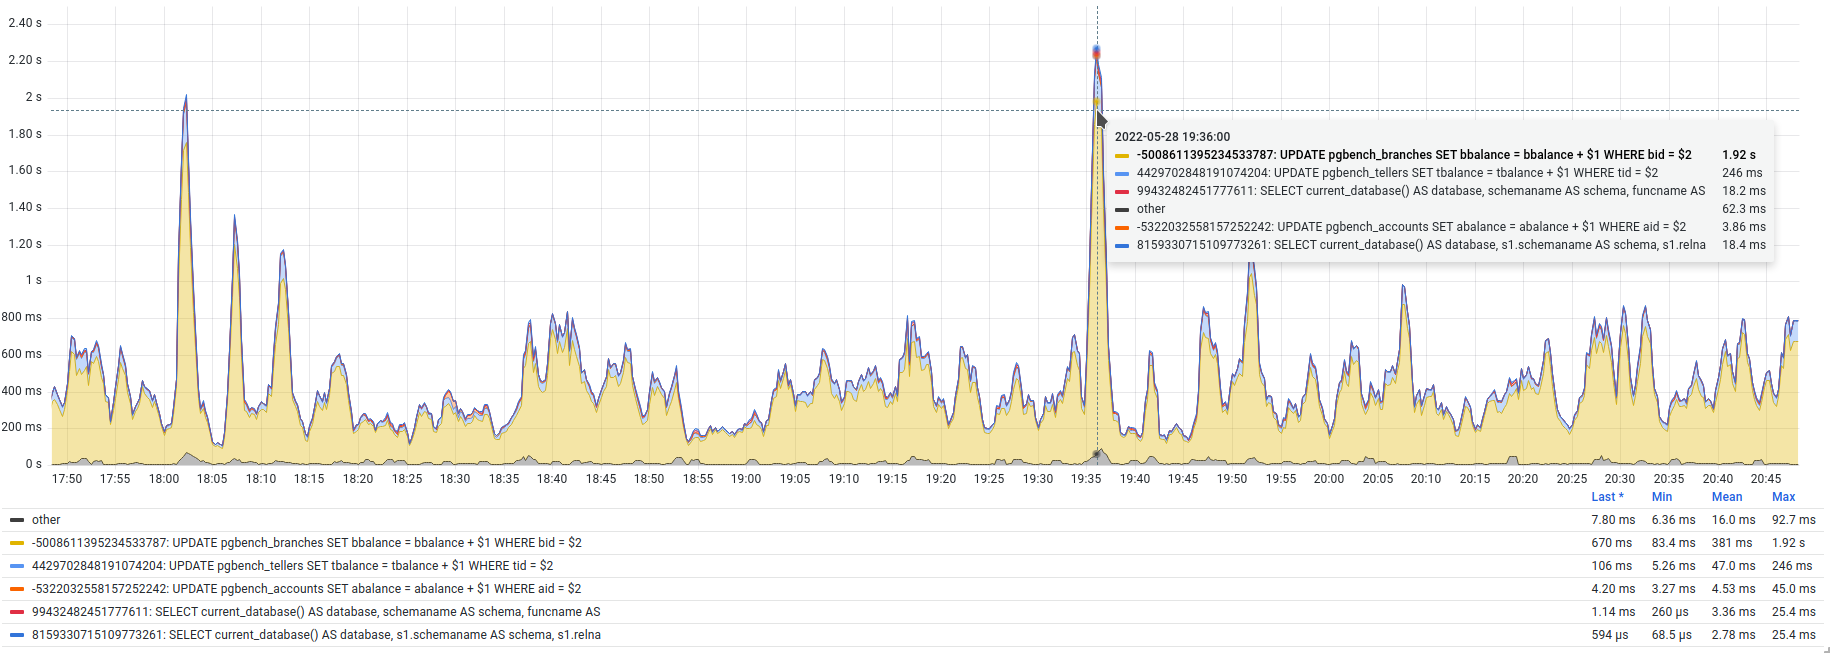
在实践中,这是最常用的图表之一,因为它能帮助我们迅速找出需要关注的查询,并立即着手优化。很多时候,只需创建索引就能大幅缩短查询的执行时间。情况更复杂时,则需要重构查询,或者像测试工作负载这样,采取措施减少资源竞争。
I/O 耗时最多的查询。 块 I/O 耗时是工作负载的另一个重要特征。它可以显示数据库系统将数据读入缓冲区缓存(shared buffers)以及从中写出数据所花费的时间,也能在一定程度上反映缓冲区缓存是否够用。如果缓存中没有所需数据,数据库系统就会请求操作系统读取,很可能需要读盘。访问磁盘比访问内存中的缓存慢,会对查询执行时间产生不利影响。所需数据也有可能位于页缓存(page cache)中,这时读取同样很快,只是会有一些额外开销。
pg_stat_statements 中有几个字段记录块 I/O 耗时:
blk_read_time和blk_write_time统计共享缓存和本地缓存中页面的 I/O 时间;temp_blk_read_time和temp_blk_write_time统计临时文件中页面的 I/O 时间。
只有启用参数 track_io_timing 才会收集这些统计信息。根据经验,建议始终启用它(不过,额外开销可能达到 1% 左右)。有了这些统计信息,就能找出经常需要访问磁盘的查询,并安排优化或增加资源。
可以分别计算读取和写入的统计信息,也可以把二者合并统计。实践中通常采用后一种方式:
大部分 I/O 时间都花在一种查询上。这与前面执行耗时最多的查询并不是同一条。分析这类查询时,需要考虑它们的执行频率。例如,对于很少执行、访问冷数据(归档数据)的查询,访问磁盘可能是可以接受的。对于定期执行的查询,例如测试环境中发现的这条查询,持续访问磁盘可能成为额外开销,延长执行时间。消除磁盘访问,或至少缩短访问时间,都可以加快查询执行。具体可采取的措施取决于访问模式:增大缓冲区缓存,使所有需要的热数据都能容纳其中;升级系统资源(增加内存、使用性能更高的存储设备或虚拟机等)。当然,最好的办法还是分析并优化查询。
在监控中,可以用以下查询找出块 I/O 耗时最多的查询:
注意,查询中为 mode 标签列出了 ioread 和 iowrite 两种取值;需要时,也可以只获取读取时间或只获取写入时间。
使用这个查询,可以观察 I/O 的动态变化(图 3.6):
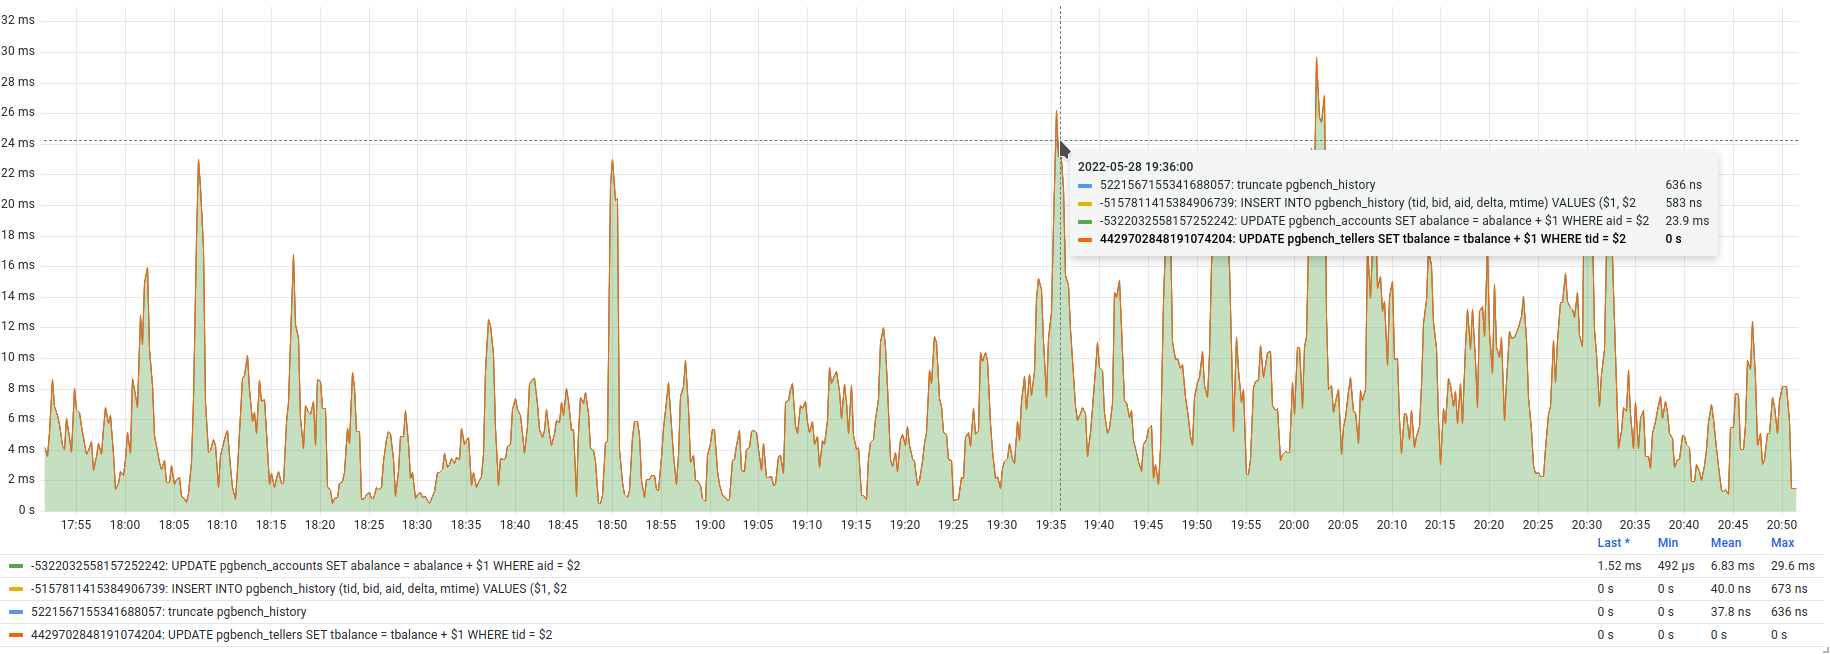
图中的情况与 SQL 查询结果一致。只有一种查询持续花费时间进行 I/O,平均每秒实际经过时间内消耗 6.83 毫秒。这看起来似乎不多,但要记住,开销很小的操作系统页缓存访问也算作块 I/O。可以做个实验:清空页缓存,看看数据库系统被迫真正访问磁盘时,I/O 时间如何变化。在 Linux 中,以 root 用户执行以下命令即可清空缓存(不要在生产环境中这样做,这会降低性能):
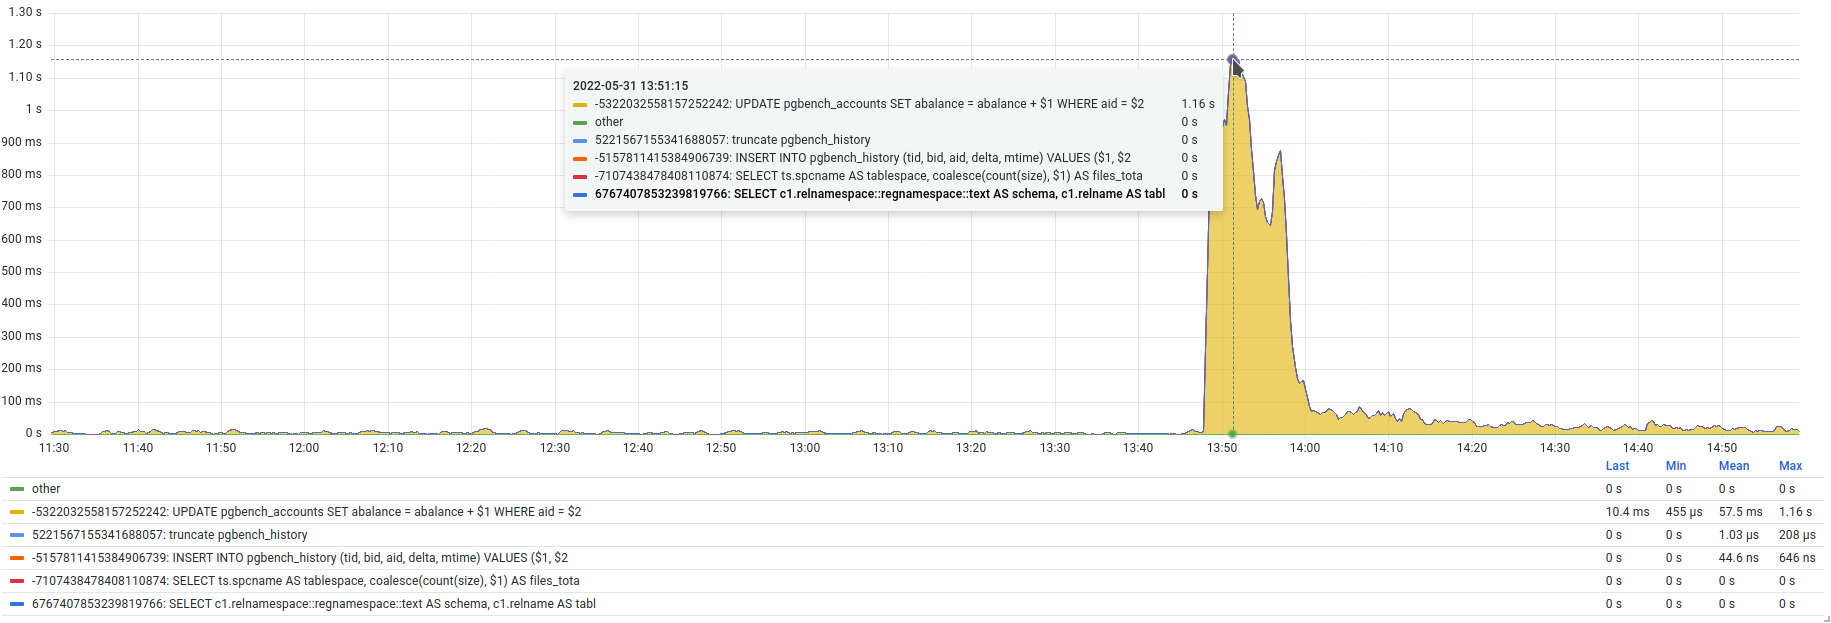
几分钟后,数据进入监控系统,就能看到 I/O 时间的峰值升至 1.16 秒(图 3.7)。随着工作负载继续运行,缓冲区缓存和页缓存逐渐填满,I/O 时间会逐步下降,最终恢复到清空页缓存之前的水平。
扣除 I/O 后执行耗时最多的查询。 既然能得到块 I/O 耗时,就可以通过简单的算术运算,得到一个暂且视为处理器执行查询所耗时间的数值。之所以说“暂且”,是因为这个统计值虽然反映执行时间,却不能精确表示处理器实际处于运行状态、执行该类查询的时间。还有一点很重要:它也包含等待时间。精确的处理器使用统计信息则可以借助相应模块获取。
用于此目的的 pg_stat_kcache 模块使用 getrusage 系统调用。不过,这不是官方扩展,需要单独安装软件包。
因此,要得到上述统计值,应从总时间 total_exec_time 中减去块 I/O 耗时:
这里的处理器时间几乎与总时间相同,说明数据库系统用于块 I/O 的时间相对较少,只有约 1%:
使用 SQL 评估查询执行时间时,同时输出这两项统计信息总是很有用,这样就能看出时间究竟花在了哪里。
这里可以直接看出 I/O 时间和 CPU 时间的比例,其中一条查询约三分之一的总执行时间花在 I/O 上,十分醒目。如果能让这类查询在缓冲区缓存中找到所需数据,就能从四小时的累计执行时间中节省约 80 分钟。这些时间可以用来执行其他查询,提高性能。
pg_stat_statements 提供的不只是规划和执行统计信息。这个视图中还有 I/O 和 WAL 写入统计信息,我们将在其他章节继续讨论。
3.6. 使用 queryid 进行跨来源查询识别
数据库系统中执行的查询,其信息可以从几个来源取得:
pg_stat_activity— 会话中正在执行的查询;pg_stat_statements— 成功执行的查询的累计统计信息;服务器日志 — 查询信息,不论查询最终成功还是出错;
EXPLAIN命令的输出 — 查询执行计划。
不过,很长一段时间里,这些来源之间并没有关联。要完整了解某种查询,就需要综合处理所有来源的数据。但 pg_stat_activity 和服务器日志记录的是完整查询文本,pg_stat_statements 保存的则是规范化后的查询,匹配它们并不容易。pg_stat_statements 扩展能够计算查询标识符 queryid;从版本 14 开始,其他来源中也能获取这一标识符,如今要在各个来源中识别同一查询就容易多了。
标识符的计算由参数 compute_query_id 控制。默认值 auto 允许 pg_stat_statements 及类似扩展自动计算标识符。启用 compute_query_id 后,查询标识符会出现在 pg_stat_activity、csvlog 格式的日志(或通过 log_line_prefix 指定格式的日志)以及 EXPLAIN VERBOSE 的输出中。
跨来源查询识别实现后,两个视图中的字段名并不相同,分别是 pg_stat_activity.query_id 和 pg_stat_statements.queryid。
3.7. 基于 pg_stat_statements 生成报告
评估系统较长时间内的运行情况时,汇总报告会很有用。这类报告通常从不同角度展示系统处理工作负载的效率。借助报告,既可以迅速评估系统状态,也能与此前的时间段比较,跟踪变化趋势。利用 pg_stat_statements 中查询统计信息的累积特性,就可以生成这类报告。
这类报告的思路很简单:先计算 pg_stat_statements 中各个维度的资源使用总量,再计算每条查询在相应总量中的占比。得到各查询的资源使用占比后,按某个标准排序,例如查询的累计执行时间。
DataEgret 的代码仓库中提供了生成这类报告的示例脚本6。报告列出执行耗时最多的查询,并附上 pg_stat_statements 中的详细信息。以下是针对测试环境中查询生成的一份报告:
报告分为两部分。第一部分显示总体信息:
成功执行所有查询所花费的总时间,并单独标出 I/O 占比;
成功执行的查询总数,以及不同查询类型的数量;
报告版本与 PostgreSQL 版本;
pg_stat_statements的设置。
第二部分按累计执行时间对查询排序,并为每条查询提供补充信息:
查询在总执行时间中的占比,分为 CPU 和 I/O 两部分;
查询调用次数及其在全部调用中的占比;
查询平均执行时间,其中单独列出 I/O;
用户、数据库和影响行数的信息;
规范化后的查询文本。
这些信息足以评估各查询在工作负载中的占比,并在需要时进一步分析性能、重构查询。也可以按需修改脚本,添加其他信息,例如统计信息的时间范围、查询标识符、资源使用情况、生成的日志记录量等。
另一个例子是 pgcenter 输出的报告。它可以针对 pg_stat_statements 中任意一条感兴趣的查询,给出汇总信息:
pgcenter 报告只关注选中的一条查询。报告上方的第一部分给出总体汇总信息,第二部分显示所选查询的统计信息及其在整体工作负载中的占比:
调用次数、影响行数及各自占比;
生成的日志记录量,细分为记录数、字节数和 FPI 页面数(参见 full_page_writes7);
该类型所有查询的累计执行时间,细分为规划、执行和 I/O;
该类型查询的平均执行时间及其明细;
规范化后的查询文本。
比较两份报告可以看出,它们的用途不同。DataEgret 报告更全面地展示数据库系统正在执行什么,更适合作为汇总报告。pgcenter 报告评估某条查询的资源使用情况,更侧重即时分析,以及查看可疑查询的细节。
生成这类报告、计算资源使用总量时,要记住 pg_stat_statements 不仅可以收集顶层查询的执行统计信息,也可以收集嵌套查询的统计信息;这一行为由参数 pg_stat_statements.track 控制。取值为 all 时,跟踪更详细,但可能把部分统计信息重复计算。例如,查询调用的函数内部又执行其他查询或函数,汇总时便会同时计入函数本身和其中所有嵌套查询的统计信息,可能严重扭曲结果。为避免这一问题,应考虑 toplevel 标志;它表示执行层级,可用于排除嵌套查询(toplevel = false)。遗憾的是,toplevel 标志在版本 14 中才出现,因此在更早的版本中,建议使用 pg_stat_statements.track = top 这一设置来生成报告。
3.8. pg_stat_statements_info 视图
除了主要视图,扩展还提供一个小型辅助视图 pg_stat_statements_info,只有一行、两个字段:
dealloc— 由于达到 pg_stat_statements.max 限制,扩展被迫删除部分统计信息的次数。这可能导致部分统计信息丢失,从而影响报告数据的准确性。一种变通办法是使用监控系统作为数据来源。如果尚未达到限制,可以通过增大数据库系统配置中的 pg_stat_statements.max 来解决问题,不过这需要重启服务器。stats_reset— 最近一次重置统计信息的时间戳,可用于明确查询统计信息累积的时间范围。
输出示例:
从这个例子可以看出,现有容量足够,至少在过去 18 天内,没有发生过统计信息删除。
3.9. 过程与函数的执行
处理数据时,可以用函数实现复杂逻辑。这些函数可以用 SQL 编写,在其中组合多条查询。除了 SQL,还支持 PL/pgSQL、PL/Tcl、PL/Perl 和 PL/Python 等过程语言(procedural language,PL)。如果工作负载中的查询调用了函数,管理员就需要找出较慢的函数并加以优化。数据库系统提供 pg_stat_user_functions 视图,其中包含函数执行统计信息的最基本集合,可用于简单的函数性能分析。更细致的函数性能剖析则需要借助第三方工具。
pg_stat_user_functions 的主要用途是优化应用的性能,而不是单条查询的性能。通过这个视图,可以找出目标应用调用最频繁的热点函数并进行优化,从而提高应用性能。
pg_stat_user_functions 还可以与 pg_stat_statements 配合使用。在后者中,可以找到调用函数的查询,并通过相应字段了解执行时间和资源使用情况。
配置参数 track_functions 用于控制函数执行统计信息的收集,可以取以下值(修改后只需重新加载配置即可生效):
none— 关闭统计跟踪(默认值);pl— 只跟踪用过程语言编写的函数;all— 跟踪所有函数,包括用 SQL 和 C 编写的函数。
需要注意,无论参数取何值,内联(inline)到调用查询中的 SQL 函数都不会被跟踪。
pg_stat_user_functions 视图包含的数据相对较少:
funcid— 函数的唯一标识符;schemaname— 函数所属模式的名称;funcname— 函数名称,在同一模式内可能不唯一,因为允许通过不同的输入参数列表来重载函数;calls— 函数调用总次数;total_time— 函数执行总时间(毫秒),若有嵌套函数,也包括嵌套函数的执行时间;self_time— 函数自身的执行总时间(毫秒),不包括嵌套函数的执行时间。
如我前面所说,这些统计信息主要用于找出调用最频繁和执行耗时最多的函数。基于 pgbench 标准场景的测试工作负载不调用函数,因此统计信息较少,只包含扩展中函数的调用:
这个查询没有附加条件或排序,因为我事先知道统计数据不多。这里只有三个函数的统计信息,它们属于 pg_buffercache 和 pg_stat_statements 两个扩展。其中两个函数由监控代理调用,calls 字段记录调用次数。由于这两个函数都没有嵌套调用其他用户定义函数,各自的 total_time 和 self_time 相同。它们的累计执行时间分别约为 122 秒和 14 秒。pg_buffercache_pages 的调用频率约为另一个函数的两倍,但总执行时间约为其 8.5 倍,也就是说,数据库系统执行它的开销更大。
用这种方法比较函数的执行时间,就能找出耗时最多的函数。以下查询可以从监控系统获取统计信息:
这个查询使用 increase,而不是 rate。由于这些函数只由监控代理调用,显然调用频率相对较低,每分钟只有几次。因此,观察每分钟(而非每秒)花在函数执行上的时间更方便。对于生产工作负载,函数可能执行得更频繁,还可能在多个会话中并发执行,这时使用 rate 也许更合适。
图 3.8 与查询 pg_stat_user_functions 的输出反映了相同情况:大部分时间都花在执行 pg_buffercache_pages 上。
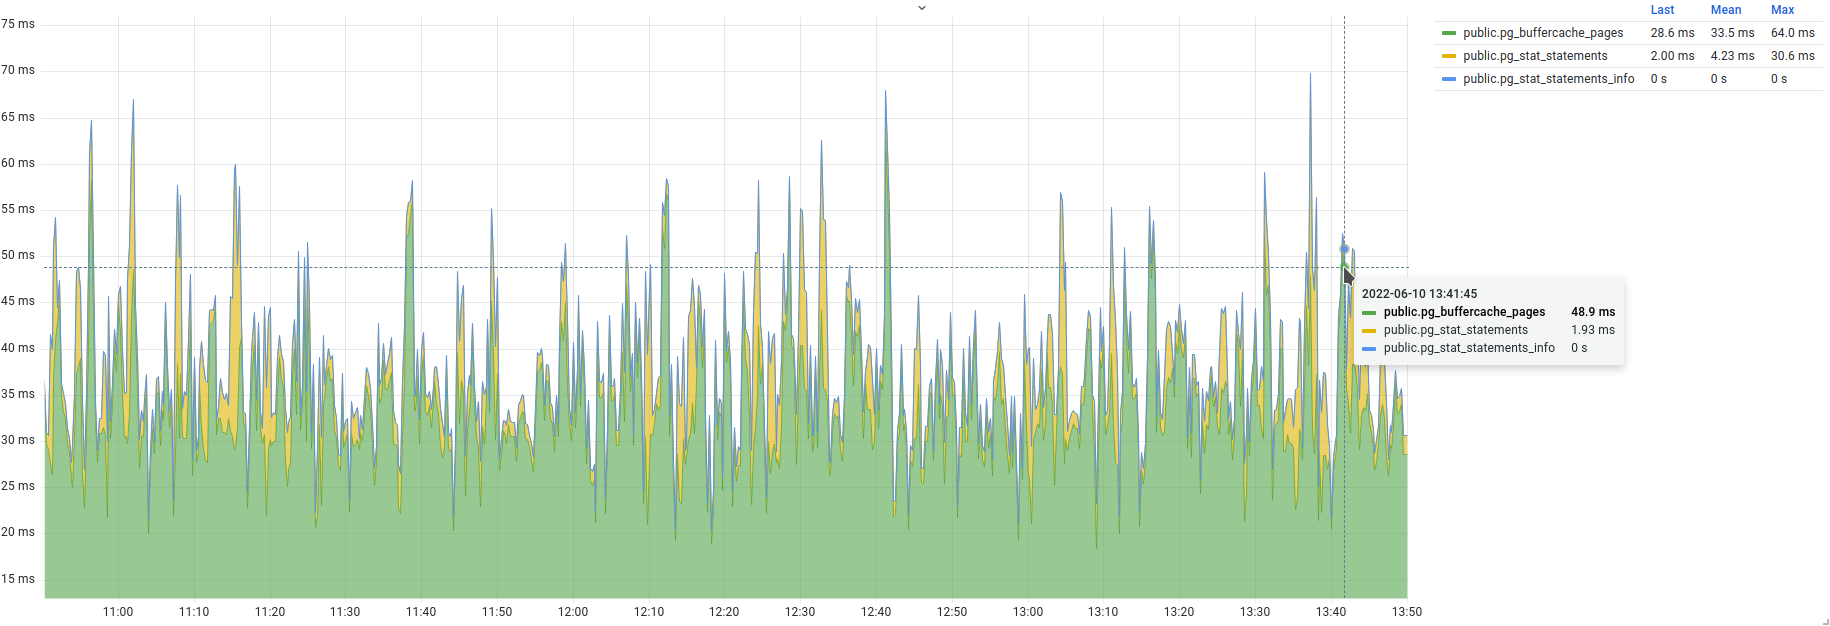
平均每分钟,执行这个函数需要 33 毫秒,而 pg_stat_statements 函数只需 4 毫秒。
小结
查询是执行工作负载的基本单位。
查询监控不可或缺,对理解工作负载十分重要。
分析工作负载可以使用
pg_stat_statements扩展,该扩展默认关闭。pg_stat_statements视图包含查询规划与执行、资源使用、I/O 时间和 WAL 生成等统计信息。pg_stat_statements视图是监控图表和数据库系统运行报告的重要数据来源。数据库系统提供跨来源查询识别功能,以便分析不同来源的统计信息。
pg_stat_statements_info视图提供有关pg_stat_statements扩展运行情况的有用信息。用户定义函数的执行统计信息位于
pg_stat_user_functions中。
4 数据库
本章将讨论:
数据库管理系统对象的层次结构;
数据库集簇、表空间、数据库、模式、表和索引;
关系;
关系的辅助结构——TOAST、可见性映射和空闲空间映射;
表和索引层面的工作负载;
多余的表顺序扫描;
数据库集簇中的错误和不良事件;
用于确定对象大小的函数;
用于输出数据库集簇辅助目录内容的函数。
上一章我们把查询视为任何工作负载的基础,并介绍了与查询相关的统计信息和活动监控。工作负载的另一面是用户数据。查询中会指定要从中读取数据、以及要向其中保存数据的具体表。本章将从访问数据库管理系统对象的角度考察活动统计信息,并跟踪发生在这些对象——数据库、表和索引——上下文中的事件。
4.1. 数据库管理系统对象的层次结构
数据库管理系统的主要任务之一,是可靠地保存数据并提供对数据的访问。在数据库管理系统层面,表和其他类型的对象负责组织和存储数据,每种对象都有自己的用途。所有这些对象构成了数据组织的逻辑层。不过,数据库管理系统并不是一个自给自足的实体,必须依托操作系统提供的工具、抽象和资源。从操作系统角度看,数据库管理系统的数据位于文件系统中,并使用块设备。在物理层面,所有表、索引以及数据库管理系统的许多其他抽象,都只是磁盘上的文件和目录。
接下来我们将考察数据库管理系统如何组织数据存储。这有助于更好地理解工作负载的组成(负载落在哪些数据库管理系统对象上),并更有意识地从对象和数据的使用角度构建工作负载监控。熟悉内部存储结构的资深管理员可以直接跳到 4.2 节。
数据库集簇
首先要考察的是数据库集簇(database cluster)这一概念。集簇是数据库以及供它们共同使用的全局对象的统一且不可分割的集合。“统一且不可分割”意味着,整个集合存在于同一个数据库管理系统实例(instance)中;实例是一组运行在操作系统空间中、并拥有共享内存区域的进程。同一台服务器上可以运行多个数据库管理系统实例,只要它们使用的 TCP 端口不冲突。不要把数据库集簇与复制集群混为一谈。复制集群通常由多个运行在相互独立环境中的数据库管理系统实例组成,这些环境可以是独立的物理服务器、虚拟服务器或容器。
从操作系统角度看,数据库集簇是一组目录和文件。可以通过 initdb 命令并指定目标目录来初始化集簇。得到的目录通常称为数据目录(data directory),其中包含集簇的其他目录和文件。表空间目录和 WAL 日志目录可能是例外:它们可以移到数据目录之外,再通过符号链接与主目录关联。因此,数据目录以及所有可能的外部目录(表空间和 WAL)共同构成集簇的数据存储。
下面给出测试环境中的一个数据目录示例。每个子目录都在集簇运行中发挥重要作用。管理员需要了解每个子目录的用途,以及它在数据库管理系统运行中的作用。
关于数据库物理存储的组织方式,可以参阅官方文档3。
表空间
数据目录的下一个(外部)组成部分是表空间。借助表空间,可以把位于不同文件系统和块设备上的独立目录组合起来,供数据库管理系统使用。执行 initdb 初始化后,数据库管理系统中会有两个表空间:
pg_default——默认表空间,所有数据库、表和索引都会在这里创建。该表空间位于集簇主目录内。初始化时,这个表空间中会创建两个系统数据库——template0和template1,它们用作创建新数据库的模板(参见CREATE DATABASE命令4);pg_global——系统表空间,同样位于集簇主目录内。整个集簇共用的系统目录对象存放在这里。
可以使用元命令 \db+ 或查询 pg_tablespace 表来获取全部表空间的列表:
命令输出中的 Location 字段值得关注,它包含表空间目录的路径。对于默认表空间,该字段为 NULL(因为二者都位于主数据目录中)。其他所有附加表空间通常都位于主数据目录之外,并通过 pg_tblspc 子目录中定义的符号链接与主目录关联。
表空间既可以用于存放数据库,也可以用于存放单独的表和索引。数据库尤其需要单独说明:把数据库放在某个表空间中,实际上表示该数据库的系统目录对象位于其中,而其余内容还可以位于其他表空间。例如,一个数据库完全可以位于 pg_default 表空间,其中有一张大型分区表;这张表最近三个月的分区和索引可以位于快速 SSD 存储上的表空间,而更早的归档分区和索引则位于较慢的 HDD 存储上。因此,数据库位于一个表空间中,但其中一部分数据位于另外两个表空间。
表空间与维护成本
实践表明,使用额外表空间会增加数据库管理系统的维护复杂度。需要记住这些表空间的存在,并在升级、配置物理复制以及许多其他工作中将它们考虑在内。表空间之间迁移数据时还会增加额外操作。最好尽可能避免使用表空间,并认真评估引入它们的利弊。在实践中,大多数系统使用默认创建的表空间就足够了。
数据库
数据库可以看作数据的容器,并负责隔离数据。一个数据库中的表和索引无法在其他数据库中访问(可以使用 postgres_fdw 和 dblink 等工具绕过这一限制)。在同一个集簇内,可以使用不同的数据库对数据进行逻辑划分:多个彼此无关的应用的数据可以分开存储在不同数据库中。
可以使用元命令 \l(或查询 pg_database 表)查看数据库列表:
初始化集簇时会创建三个数据库。两个数据库——template0 和 template1——由数据库管理系统用作创建新数据库时的模板;第三个数据库——postgres——是一个普通数据库,可以在其中创建表。通常,postgres 数据库不用于应用业务,管理员一般会在其中安装辅助脚本和工具。建议为用户数据创建单独的数据库,并使用能够清楚说明数据库用途或其中所存数据性质的名称。
主目录中的所有数据库都位于 base 子目录下。每个数据库都存放在一个目录中,目录名对应 pg_database.oid 中的标识符。
模式
在单个数据库内部,还可以按模式(schema)进一步划分数据。模式本质上是命名空间(namespace),提供额外一层对象隔离和存储,但不支持嵌套。例如,可以使用模式按照不同业务领域组织表,或者对函数和视图进行版本管理。关于模式的有趣用法,可以参阅 Б. Момджян 关于微服务的演讲5。
任何数据库都会创建一个 public 模式,它是所有新建表和索引的默认模式。很多情况下,一个模式就足够了。
可以使用元命令 \dn+(或查询 pg_namespace 表)查看模式列表:
模式是数据库管理系统用于逻辑分组对象的内部抽象。它们在文件系统中没有与之关联的文件或目录。
表和索引
表是存放用户数据的主要对象,甚至可以说是最主要的对象;用户数据以行的形式表示。索引是表的附加结构,可以加快对表中单独行的查找。
可以使用元命令 \dt+ 或查询 pg_tables 视图来获取表列表:
输出中只包含用户表。要查看包括系统表在内的所有表,应指定修饰符 S,命令形式为 \dtS+。索引也有对应的元命令 \di 和 pg_indexes 视图(该视图基于 pg_index 表):
还可以特别关注 pg_class 表,它包含当前数据库中所有对象的列表,在获取数据库对象统计信息时经常作为辅助表使用。后续的一些查询会访问这张表。
关系与元组
关系(relation)是数据库中所有具有名称和属性列表的对象的统称。表和索引、外部表、视图(普通视图和物化视图)、序列(sequence)、复合类型,都可以称为关系。PostgreSQL 中还存在类(class)这一术语;它是关系的过时同义词,来源于早期对面向对象思想的热衷。PostgreSQL 最早的版本中有一张 pg_relation 表,后来很快重命名为 pg_class,但属性名中的 rel 前缀保留了下来。
更一般地说,关系是元组(tuple)的集合;例如,查询结果也是一种关系。元组是属性按顺序排列的集合。属性顺序在定义将要保存元组的表(或其他关系)时确定。在这种情况下,元组通常称为表的行。元组也可以由结果集的结构定义;这样的元组有时称为记录。这个术语经常带有“行版本”的含义,因为它更多指页面内部数据的物理表示,而不是行这一逻辑概念。
表和索引(以及其他一些关系类型)在数据库目录中都表示为独立文件。如果表中包含大量行,表文件(或索引文件)会自动按每个 1 GB 切分成多个文件段。每个文件段按递增顺序编号。
每个表或索引都由多个文件组成,这些文件称为分支(fork):
表的主分支(main fork)以行的形式包含用户数据。
可见性映射(visibility map)用于跟踪其中的行对所有活动事务都可见的页面。可见性映射只存在于表中。可见性映射文件的后缀为
_vm。可见性映射会在清理时更新,通常只占用很少空间。详细说明请参阅文档6。空闲空间映射(free space map)用于跟踪表(或索引)中的空闲空间,以及可以插入新行的页面。与可见性映射一样,空闲空间映射会在清理时更新,并且占用的空间很少。这些映射文件的后缀为
_fsm。详细说明请参阅文档7。初始化分支(initialization fork)只用于不记录 WAL 的表(unlogged table)和索引,它们的变更不会记录到 WAL 日志中。这类表不会在故障后恢复,而是通过把初始化文件复制到主文件上来重新创建(如果表很大、包含多个段,则会删除这些段)。文档中关于初始化文件的信息并不多8。
在更低层面,表和索引采用分页组织方式,由大小为 8 KB 的页面(块)组成。每个页面都有辅助字段,以及为用户数据——行或元组——预留的空间。索引同样采用分页组织方式,但根据索引类型(btree、hash、gin 等)不同,页面内部的空间组织方式也可能不同。
TOAST
分页组织的限制之一是,行不能跨越页面边界,也就是说,一个页面中不能存放长度超过页面大小的行。为克服这一限制,PostgreSQL 使用超长属性存储技术 TOAST(The Oversized-Attribute Storage Technique),通过压缩和/或拆分长属性值来存储数据。这个过程对最终用户是自动且透明的,不过需要指出,TOAST 也提供了精细调整的可能。TOAST 技术只支持那些可以表示为变长属性(varlena,variable-length attribute)的数据类型,因为它对固定大小类型没有意义。
如果表中包含变长类型的列,该表还会关联一个额外的 TOAST 表,无法放入普通页面的数据就存放在其中。与普通表一样,TOAST 表也采用固定页面大小的分页组织方式;但通过额外压缩并把值拆分成片段,这项技术可以把大值分布到多个页面中。关于这项技术的更多说明,以及数据如何在磁盘和内存中存放,可以参阅官方文档9。
我们简要考察了数据库管理系统对象层次结构中的主要概念。后续内容将帮助我们更好地理解统计信息,尤其是与磁盘空间和共享缓存使用有关的问题。
4.2. 数据库集簇中的事件
在第 3 章中,我们从正在执行的查询角度考察了工作负载。可以把查询看作应用施加给数据库管理系统的外部力量,而把工作负载看作数据库管理系统在这种力量作用下完成的内部工作。这使我们能够从完全不同的角度看待工作负载,例如考察应用命令时所涉及的数据库对象(表和索引)。
表和索引层面的工作负载
另一类同样能够描述工作负载的统计信息,是表和索引使用情况统计。这些统计信息有两种粒度:行级和块级。第一种表示查询执行过程中有多少行受到影响。行级统计是工作负载的逻辑反映,因为它说明了数据库管理系统逻辑抽象的使用情况;以页面或字节表示的块级统计更接近数据存储的物理层,适合分析输入/输出。
要获取所需数据,需要使用多个视图。可以在 pg_stat_database 视图中获取集簇或单个数据库范围的总体情况,其中包含一些必要字段:
tup_returned和tup_fetched——表示访问表和索引时涉及的行总数(不是返回给客户端的行数!)。
— 对于索引,tup_returned 表示索引访问方法(Index Scan、Bitmap Index Scan、Index Only Scan)返回的行数,tup_fetched 表示此过程中从表中读取的行数(但只统计不使用位图的简单索引访问)。
— 对于表,tup_returned 表示顺序扫描(Seq Scan)从表中读取的行数,tup_fetched 表示使用位图访问时从表中读取的行数(Bitmap Heap Scan)。这是因为合并位图(Bitmap And)时,无法把访问统计归属于某个具体索引,因此这些统计信息始终计入表的统计信息。
从上述说明可以看出,有些操作会同时增加两个计数器,因此不要把它们的值相加。更新和删除行时,计数器也可能增加(因为仍然需要找到并读取目标行)。在 pg_stat_database 中可以获得受影响行的总体情况;如果需要更详细的信息,则应分析单个表和索引的统计信息。
tup_inserted、tup_updated和tup_deleted——这些字段简单得多:它们记录INSERT、UPDATE和DELETE操作影响的行数,没有额外的细节和例外。
这些统计信息也适合粗略评估工作负载的波动。可以从监控系统中通过以下指标获取:
postgres_database_tuples_returned_total;postgres_database_tuples_fetched_total;postgres_database_tuples_inserted_total;postgres_database_tuples_updated_total;postgres_database_tuples_deleted_total.
每个指标都会返回单个数据库中相应的受影响行数。要观察动态变化,应关注数值变化的频率;要评估总体情况,则应将各个数据库的指标相加。
要绘制图表(图 4.1),需要使用两个查询;每个指标描述一种与行有关的操作。
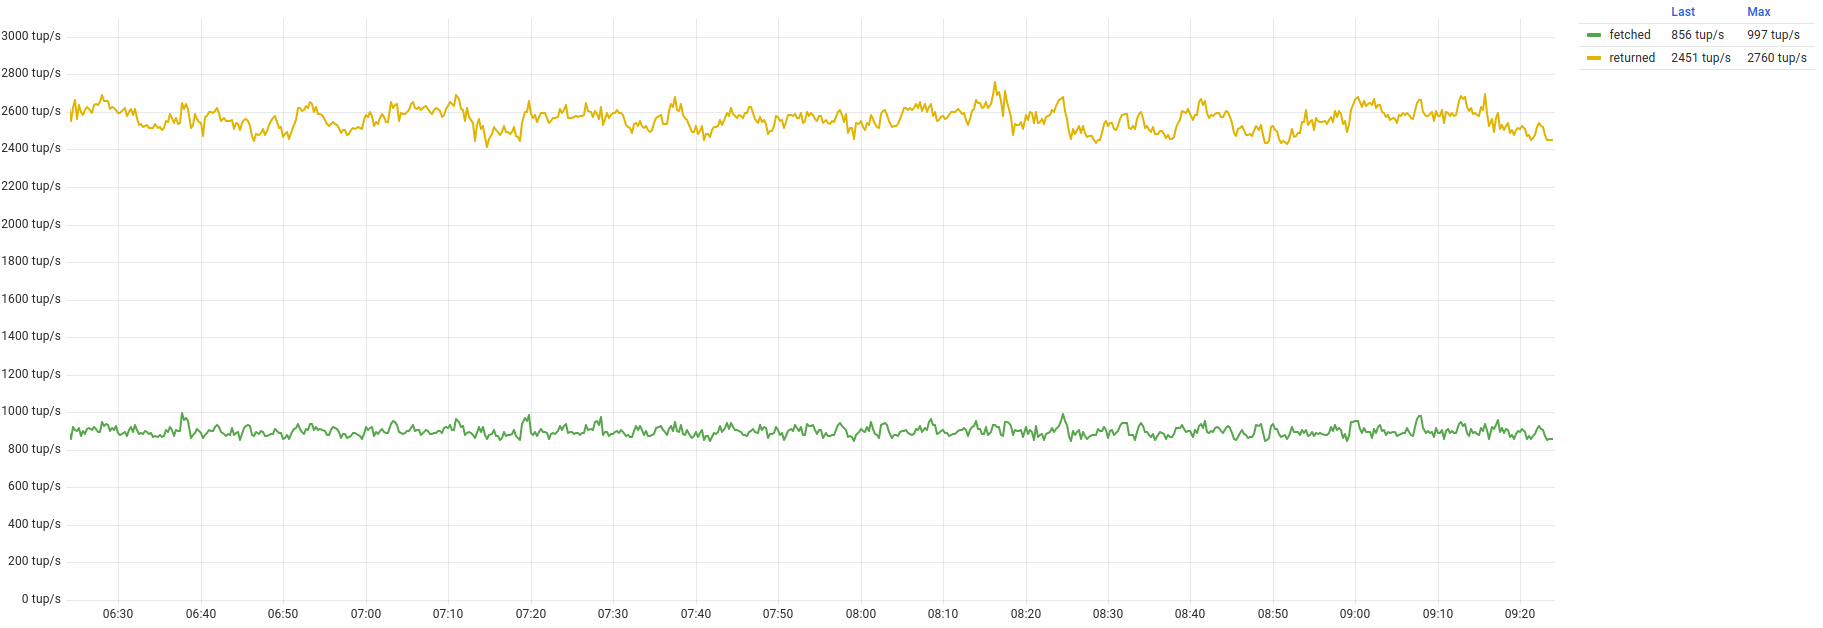
对修改操作影响的行也可以得到类似的情况。要绘制图表(图 4.2),需要使用三个查询:
两张图都显示出平稳的工作负载,没有明显波动。这说明从应用侧看,客户端数量和请求量基本保持不变;从数据库管理系统侧看,工作负载执行过程中受影响的行数也保持稳定。剧烈波动可能由应用实例数量或发送请求量的变化引起,也可能由内部原因造成,例如
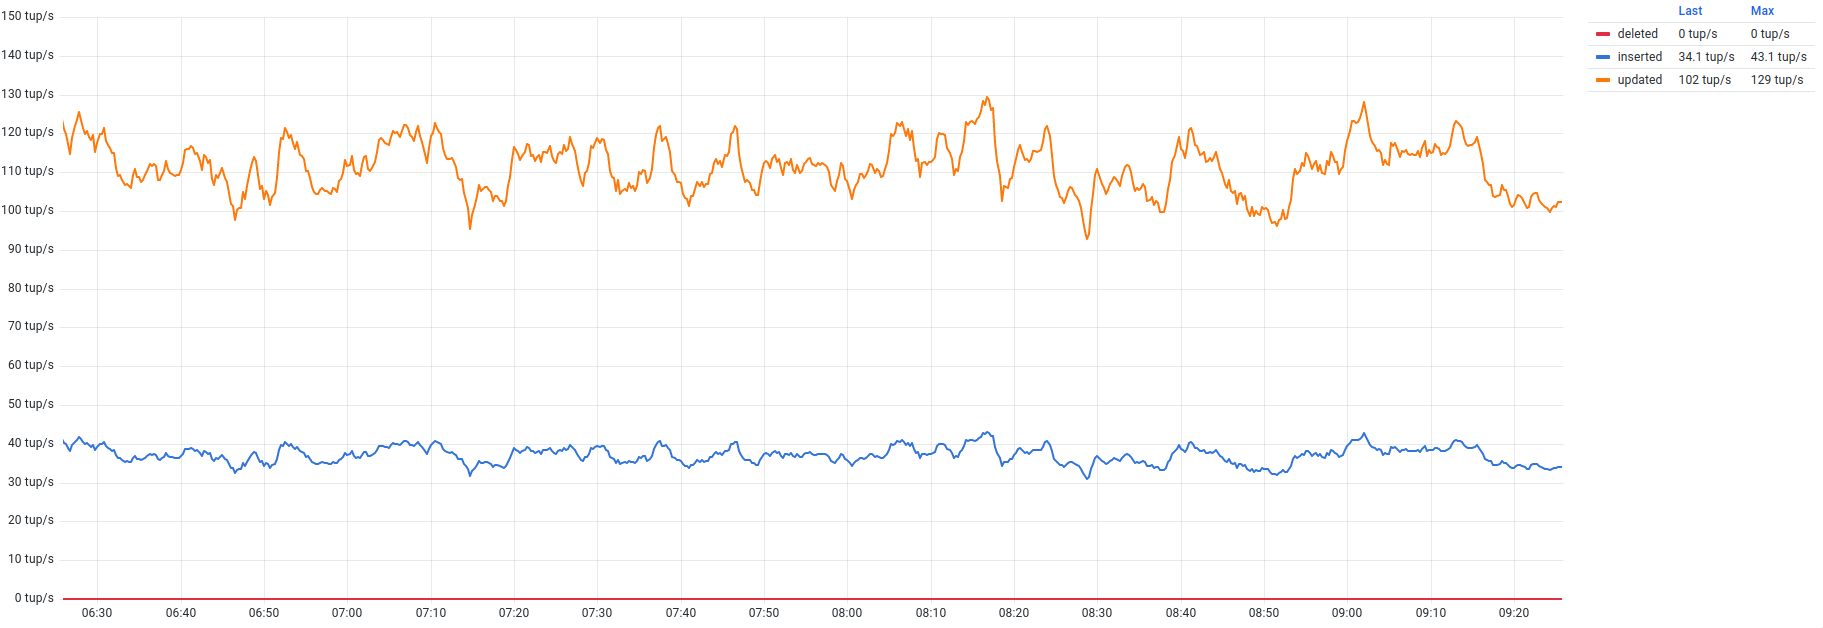
使用非最优计划,这些计划可能改变受影响的行数,并导致查询执行时间变长。
如果要更详细地分析工作负载中究竟涉及哪些表,应使用 pg_stat_user_tables 和 pg_stat_user_indexes 视图。这些视图包含更多有关具体表和索引使用情况的信息。pg_stat_user_tables 中值得关注的字段包括:
seq_scan——顺序访问(sequential scan)操作的次数;seq_tup_read——所有顺序访问操作执行过程中涉及的行数;idx_scan——索引访问(index scan)操作的次数;idx_tup_fetch——索引访问涉及的行数;n_tup_ins——插入的行数(通常由INSERT查询产生);n_tup_upd——更新的行数,包括所谓的 HOT 更新(由UPDATE查询产生);n_tup_del——删除的行数(由DELETE查询产生);n_tup_hot_upd——使用 HOT(HeapOnly Tuples update,堆内元组更新)机制更新的行数。HOT 是一种用于减少行更新开销的优化。其要点是:如果更新后属性值在任何索引中都没有变化,就可以省略插入索引指针。因此,更新会更快,资源开销也更低。HOT 更新的数量也计入n_tup_upd字段。关于 HOT 机制的更多信息,可以参阅相关资料10 11。
pg_stat_user_indexes 视图中也有类似的索引统计信息:
idx_scan——访问该索引的次数。这个字段可以帮助发现未使用的索引,这一点很重要,因为保留索引并不是没有代价的;idx_tup_read——索引扫描时读取的索引项数量(不访问表);idx_tup_fetch——简单索引扫描从表中选出的存活行数量。
需要弄清楚在使用索引位图时,idx_tup_read 和 idx_tup_fetch 计数器是如何工作的。使用多个索引时,扫描结果可以通过逻辑乘法或加法合并,因此无法把对单独行的选择归属于具体索引。在这种情况下,所用索引的 pg_stat_user_indexes.idx_tup_read 值会增加,每个表的 pg_stat_user_tables.idx_tup_fetch 计数器也会增加,而 pg_stat_user_indexes.idx_tup_fetch 的值不会变化。
pg_stat_user_tables 和 pg_stat_user_indexes 视图汇总了用户表和用户索引的统计信息。系统对象的统计信息则汇总在类似的 pg_stat_sys_tables 和 pg_stat_sys_indexes 视图中。这些视图会访问另外两个汇总所有对象统计信息的视图(pg_stat_all_tables 和 pg_stat_all_indexes);而后两者又建立在一组大型函数之上,这些函数访问各个统计计数器。上述视图都针对单个数据库,区别于面向整个数据库集簇的 pg_stat_database。
下面考察这些统计信息的几种使用场景:
多余的顺序访问;
插入、更新和删除次数最多的表。
多余的顺序访问。 顺序访问意味着访问表(读取并可能写入),直到处理完所需数量的行。这是基本访问方法之一,适用于需要访问大量行,或不存在合适索引的情况。前一种情况下,顺序扫描可以用于分析查询或批量(bulk)修改,因为这类操作需要读取表的大部分,甚至整张表。后一种情况下,如果没有合适的索引,即使查询只需要一行,也会使用顺序访问,从而可能造成输入/输出和处理器资源的过度消耗(读取并过滤行)。
实践中需要跟踪顺序访问的次数,并判断它们是否确实必要。对于分析查询,顺序访问是合理的;而对于 OLTP 查询,通常不需要大量记录,使用顺序访问的成本可能高于使用索引。不过,这并不意味着应为每个字段都创建索引——维护索引并非没有代价,在某些情况下还会造成多余的输入/输出。添加新索引时,需要评估查询执行计划,并确认新索引是否会被使用、是否有益。
要获取顺序读取的表列表,可以使用下面的查询(连接必须建立到 pgbench 数据库):
查询输出了表通过顺序访问和索引访问时的统计信息,包括操作次数和受影响行数。在测试负载中,表并不多,因此查询只输出一张通过顺序方式访问的表。实际上,这张表有一个本可以使用的索引,但表中只有 20 行(也就是说整张表只占一个块),规划器认为使用索引的代价更高:因为那样不仅要读取表的块,还要读取索引的块。因此,它选择了成本更低的顺序访问计划。
在负载多样的生产环境中,顺序扫描的表可能更多。比较这些表时,还应考虑一些指标(为了方便,也可以把它们输出到查询中):
每次扫描的平均行数——
seq_tup_read / seq_scan。平均行数越多,扫描所需的资源就越多。但这并不意味着所有查询都会读取恰好这么多行;顺序访问占全部访问的比例——
seq_scan / (seq_scan + idx_scan)。比例越高,扫描使用的资源越多;不过要记住,有些小表可能完整放入共享缓存;表的字节大小,用于相互比较表。例如,消除大型表的顺序访问可能比消除小表的顺序访问更优先。本章稍后将介绍如何确定表和其他数据库对象的大小。
通过查询获取这类统计信息,适合构建按时间段生成的报告;但要进行实时分析和问题排查,还需要看到变化趋势。下面的查询可以返回按顺序访问读取行数最多的前 K 张表:
如果根据这个查询绘制图表,图中只会显示一张表,这与 SQL 查询的结果完全一致。
可以做一个小实验:执行一次查询,读取另一张表中的所有行:
过一段时间后,图表中会出现一个明显的尖峰(图 4.3)。
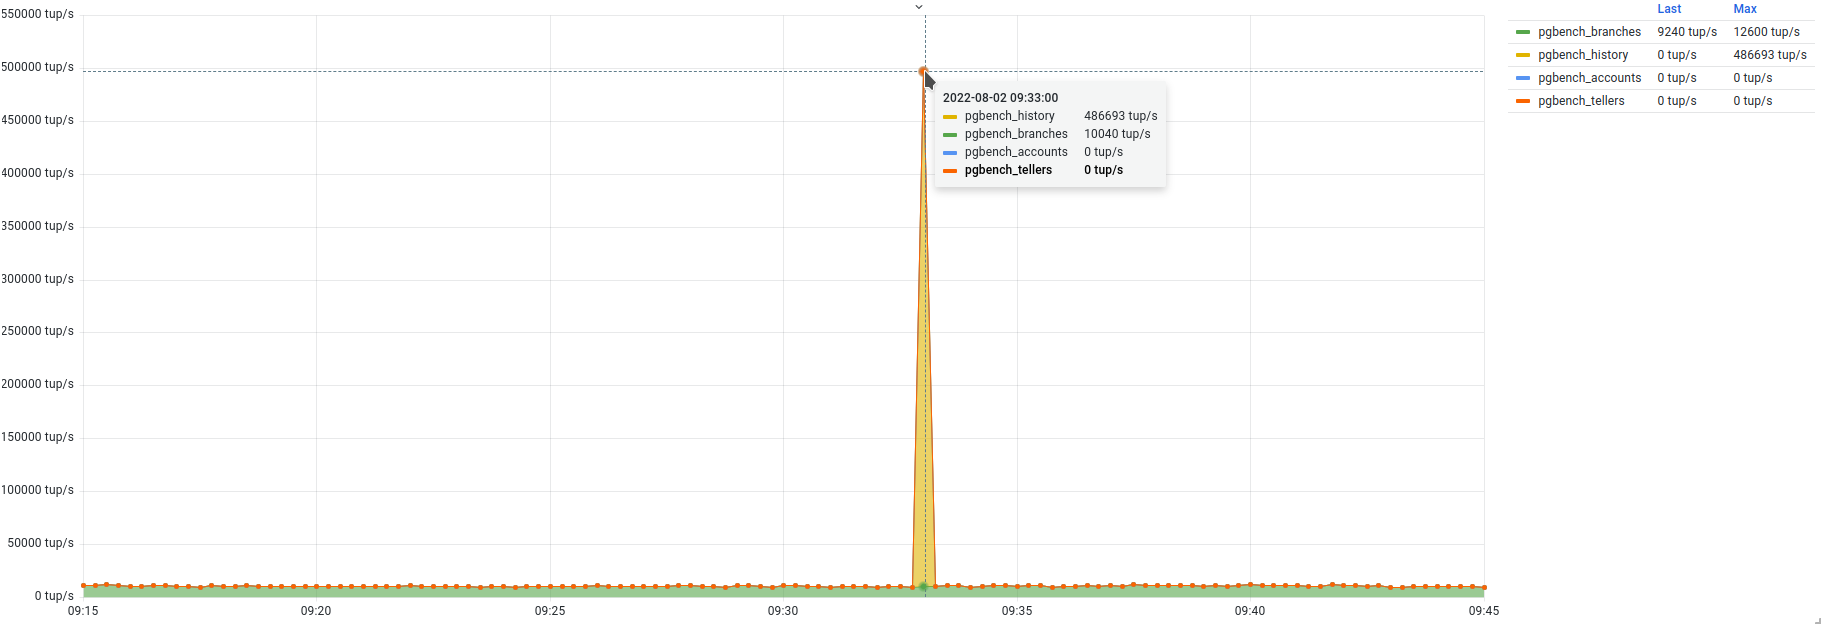
因此,借助这类图表,可以实时跟踪顺序访问的变化趋势,并采取适当措施(分析访问表的查询、创建索引等)。
插入、更新和删除次数最多的表。 表使用统计信息是 pg_stat_database 中行统计信息的逻辑延伸。如果说前者展示的是数据库层面的总体统计信息,那么借助 pg_stat_user_tables 就可以深入各个数据库,更详细地分析工作负载涉及的表,并评估受影响行的数量。
pg_stat_user_tables 针对单个数据库,因此要获取 pgbench 数据库中表的统计信息,必须连接到这个数据库。下面的查询可以获取受影响行的统计信息:
这个例子输出了 pgbench 数据库中的所有用户表,以及不同操作影响的行总数;在 ORDER BY 子句中指定关注的字段,就可以得到受影响行数最多的表。不过,输出中再次出现了很大的数字,实践中更适合跟踪这些数值的变化趋势。可以使用下面的指标(指标名称与字段名称类似):
postgres_table_seq_tup_read_total;postgres_table_idx_tup_fetch_total;postgres_table_tuples_inserted_total;postgres_table_tuples_updated_total;postgres_table_tuples_deleted_total;postgres_table_tuples_hot_updated_total.
下面的查询可以获取更新次数最多的表:
图表(图 4.4)可以更直观地显示哪些表的更新次数最多。
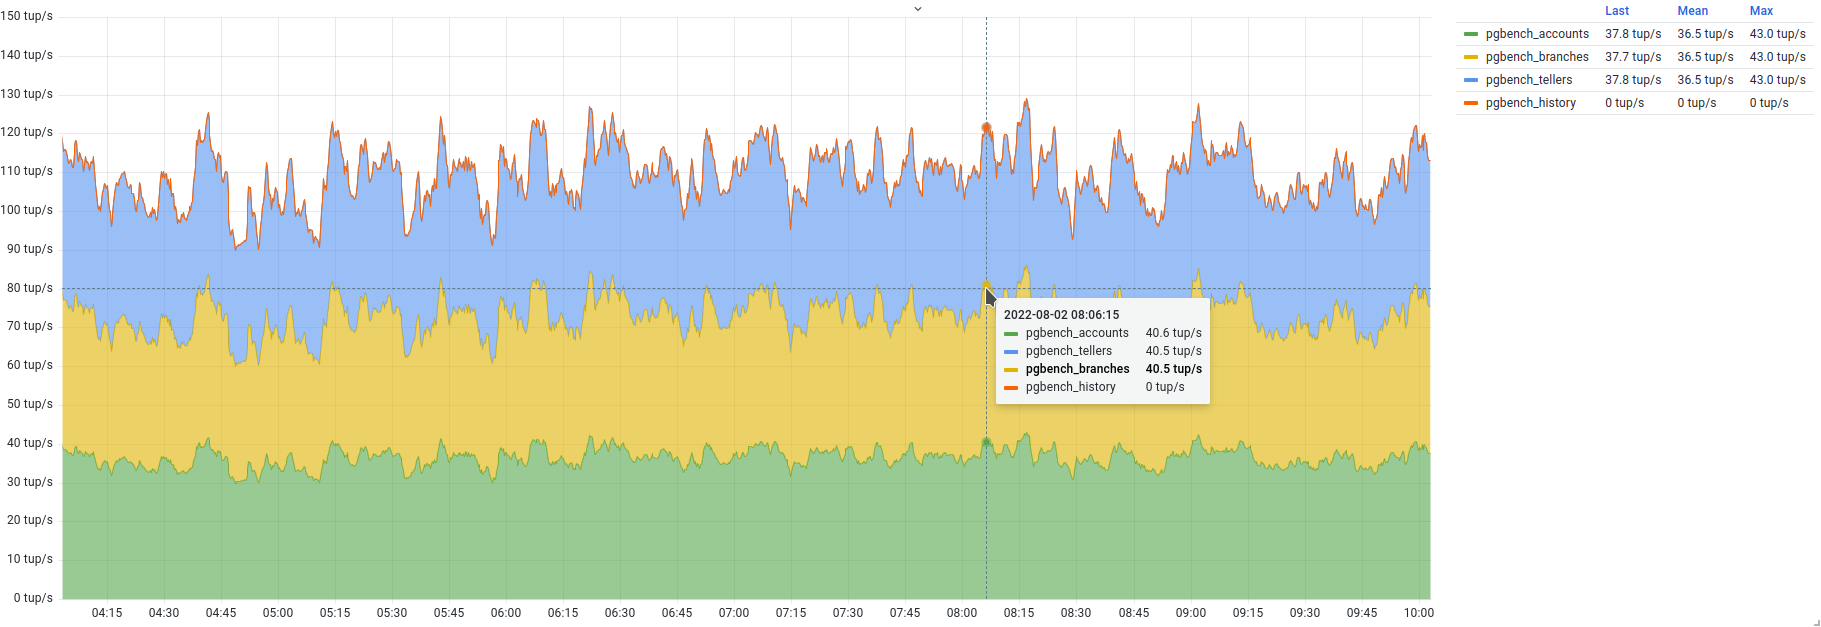
修改查询中的指标,就可以得到其他指标对应的图表,例如插入行数(图 4.5)。在实践中使用这类图表,可以实时跟踪工作负载的波动,尤其是应用侧发生重大变化时。
错误和不良事件
我们再次回到 pg_stat_database,考察以下字段:
xact_rollback——这个字段在介绍事务活动时已经提到。它表示以回滚结束的事务数量。回滚这一事实可以视为发生了错误(显式调用ROLLBACK命令的情况除外)。因此,大量回滚可能说明单个查询或事务执行过程中发生了错误,xact_rollback可以作为这类错误的计数器。典型例子包括插入行时违反唯一性约束、语法错误、函数参数指定错误或访问不存在的对象。不过,除了这类错误外,还可能有其他由与应用无关的原因引起的错误,而这类信息只能从数据库管理系统日志中获得。conflicts——由于热备节点上查询执行与 WAL 日志重放之间发生冲突而取消的查询数量(使用复制时)。这是一类单独的错误,将在第 7 章“复制”中详细讨论。无论如何,这类冲突也可以视为错误。deadlocks——死锁;前面第 2 章已经讨论过。为解决死锁,某个事务会被强制结束,这同样可以视为错误。checksum_failures和checksum_last_failure——分别表示校验数据页校验和时发生的错误数量,以及最近一次记录到错误的时间。校验和根据数据页内容计算,并在后续修改时重新计算,用于在访问页面时发现数据损坏。这是最令人不安的错误类型之一;出现这类错误时(尤其是在生产环境中),应高度重视,并采取一切必要措施,避免今后再次发生。sessions_abandoned、sessions_fatal、sessions_killed——表示异常结束的会话数量。这些字段也在第 2 章中讨论过。它们表明会话以异常方式结束,也可以视为错误。
正如你可能已经注意到的,前面讨论的所有事件本质上都是错误;在数据库管理系统和应用正常、正确运行时,它们本不应该发生。一个好的做法是绘制一张图,把所有这些错误指标汇总在一起:
postgres_database_xact_rollbacks_total;postgres_database_conflicts_total;postgres_database_deadlocks_total;postgres_database_checksum_failures_total;postgres_database_sessions_total{reason=~"abandoned|fatal|killed"}.
理想情况下,这样的图应该是“空的”,如图 4.6 所示。任何尖峰都应该引起数据库管理员的注意,并促使其查明原因。
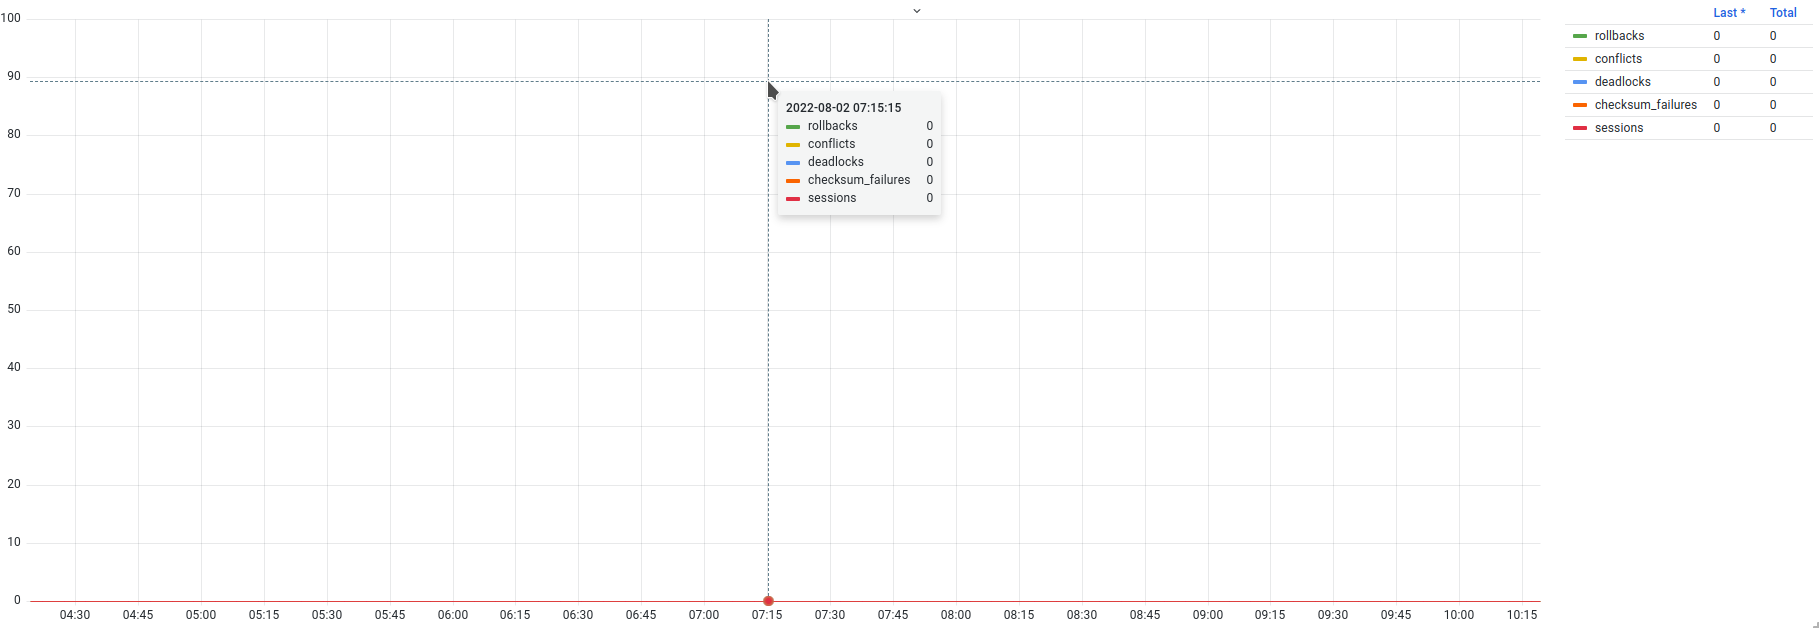
列出的多数事件说明问题出在应用侧,只有校验和错误指向数据库管理系统自身的问题。长期运行后,有些错误可能呈现出持续累积的特征;如果绘制这类图表,错误曲线可能已经形成某种持续的背景值。此外,有些错误类别可能因为由应用侧处理而被视为常见且正常,例如连接中断后重新建立会话,或死锁后重试查询。在这种情况下,可以忽略回滚和复制冲突等不太重要、对数据库管理系统性能影响不大的事件;但仍应认真对待死锁和校验和错误——死锁会损害并发工作性能,而校验和错误可能意味着存在数据损坏风险。
4.3. 数据库管理系统对象操作函数
在查看数据库对象的主要统计信息时,我们经常还希望看到这些对象的大小,以便了解它们的相对规模。对象大小往往决定工作的优先级和处理方式:大型对象需要更加谨慎(不能让锁长时间持有,也应避免引入额外负载),完成工作后可能获得更大的最终收益。对象大小本身也很重要,是规划磁盘空间容量的关键因素之一。数据库管理系统长期运行后,数据会不断增加,对象会不断变大,并占用越来越多的磁盘空间。
既可以从操作系统侧跟踪对象大小,也可以从数据库管理系统侧跟踪。我们知道,数据库管理系统中的几乎所有对象都是文件和目录,因此可以在文件系统中获取这些对象占用的空间。另一方面,数据库管理系统使用自己的抽象——表空间、数据库、表、索引等。在这两种情况下,都需要使用所谓的系统管理函数12。这是一组规模很大的辅助函数,用于获取管理员可能需要的各种信息。目前我们关注其中的两组:
数据库对象管理函数13。这一组中的大多数函数用于计算各种数据库管理系统对象占用的空间。
文件访问函数14提供对运行数据库管理系统服务器的操作系统目录的访问。这是一组功能强大的系统调查函数;只有超级用户和
pg_read_server_files角色成员可以访问它们。授予这些函数的权限时必须非常谨慎,并充分考虑安全要求,因为数据库管理系统内置的权限检查不适用于这些函数。例如,授予pg_read_file函数EXECUTE权限,就允许读取数据库管理系统服务器进程可以访问的任意文件;拥有该函数执行权限的用户可以读取任意表的内容,包括可能包含机密数据的表(例如pg_authid)。
确定数据库管理系统对象的大小
对象管理函数中值得关注的包括:
pg_tablespace_size——显示指定表空间的大小;pg_database_size——显示指定数据库的大小;pg_table_size——显示指定表的总大小,包括 TOAST 存储和辅助分支(vm、fsm、init);pg_indexes_size——显示指定表的所有索引的总大小;pg_total_relation_size——显示指定表的总大小(包括 TOAST 和辅助分支)以及该表的所有索引。计算结果等于pg_table_size和pg_indexes_size两个函数结果之和;pg_relation_size——显示第一个参数指定的关系(表或索引)分支的大小。第二个参数可以指定要关注的分支名称:main——计算包含数据的主分支大小;
— fsm——计算空闲空间映射的大小;
— vm——计算可见性映射的大小。
如果不指定第二个参数,则默认使用 main。对于索引,可见性映射的大小始终为零。
pg_size_pretty——辅助函数,将以字节表示的值转换为带单位的文本(bytes、kB、MB、GB、TB、PB)。pg_size_bytes——辅助函数,是pg_size_pretty的逆操作,可以把文本值换算成字节数。
其中一些函数有两个变体,对象既可以用数值 OID 标识符表示,也可以用文本名称表示。
在输出数据库对象统计信息的查询中,可以方便地使用这些函数显示对象大小。表空间或数据库这样的复合对象的大小,是评估存储空间使用情况和规划容量所必需的。表和索引等其他对象的大小,通常用于评估数据库内部的空间使用,或评估膨胀效应的影响。下面简要介绍这些函数的使用示例。
表空间。 本章开头提到过元命令 \db+,它会显示表空间列表。大多数元命令实际上都会对系统目录的系统表执行 SQL 查询,因此也可以直接使用 SQL 得到与 \db+ 输出相似的结果。
元命令查询
要获取元命令使用的查询文本,可以在启动 psql 时使用参数 -E (--echo-hidden),让 psql 在使用内置元命令时显示查询。在已打开的会话中,可以使用 \set ECHO_HIDDEN on 命令开启查询显示。
下面的查询是元命令 \db+ 的简化版本:
路径(path 字段)由 pg_tablespace_location 函数确定。在测试环境中使用的是默认表空间;它们的路径值为空(NULL),因为这些表空间位于数据库集簇的主目录中。大小由 pg_tablespace_size 函数获取,该函数既可以接收数值 OID,也可以接收表空间名称。
数据库。 使用 pg_database_size 函数获取数据库大小。该函数的参数可以是数值 OID,也可以是数据库名称。下面是获取数据库大小的查询示例:
表。 表是复杂的抽象,谈到表的大小时,必须明确“大小”这一术语的具体含义。表由用户行所在的主分支组成,同时还包括可见性映射和空闲空间映射等辅助分支。此外,表还可能关联索引和 TOAST 表;从物理角度看,它们是独立的实体(磁盘上的文件),但从逻辑角度看,离开其父表就无法存在。要获取包括全部辅助结构在内的表完整大小,可以使用 pg_table_size 函数。如果还要计入索引,则应使用 pg_total_relation_size 函数(它等价于 pg_table_size 与 pg_indexes_size 之和)。最后,要在辅助分支层面确定大小,应使用 pg_relation_size,并向它传入具体的辅助分支。下面的查询演示了这些函数的用法:
这个例子有几个特点:
使用
pg_class代替pg_stat_user_tables,因为前者包含数据库对象的完整列表。使用过滤条件
c.relkind IN ('p', 'r', 'm')获取所需对象,只保留普通表(r)、分区表(p)和物化视图(m),从而排除索引、TOAST 表、普通视图、序列以及其他对象。排除以排他模式
AccessExclusiveLock锁定的表。使用管理函数时,一个重要的细节是它们建立的锁级别。函数要计算对象大小,需要ExclusiveLock级别的锁15。如果经常使用这些函数,例如用于监控,就可能与最严格的排他锁(AccessExclusiveLock)发生冲突,并有可能排队等待。为消除这一风险,查询不输出已经被锁定的表;待锁释放后,可以在下一次获取它们的大小。只选择大小超过 500 KB 的表。使用这种条件可以方便地过滤掉小表。不过,测试环境中的表本来就不多,大表则更少。
通过对
pg_index执行子查询,计算每张表的索引总数。为完整起见,加入了 init 分支大小的计算,尽管这只在使用不记录 WAL 的表时有意义,而测试环境中并没有这类表。
这个查询还可以做一个逻辑上的改进:把辅助分支表示为相对于表总大小的百分比,这样更容易发现异常和失衡(虽然我想不起见过辅助分支特别大的情况)。还可以输出表所属的表空间,但这需要与 pg_tablespace 进行连接。
索引。 可以使用 pg_relation_size 或 pg_total_relation_size 函数确定具体索引的大小。这两个函数既适用于表,也适用于索引。
为了便于处理索引,可以使用基于 pg_class 和 pg_index 的 pg_indexes 视图。不过,该视图没有包含唯一标识符字段,因此无法按 OID 与其他视图连接。为简单起见,查询只访问 pg_indexes,不与 pg_locks 连接,但与排他锁发生冲突的风险仍然存在,和表的情况一样。
在监控系统中评估数据库对象大小。 用 SQL 查询中的表格形式展示大小,很适合生成报告。要实时观察数据库管理系统对象的大小,可以使用以下指标:
postgres_database_size_bytes;postgres_table_size_bytes;postgres_index_size_bytes.
根据这些指标,可以绘制两类图表。第一种、也是最简单的方式,是显示最大的对象。这可以粗略评估最大数据库对象的空间使用情况,但这样的图表不会显示其他表的异常增长——只有当某张表增长到足以进入最大对象列表时,才会被发现。增长可能持续很长时间,在此期间,异常增长问题本来可能已经得到解决。第二种补充方式,是绘制在某个时间区间内大小变化最大的对象。
以表为例,考察几种情况。下面的查询可以得到最大的表:
图表(图 4.7)如下所示:
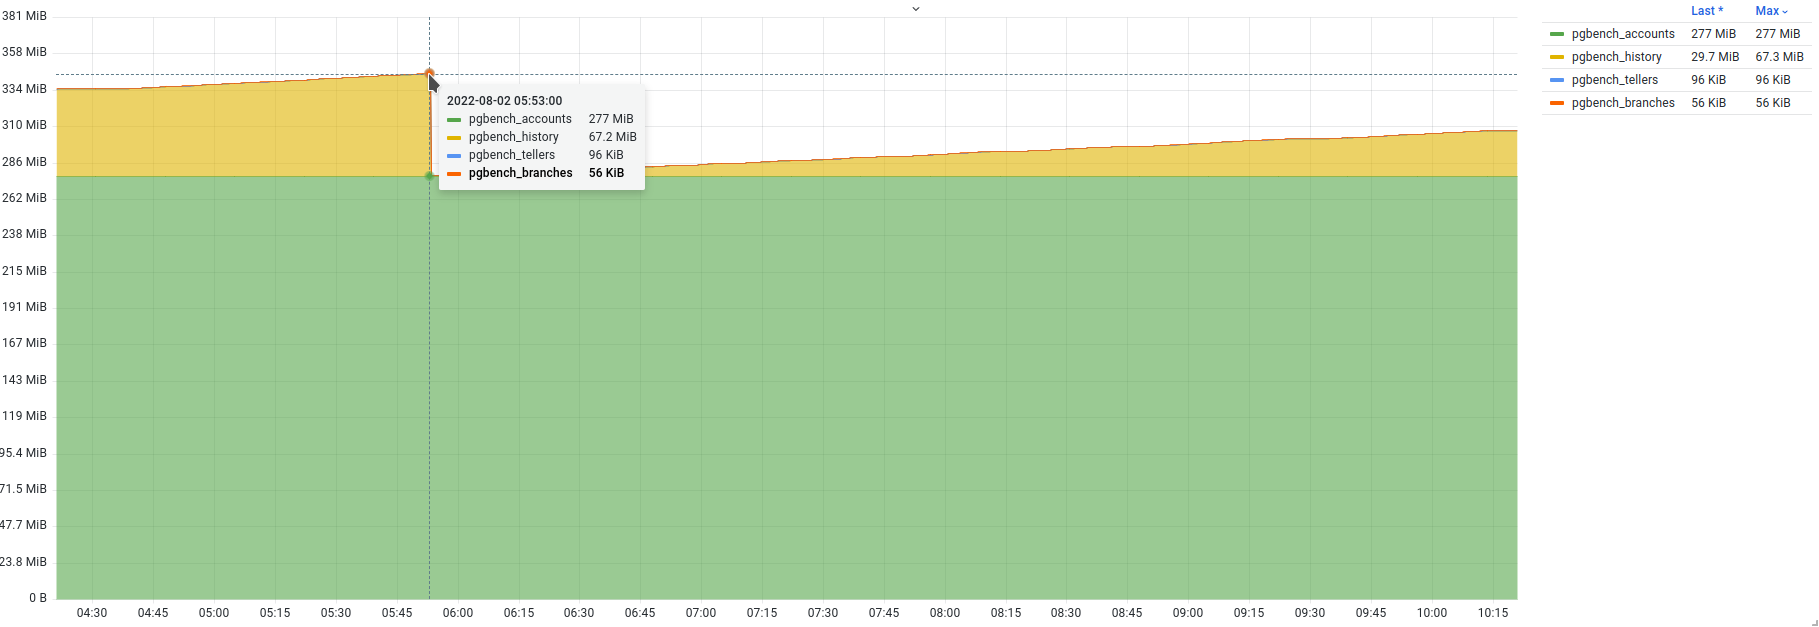
第二种查询用于获取大小变化最大的表:
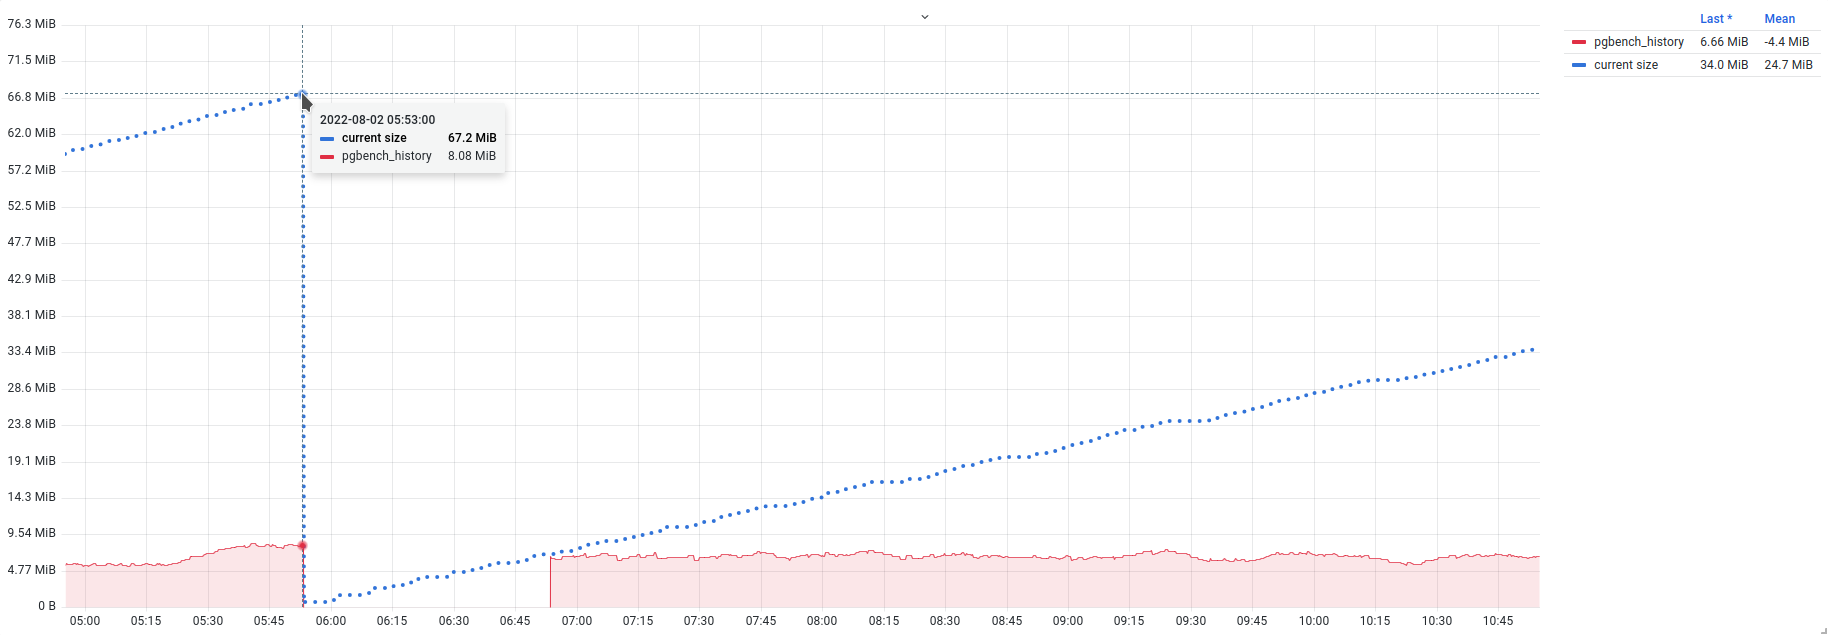
这里使用了 delta 函数,它计算一小时区间内的数值差。选择区间时要谨慎:即使一小时也可能过长,会把短时间内的剧烈大小变化平滑掉。根据该函数绘制的图表如图 4.8 所示:
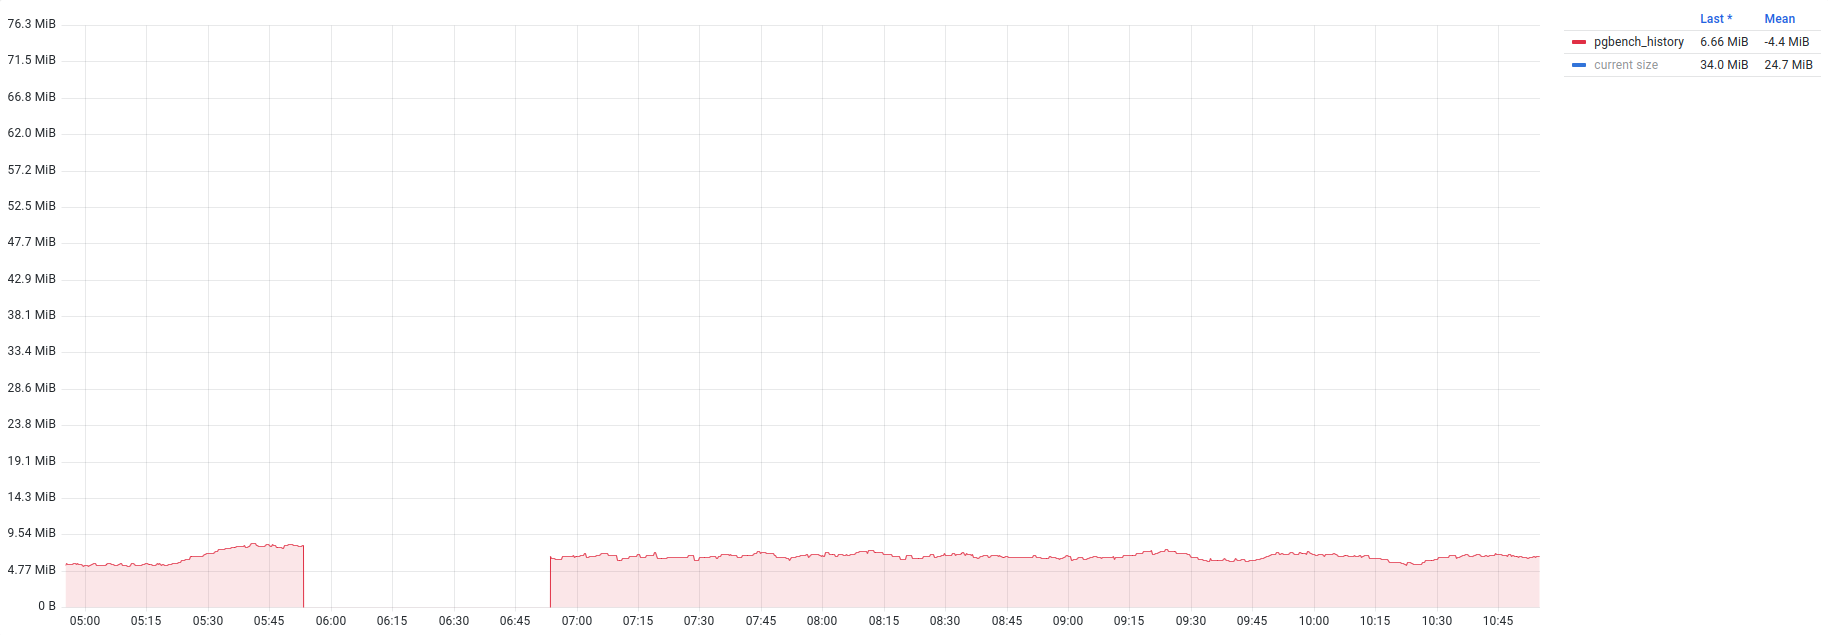
从这个例子可以看出,表先经过清理,然后以每小时约 5 MB 的速度稳定增长。为了让图表更直观,还可以叠加表本身的大小(图 4.9):
对象在文件系统中的位置
有时需要访问表和索引的物理存储层,因此必须找到对象在文件系统中的物理位置。这在分析损坏和恢复数据时经常是必要的。为此,数据库管理系统提供了几个函数:
pg_relation_filenode——接收 OID 标识符或对象名称,返回与指定对象关联的所谓文件节点(filenode)编号。文件节点是用于存储数据的文件名中的主要组成部分。对于大多数表,这个编号与pg_class.relfilenode的值相同;但对于某些系统目录,该值为零,要获取实际值就必须使用这个函数。如果指定的关系不存储在磁盘上,例如视图,该函数会返回NULL;pg_relation_filepath——返回相对于主数据目录的关系文件路径;pg_filenode_relation——这是pg_relation_filenode的逆函数,用于按文件节点编号(从文件名中取得)查找表。它根据指定的表空间 OID 和文件节点返回关系的 OID。对于默认表空间中的表,第一个参数可以传入零。
除了存放用户数据的对象外,数据库管理系统还有其他也存储在磁盘上的对象,在某些情况下同样可能占用大量空间。数据库管理系统也提供了一组函数用于查看和分析这些对象:
pg_ls_logdir——输出保存数据库管理系统服务器日志的目录内容;pg_ls_waldir——输出pg_wal目录的内容,该目录存放 WAL 日志段;pg_ls_archive_statusdir——输出pg_wal/archive_status目录的内容,该目录存放各个 WAL 段的归档状态;pg_ls_tmpdir——输出用于保存临时文件的目录内容;pg_ls_logicalmapdir——输出pg_logical/mappings的目录内容;pg_ls_logicalsnapdir——输出pg_logical/snapshots的目录内容;pg_ls_replslotdir——输出pg_replslot中指定复制槽目录的内容;pg_ls_dir——输出任意目录内容的通用函数(包括主数据目录之外的目录)。
在这些函数中,最通用的是 pg_ls_dir。该函数输出指定目录中所有文件和目录的名称,因此可以查看数据库管理系统所在服务器上的任意目录,包括操作系统目录(当然,前提是用户拥有数据库管理系统运行账号对应的访问权限):
虽然 pg_ls_dir 是通用函数,但其他函数使用起来更方便,因为不需要记住目录的确切位置。
下一个同样有趣的函数是 pg_read_file。该函数读取指定文本文件并返回其内容。下面的示例只是输出结果,但当然也可以把结果传给另一个函数继续处理。还可以指定偏移量和长度作为附加参数,以更精确地指定读取范围。
读取的内容会按照数据库编码处理;如果其中的字符不符合该编码,就会产生错误。绕过这一问题可以使用 pg_read_binary_file 函数。它同样用于读取文件,但读取任意二进制数据,并以 bytea 而不是 text 类型返回结果,因此可以绕过编码检查。结合 convert_from,可以使用这个函数读取指定编码的文本,并将其转换为数据库编码:
下一个值得特别关注的函数是 pg_stat_file,它输出指定文件系统对象的属性:
以字节为单位的大小;
最后访问时间(atime,access time);
最后修改时间(mtime,modification time);
最后状态变更时间(ctime,change time),仅适用于 Unix 系统;
创建时间(creation time),仅适用于 Windows;
指示对象是否为目录的标志。
总结一下:只要能够访问上述函数,就可以在运行数据库管理系统的用户权限范围内,读取任意目录和文件的内容。默认情况下,对这些函数的访问受到限制;如需授予函数权限,必须认真权衡并考虑安全风险。
数据库管理系统服务器日志目录的内容。 pg_ls_logdir 函数可以输出数据库管理系统日志目录的内容。目录位置取决于配置设置;使用该函数可以直接以文件列表及其属性的形式显示目录内容。考虑到快速确定数据库管理系统如何、以及向哪里写入服务器日志并不简单,而且答案还取决于系统版本,这项功能非常方便。
该函数输出数据库服务器日志目录中所有文件(隐藏文件和特殊文件除外)的名称、大小和最后修改时间(mtime)。从监控角度看,可以获得日志在磁盘上占用的总空间:
如果日志收集子系统关闭(logging_collector = off),并且 log_directory 指定的目录不存在,该函数可能返回错误。某些配置下,服务器日志可能占用大量空间,甚至可能位于数据库集簇目录中。如果日志填满文件系统上的所有可用空间,就会导致数据库管理系统异常停止。
默认情况下,只有超级用户和 pg_monitor 组成员可以访问 pg_ls_logdir 函数;也可以把执行权限授予其他用户。
输出 WAL 日志目录的内容。 下一个不直接存放用户数据、但同样可能占用大量空间的目录,是 WAL 日志目录 pg_wal。这个目录通常位于数据库集簇主目录中,但也经常被移到外部,在集簇目录中只创建一个符号链接。这样做是出于性能和空间使用方面的考虑。可以使用 pg_ls_waldir 函数输出 WAL 目录的内容。该函数输出所有普通文件的名称、大小和最后修改时间。名称以点开头的文件、目录和其他特殊文件不会输出。默认情况下,只有超级用户和 pg_monitor 组成员可以访问该函数;也可以把执行权限授予其他用户。
配置了 WAL 归档后,pg_wal 目录中会创建 archive_status 目录,用于保存所有(需要归档的)段的归档状态。可以使用 pg_ls_archive_statusdir 函数获取其内容;该函数同样输出目录中所有普通文件的名称、大小和最后修改时间(不输出名称以点开头的文件、目录及其他特殊文件)。
默认情况下,只有超级用户和 pg_monitor 组成员可以访问这个函数;也可以把执行权限授予其他用户。
pg_ls_waldir 和 pg_ls_archive_statusdir 两个函数都可以用于监控目录大小和归档队列。关于这一主题的更多内容,请参见第 7 章“复制”监控。
输出临时文件目录的内容。 下一个函数用于输出临时文件目录的内容。pg_ls_tmpdir 函数输出临时对象目录中所有普通文件的名称、大小和最后修改时间。这类目录可能有多个,位于各个表空间目录中。该函数考虑到了这一点,参数可以接收具体表空间的名称(未指定时使用 pg_default)。名称以点开头的文件、目录和其他特殊文件不会输出。默认情况下,只有超级用户和 pg_monitor 组成员可以访问该函数;也可以把执行权限授予其他用户。
pg_ls_tmpdir 可以用于监控临时文件,但其中有多种方法和细节需要考虑。关于临时文件监控的更多内容,请参见第 5 章“输入/输出”。
输出其他目录的内容。 下面的函数用于输出复制和逻辑解码相关目录的内容,逻辑解码用于逻辑复制。以下函数都会输出目标目录中所有普通文件的名称、大小和最后修改时间:
pg_ls_logicalmapdir输出 pg_logical/mappings 的内容;pg_ls_logicalsnapdir输出 pg_logical/snapshots 的内容;
pg_ls_replslotdir输出pg_replslot/slot_name的内容,其中slot_name是具体复制槽的名称。
使用逻辑复制或复制槽时,可以用上述函数进行监控。与往常一样,名称以点开头的文件、目录和其他特殊文件不会输出。默认情况下,只有超级用户和 pg_monitor 组成员可以访问这些函数;也可以把执行权限授予其他用户。
总结
数据库管理系统提供了许多用于组织和存储数据的抽象。
数据库集簇是数据库的统一且不可分割的集合。
数据库集簇、表空间、表和索引在文件系统中表现为目录和文件。
数据库是彼此隔离的“容器”。
模式是用于分组对象的命名空间。
表由用户数据主存储和辅助分支组成。
表采用固定块大小的分页组织方式。
TOAST 表是主表的附加结构,用于存储大值。
数据库集簇目录中有许多与用户数据存储无关的辅助目录。
数据库管理系统为管理员提供了一组用于操作其对象的函数。
表和索引的使用统计信息可以从另一个角度展现工作负载。
工作负载中可能出现错误和不良事件。
大小是数据库管理系统对象的重要特征。
stackoverflow.com/questions/36900462/postgres-wont-start-after-deleting-pg-xlog-files ↩︎
www.depesz.com/2016/10/25/waiting-for-postgresql-10-rename-pg_xlog-directory-to-pg_wal ↩︎
postgrespro.ru/docs/postgresql/current/sql-createdatabase ↩︎
www.cybertec-postgresql.com/en/hot-updates-in-postgresql-for-better-performance ↩︎
postgrespro.ru/docs/postgresql/current/functions-admin#FUNCTIONS-ADMIN-DBOBJECT ↩︎
postgrespro.ru/docs/postgresql/current/functions-admin#FUNCTIONS-ADMIN-GENFILE ↩︎
5 共享内存与输入/输出
本章将讨论:
如何分析共享内存的内容;
pg_buffercache和pg_shmem_allocations视图;共享缓存中的缓冲区使用情况;
如何分析后端进程的内存;
pg_stat_slru视图;如何评估数据库对象层面的输入/输出;
如何评估查询执行层面的输入/输出;
什么是临时文件,以及如何评估其使用情况;
如何评估后台写入进程和检查点进程执行的输入/输出;
pg_stat_bgwriter视图;检查点执行的特点;
如何评估数据库管理系统不同进程执行的缓冲区写入。
前几章介绍了查询和数据库管理系统的主要对象。查询决定工作负载,并作用于数据库管理系统对象——表和索引。数据库管理系统需要一块独立的运行内存,用于存放用户数据和系统数据并执行查询。内存速度很快,但具有易失性;为了可靠地保存数据,还需要使用其他存储设备,尽管它们的速度不如内存。这就产生了在“快速”运行内存与“慢速”主存储之间移动数据的需求。这种数据移动可以用一个相当笼统的术语来称呼:输入/输出(input/output)。从性能角度看,理解输入/输出的数量和速度非常重要,因为它们会直接影响性能:数据在内存区域与主存储之间移动得越快,查询执行得就越快,能够执行的查询也越多。本章将介绍数据库管理系统提供的工具,以及从数据库对象、后台进程和查询执行等角度评估输入/输出时可能需要的方法。
5.1. 分析共享内存
共享内存用于快速存放表、索引的数据以及大量不同的辅助结构。之所以称为共享,是因为数据库管理系统的所有进程都可以平等访问它,一个进程做出的修改也会对其他进程可见。通常,共享内存中最大的部分是缓冲区缓存,也称为共享缓存,用于存放用户数据。
只要缓冲区缓存能够容纳主存储中的全部数据(主数据目录和表空间),它几乎不会带来问题。但是,当存储数据量超过共享缓存的容量后,就需要有效利用已经分配的空间:哪些数据应该保留在缓存中,空间不足时又该替换掉哪些无用数据?这时可能会产生一系列问题:共享内存中有哪些系统结构,它们占用多少空间?缓冲区缓存中有哪些对象(表、索引)?这些对象的大小及其相互占比是多少?缓冲区缓存的使用效率如何?访问命中率是多少?数据找不到、必须访问主存储的情况有多频繁?数据库管理系统提供了几个可以回答这些问题的工具,既适合一次性分析,也适合定期监控:
借助这些视图,可以从表和索引以及内部辅助结构两个角度了解共享内存的内容。下面详细考察这两个工具及其使用场景。
pg_buffercache 视图
pg_buffercache 扩展可以从用户对象的角度分析缓冲区缓存,并帮助回答以下问题:
共享缓存中有哪些表和索引的页面;
表和索引使用了多少个缓冲区,以及它们占整个缓存的百分比;
当前缓存中有多少空闲缓冲区和已占用缓冲区(“干净”或“脏”缓冲区)。
使用该扩展只需通过 CREATE EXTENSION 命令安装。安装后会出现相应的函数和视图。测试环境中已经安装好该扩展,可以直接使用。
每一行描述一个独立的缓冲区;因此,缓冲区缓存越大,视图中的行就越多。根据实践经验,我不记得有过需要单独某个缓冲区信息的情况:通常需要的是按对象、数据库和表分组的统计信息。为 pg_buffercache 编写查询时,需要注意扩展安装在某个具体数据库中,但统计信息描述的是所有缓冲区,包括与其他数据库中的对象关联的缓冲区。可以与 pg_class 连接,把数值标识符转换为表名和其他关系名,但这种转换只适用于当前数据库中的对象。遇到这种情况,建议增加条件,只输出当前数据库的缓冲区,而不是全部数据库的缓冲区。
该视图包含以下字段:
bufferid——具体缓冲区的标识符。对于空闲(未使用)的缓冲区,除bufferid外所有字段都没有值(NULL);relfilenode——关系文件编号(引用pg_class.relfilenode);可以根据这个编号在主数据目录中找到对象;reltablespace——关系所属表空间的标识符(引用pg_tablespace.oid字段);reldatabase——数据库的标识符(引用pg_database.oid)。属于系统目录的共享对象,其值为零;relforknumber——指示关系分支的标识符(main、visibility map、free space map、init);relblocknumber——关系内部的块编号;
isdirty——指示缓冲区是否为脏缓冲区的标志,即其中块的内容是否不同于主存储中对应块的内容;usagecount——缓冲区访问计数器,Clock Sweep 算法使用它来淘汰共享缓存中未使用的页面3;pinning_backends——当前固定该缓冲区的后端进程数。
缓冲区固定
进程读取页面时,必须阻止其他进程修改该缓冲区,但长时间锁定缓冲区会对并发工作产生负面影响。根据行可见性规则,缓冲区只需在读取页面头部的过程中保持锁定;不过,仍然必须确保页面不会从缓冲区中淘汰,且页面内容不会发生根本变化。为了限制对缓冲区可以执行的操作范围,又不锁定缓冲区,可以使用所谓的缓冲区固定(pin):它允许其他进程读取和修改数据,但不允许淘汰页面或清理缓冲区。
利用这些数值标识符,可以准确确定缓冲区缓存中的对象(表和索引)、它们所属的具体数据库,甚至可以使用 pg_relation_filepath 函数了解它们在文件系统中的位置。
根据 isdirty、usagecount 和 pinning_backends 字段,可以区分缓冲区可能处于的几种状态,从而判断缓冲区缓存的使用程度。数据库管理系统启动、缓冲区缓存初始化后,大多数缓冲区都未被使用,也没有关联任何块(除 bufferid 外没有其他值)。查询执行时,数据库管理系统会访问主存储,将表和索引的数据填入缓冲区缓存;缓冲区就会从空闲状态转为已占用状态。此时,缓冲区与表或索引的具体块关联。reltablespace、reldatabase 和 relfilenode 字段共同决定了与缓冲区关联的对象。
还可以关注 usagecount 的值,它表示当前访问缓冲区的强度。每次访问都会使计数器加一(最大值为 5),每次执行淘汰算法都会使它减一。如果执行递减时计数器已经为零,块就会被淘汰并替换为另一个块。因此,根据 usagecount 的值(0 到 5),可以判断缓冲区的使用活跃程度。
还可以进一步细分已占用缓冲区的状态。例如,后端进程可能正在访问缓冲区,读取或修改其中块的数据;这由非零的 pinning_backends 值表示。如果缓冲区内容被修改,它就会变成脏缓冲区,必须把这些修改写入主存储中与该缓冲区关联的块。脏状态由 isdirty 标志表示。
因此,至少可以从两个维度考察缓冲区缓存的使用情况:
在较高层面,按空闲、已使用、已固定和脏缓冲区划分。
在更细的层面,根据访问计数器(
usagecount)划分,其取值范围为 0 到 5。
在定期监控中使用 pg_buffercache 时,需要注意该视图只显示轮询时刻的缓冲区状态;两次轮询之间缓冲区发生了什么是未知的。这与 pg_locks 和 pg_stat_activity 的工作方式类似。
对性能的影响
在 PostgreSQL 10 之前,pg_buffercache 的内部机制会使用锁来获取所有缓冲区的一致状态。在工作负载繁重的系统中,这些锁会降低性能。从版本 10 开始,缓冲区管理器不再设置这些锁。因此,访问 pg_buffercache 对缓冲区正常活动的影响变小了,但针对所有缓冲区得到的结果整体上可能不一致(通常这并不严重)。对于每个单独的缓冲区,信息的一致性仍然有保障。
回到前面查询 pg_buffercache 的 SQL。它的输出几乎全部是数值标识符;要得到更易理解的信息,需要把结果与其他信息源连接起来并进行一些转换。
得到的结果更容易理解了:对象不再以数值标识符显示,统计信息按对象分组,块数也被汇总,并额外换算成了字节数。现在可以看出,在测试环境中,缓冲区缓存的大部分空间(shared_buffers 参数设置为 128 MB)由 pgbench_accounts 表及其索引占用。
换算为字节
在测试环境中,我预先知道块大小,因此查询示例使用常量 8192。不过,在实践中,块大小可以在从源代码编译时重新定义,这种情况下换算结果就会不正确。可以使用更通用的方案,通过调用 current_setting('block_size') 函数从数据库管理系统配置中获取实际块大小。需要将块大小表示为字节、但又不知道确切块大小时,优先使用这种方法。
下面的查询可以获取缓冲区缓存的使用情况,并了解处于不同状态的缓冲区容量之间的关系。
从查询输出可以看出,大部分缓冲区都是脏的。这说明系统确实发生了大量修改:前面介绍查询的章节已经说明,测试工作负载中占主导的是更新 pgbench_accounts 中记录的查询。在测试环境中,监控代理使用类似的查询获取 postgres_shared_buffers_all_usage_bytes 指标,并据此绘制下面的图表(图 5.1):
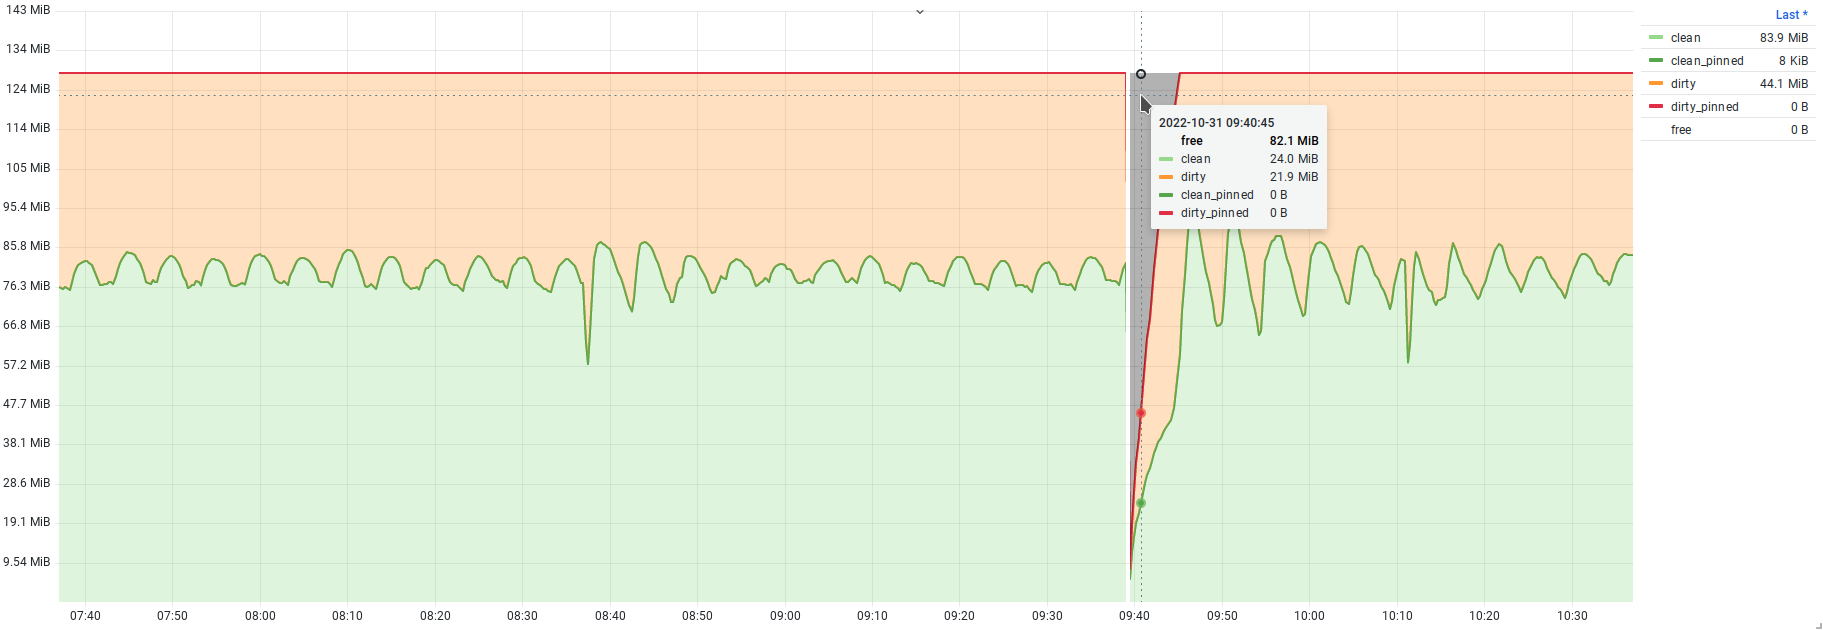
图中记录了数据库管理系统容器重启的时刻,此时缓冲区缓存被清空。一段时间内,缓冲区缓存中存在空闲缓冲区,但它们很快就会耗尽。
还可以用另一种图表展示数据:按数据库名称分组统计。这样可以跟踪特定数据库页面对缓冲区缓存的填充情况;当一个集簇中使用了许多数据库时,这种方式可能很有用。
pg_shmem_allocations 视图
pg_buffercache 扩展只显示用于缓存表和索引的缓冲区信息。不过,除了缓冲区缓存外,共享内存中还放置着各种辅助结构,数据库管理系统的所有进程(包括后端进程和后台进程)都可以访问这些结构。可以使用 pg_shmem_allocations 视图对共享内存进行结构分析。
每一行描述为某个特定辅助结构分配的一段内存。列表中最大的结构是 Buffer Blocks 区域,用户对象的数据缓冲区缓存就存放在其中,可以使用 pg_buffercache 对其进行详细研究。查看该视图的完整输出可以发现,共享内存中放置了大量结构。例如,在版本 15 中大约有六十个,具体数量可能因配置、所使用的模块等因素而异。视图本身的字段并不多:
name——段的名称,可以据此大致判断其用途。没有名称(NULL)的段表示未使用的内存;名称为<anonymous>的段是匿名段,可以用于存放锁信息;off——段在共享内存区域中的起始偏移量。匿名段没有偏移量值(NULL);size——段的大小,单位为字节;allocated_size——考虑对齐(padding)后的段大小。对于空闲内存和匿名段,size与allocated_size的值始终相等。
在日常监控中,pg_shmem_allocations 提供的信息并不十分有用。它主要适用于少数故障排查场景,或者在开发、调试数据库管理系统的新功能时检查内存使用效率。
5.2. 分析后端进程的内存
另外两个同样可能对调试和排查问题有用的工具是 pg_backend_memory_contexts 视图和 pg_log_backend_memory_contexts 函数。这两个工具都用于显示某个具体进程所使用的内存段信息,但视图和函数的行为有所不同。视图只显示与当前会话关联的进程的内存分布,无法用来查看其他进程(例如正在执行长查询的进程)的内存布局。遇到这种情况,应使用 pg_log_backend_memory_contexts 函数;它接收进程标识符作为参数,并将内存布局输出到数据库服务器日志中。
每一行包含某个具体内存区域(即所谓的上下文)的信息、使用指标以及其他数据:父上下文、嵌套层级、块数(total_nblocks)和空闲片段数(free_chunks)。
这些工具更适合调试和排查问题,而不是常规监控。不过,截至目前(版本 15),它们是唯一能够详细分析数据库管理系统进程内存构成和使用情况的工具。
5.3. 评估 SLRU 缓存的使用情况
还需要考察另一组缓存,即 SLRU 缓存(Simple Least-Recently-Used,简单最近最少使用)。这些独立缓存用于加快访问存放在主数据目录磁盘上的某些辅助结构。此类辅助结构包括:
事务提交状态日志结构(clog,commit log);
支持嵌套事务(subtransactions)的结构;
跟踪事务提交时间的结构(参见 track_commit_timestamp);
与通知子系统相关的结构(
LISTEN和NOTIFY命令);其他使用基于 SLRU 算法的缓存的结构。
可以使用 pg_stat_slru 视图跟踪 SLRU 缓存的使用情况:
每一行包含某个具体 SLRU 缓存的累计使用统计(缓存列表是固定的):
name——SLRU 缓存的名称;blks_zeroed——初始化期间填零的块数;blks_hit——在缓存中找到的块数;blks_read——必须从磁盘上的主存储读取的块数;blks_written——必须从缓存写入磁盘的脏块数;blks_exists——在磁盘上成功找到的块数;flushes——已执行的脏块同步请求数;truncates——因块已不再需要而执行的删除块请求数(在维护操作期间);stats_reset——上次重置统计信息的时间戳。
目前,SLRU 缓存使用统计只能用于监控,因为数据库管理系统的配置中没有可以调节其大小的参数(不过,未来不排除会出现这样的参数)。统计信息的主要用途是评估缓存效率。
5.4. 从数据库管理系统对象角度评估输入/输出
前面介绍的 pg_buffercache 统计信息只能分析缓冲区缓存使用的总体情况。使用该视图监控缓冲区缓存无法完整反映输入/输出量,因为它只包含当前位于缓存中的对象信息,许多在两次统计快照之间被访问的其他数据库对象可能会从视野中消失。要更完整地统计输入/输出,需要针对所有数据库对象的累计统计信息。这些信息分布在多个视图中,其中一个我们已经遇到过:
pg_stat_database包含各个数据库的部分输入/输出统计信息;pg_statio_all_tables——表的输入/输出统计信息(包括 TOAST 表和临时表);pg_statio_all_indexes——索引的输入/输出统计信息;pg_statio_all_sequences——序列的输入/输出统计信息。
数据库
前面几章已经介绍过 pg_stat_database 视图。现在重新讨论它,是因为其中有几个字段提供了按数据库划分的输入/输出信息:
blks_hit——在共享缓存和本地缓存中找到的块数;blks_read——从磁盘读取的块数(包括在操作系统页缓存中找到的块);blk_read_time——读取磁盘所耗费的时间,单位为毫秒;blk_write_time——写入磁盘所耗费的时间,单位为毫秒。
只有启用 track_io_timing 参数后,才会统计耗时。要完整了解情况,还缺少已写入块和脏块的统计信息。利用这些数据可以大致评估缓存使用效率,但需要注意,统计信息同时包含共享缓存和本地缓存的数据;当临时表被广泛使用时,这一点尤其重要。
可以使用下面的查询评估缓存效率并计算缓存命中率:
得到的指标反映了缓存的使用效率。接近 1 的值表示所需数据能够在缓存中成功找到。相反,值越接近 0,所需数据就越不容易在缓存中找到,数据库管理系统也就越频繁地需要访问主存储,读取数据,再将其加载到缓存中,同时把其他数据从缓存中淘汰。缓存效率持续偏低时,大量时间会耗费在磁盘输入/输出上,从而损害整体性能。遗憾的是,这里没有简单或通用的解决方案,提高缓存效率可以采用多种方式。最直接的办法是增大共享缓存,但这种方法并不总能奏效。更合理的办法是找出执行了大部分输入/输出或在此过程中耗费大量时间的查询,并尝试优化这些查询(例如重构查询或添加索引)。通过这种优化,查询性能可能提高几十倍甚至几百倍,同时缓存使用效率也会提高,而无需修改配置。
还可以利用这些统计信息,通过 blk_read_time 和 blk_write_time 跟踪输入/输出耗时(图 5.2):
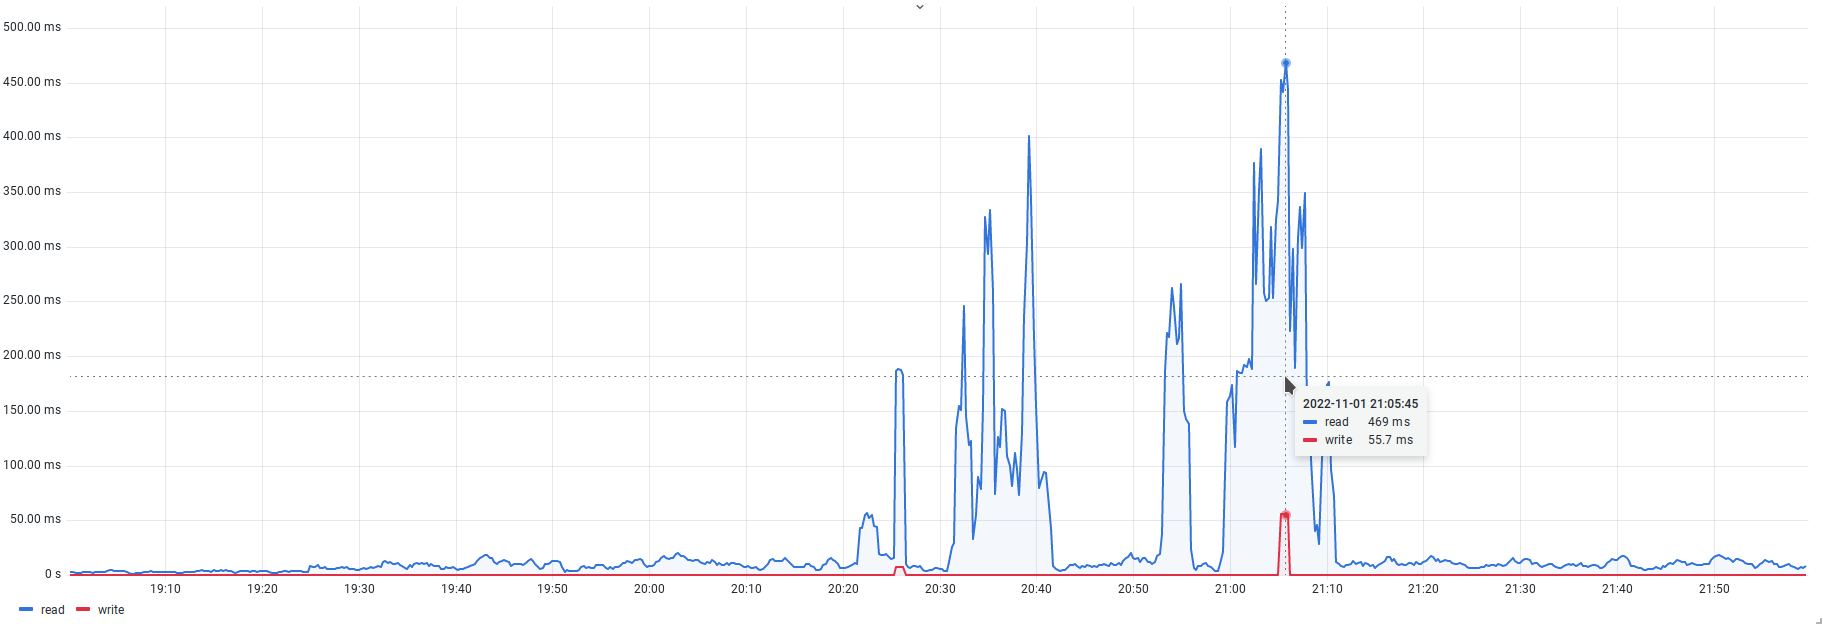
这种图表适合整体评估数据库管理系统的状态,能够反映数据库管理系统被迫耗费时间读取和写入数据的时刻;这些时刻可能导致查询执行出现性能下降。
表、索引和序列
要获取数据库管理系统各个对象层面更详细的输入/输出信息,可以使用下面的视图:
pg_statio_all_tables包含每张表的统计信息:
— heap_blks_read——从磁盘读取的块数;
— heap_blks_hit——在缓存中找到的块数;
— idx_blks_read——从磁盘读取的、属于该表的所有索引的块数;— idx_blks_hit——在缓存中找到的、属于该表的所有索引的块数;
— toast_blks_read——从磁盘读取的 TOAST 表块数;
— toast_blks_hit——在缓存中找到的 TOAST 表块数;
— tidx_blks_read——从磁盘读取的 TOAST 表索引块数;
— tidx_blks_hit——在缓存中找到的 TOAST 表索引块数。
pg_statio_all_indexes包含每个索引的统计信息:
— idx_blks_read——从磁盘读取的块数;
— idx_blks_hit——在缓存中找到的块数。
pg_statio_all_sequences包含每个序列的统计信息:
— blks_read——从磁盘读取的块数;
— blks_hit——在缓存中找到的块数。
上述视图包含所有对象的统计信息,包括用户对象和属于系统目录的系统对象。以 pg_statio_sys_ 和 pg_statio_user_ 为前缀的视图分别提供系统对象和用户对象的统计信息。
还需要特别注意缓存命中统计(字段名带有后缀 _hit)。当在缓冲区缓存中找到某个块时,不会发生输入/输出:该块已经位于数据库管理系统拥有的内存中,因此只需读取缓冲区中的所需行,甚至其中一部分即可。需要理解的是,缓存命中统计显示的是在缓存中找到的数据量,但实际需要的数据量可能更少。组织监控时,应尽量避免直接将缓存命中量与读取量进行比较,尤其不要把两个值都表示成字节。评估缓存效率时,最好计算缓存命中量占数据访问总量(缓存命中和从存储读取)的比例。缓冲区脏化和页面写入统计(pg_stat_statements 视图中的 blks_dirtied 和 blks_written 字段)同样如此:插入、更新或删除单独的行时,块的脏化只是对缓冲区的部分修改;与将整个块直接写入主存储不同,它不会导致输入/输出。在把指标合并到一张图中、计算输入/输出量、编写性能报告以及选择通用计量单位(块或字节)时,都要考虑这一细节。
这项统计还有一个重要特点:数据库是表、索引及其他对象的某种隔离容器。因此,这些视图只包含属于当前数据库的对象的统计信息。要收集数据库集簇中所有对象的统计信息,必须依次连接到每个数据库。
单个对象的统计信息能够提供详细的输入/输出数据,但通常只有在优化或排查性能瓶颈等特殊情况下才需要这些数据。以我多年的实践经验来看,需要如此详细信息的情况一只手就数得过来。在许多生产环境中,数据库、表和索引的数量可能很大。监控会生成大量指标,因此在采集和存储之前,应先评估这些指标的实际价值。
下面的查询可以得到数据库各表的读取量(图 5.3 和 5.4):
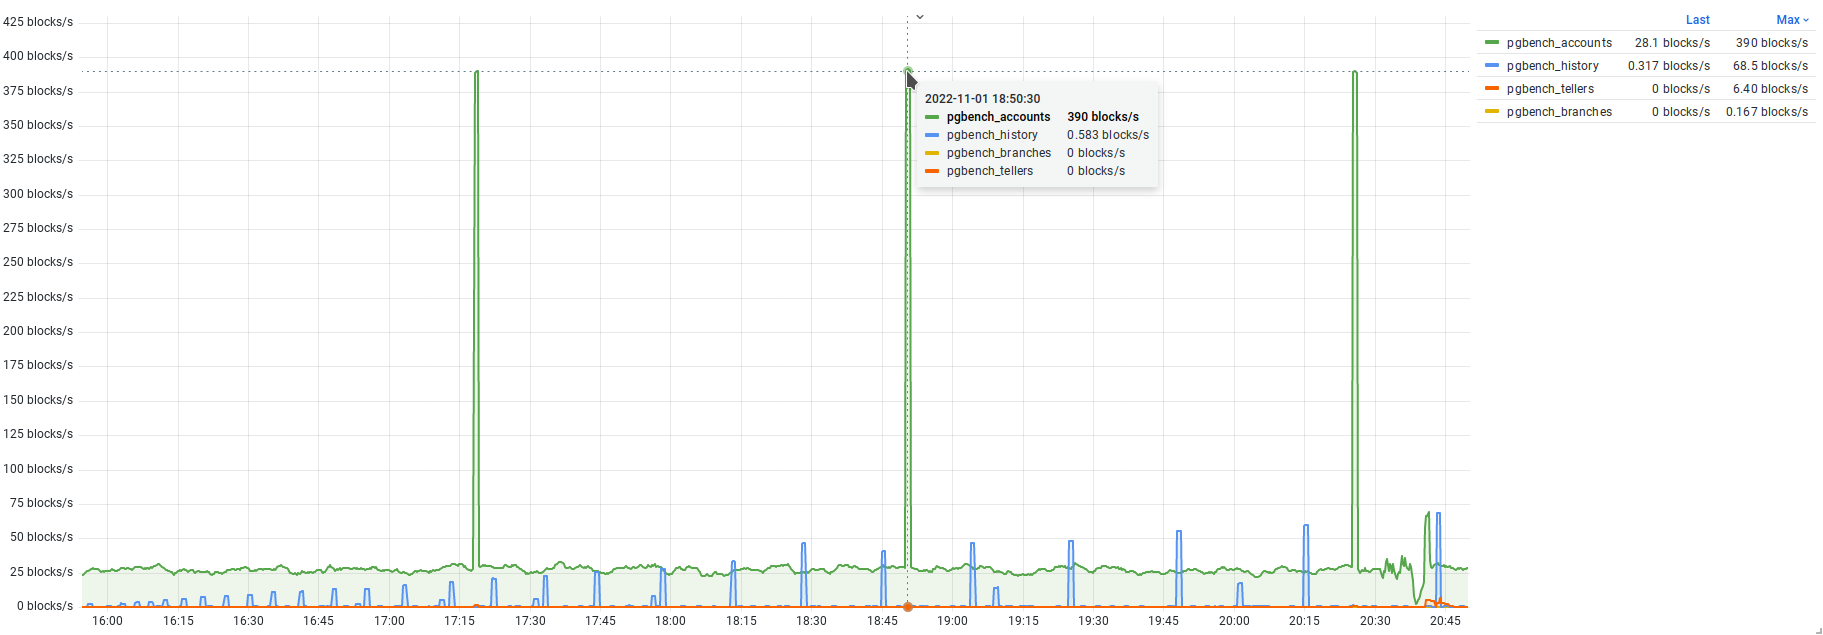
第一张图(图 5.3)中的输入/输出量大致稳定,但从生产运行的角度看,仍然可能需要关注与 pgbench_accounts 表相关的周期性峰值,以及 pgbench_history 表读取量的增加。后者没有峰值那么明显,但在关闭其他指标后就能看出来(图 5.4)。
下面的查询显示 pgbench_accounts 表在缓存中命中的块数以及从磁盘读取的块数(这是测试环境中使用最频繁的表;图 5.5):
从图中可以看出,大部分块从缓存读取,只有相对较小的一部分从主存储(或操作系统页缓存)读取,这对性能总体有利。当然,还需要注意,计量单位使用的是未经任何换算的块。
5.5. 从查询执行角度评估输入/输出
可以使用 pg_stat_statements 扩展分析已执行的查询;前面几章已经介绍过这个扩展。该视图包含大量有用信息,其中也包括按查询类型划分的输入/输出统计。与 pg_stat_database 和 pg_statio_* 相比,查询级统计信息更加完整:
shared_blks_hit——在缓冲区缓存中找到的块数;
shared_blks_read——从磁盘或操作系统页缓存读取到共享缓冲区缓存中的块数;shared_blks_dirtied——由于发生修改而变脏的共享缓冲区缓存块数;shared_blks_written——内容已写入磁盘的共享缓冲区缓存块数。
统计信息还包括本地缓存的对应字段:local_blks_hit、local_blks_read、local_blks_dirtied 和 local_blks_written。在介绍查询的第 3 章中,我们已经讨论过 blk_read_time 和 blk_write_time 字段,它们表示输入/输出所耗费的时间。
这些统计信息可以用于以下场景:
确定具体查询产生的输入/输出量;
找出访问临时表的查询及其产生的输入/输出量(临时表使用本地缓存,其大小由 temp_buffers 参数决定);
评估已实施优化的效果(执行具体查询时的输入/输出量发生了什么变化);
在确定优化优先级时评估查询的输入/输出量(输入/输出量更大的查询经过优化后,在资源利用方面会有更明显、更有效的改善)。
在某些特殊的性能问题排查场景中,还可能有其他使用方式。
5.6. 临时文件
查询执行,尤其是复杂查询的执行,由与计划节点对应的多个步骤组成。在这些步骤中,通常会对数据执行某些操作(选择、过滤、排序、比较等)。排序数据、为连接和聚合构建哈希表、物化 CTE 等操作可能需要临时缓冲区。为此会分配一块大小为 work_mem 的工作内存,通常比较小,默认值为 4 MB。不过,查询处理的数据量可能大得多。工作内存不足时,系统会在磁盘上创建临时文件,并将一部分数据移入其中。查询完成后,执行查询所需的所有临时文件都会被删除。使用临时文件通常会降低查询性能,因为所需数据必须写入磁盘并从磁盘读取。从性能角度看,应跟踪所有使用临时文件的查询,并设法优化它们,消除输入/输出的必要性。
数据库管理系统的统计信息提供了多个跟踪临时文件的来源,可以用于不同场景:
pg_stat_database包含按数据库划分的已创建临时文件统计信息;pg_stat_statements包含按查询执行划分的临时文件输入/输出统计信息;数据库管理系统的服务器日志也可以记录临时文件的使用情况(参见 log_temp_files),其中还可能包含查询文本。
这三个来源都有一个共同特点:只有在查询结束时才会记录使用统计信息。对于执行时间很长、已经使用临时文件的查询来说,这很不方便:统计信息只有在查询成功结束后才会更新;如果查询因为超时(例如 statement_timeout)异常结束,或者被管理员通过 pg_terminate_backend 函数强制终止,则不会记录这些信息。
下面逐一介绍获取临时文件统计信息的各种方法。
数据库级别
pg_stat_database 视图包含 temp_files 和 temp_bytes 字段,分别表示临时文件的总数及其大小。我们知道,pg_stat_database 的每一行都包含某个数据库的累计统计信息,因此这两个字段也表示统计信息累计期间的总量(统计信息重置时间记录在 stats_reset 中)。
测试环境中的查询几乎不使用临时文件,但仍然可以看到一些统计信息。接下来进行实验时,将使用下面的查询;在 work_mem 取默认值的情况下,它一定会需要临时文件:
查询执行需要几秒钟,并会创建一个约 60 MB 的临时文件。再次查询 pg_stat_database,可以发现 postgres 数据库记录了临时文件的使用情况:
利用 postgres_database_temp_bytes_total 指标可以绘制图表(图 5.6):
这种图表通常用于粗略跟踪临时文件:一旦发现临时文件使用量达到临界水平,就可以通过 pg_stat_statements 或服务器日志进行更详细的分析。
temp_bytes 计数器的一个重要特点是记录临时文件的最终大小。不要把这个大小与该文件产生的输入/输出量混淆:文件可能被反复读写,已执行的输入/输出量可能远远超过文件的最终大小。
查询执行期间的输入/输出
pg_stat_statements 扩展是跟踪临时文件的第二个来源。该视图中下面这些字段显示查询的输入/输出量,以及处理临时文件所耗费的时间:
temp_blks_read——从临时文件读取的块数;temp_blks_written——写入临时文件的块数;temp_blk_read_time——读取临时文件所耗费的时间,单位为毫秒;temp_blk_write_time——写入临时文件所耗费的时间,单位为毫秒。
没有 _hits 和 _dirtied 计数器是正常的,因为所有输入/输出都直接针对文件进行,不经过缓存。此外,临时文件使用的处理方式也不同于缓冲区缓存(共享缓存或本地缓存)所采用的基于页面的方式:这里的输入/输出处理的是没有头部、紧密排列的行,而且只处理所需字段。视图中还有一个 dbid 字段,按该字段分组可以获得各个数据库的统计信息。这可能让人想到 pg_stat_database,但 pg_stat_database 统计临时文件的数量和大小,而 pg_stat_statements 统计输入/输出量。直接比较 pg_stat_database 和 pg_stat_statements 中的值没有什么意义。
从查询监控的角度看,Top-K 图表也很有用,它们可以快速找出使用临时文件最多的查询。不过,测试环境中没有合适的查询,因此这种图表不会显示有意义的内容。
在服务器日志中跟踪
跟踪临时文件的下一种方法是使用数据库管理系统的服务器日志。默认情况下,临时文件消息记录是关闭的;要启用它,需要通过 log_temp_files 参数设置阈值。临时文件大小超过该值时,包含查询文本在内的相关信息会写入服务器日志。临时文件使用记录具有容易识别的特征:其中包含 temporary file 文本、文件路径和以字节表示的文件大小,下一行会显示查询文本:
关注服务器日志
实际工作中曾发生过这样的情况:监控系统发出磁盘可用空间不足的告警。很快就发现,原因是服务器日志占用了大量空间。不过,只有最近两天的日志明显变大,前几天的日志小了几十倍。分析日志内容后发现,工作负载中出现了大量使用临时文件的查询。但问题不在临时文件,而在查询文本。查询包含一个很长的 IN 列表,由应用程序自动生成,并且没有长度限制。结果,列表中包含数万个 UUID 值,查询文本达到数 MB。每记录一次临时文件使用情况,还会额外写入一条包含巨大查询文本的记录,最终导致日志体积增加。
跟踪活动临时文件
使用 pg_stat_database 和 pg_stat_statements 视图跟踪临时文件存在一个缺点:只有使用临时文件的查询结束后,统计信息才会记录,而此时临时文件本身已经被删除。对于执行很快的查询,这没有问题;但对于运行数分钟的长查询,这种行为可能无法接受。最糟糕的情况是,正在执行的查询所需的临时文件数量和大小不断增加,直到磁盘上的所有可用空间耗尽,导致数据库管理系统异常停止。此时只能看到磁盘空间耗尽,却不容易看出耗尽的原因。数据库、表和索引的大小都不会变化,而临时文件信息只有在查询成功结束后才会出现。
要有效跟踪临时文件,需要能够发现当前正在使用的活动临时文件。为此需要使用操作文件系统的函数,并了解数据库管理系统数据目录的文件层次结构。
先从文件系统的布局开始。数据库管理系统使用 temp_tablespaces 参数指定临时文件4的存放位置;该参数列出一组表空间,系统会从中随机选择一个,并在所选表空间的 pgsql\_tmp 子目录中创建临时文件。不过,默认情况下,以及大多数配置中,temp_tablespaces 通常为空(NULL);此时使用当前数据库的默认表空间。通常这个表空间是 pg_default,临时文件会创建在 base/pgsql\_tmp 子目录中。临时文件名的格式为 pgsql_tmpPPP.NNN,其中 PPP 是文件所属后端进程的标识符,NNN 是文件序号,用于区分同一进程所属的文件。
知道临时文件所在的目录后,只需查看这些目录,并使用访问文件系统的函数获取临时文件统计信息。
为了进行实验,我们打开两个会话,在第一个会话中执行之前介绍过的、会创建临时文件的查询;不过这次对查询进行修改,再增加一次表连接,以提高处理量:
用于输出所需统计信息的查询有几十行,因此这里不再列出,但可以在测试环境的 scripts 目录中找到它5。在第二个会话中,我们会定期执行包含该查询的 SQL 脚本;它不仅可以显示临时文件大小的增加,还可以显示新段的出现:
还可以打开第三个会话,观察 pg_stat_database 和 pg_stat_statements 视图中的统计信息何时更新。
5.7. 后台进程的输入/输出
数据库管理系统除了后端进程外,还有同样会执行输入/输出的后台服务。本节介绍后台写入进程 background writer 和执行检查点的检查点进程 checkpointer。这两个进程都负责把缓冲区缓存中的变更写入主存储。由于数据量和所需的输入/输出操作数量可能很大,进程不会在变更发生时立即写入,而是在后台异步写入数据。
后台写入进程的任务是把缓冲区缓存中的脏缓冲区写入主存储。该进程交替执行工作和暂停。在开始下一轮迭代之前,它会评估上一轮迭代期间对缓冲区的访问次数:访问越多,本轮写入的缓冲区就越多(参见 bgwriter_lru_multiplier),但不会超过 bgwriter_lru_maxpages6 指定的上限。在脏缓冲区中,进程会选择近期最有可能被淘汰的缓冲区;为此,它实际上会重复执行淘汰算法,但不会减少使用计数器。也就是说,后台写入进程采取主动方式,避免后端进程尝试淘汰脏页。
checkpointer 进程执行检查点,将变更可靠地写入主存储。检查点完成时,可以保证检查点开始之前发生的所有变更都已经与磁盘同步。检查点通过删除旧段、为新段释放空间来维护 WAL 日志。执行检查点时,进程会扫描缓冲区缓存,把所有脏缓冲区标记为需要同步,然后逐步将其中的内容写入主存储。这项工作同样会产生输入/输出,输入/输出量直接取决于脏缓冲区的数量。关于检查点进程工作的完整信息,可以参见文档7和书籍8。
pg_stat_bgwriter 视图。 可以使用 pg_stat_bgwriter 视图跟踪后台写入进程和检查点进程的工作。历史上,这两项任务由同一个进程执行;但在 9.2 版本中,与检查点相关的工作被拆分到独立进程中,而统计信息仍然保留在同一个视图中。该视图只有一行:
这些统计信息不仅涉及后台写入进程和检查点进程,也涉及整体的后台写入。下面详细考察这个视图。
检查点的触发原因。 前两个字段描述已执行检查点的数量:
checkpoints_timed——按计划执行的检查点数量;checkpoints_req——按需执行的检查点数量。
可以看出,检查点有两种启动方式:一种是按计划启动,即按照 checkpoint_timeout 参数指定的时间间隔执行;另一种是按需启动,即 WAL 写入量超过 max_wal_size 参数设定的限制时,在计划之外启动。此外,管理员通过 CHECKPOINT 命令启动的检查点,以及数据库服务器关闭时为将缓冲区缓存与主存储同步而执行的检查点,也属于后一类。
配置检查点有两种策略。第一种策略依赖按计划执行检查点:设置相对较长的 checkpoint_timeout 时间间隔,并让检查点执行过程延续整个间隔。这种策略适用于性能较低的硬件,目的是分散检查点带来的负载,使其对整体性能的影响尽可能小。在这种情况下,如果出现按需检查点,说明负载增加了,在设定的时间间隔结束之前就有更多数据写入 WAL 日志。这种策略的缺点是:如果增大 checkpoint_timeout 间隔和 max_wal_size 上限,由于 WAL 日志写入量更大、检查点更加稀疏,潜在故障后的恢复可能需要很长时间(因为故障恢复时必须重放 WAL 中记录的所有变更)。
第二种策略依赖根据 max_wal_size 的值按需执行检查点:WAL 日志写入量一达到指定值,就启动检查点。这种方法适合调节故障后的恢复时间:由于知道需要重放多少 WAL,恢复时间更容易预测,而且可以根据硬件的性能特点调整 max_wal_size 的值。不过,这种策略也有缺点。max_wal_size 只是一个参考值,实际写入 WAL 日志的变更可能更多,这同样会影响恢复时间。
WAL 日志写入有一个特点:执行检查点后,缓存中任意缓冲区的第一次修改都会执行整页写入(full page write,FPW),将该缓冲区中的整页写入日志(参见 full_page_writes)。之后对该缓冲区的所有修改都会单独记录。因此,检查点执行得越频繁(无论按时间间隔还是按需执行),写入整页镜像带来的额外负载就越大;负载大小取决于缓冲区缓存的大小以及其中发生的变更量(INSERT、UPDATE、DELETE 操作)。
可以注意到,在实践中第一种配置策略更常见,原因正是检查点通常被视为一种开销很大的操作,最好谨慎执行,尽量减少对其他进程和正在执行的查询性能的影响。在这种策略下,checkpoints_req 增加会被视为负面信号,需要评估实际负载是否增加及其对整体性能的影响,重新考虑配置,并进一步查找负载增加的原因。如今,磁盘子系统借助 SSD 和 NVMe 设备大幅提升了性能,这种方法的重要性已经受到质疑。无论采用哪种策略,都应根据存储子系统的性能指标以及查询执行时数据库管理系统的吞吐量来做选择。
监控时可以根据这些指标绘制图表(图 5.7),跟踪“非预期”检查点出现的峰值(具体取决于所选的配置策略)。
图中可以看出,大部分检查点都是按计划执行的,这说明 WAL 日志写入量保持在 max_wal_size 上限以内。也有一些按需执行的检查点:如果这是生产环境,可能意味着 WAL 写入出现峰值;但测试环境中的负载很稳定,因此 WAL 写入量也很平稳,没有明显突增。为了演示,这些检查点是通过 CHECKPOINT 命令启动的。
检查点执行时长。 检查点执行过程可以粗略分为两个阶段:把脏缓冲区的内容写入磁盘,以及调用同步操作将其与主存储同步(参见 fsync)。第一阶段的写入不能可靠保证数据已经保存,因此必须执行第二阶段的显式同步(但即使如此也可能出现问题9)。这种阶段划分是粗略的,因为检查点执行机制会把同步请求排成队列;如果队列已满,就会暂停写入,先同步已经写入的块,然后恢复写入。下面的字段分别显示这两个阶段所耗费的时间(两个值的单位都是毫秒):
checkpoint_write_time——写入页面所耗费的时间;checkpoint_sync_time——执行同步所耗费的时间。
第一个阶段的页面写入占检查点的大部分时间,而同步是最后阶段,通常要快得多。不过,同步速度取决于磁盘子系统的性能:在速度较慢的存储设备上,同步阶段可能积压输入/输出请求队列,从而增加延迟并降低性能。因此,同步缓慢说明磁盘子系统的性能不足。通过这些字段的值,可以跟踪同步所需的时间;如果同步变慢,就应评估检查点对查询性能的影响(检查点同步期间查询执行时间的变化)。
可以根据 postgres_checkpoints_seconds_total 指标绘制图表来跟踪执行时间(图 5.8):
图中可以看出,检查点执行时间总体平稳,但在这段时间内有两个检查点的同步持续了约 10 秒。这与其他检查点相比很突出,足以引起关注并进一步查明为什么同步偶尔会持续这么长时间。
缓冲区写入。 下面的字段可以分析后台进程和后端进程写入的数据量:
buffers_checkpoint——检查点进程写入的缓冲区数量;buffers_clean——后台写入进程写入的缓冲区数量;
buffers_backend——后端进程写入的缓冲区数量;buffers_alloc——为存放数据页面而分配的缓冲区数量;maxwritten_clean——后台写入进程因达到 bgwriter_lru_maxpages 参数指定的上限而暂停刷写脏页的次数。
可以把后台写入进程看作检查点进程的助手。它持续写入脏页,从而减少执行检查点所需的工作量。前两个指标显示这两个后台进程完成的工作量。第三个指标显示后端进程写入的缓冲区数量,其中也包括自动清理工作进程。回想一下,如果进程无法在缓存中找到所需的数据块,就必须从磁盘读取该块。为此,通常需要找到一个缓冲区(buffers_alloc),并淘汰其中已有的块。如果找到的缓冲区是脏的,还必须把缓冲区内容写入磁盘。后台写入进程会提前完成这项工作。
数据库管理系统的配置包含几个用于调节后台写入进程工作的参数10,因此这些参数会影响该进程在一次工作循环迭代中完成的工作量和产生的负载。通过 maxwritten_clean 指标,可以评估后台写入进程因达到 bgwriter_lru_maxpages 指定的上限而停止的频率。这样,结合 buffers_backend 和 maxwritten_clean 的值,可以评估后台写入进程的效率:两个值越小越好。配置时需要记住,后台写入进程会给输入/输出子系统带来负载。配置过于激进会让进程执行多余的输入/输出,从而可能损害其他进程的性能。
可以将上述指标绘制成图表(图 5.9)。图中可以看到,后台写入进程和检查点进程产生的负载比较稳定、平缓,而后端进程产生了两个写入请求峰值。需要进一步确认后台写入进程是否能够应对这种情况(参见 maxwritten_clean),或者这只是工作负载中的突发峰值。
还剩下两个字段需要考察:
buffers_backend_fsync——后端进程被迫自行执行同步的次数。同步操作通常交给检查点进程,但也可能由后端进程执行,这被视为不良信号。在我的数据库管理系统运维实践中,从未遇到过buffers_backend_fsync大于零的情况;stats_reset——其他视图中已经熟悉的字段,表示统计信息重置的时间戳。通常,如果后台写入和检查点统计信息被收集到监控系统中,就不需要查看这个字段;但如果
使用该视图的统计信息生成汇总报告,就必须确保统计信息是在相对较长的时间段内累计的,例如 2–4 周。时间段过短的统计信息可能缺乏代表性,而时间段过长则会被过度平均,无法反映任何峰值和可能的异常。
最后还要指出,其他一些视图(例如 pg_stat_wal 或 pg_stat_replication_slots)也包含输入/输出统计信息。它们与用户数据相关的输入/输出关系较小,但可以作为数据库管理系统实例级输入/输出的信息来源。这些视图以及其他视图将在后面介绍 WAL 日志和复制的章节中讨论。
总结
pg_buffercache视图可以从不同角度评估缓冲区缓存的使用情况。可以使用
pg_shmem_allocations视图分析共享内存的结构。可以使用
pg_backend_memory_contexts视图和pg_log_backend_memory_contexts函数分析后端进程内存的结构。可以使用
pg_stat_slru视图评估 SLRU 缓存的使用情况。可以使用
pg_stat_database评估总体输入/输出。可以在相应的
pg_statio_*视图中详细评估具体数据库对象的输入/输出。
可以使用
pg_stat_statements视图评估查询执行期间的输入/输出。可以使用
pg_stat_database粗略评估临时文件。可以使用
pg_stat_statements评估查询执行期间与临时文件相关的输入/输出。可以通过数据库管理系统的服务器日志跟踪临时文件。
跟踪活动临时文件很重要。
后台写入进程和检查点进程都会产生输入/输出,后者可能对整体性能产生显著影响。
应使用
pg_stat_bgwriter视图评估后台写入和检查点进程产生的输入/输出。
postgrespro.ru/docs/postgresql/current/view-pg-shmem-allocations ↩︎
postgrespro.ru/docs/postgresql/current/storage-file-layout ↩︎
github.com/lesovsky/postgresql-monitoring-book/blob/main/playground/scripts/active_temp_files.sql ↩︎
postgrespro.ru/docs/postgresql/current/runtime-config-resource#RUNTIME-CONFIG-RESOURCE-BACKGROUND-WRITER ↩︎
postgrespro.ru/docs/postgresql/current/runtime-config-resource#RUNTIME-CONFIG-RESOURCE-BACKGROUND-WRITER ↩︎
6 预写式日志
本章将讨论:
什么是预写式日志;
PostgreSQL 中预写式日志的结构;
如何跟踪与日志相关的活动;
pg_stat_wal视图;使用查询跟踪日志写入;
归档日志段;
pg_stat_archiver视图;如何跟踪日志归档问题;
跟踪日志归档队列。
本章将介绍预写式日志,也称为预写日志(Write-Ahead Log,WAL),它以某种形式存在于大多数数据库管理系统中。概括地说,预写式日志记录了数据库管理系统中发生的所有数据变更历史。发生故障时,可以利用这段历史重放故障前的全部变更序列,恢复数据库管理系统最新且一致的状态。本章先简要介绍日志的结构(下文在本章中提到“日志”时,均指 WAL,而不是数据库管理系统的服务器日志),再详细介绍跟踪与日志相关事件的工具和方法。
6.1. Write-Ahead Log — 预写式日志
为了保证可靠性,数据库管理系统中的所有数据变更都必须写入可靠的存储(通常是磁盘)。即使系统发生故障,也不能允许数据出现错误、损坏,更不能丢失数据。为了满足这些要求,几乎所有数据库管理系统都使用预写式日志。在 PostgreSQL 中,日志记录数据变更历史;发生故障时,数据库管理系统利用日志重放这些变更,恢复到故障前最后一个一致状态。
一个数据库实例由许多后端进程和后台进程组成,它们处理位于共享内存中的数据,其中包括存储用户数据的缓冲区 缓存和系统数据结构。应用程序发送查询,数据库管理系统执行这些查询。对于读取查询,数据库管理系统访问数据并返回所需的行集;对于修改数据(或模式)的查询,数据库管理系统执行相应的变更。所有变更都发生在共享内存中,随后后台写入进程或检查点进程以延迟方式将缓存中的变更同步到主存储。数据库管理系统的共享内存属于易失性存储,其内容无法抵御断电等系统故障。此外,还存在一类软件错误,会损坏共享内存区域,需要将其完全清理并重新创建——通常是段错误(segmentation fault)。操作系统异常终止数据库管理系统进程也会造成类似后果。这类故障通常突然发生,无法提前做好准备,也无法预知它会在什么时候发生。因此,数据库管理系统需要一种工具,用来恢复那些已经在共享内存中发生、但因故障未能写入主存储的数据变更。
然而,数据库管理系统可能长期运行,不可能保存全部变更历史(否则就需要投入大量甚至不合理的经济成本)。为了重复使用日志文件并将日志控制在合理大小,系统会使用检查点:检查点之前的所有变更都已可靠写入主数据存储,后者被视为可靠存储。检查点成功完成的标记也会写入日志,之后可以删除检查点之前的一部分日志。发生故障时,只需重放检查点之后写入日志的变更,将系统恢复到故障发生前的状态。
实际上,日志是一组位于主数据目录 pg_wal 子目录中的文件(日志段):
所有日志段的名称都是不带扩展名的 24 个十六进制数字。名称由三个八位组组成(以日志段 000000010000004B000000CD 为例):
0000004B——日志段高位范围标识符,取值范围为00000000至FFFFFFFF。000000CD——日志段低位范围标识符,取值从00000000开始;最后一个编号取决于初始化主数据目录时指定的日志段大小。
每个日志段的大小固定(参见 wal_segment_size),默认为 16 MB。每个日志段内部又划分为 8 KB 的块(参见 wal_block_size)。初始化集簇时可以通过参数 --wal-segsize 修改日志段大小。每个块都包含采用不可打印的二进制格式的 WAL 记录(records),用于描述单独的数据变更。每条记录都包含在系统发生故障时重放(重新应用)某个具体变更所需的足够信息。记录可以有不同类型,并对应各种对象的变更。可以使用 pg\_waldump 工具3或 pg_walinspect 扩展4分析日志内容。这两个工具提供相同的功能,但前者只能在终端环境中使用,而扩展提供了 SQL 接口,能够更灵活地分析结果:
每条记录都有唯一的 LSN(日志序列号,log sequence number)。可以把这个标识符当作 WAL 中的位置,据此确定记录在日志中的位置。以记录 4B/DF0026B0 为例:
4B——高位范围标识符(日志段文件名的第二个八位组);DF——低位范围标识符(日志段文件名的第三个八位组);0026B0——在日志段文件中的偏移量。
可以使用 pg_walfile_name 函数并向其传入 LSN,确定某条记录所在的日志段:
在数据库管理系统运行期间,数据不断发生变更,新的记录会写入日志,当前的位置(用 LSN 表示)也会不断向前移动。记录插入后,还需要将新增记录可靠地写入主存储。可以使用几个函数获取日志记录的当前位置:
pg_current_wal_insert_lsn——最后插入日志的记录所在的位置;pg_current_wal_lsn——最后写入磁盘的记录所在的位置;pg_current_wal_flush_lsn——最后写入并与磁盘同步的记录所在的位置。
日志段填满后,写入会从下一个顺序排列的日志段开始。
WAL 的大小受配置参数限制,正常运行时日志段数量会在某个范围内波动。在负载高峰期,尤其是涉及数据变更的高峰期,可能会创建额外的日志段,从而使日志大小增加。当负载恢复正常并完成检查点后,日志大小会重新调整——多余的日志段要么被删除,要么被重命名,以便将来复用;因此,日志大小会缩小到数据库管理系统配置指定的范围。下面的列表中可以根据时间戳看出,当前正在向日志段 000000010000004B000000FC 写入,而编号更大但时间更早的日志段已预留给近期使用——当前日志段填满后,数据库管理系统就会切换到下一个日志段。
日志既可以由后端进程写入,也可以由后台进程 walwriter 写入。默认情况下,所有变更都由后端进程写入日志。这可能发生在使用 COMMIT 命令提交事务时,或者 WAL 缓冲区填满时(参见 wal_buffers)。这种写入称为同步写入:在发送下一条命令或查询之前,客户端必须等待日志写入完成。数据库管理系统的设置允许改变这一行为,使用异步事务提交(参见 synchronous_commit)。在这种模式下,日志写入交给后台运行的 walwriter 进程。将日志写入任务交给后台进程后,后端进程无需等待写入完成,就可以立即向服务器发送下一条命令。不过需要注意,在这种模式下,如果发生故障,仍可能丢失尚未由 walwriter 进程写入的最后几个事务。事务提交设置在复制场景下还提供其他几种模式。详细说明请参见文档5。关于 WAL 的工作方式,还可以参阅完整资料6 7。
6.2. 跟踪日志活动
预写式日志是数据库管理系统的重要组成部分,管理员需要了解与它相关的活动。日志写入会影响事务持续时间,因此为了保证数据库管理系统的良好性能,日志写入应当快速完成且不产生延迟。还可能有其他问题:日志写入量是多少?写入需要多长时间?不同类型的查询分别产生了多少日志写入量?
可以使用多个工具跟踪与日志相关的活动:
pg_waldump 和
pg_walinspect——用于详细分析日志的工具,更适合调试、查找问题或教学;pg_stat_wal——与日志相关活动的总体统计信息;pg_stat_statements——这个成熟的扩展还提供按查询类型划分的日志相关统计信息;EXPLAIN ANALYZE——用于输出查询计划的工具,指定WAL参数后可以显示有关日志写入的附加信息。
从定期监控的角度看,pg_stat_wal 和 pg_stat_statements 视图尤其值得关注,下面将对它们作更详细的介绍。
pg_stat_wal 视图
pg_stat_wal 视图只包含一行:
统计信息是累积的,包含以下内容:
wal_records——写入日志的记录总数;wal_fpi——写入的 FPI 页面总数(full page image,整页镜像);wal_bytes——写入日志的数据总量,单位为字节;wal_buffers_full——因 WAL 缓冲区填满而将数据写入日志的次数;wal_write——将数据从 WAL 缓冲区写入时执行的输入/输出操作次数;wal_sync——将 WAL 段与主存储同步的请求次数;wal_write_time——将 WAL 缓冲区内容写入主存储所耗费的时间,单位为毫秒。如果参数 wal_sync_method 设置为open_datasync或open_sync,其中可能包括同步所耗费的时间;wal_sync_time——将日志段同步到主存储所耗费的时间,单位为毫秒;stats_reset——重置统计信息的时间戳。
只有启用 track_wal_io_timing 参数后,才会跟踪时间统计信息。根据该视图的数据,可以跟踪与日志相关的活动、写入量和写入时长,以及表明 WAL 缓冲区空间不足的情况;后者可能促使我们重新考虑 wal_buffers 参数的设置。
根据这些统计信息中的指标,可以绘制数据库实例层面的总体 WAL 活动图表。
图 6.1 展示了写入日志的普通记录和 FPI 页面的数量。可以看到,日志写入量很稳定,没有明显的峰值。同时还可以看到,FPI 页面的写入流量持续呈锯齿状。峰值持续时间在五分钟以内,这与默认的 checkpoint_timeout 值相符。强制执行检查点在视觉上不会影响 FPI 页面的写入量,在图表中也看不出来。
图 6.2 展示了以字节为单位的日志写入量,负载同样比较平稳。不过仔细观察可以发现,这张图与上一张图一样,呈现出五分钟间隔的锯齿状。可以利用这样的图表将日志写入量可视化。
图 6.3 展示了从缓冲区向日志写入数据的操作次数,以及随后进行的段同步次数。图表左侧的写入操作次数与同步次数相同。这是因为每个事务完成时都会执行写入及随后的同步。旁边还显示了已提交事务的数量(蓝色的 commits 线),它与其他指标几乎重合。图表右侧,在事务流量不变的情况下,段同步次数大幅减少,经过一段时间后又恢复到原来的水平。写入操作次数也有所减少,但幅度没有那么大。在这段时间内启用了异步事务提交模式(synchronous_commit = off)。在这种模式下,日志写入和段同步任务交给 walwriter 进程,由它根据自身设置执行这些任务。
写入和同步所耗费的时间同样很重要(图 6.4)。
在这样的图表中,重要的是跟踪峰值,并找出数据库管理系统写入日志所耗费时间异常增加的原因。
关闭同步事务提交也会影响时间。当日志由后台 walwriter 进程以异步方式写入时,随着同步次数减少,段同步所耗费的时间也会减少。关闭同步事务提交常被用作一种性能优化手段:把事务提交确认的职责从后端进程转移给后台进程。节省下来的时间可以用于执行更多查询,从而提高数据库管理系统的总体吞吐量。
pg_stat_statements 视图
如果说 pg_stat_wal 视图包含数据库管理系统层面的总体统计信息,那么在 pg_stat_statements 视图中,可以找到按查询类型划分的类似统计信息:
wal_records——写入日志的记录总数;wal_fpi——写入日志的 FPI 页面总数;wal_bytes——写入日志的数据总量,单位为字节。
上述字段包含每一种具体查询类型的写入统计信息。利用这些信息,可以分析 WAL 的组成,并回答这样的问题:哪些查询写入日志的量最大?
结果表明,产生最大日志写入量的是更新 pgbench_accounts 表中行的查询(678 GB),远远超过排名第二的查询。可以使用下面的查询从监控中获取数据:
图 6.5 证实了对 pg_stat_statements 的查询结果:从变化趋势可以看出,更新 pgbench_accounts 表的查询平均每秒写入约 500 KB,在写入量上明显超过其他查询。
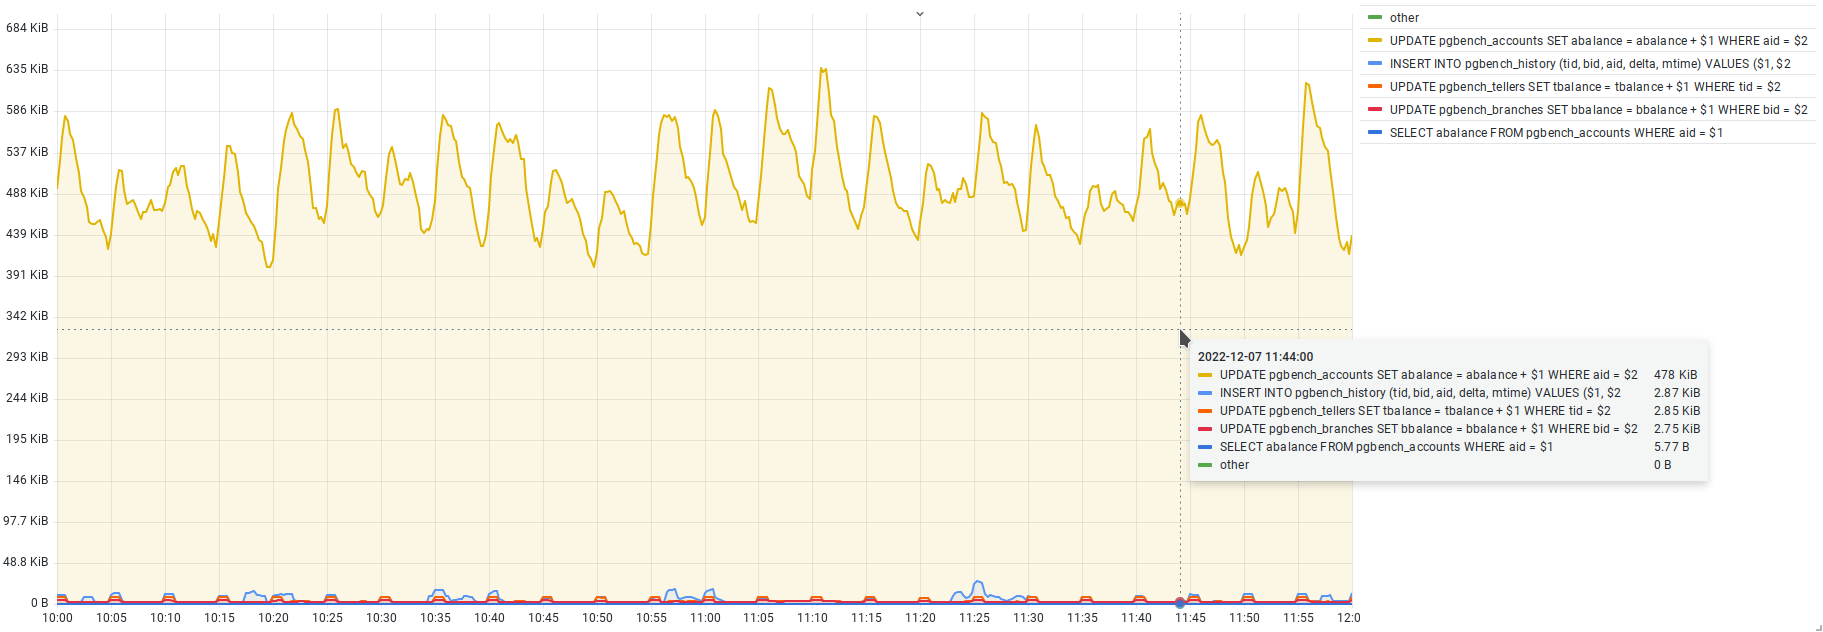
6.3. WAL 归档
数据库管理系统在维护日志的同时,会持续保存数据变更历史,以防范潜在的系统故障。还记得吗,发生故障后,数据库管理系统可以通过重放变更,自动恢复数据的一致状态。日志还为数据库管理系统提供了备份的可能。将数据库管理系统的文件与日志段一起备份后,日后可以从创建的备份中恢复数据库管理系统在任意时间点的状态——先恢复文件,再根据日志重放变更。这种方法会带来一些复杂性,但总体上有许多优点。
采用这种方法,需要持续将日志段归档到独立于数据库管理系统的存储中8。默认情况下,日志段归档处于关闭状态,需要单独配置。启用归档后,数据库管理系统会启动 archiver 后台进程。当一个日志段写入完成、可以归档时,archiver 会执行参数 archive_command 中指定的命令,并等待命令结束。如果命令执行失败,进程会在一段时间后再次尝试归档该日志段,并持续重试,直到命令成功为止。显然,这可能导致归档故障,使日志段数量不断增加,最终耗尽磁盘空间,并使数据库管理系统在尝试写入日志时异常停止。面对这样的风险,管理员又多了一项职责:监视归档工作、跟踪潜在错误并加以解决。
pg_stat_archiver 视图
可以使用 pg_stat_archiver 视图跟踪归档进程;该视图只有一行,包含以下字段:
archived_count——成功归档的日志段总数;last_archived_wal——最近成功归档的日志段名称;last_archived_time——最近一次成功归档日志段的时间戳;failed_count——归档失败的尝试次数;last_failed_wal——最近一次归档失败时对应的日志段名称;last_failed_time——最近一次归档失败的时间戳;stats_reset——重置统计信息的时间戳。
测试环境配置了伪归档:需要将日志段发送到归档时,会调用 /bin/true 命令;该命令什么也不做,只返回成功退出码。不过,这仍然可以让我们看到归档统计信息:
要想正确使用这些统计信息,必须了解日志归档过程中可能出现的问题类型:
归档端数据传输错误或服务拒绝——此时归档进程无法将日志段传输到存储中;
执行归档命令时出错,例如脚本出错或脚本不存在;
负责将日志段实际发送到归档存储的进程因某些未知原因挂起;
archiver 进程挂起——这种情况不太可能发生,但也不能完全排除。
对于前两种情况,需要跟踪归档失败的尝试次数。如果归档已经中断,还需要了解它处于这种状态的时间。failed_count 和 last_archived_time 字段很适合进行评估。发生错误时,failed_count 计数器会开始增加(而 archived_count 会停止增长)。失败次数增加比没有归档尝试更能说明问题,因为系统可能没有负载、处于空闲状态,此时没有成功的归档尝试也可能是正常的。时间指标也是如此:now() - last_archived_time 的值会一直增加,直到归档恢复,因此也是判断归档是否存在问题的良好指标。
图 6.6 展示了归档成功和失败尝试的次数。失败尝试形成的条带表明,归档在 10 分钟内未正常运行,而日志段仍在不断累积。问题解决后,可以看到积累的日志段被成功归档,形成了一个小峰值。
挂起这类问题更复杂:在这种情况下,命令已经启动,但无法结束,归档进程在等待命令完成。此时 archived_count、failed_count 和 last_failed_time 都不会改变,但 now() - last_archived_time 的值会开始增加,表明归档已经停止。图 6.7 展示了与图 6.6 相同的归档停止情况。日志段通常每 54 秒归档一次,但有一段时间间隔增加到了 11 分钟。
根据上次成功发送距今的时间进行判断,适用于日志写入量大且持续稳定、日志段定期归档的活跃系统。对于活动量较小、日志写入零星且数量不多的系统,两次日志段归档之间可能间隔很长,此时 now() - last_archived_time 的值很大,却不一定表示存在问题。当然,也可以使用超时设置强制归档(参见 archive_timeout):超时后会切换到下一个日志段,并将前一个日志段发送到归档。
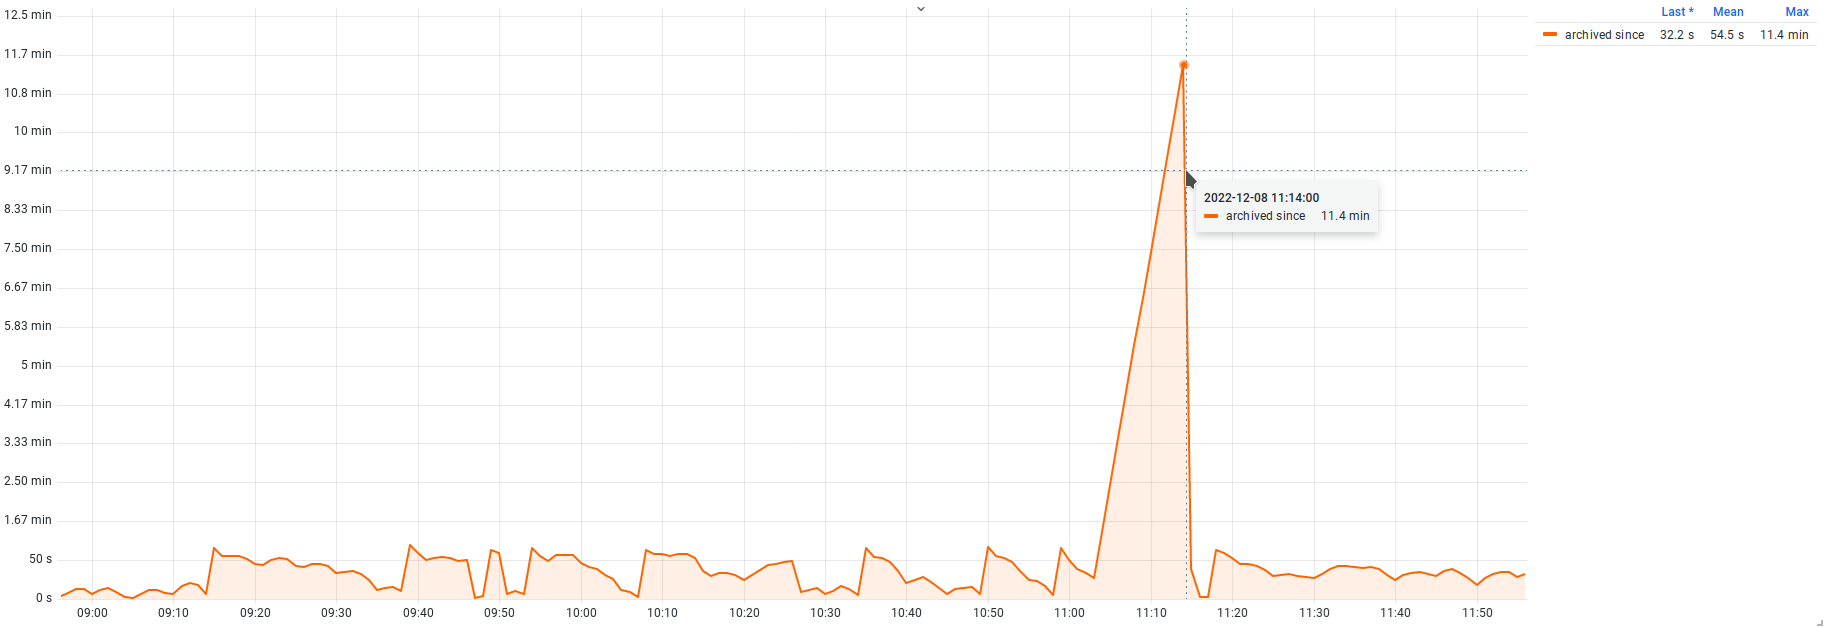
归档队列
前面介绍的归档状态评估方法都依赖最终结果:日志段是否已成功归档。还可以采用另一种方法跟踪归档是否正常工作。这种方法关注待完成的工作量,跟踪等待发送的队列中有多少日志段。如果队列为空,说明一切正常;如果队列不断增长,说明存在问题。要实现这种方法,需要了解主数据目录的文件层次结构。
pg_wal 目录中有一个 archive_status 子目录,其中包含描述具体日志段归档状态的一组文件。
在这个目录中,我们关注扩展名为 ready 和 done 的文件。ready 状态表示相应日志段已准备好归档,done 状态表示日志段已成功归档。因此,要得到等待发送队列中的日志段数量,只需统计扩展名为 ready 的文件数量即可。还可以将队列大小换算为字节(乘以日志段大小,默认为 16 MB),从而了解待归档日志段占用了多少磁盘空间。可以使用 pg_ls_archive_statusdir 函数,或者使用更通用的 pg_ls_dir 函数进行统计:
测试环境使用 /bin/true 命令进行伪归档;调用该命令时不会真正复制文件,但这种归档仍会反映在 pg_stat_archiver 统计信息中。为了进行实验,可以把 /bin/true 换成 /bin/false,从而使归档“失效”。
开始实验前,可以先查询统计信息,记录归档正常工作时的状态:
现在修改 archive_command 参数:
观察此时统计信息的变化:
archived_count 计数器停止增长,而 failed_count 开始增加;新增字段 last_archived_age 表示的上次成功归档距今的时间也在增长,已经达到四分钟。检查状态目录中的情况:
出现了扩展名为 ready 的文件。可以统计这些文件,从而确定归档队列中的日志段数量:
可以将相应的测量结果绘制成图表(图 6.8):
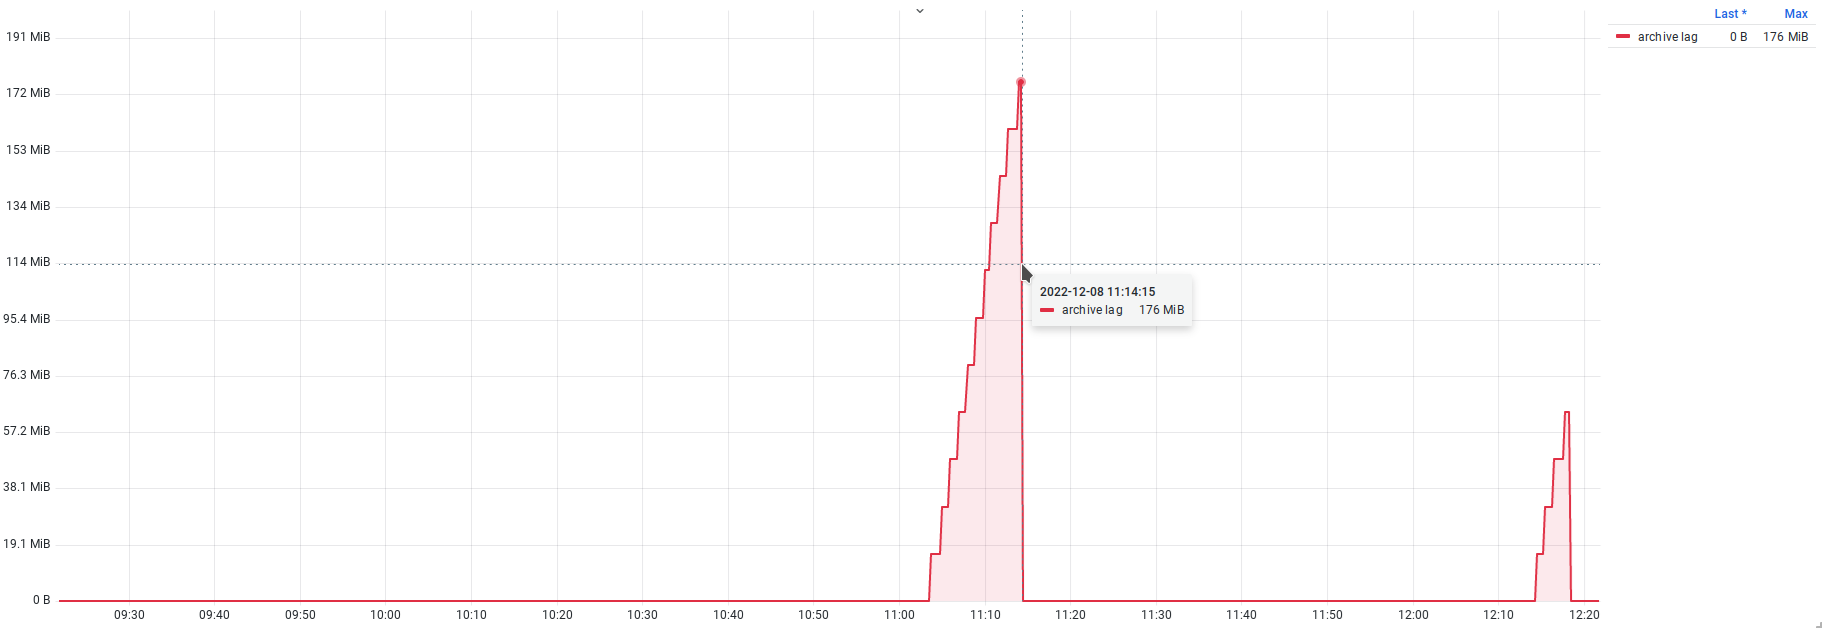
按队列大小监控的方法具有通用性,不受日志活动和写入量影响,既可以跟踪归档错误,也可以发现归档挂起的情况。
实验结束后,不要忘记恢复配置:
总结
预写式日志是任何数据库管理系统的重要组成部分,保存了所有变更的历史。
日志由一系列连续的日志段文件组成。
可以使用 pg_waldump 工具和
pg_walinspect扩展详细分析日志内容。可以使用
pg_stat_wal视图跟踪与日志相关的总体活动。pg_stat_statements包含针对具体查询的日志写入统计信息。日志还用于备份和复制。
可以为备份和恢复任务归档日志。
可以使用
pg_stat_archiver视图跟踪归档。跟踪归档队列是发现问题最通用的方法。
7 复制
本章将讨论:
复制及其工作方式;
复制跟踪工具;
pg_stat_replication和pg_stat_wal_receiver视图;复制滞后;
复制槽;
pg_replication_slots视图;发布与订阅;
pg_stat_replication_slots视图;pg_stat_subscription和pg_stat_subscription_stats视图;恢复冲突和
pg_stat_database_conflicts视图。
上一章介绍了预写式日志,这是数据库管理系统中保证数据持久性的关键组件之一。此外,复制建立在使用 WAL 日志的基础上。借助复制,可以构建复杂的分布式配置,用于提供冗余、容错与灾难恢复能力,并分摊负载。使用复制和集群配置会增加管理复杂度,需要认真负责的态度以及配置和运维技能。本章简要介绍 PostgreSQL 中复制的工作方式及其使用方式,并更详细地介绍数据库管理系统提供的、用于跟踪集群和复制机制运行情况的工具。
7.1. 复制概览
复制是两个或更多节点之间同步数据的过程。通常区分物理复制和逻辑复制。物理复制传输数据块的物理变更,不分析所传输变更的内容。逻辑复制更复杂,包括分析、过滤和选择性传输变更。在最小配置中,复制涉及两个节点:一个作为主库(primary),作为变更来源;另一个作为副本,接收来自主库的变更并在自身重放。根据复制类型,术语可能不同:例如在物理复制中,副本通常称为备库或备用节点(standby)。更复杂的复制方案可包含多个主库,复制类型也可组合,每个节点都可将变更复制到其他节点。复制主要用于在多个节点间分摊负载和提供容错能力:主库发生故障时,可以将副本切换为主库模式,以最小化整体系统停机时间(downtime)继续处理工作负载。物理复制因通用且适用于两种场景而广泛采用。逻辑复制则用于选择性传输数据集,例如分片(sharding)。本章主要讨论物理复制,较少涉及逻辑复制。
PostgreSQL 中的两种复制工作方式相近。首先将数据从主库初始同步到副本。随后副本连接到主库,主库中写入 WAL 日志的所有变更都通过复制协议传输到副本。副本也可以继续向其他节点传输变更,从而构建级联配置。
默认情况下,复制是异步过程:主库上的变更无论是否有副本都会提交。可以将复制切换到同步模式(参见 synchronous_commit),此时主库上的事务只有在备库确认收到后才提交。根据参数 synchronous_commit 的值,确认消息可以在收到的日志记录写入磁盘后(remote_write)、与磁盘同步后(on,默认值)或接收的变更重放后(remote_apply)发送。同步模式可以在发生故障时将已提交事务的丢失量降为零。不过,使用同步复制,尤其是 remote_apply 模式,可能会显著影响性能;此外,副本发生故障还可能导致主库无法提供服务:所有事务提交操作都要等待日志记录传送到副本。因此,是否使用同步复制必须经过审慎、充分的论证。无论如何,写入主库日志的所有变更都会以一定的滞后(replication lag)出现在副本上;滞后程度取决于节点性能、网络环境和当前工作负载等因素。
复制过程由副本发起。walreceiver 进程检查本地 WAL 日志的状态,并向主库发送传输日志记录的请求。如果主库拥有所请求的记录,就会在主库上启动后台 walsender 进程,负责后续的日志流式传输。walsender 和 walreceiver 两个进程之间保持持久连接;日志中一出现新数据(包括尚未提交事务的数据),walsender 就会将其传给 walreceiver。walreceiver 进程等待数据传输。收到日志记录后,它把记录保存到主数据目录的本地 pg_wal 目录中;随后,另一个后台进程 startup 在本地数据副本上重放(replay)所传输的变更。变更一经应用,更新后的数据就对在副本上执行的查询可见。这种复制机制已经证明简单而可靠。
两种复制都基于 WAL 记录的传输实现,包括物理复制和逻辑复制。由于 WAL 日志记录的是单个物理块层面的变更,物理复制实际上就是传输物理块的变更。这些变更描述了数据块从一种物理状态原子地转变为另一种物理状态,但不说明究竟修改了哪些用户数据(表、行或单个字段)。因此,walsender 和 walreceiver 进程负责在节点之间连续、按顺序传输变更流,而 startup 进程则不跳过任何变更,严格按照日志记录的顺序应用全部变更。要评估物理复制的运行情况,只需跟踪 walsender 和 walreceiver 进程的状态,以及主库向副本传输的数据量。
逻辑复制更复杂,可以选择性地复制变更。在 PostgreSQL 中,这项功能通过发布1和订阅2机制实现。在逻辑复制中,主库和备库的概念不再适用,因为逻辑复制节点可以同时承担两种角色;表示变更来源和接收方时,使用发布服务器和订阅服务器这两个术语。发布服务器对日志流进行解码,识别发生变更的对象。解码后,就可以过滤记录流,并复制单个对象的变更(全部操作或指定的一组操作)。选定的变更会传给订阅端服务器,后者在本地保存这些变更,然后按照事务在发布服务器端提交的顺序应用事务,而不是像物理复制那样按照 WAL 记录的顺序应用。
物理复制可以使用所谓的复制槽,而逻辑复制必须使用复制槽。复制槽可以保留所需数量的 WAL 段,避免它们在执行检查点时被回收。复制槽是复制机制的重要组成部分,需要管理员关注和控制:监控逻辑复制时,不仅要跟踪变更传输,还要跟踪复制槽的状态。
复制集群运行过程中可能出现各种问题,影响集群的可用性以及各节点的性能:
节点故障或不可用,导致无法传输日志;
数据库管理系统节点或传输环境性能不足,导致日志传输延迟;
副本上的日志重放性能不足,从而落后于主库;
日志重放时发生冲突,导致滞后或查询执行出错;
日志段累积导致磁盘空间不足,数据库管理系统异常终止。
从上面的列表可以看出,潜在问题很多。其中一些问题会造成性能下降,甚至完全无法提供服务,而且恢复时间无法预测。因此,管理员有责任跟踪集群状态和各节点的可用性,并预防可能破坏正常运行的问题。下面将介绍数据库管理系统提供的、用于跟踪复制和发现相关问题的工具。
7.2. 复制跟踪工具
复制跟踪有多种工具,根据所使用的复制方式,可能只需要其中一部分:
pg_stat_replication——跟踪 walsender 进程以及向副本传输日志的过程;pg_stat_wal_receiver——跟踪 walreceiver 进程以及接收日志的过程;pg_replication_slots——跟踪物理和逻辑复制槽;pg_stat_replication_slots——逻辑复制槽的使用统计;pg_stat_subscription——订阅端的工作统计;pg_stat_subscription_stats——订阅端工作错误的统计;pg_stat_database_conflicts——恢复冲突的统计,并按发生原因分类。
下面将介绍这些工具及其可能的使用场景。
pg_stat_replication 视图
主库是所有变更的来源,可以向多个节点复制数据。发送变更的速度与副本应用变更的速度可能不同,这会体现为复制滞后以及数据新鲜程度的差异。可以使用 pg_stat_replication 视图确定复制滞后和日志传输的其他特征。视图的每一行都包含一个 walsender 进程的工作统计。pg_stat_replication 视图显示当前数据的方式与 pg_stat_activity 视图类似:
测试环境配置了一个带单个备库的复制集群,因此该视图中只有一行。字段如下:
pid——操作系统中的 walsender 进程标识符;usesysid、usename——数据库管理系统用户的标识符和名称,备库一侧使用该用户建立连接;application_name——连接主库时可以指定的附加应用标识符;client_addr、client_hostname、client_port——备库一侧的网络信息:地址、节点名称和端口号;backend_start——连接建立和 walsender 进程创建的时间戳;
backend_xmin——副本通过反馈传给主库的事务界限(参见 hot_standby_feedback);state——walsender 进程的当前状态,也决定复制的总体状态:
— startup ——walsender 正在启动;
— catchup ——副本正在尝试“追上”主库;
— streaming ——这是主要工作模式:副本成功“追上”主库后,walsender 向副本传输变更流;
— backup ——walsender 正在传输备份;
— stopping ——walsender 正在关闭。
根据下面这些显示日志发送和接收状态的字段,可以确定具体副本的滞后量,以及它要完全消除滞后还需要完成多少工作:
sent_lsn——日志位置;截至该位置的记录已经发送到副本;write_lsn——日志位置;截至该位置的记录已经接收,但尚未由 walreceiver 同步;flush_lsn——日志位置;截至该位置的记录已经由 walreceiver 同步;replay_lsn——日志位置;截至该位置的记录已经由 startup 重放。
前面提到过,变更可能会延迟出现在副本上。复制滞后在理想情况下应接近于零,但并不总能做到。滞后也可以理解为还需要完成的工作量。不过,主库并不会停下来,其日志中会不断写入新的变更。新增变更量可能变化,因此副本的滞后也不会保持不变。滞后增加可能表现为在主库和副本上执行查询得到的结果不一致,设计从副本读取数据的应用时应考虑这一点。
要“追上”主库,副本需要:a)从主库接收全部变更;b)将其写入本地存储;c)完成同步;d)在本地数据副本上重放。利用上述日志位置字段,可以计算位置之间的字节距离,从而判断最大的滞后出现在处理链路的哪个环节。这里需要用到已经介绍过的 pg_current_wal_lsn 函数,以及由 pg_lsn 数据类型支持的减法运算符:
pg_current_wal_lsn - sent_lsn——待发送数据量,包括主库上已经积累、但尚未传给副本的全部日志记录;
sent_lsn - write_lsn——已从主库发送、但尚未在副本一侧写入的数据量;write_lsn - flush_lsn——已经写入、但尚未在副本上同步的数据量;flush_lsn - replay_lsn——等待 startup 进程重放的数据量。
计算出的数据量以字节表示,可以直观地反映副本滞后的规模。实际中,滞后经常出现在日志发送或重放阶段。这通常是因为大量数据变更生成了许多日志记录,walsender 或 walreceiver 进程来不及传输,或者 startup 进程性能不足,无法及时重放全部日志。
下面一组字段可以直接跟踪以秒为单位的滞后时间,显示副本“追上”主库大约需要多长时间:
write_lag——从本地同步日志到收到通知之间经过的时间;通知表明变更已经写入副本,但尚未同步;flush_lag——从本地同步日志到收到通知之间经过的时间;通知表明变更已经写入副本并完成同步;replay_lag——从本地同步日志到收到通知之间经过的时间;通知表明变更已经写入、同步并应用;reply_time——收到副本最后一条状态消息的时间戳;该消息包含日志处理数据。
这些字段可以帮助评估同步复制中确认事务时产生的延迟,此时参数 synchronous_commit 设置为 remote_write、on 或 remote_apply 之一。
还剩两个字段:sync_priority 和 sync_state。在异步复制中,sync_state 始终为 async。在同步复制中,各节点可能处于不同状态,在集群中承担不同角色。值为 sync 表示副本当前作为同步副本运行。如果使用基于优先级的同步复制,值为 potential 表示副本当前以异步模式运行,但具备切换到同步模式的候选资格(此时 sync_priority 显示该节点的优先级)。如果使用基于仲裁的同步复制,值为 quorum 表示该副本属于确认收到变更所需的最少节点集合。有关同步复制配置的更多信息,参见文档3。
从排查和解决问题的角度看,地址、日志处理位置和滞后字段尤其有用。它们可以准确识别副本(特别是副本不止一个时),并确定日志处理的哪个阶段出现延迟。日志位置字段可以直接转换为滞后量:
该视图可以按字节和秒评估滞后量,显示副本需要处理多少数据才能“追上”主库,以及需要多长时间。查询输出表明副本滞后很小,只有几微秒;按字节计算,滞后量仅约 17 KB。此时数据已经传输并写入副本,只需完成同步和重放。
可以根据滞后量收集指标并绘制图表,显示副本随时间变化的滞后情况(图 7.1 和 7.2)。
注意两张图表的图例。按字节表示的滞后更详细,其中包含尚未发送到副本的日志量。另一个有趣的现象是,在选定时刻,两张图表显示的滞后峰值不同。例如,大部分字节滞后出现在变更写入阶段,而按秒计算的滞后已经出现在同步和重放阶段。数值较小时尤其容易看到这一点。两张图表的整体情况表明,滞后经常出现在同步和重放阶段。这说明副本处理其负责的那部分工作稍慢。
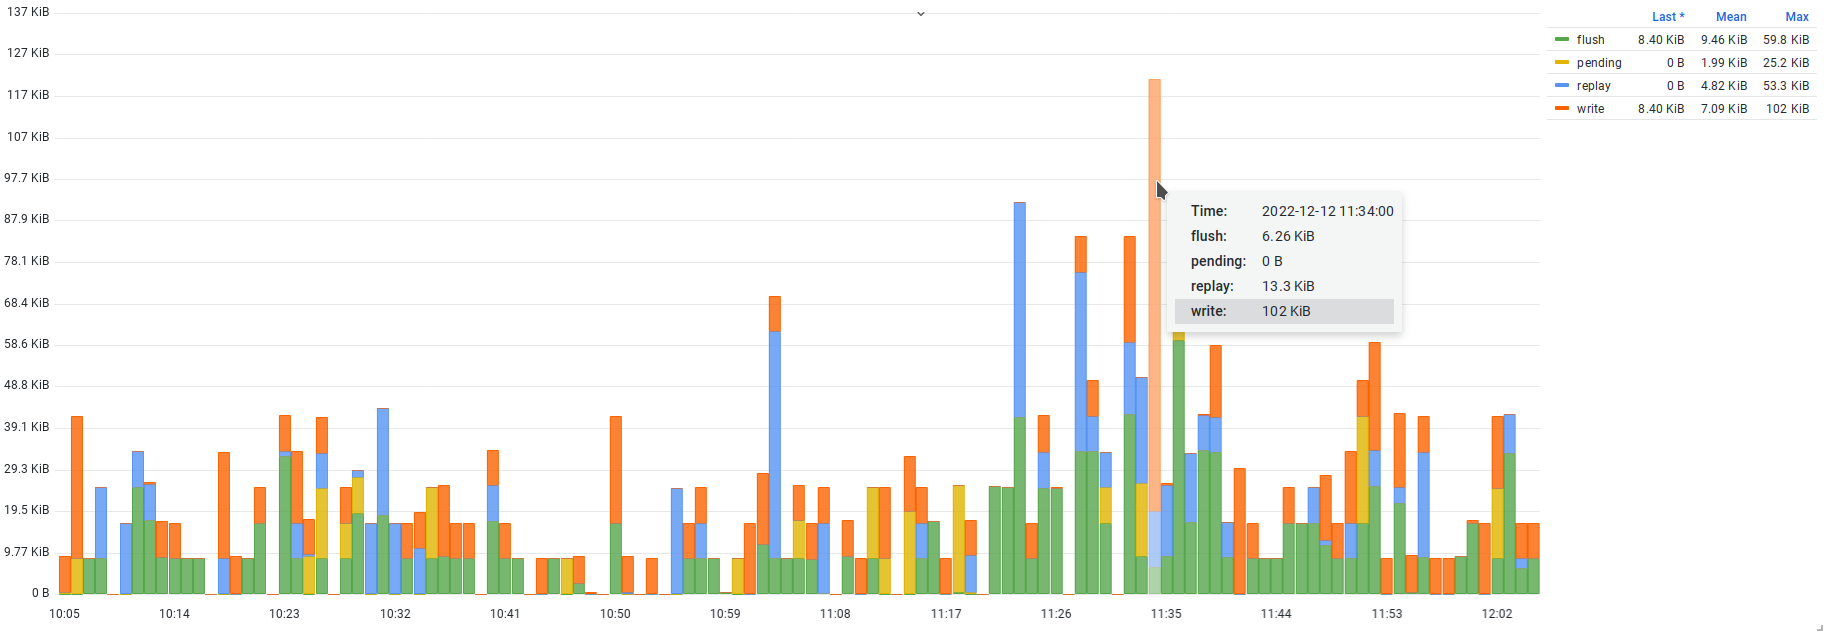
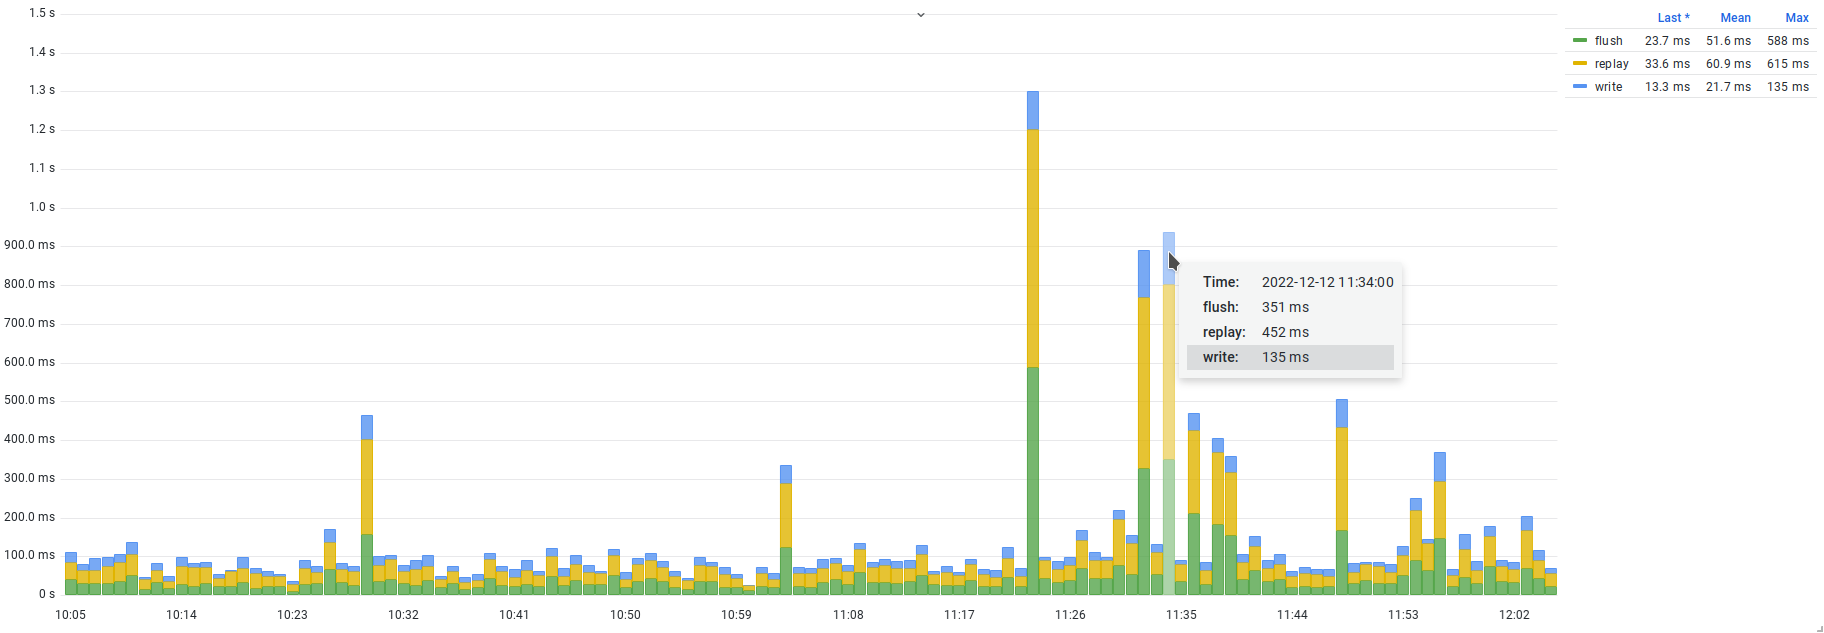
pg_stat_wal_receiver 视图
下一种复制跟踪方式是在备库上使用 pg_stat_wal_receiver 视图。该视图从 walreceiver 进程的角度反映复制状态,并包含以下信息:
pid——操作系统中的 walreceiver 进程标识符;status——walreceiver 进程的状态;receive_start_lsn——walreceiver 进程启动时的日志位置;receive_start_tli——walreceiver 进程启动时的日志时间线;
written_lsn——对应于最近写入但尚未同步的数据的日志位置;flushed_lsn——对应于最近写入并同步的数据的日志位置。walreceiver 进程启动时使用该位置作为起点;received_tli——对应于最近写入并同步数据的时间线编号。启动 walreceiver 进程时使用该时间线作为起始时间线;last_msg_send_time——从主库收到的最后一条消息的发送时间;last_msg_receipt_time——从主库收到的最后一条消息的到达时间;latest_end_lsn——副本在最后一条消息中发给主库的日志位置;latest_end_time——副本在最后一条消息中发给主库的最后日志位置对应的时间;slot_name——当前复制会话使用的槽名称;sender_host——建立连接的主库名称;sender_port——建立连接的主库网络端口号;conninfo——walreceiver 进程使用的、连接到主库的连接字符串。
该视图不包含日志重放信息,因为重放由 startup 进程负责。walreceiver 进程只负责接收和写入日志。从监控角度看,该视图几乎没有使用价值,因为通过主库上的 pg_stat_replication 就能获取全部这些数据。
除了 pg_stat_wal_receiver,还有几个函数可以提供日志的补充信息:
pg_last_wal_receive_lsn——从主库收到的最后日志位置;pg_last_wal_replay_lsn——最后一个日志位置;截至该位置的记录已经由 startup 进程重放;pg_is_in_recovery——数据库管理系统是否处于恢复模式(这是副本的工作模式,因为副本一直在根据日志进行恢复)。
pg_is_in_recovery 函数可用于判断节点是主库还是备库。pg_last_wal_receive_lsn 和 pg_last_wal_replay_lsn 适合用于确定副本上仍需重放的日志量,但不能用来计算复制滞后,因为它们没有考虑主库上尚未传给副本的日志量。如果主库发生故障并完全不可用(硬件故障、网络不可用或灾难),可以使用这两个函数来确定哪个节点最适合成为主库:比较各节点的日志位置,选择已经接收更多日志记录,或已经重放其中更大部分的节点。
复制槽与 pg_replication_slots
复制正常运行时,主库向副本发送日志,副本在本地数据副本上重放变更。不过,副本可能来不及重放变更,甚至来不及接收和写入日志。例如,主库负载增加会生成大量日志,网络带宽不足,日志段开始在主库上堆积,副本滞后不断增加。又或者,主库与副本之间的网络连通性中断,日志传输被打断,复制停止。在 PostgreSQL 的早期版本中,主库不会跟踪副本需要哪些日志段:如果副本断开,服务器会继续运行,并可能在执行检查点时删除尚未传给副本的日志。如果副本重新连接并从已知位置请求日志,而主库上已不存在这些日志段,复制就无法继续。解决办法是从归档中加载所需日志段,或者重新初始化副本。这两种办法都有缺点:保存日志段归档可能消耗大量资源,而重新初始化可能需要很长时间。为了减轻这个问题,可以使用参数 wal_keep_size(原名为 wal_keep_segments),要求数据库管理系统额外保留一定量的日志,专门应对这类副本故障。另一种更现代的解决办法是使用复制槽。
复制槽保证在特定复制会话中保留日志段,直到这些日志段传输到副本为止。不过,如果副本长时间断开,同时新日志段大量增长,就有可能耗尽全部可用空间,导致数据库管理系统异常终止。作为保护措施,增加了参数 max_slot_wal_keep_size,用于指定上限;达到上限后,数据库管理系统会开始删除日志段。它类似于改进版的 wal_keep_size。无论选择哪种设置,仍然存在两种风险:副本完全且不可逆地滞后(只能借助 WAL 归档恢复),或者数据库管理系统因空间耗尽而异常终止。
因此,使用复制槽会给管理员增加跟踪其状态和使用情况的任务。为此,可以使用 pg_replication_slots 视图,它包含全部复制槽的信息,每个复制槽一行:
通常,该视图已经足以评估复制槽状态并确定是否存在问题:
slot_name、slot_type、plugin——用于标识复制槽的字段:槽名称、类型以及用于解码 WAL 记录流的插件(仅逻辑槽有插件);datoid、database——与复制槽关联的数据库标识符和名称(仅逻辑槽有值);temporary——表示复制槽是否为临时槽的标志。临时槽的状态不会保存到磁盘;发生错误或会话结束时,它们会自动删除;active——表示复制槽当前是否处于活动状态并正在使用的标志。这是复制槽最重要的属性之一,可以据此判断槽的消费者是否存活;active_pid——当前使用复制槽的会话进程标识符;xmin——确定行版本可清理界限的事务标识符;catalog_xmin——系统目录对象中行版本的相应界限;restart_lsn——从该日志位置开始,槽消费者在工作过程中仍可能需要这些记录。从该位置开始的所有日志记录都不能在执行检查点时被回收,直到其总量超过 max_slot_wal_keep_size 为止;confirmed_flush_lsn——日志位置;截至该位置的记录消费者已经确认收到(仅逻辑槽有值);wal_status——该复制槽所需日志文件的状态:
— reserved ——所需日志量在 max_wal_size 限制以内;
— extended ——日志量超过 max_wal_size 限制,但日志段仍由复制槽保留,或者仍在 wal_keep_size 限制以内;
— unreserved ——复制槽不再保留所需的日志段,其中一些会在下一次检查点时删除。这说明消费者来不及读取变更,但如果读取速度提高,该状态仍可能恢复为 reserved 或 extended;
— lost ——所需日志段已经删除,该复制槽已经无法使用;
safe_wal_size——在没有消费者的情况下,再向日志写入这么多字节的变更后,复制槽就会进入lost状态。如果复制槽已经丢失,或者没有设置 max_slot_wal_keep_size,该值可能不显示(NULL);two_phase——表示复制槽是否用于解码已准备事务的标志(仅逻辑槽有值)。
监控复制槽时,以下指标很重要:
当前日志位置(
pg_current_wal_lsn函数的返回值)与confirmed_flush_lsn之间的差值。本质上,这是等待发送给订阅端的数据量,用来表示订阅端的滞后。该值越大,积累的日志越多,订阅端处理变更所需的时间也越长。事务界限的大小(根据
xmin和catalog_xmin字段确定);清理进程会在删除过时行版本时考虑该界限。槽消费者所需日志段的可用性(
wal_status);数据库管理系统会自行评估这一点。safe_wal_size的大小;它表示可写入日志的余量,耗尽该余量后可能发生日志回收并导致复制槽无法使用。
例如,在测试环境中,复制使用了复制槽,可以通过 pg_replication_slots 跟踪滞后情况(图 7.3):
可以做一个小实验:设置 max_slot_wal_keep_size 并关闭副本,观察统计信息如何变化。数据库管理系统会在一段时间内保留日志段;但日志量超过 max_slot_wal_keep_size 后,数据库管理系统会回收部分日志段,使复制槽无法继续使用。现在设置 max_slot_wal_keep_size:
接下来关闭运行副本的容器:
现在查看 pg_replication_slots 的内容:
由于备库关闭,通过复制槽传输的变更停止了,复制槽变为非活动状态(active = f)。但工作负载并没有消失,新的变更仍在继续写入 WAL 日志,因此消费者的滞后不断增加(backlog 字段)。随着滞后增加,日志量余量 safe_wal_size 开始减少;此时日志状态仍为 reserved,说明所需日志量仍在 max_wal_size 限制之内。
可以运行元命令 \watch 60,观察滞后如何随时间增加,以及 safe_wal_size 最终变为负数。
如果没有及时启动副本,复制槽就会丢失,本实验正是如此。服务器日志中可以找到一条记录,说明复制槽在执行检查点时失效:
要让副本恢复运行,必须重新初始化它(因为测试环境中没有 WAL 归档):
重新创建容器后,复制槽状态会显示它重新开始使用,和之前一样:
发布与订阅
逻辑复制使用发布与订阅模型。可以在一个节点上发布一张或多张表中的变更,在另一个节点上订阅这些变更并重放。与物理复制一样,发布与订阅机制也是基于传输预写式日志实现的。复制过程从订阅端发起:创建订阅时,会启动一个逻辑复制工作进程(logical replication worker),它按照指定地址连接发布服务器。在发布端会启动两个 walsender 进程,其中一个执行目标表的初始复制后退出,另一个保留下来负责传输 WAL 日志。如果订阅服务器有多个,则会为每个订阅服务器启动一个独立的 walsender 进程,但总数不会超过参数 max_wal_senders 指定的值。随后开始对 WAL 日志进行解码:解析日志记录,提取单个表行的变更数据,并按事务分别分组。最终向订阅端传输已提交事务的数据。解码使用一个缓冲区,其大小由参数 logical_decoding_work_mem 决定(默认 64 MB)。如果缓冲区不足,发送端可以决定将缓冲区内容溢出到磁盘,或者立即向订阅端发送部分已解码数据。这个决定取决于创建订阅端时指定的 streaming 参数。默认情况下,流式传输关闭;事务会先在发送端完成全部解码,然后才把已解码数据传给订阅端。有关逻辑复制的工作方式、配置和运行的更多信息,参见官方文档4。
测试环境没有使用逻辑复制,也没有发布或订阅,但下面仍介绍跟踪它们运行情况的工具。
pg_stat_replication_slots 视图只包含逻辑复制槽的信息,可用于评估正在执行的工作量。视图的每一行都包含一个逻辑槽的统计信息:
slot_name——复制槽的唯一标识符;spill_txns——由于日志解码时工作内存不足而溢出到磁盘的事务总数。统计顶层事务和嵌套事务(subtransaction);spill_count——日志解码时事务溢出到磁盘的总次数。每次事务溢出都会增加计数器,同一事务可能多次溢出;spill_bytes——日志解码时溢出到磁盘的已解码数据总量,单位为字节;stream_txns——由于日志解码时工作内存不足,数据被发送给订阅端的活动事务总数。因此,只有顶层事务的数据可以这样传输(嵌套事务的数据不会单独在流中传输),所以计数器不统计嵌套事务;stream_count——由于日志解码时工作内存不足,活动事务数据被发送给订阅端的总次数。每次以流式方式传输事务数据时,计数器都会增加;同一事务可能以这种方式传输多次;
stream_bytes——以流式方式传给订阅端的已解码数据总量,单位为字节;total_txns——发送给订阅端的已解码事务总数。只统计顶层事务,不统计嵌套事务。计数器同时包括以流式方式传输的事务和溢出的事务;total_bytes——发送给订阅端的已解码数据总量,单位为字节。计数器同时包括流式传输事务和溢出事务的数据;stats_reset——这组统计信息重置的时间戳。
这些计数器有助于评估逻辑解码相关的工作量和 I/O,并调整参数 logical_decoding_work_mem。
下一个工具是 pg_stat_subscription 视图,它提供订阅统计信息,可以跟踪接收日志的过程:
subid、subname——订阅的唯一标识符和名称;pid——负责订阅的进程;relid——当前正在进行初始同步的关系标识符。如果进程处于只应用变更的常规工作模式,该值为空(NULL);received_lsn——最后一个已由订阅端接收的日志位置;last_msg_send_time——订阅端收到的最后一条消息的发送时间;last_msg_receipt_time——从发布节点收到的最后一条消息的到达时间;latest_end_lsn——订阅端向发布节点确认的最后一个本地日志位置;latest_end_time——订阅端向发布节点确认的最后一个本地日志位置对应的时间。
实践中,pg_stat_subscription 可以用于跟踪订阅状态以及接收变更的处理速度。
下一个工具是 pg_stat_subscription_stats 视图,它有助于跟踪订阅端是否出现错误。复制与更新、删除操作(UPDATE 和 DELETE 命令)相关的变更时,会使用所谓的复制标识,通常基于表的主键值。也可以使用其他唯一键,甚至使用整行代替主键。如果复制变更时违反复制标识的唯一性,例如尝试插入一个表中已经存在的标识符,就会发生冲突,并导致错误。冲突不会自动解决;同步或应用变更的进程会停止,需要管理员手动干预。为避免出现此类冲突,初始同步表时,订阅端的表应为空;在复制运行期间,应避免在订阅端修改数据。不过,即使满足这些条件,也应该通过 pg_stat_subscription_stats 视图跟踪错误,该视图包含以下字段:
subid、subname——订阅的唯一标识符和名称;apply_error_count——正在运行的复制过程中应用变更时发生的错误总数;sync_error_count——表初始同步过程中发生的错误总数;stats_reset——这组统计信息重置的时间戳。
发布与订阅机制刚加入时,这类错误只能记录在服务器日志中,需要对日志进行处理和分析。增加 pg_stat_subscription_stats 后,跟踪这类错误变得更加容易。
7.3. 恢复冲突
物理复制的一种使用场景是分摊负载:应用程序的一部分查询在主库上执行,另一部分查询(读取查询)在副本上执行,从而更高效地利用整个数据库集群的计算资源。
在承担读负载的副本上重放变更时,下一条日志记录的应用可能导致查询无法继续执行。这样的情况称为恢复冲突(recovery conflict)。数据库管理系统面临一个选择:继续执行查询,同时暂停变更应用(也就是暂停复制),还是取消查询并应用变更。数据库管理系统的处理方式是:将变更应用暂停 max_standby_streaming_delay 的时长(默认 30 秒),给查询留出完成的机会。如果查询在这段时间内未能完成,数据库管理系统就会强制终止查询并恢复应用变更。需要注意,在这段延迟倒计时期间,数据库管理系统仍会从主库接收新的日志记录,但不会应用它们。理想情况下,导致复制延迟的查询很少出现,而查询执行期间积累的滞后会很快补回来。最糟糕的情况是,大量并发查询导致日志记录应用不断推迟:一个冲突查询结束后,同一条日志记录可能又与下一个查询发生冲突,使滞后不断积累。
如果查询被强制取消,应用程序会收到错误,该错误也会记录在服务器日志中:
从归档恢复时也可能发生恢复冲突,此时日志段不是通过流复制传输,而是从 WAL 归档复制。在这种情况下,滞后时间由 max_standby_archive_delay 决定,默认同样为 30 秒。
如何处理这些错误取决于业务要求:需要判断两种代价中哪一种更小,是落后于主库,还是中断查询。如果更重视查询无错误完成,可以增大 max_standby_streaming_delay 的值,但这可能导致副本进一步滞后。反过来,如果不能容忍副本滞后(例如副本是故障切换的主要候选节点),则可以忽略错误,或在应用侧处理错误,将失败的查询重试到主库上。另一种常见方案是使用一个允许极大滞后的独立副本,它可能严重落后。这个副本主要用于执行长时间查询,不参与故障切换过程。
除了服务器日志,还可以通过 pg_stat_database.conflicts 跟踪恢复冲突:该计数器按数据库统计所有类型的冲突。更具体的冲突原因可以在 pg_stat_database_conflicts 视图中查看。这个视图只对副本有意义,因为冲突只会在那里发生。视图包含数据库列表,以及每类冲突的计数器:
datid、datname——数据库的唯一标识符和名称;confl_tablespace——因表空间被删除而取消的查询总数;confl_lock——因锁超时到期而取消的查询总数;confl_snapshot——因数据快照过时而取消的查询总数;confl_bufferpin——因共享缓存中的缓冲区被固定而取消的查询总数;confl_deadlock——因发生死锁而取消的查询总数。
通常,恢复冲突被视为错误;当 pg_stat_database.conflicts 中出现非零值时,可以进一步借助服务器日志(哪些查询引发了冲突)和 pg_stat_database_conflicts 视图(发生了哪些具体冲突)调查细节和原因。
恢复冲突可能由主库上发生的不同事件引起。实践中最常见的是因清理而取消查询:清理过时行版本产生的变更传到副本时,副本上正在执行的查询仍然需要这些版本(confl_snapshot 计数器)。这通常是处理大量数据的长时间分析查询,因此执行时间可能无法预测,并且需要大量资源。取消并重试这类查询可能在资源和等待结果的时间上代价很高。为了减少查询被取消的概率,可以单独采取或同时采取两项措施。第一,增大允许的滞后时间 max_standby_streaming_delay。第二,启用反馈 hot_standby_feedback。通过反馈,walsender 进程会从副本收到它所需的界限,并在删除过时行版本时考虑该界限(如果未使用复制槽,该界限显示在 pg_stat_replication.backend_xmin 中;如果使用复制槽,则显示在 pg_replication_slots.xmin 中)。这样就不会发生与这些变更冲突的情况(关于事务界限的详细说明,参见介绍清理的第 8 章)。不过,这两种方法都不能保证查询 100% 执行成功,而且都会带来一定的负面影响。增大滞后时间可能导致滞后增加;如果查询执行时间超过这个滞后时间,查询仍会被取消(极端情况下,可以将参数设置为 −1,让副本无限等待)。反馈只能保证免受清理影响,但清理推迟会使表膨胀;此外,仍有其他原因可能导致冲突并随后取消查询。因此不存在理想的解决方案,应根据业务要求,在允许取消查询和允许副本滞后之间作出取舍。对于分析查询,一个折中办法是创建一个允许较大滞后时间的独立副本,但不要将其用于选择主库。这样可以容忍较大的滞后;同时可以不启用反馈,从而尽量减少膨胀效应。
总结
复制几乎总是用于生产环境。
复制基于传输 WAL 日志运行。
复制分为物理复制和逻辑复制。
pg_stat_replication是跟踪复制的主要工具。
在副本上跟踪复制时使用
pg_stat_wal_receiver。复制滞后是最常见的问题。
复制滞后量可以按字节或秒进行测量。
复制槽可以排除副本不可逆滞后的风险,但会增加磁盘空间耗尽的风险。
使用
pg_replication_slots视图跟踪复制槽。逻辑复制使用发布与订阅模型。
可以使用
pg_stat_replication_slots视图跟踪逻辑复制槽。可以使用
pg_stat_subscription和pg_stat_subscription_stats视图跟踪订阅。在副本上执行查询时可能发生恢复冲突。
可以使用
pg_stat_database和pg_stat_database_conflicts视图跟踪恢复冲突。
8 清理
本章将讨论:
什么是清理以及为什么需要清理;
活行和死行;
自动清理后台进程;
在什么条件下以及多久执行一次清理;
如何查看等待处理的表队列;
事务计数器以及防止与其回卷相关的错误;
事务界限;
如何确定可用事务 ID 的数量;
膨胀现象;
如何确定表和索引的膨胀程度;
跟踪正在运行的清理进程的方法。
前几章介绍了数据库管理系统的一些后台进程,本章继续介绍这类进程。本章讨论清理过程,即通常所说的 vacuum。下文使用“清理”一词时,既包括手动清理,也包括自动清理;在自动清理的语境中使用“自动清理”这一术语。
清理是垃圾收集器(garbage collector)的一种实现,也是数据库管理系统的重要组成部分。清理是否高效会直接影响性能。本章将介绍清理机制、需要跟踪的工作特征,以及数据库管理系统为监控清理提供的工具。
8.1. 清理简介
为了在高负载下保证客户端并发工作的高性能,PostgreSQL 实现了 MVCC1(多版本并发控制,Multiversion Concurrency Control)模型。该模型尽量减少锁的数量,使读进程不会阻塞写进程,写进程也不会阻塞读进程。
执行查询和事务时,数据库管理系统使用快照(snapshot)。快照确定事务可见的数据状态,只包含快照创建时已经提交的变更;快照的创建时刻取决于事务设置的隔离级别(isolation level)。事务(以及查询)的并发执行意味着系统中会同时存在多个快照,而这些快照既可以用于读取数据,也可以用于修改数据。
在 PostgreSQL 的 MVCC 模型中,行不会原地修改(in-place);相反,各种操作会处理行版本:
INSERT操作插入新行的第一个版本;UPDATE操作插入行的新版本,并将旧版本标记为已删除;DELETE操作将行版本标记为已删除。
因此,同一行可能存在多个版本:一个当前版本,也就是活行(live),以及可能存在的多个死行(dead)。标记为已删除的行会继续在原来的页面和数据文件中保存一段时间,因为其他活动事务可能仍然需要它们(也就是说,这些行版本仍属于这些事务使用的快照)。在写入活动很高的情况下,标记为已删除的行版本会不断增加,从而影响表和索引的大小。随着事务逐步结束,死行最终不再被任何事务需要,此时可以安全地删除它们,为新行释放空间。有关 MVCC 机制工作方式的更多信息,参见《The Internals of PostgreSQL》的相应章节2。
死行版本逐渐变得不再需要,但仍会占用页面空间,造成我们希望避免的多余输入/输出操作和资源消耗。因此,数据库管理系统需要删除那些已经过时且不再被任何人需要的行版本,这正是清理所负责的工作。在 PostgreSQL 的早期版本中,清理通过单独的 VACUUM 命令实现,管理员必须手动执行该命令,或借助外部任务调度器(通常是 cron)执行。除了清理之外,VACUUM 命令还具有一些附加功能,例如收集规划器统计信息、执行完全阻塞式清理、冻结行等。有关清理命令工作方式的更多信息,参见文档3。后来,数据库管理系统又实现了自动清理版本,由按需启动的后台进程执行。
第一个自动清理进程 autovacuum launcher 维护数据库列表,并决定何时在具体数据库中启动清理。需要清理时,autovacuum launcher 向主进程 postmaster 发送信号,后者随即启动自动清理工作进程 autovacuum worker。清理工作进程获取目标数据库的名称,连接到该数据库,并建立待处理表的列表。它依次处理列表中的表,扫描其中不再被任何活动事务需要的过时行版本,并同时为表和索引释放空间。释放出的空间可以用于插入新行。如果清理在表文件末尾形成了空闲空间,清理还可以截去末尾的空页面(truncate heap),从而减小表文件。
在某些工作负载下,表和索引中只有相对较少的活行,其余空间虽然已经释放,却没有被使用。如果这些空闲空间在物理上分布于文件的不同位置,清理就无法释放这些区域并缩小文件。这样的区域形成并逐渐增大的过程称为膨胀(bloat)。在最轻微的情况下,膨胀效应只会导致空间被白白占用;在最严重的情况下,则会因为多余的输入/输出操作、缓冲区缓存不足,以及索引层级增加导致索引访问效率下降而降低性能。因此,在运行数据库管理系统时,需要跟踪表和索引的过度膨胀并减少这种膨胀。
概括来说,从运维角度看,数据库管理员应跟踪自动清理的工作效率、它产生的负载,以及表中死行所占的比例,并在必要时调整清理设置、减少已经形成的膨胀。
随着现代存储系统性能提高,跟踪清理负载的重要性已经大幅降低。过去在 HDD 磁盘时代,这项工作很重要,因为清理可能显著影响查询性能;现在使用 SSD 和 NVMe 介质时,这种负面影响已经大幅减小,甚至基本消失。
8.2. 清理的实际特点
为了了解清理工作中究竟应该跟踪什么,下面来看它在实践中的一些特点。清理只会在特定事件发生后启动,理想情况下不应延迟。但如果清理发生延迟,就需要了解已经积累了多少工作。
自动清理何时执行?
当表中的死行数量超过某个允许值时,自动清理就会处理该表。过时行版本由更新和删除操作产生;执行这些操作时,系统会持续跟踪过时行版本的数量,一旦超过允许值,就会将表加入待处理列表。允许值根据以下信息计算:
pg_class.reltuples——根据最近一次清理得到的表中总行数;pg_stat_all_tables.n_dead_tup——死行总数,在更新和删除操作期间更新;autovacuum_vacuum_threshold——确定基础阈值的参数,即表中触发清理所需的最少死行数(默认 50 行);
autovacuum_vacuum_scale_factor——确定表中总行数比例的参数,该比例用于增加基础阈值 autovacuum_vacuum_threshold(默认值为 0.2,即
pg_class.reltuples的 20%)。
按默认值计算,表中的死行数量必须超过 50 行加总行数的 20%,自动清理才会触发。参数 autovacuum_vacuum_scale_factor = 0.2 常被认为较为保守;在现代配置中通常会指定 0.01 到 0.05 范围内的更小值,从而更频繁地触发自动清理,并在死行数量少得多时就开始清理。对于非常大的表(以及很大的索引),即使 autovacuum_vacuum_scale_factor 较小,换算成行数后也可能很大,工作内存可能不足以容纳全部死行指针。这会显著增加清理成本,因为系统不得不多次完整扫描并清理索引。在这种情况下,可以通过存储参数4为单独的表设置清理参数。
现在已经知道自动清理的触发条件,可以编写查询,找出死行数量超过允许值的表。该查询输出用户表及其一些统计信息:
relation——表名;如有需要,也可以同时输出模式名;reltuples——表中行数的近似值。每次执行自动清理、VACUUM、ANALYZE以及某些 DDL 命令(例如CREATE INDEX)后,该值都会更新;live_tup——表中的活行数;dead_tup——表中过时的死行数;boundary——允许的死行版本数。当死行版本数超过该值时,表就应由自动清理处理;av_cnt——表上已执行的自动清理操作总次数;since_last_av——距离上次自动清理执行已经过去的时间;
av_need——表示死行版本数超过允许值、表需要处理的标志;dead_ratio——死行版本数占表中总行数的百分比。
根据查询结果,可以观察到几点:
有两张表(
pgbench_tellers和pgbench_branches)需要清理:其中的死行版本数大幅超过允许值,av_need = t这一标志说明了这一点;av_cnt和since_last_av的值表明,这两张表会定期清理,但在当前工作负载下,下一次清理启动前,表中仍会积累大量死行版本(参见dead_ratio);要评估
since_last_av的值,需要知道参数 autovacuum_naptime5 的值(默认一分钟)。该参数确定autovacuum launcher 向每个数据库发送信号、启动清理工作进程的间隔。查询输出中有两张表带有需要清理的标志。这两张表的since_last_av值都在一分钟以内,说明虽然表需要处理,但没有发生延迟。反过来,如果表带有清理标志,而since_last_av的值超过 autovacuum_naptime,就说明清理发生了延迟;有一张表包含大量行,但从未被处理过(
pgbench_accounts),因为其中的死行数量从未达到阈值。
可以得出结论:测试环境中的表不多,自动清理能够完成自己的工作。
还需要说明允许值(boundary)是如何计算的。计算以全局配置参数为基础,但数据库管理系统允许通过所谓的存储参数(storage parameter)6为单独的表指定这些参数。表级存储参数的优先级高于全局配置参数,计算阈值时应将其考虑在内。测试环境中的表没有显式设置存储参数,因此查询没有考虑它们。
清理执行统计
前面查询使用了函数 pg_stat_get_autovacuum_count,该函数返回表被自动清理处理的次数。这个函数以及其他几个类似函数都被 pg_stat_all_tables 视图使用,pg_stat_user_tables 和 pg_stat_sys_tables 视图也建立在该视图之上。借助这些函数,相关视图会显示多个字段,用于表示自动清理和手动清理的工作情况:
last_vacuum——表上一次由VACUUM命令清理的时间;last_autovacuum——表上一次由自动清理处理的时间;vacuum_count——表由VACUUM命令处理的总次数;autovacuum_count——表由自动清理处理的总次数。
收集规划器统计信息
规划器统计信息收集操作也有一组类似字段。统计信息既可以通过调用 ANALYZE 命令收集,也可以在调用 VACUUM 命令时指定 ANALYZE 参数,将其作为附加操作收集,或者由自动清理工作进程收集。
下面的查询可以跟踪清理的规律性:
查询输出同时反映了手动清理和自动清理的统计信息。清理的主要工作由自动清理完成,VACUUM 命令只偶尔执行(这是工作负载的特征)。
汇总所有数据库中的清理操作执行统计信息,可以得到整个实例的总体情况,并将其显示在监控中(图 8.1):
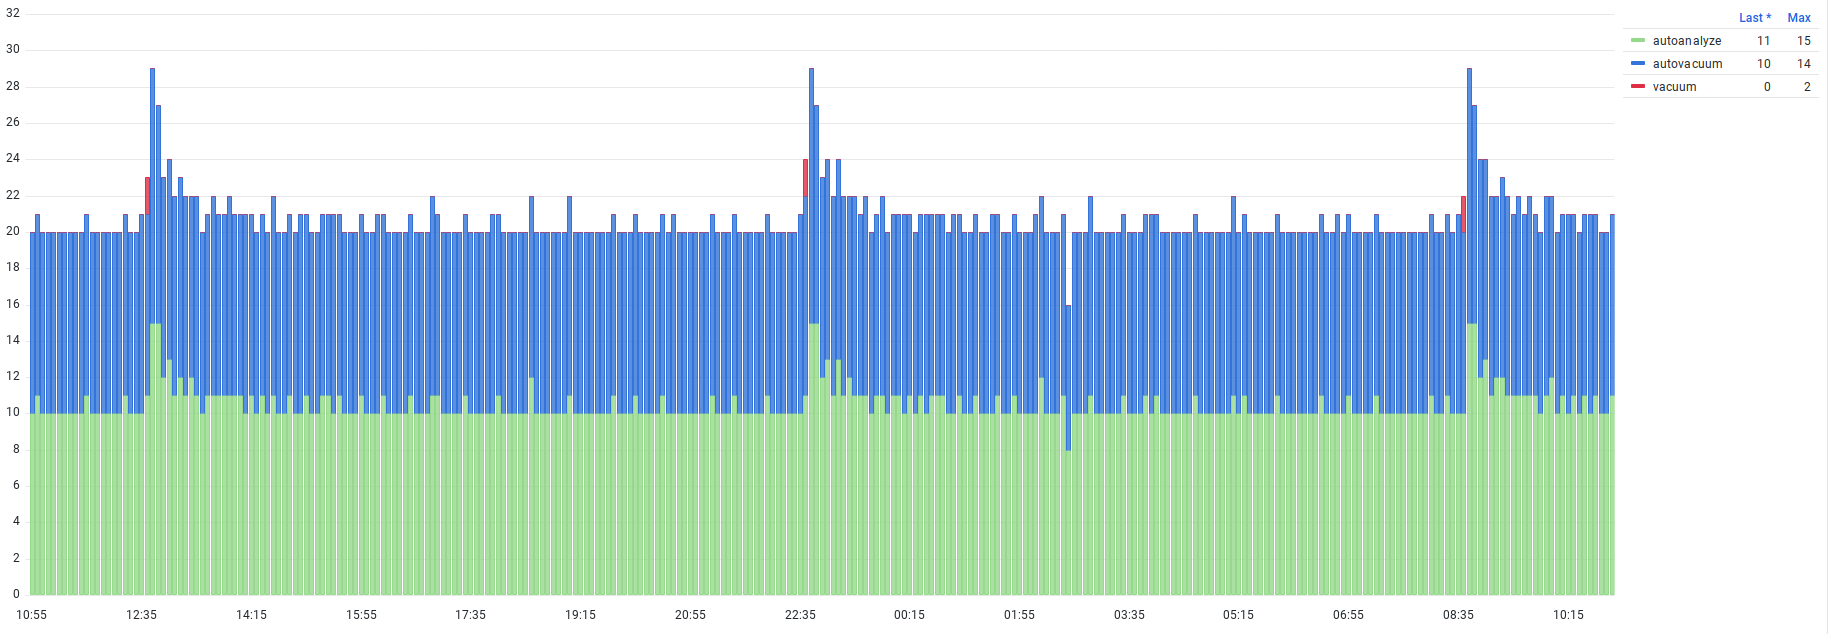
图 8.1 显示了五分钟内执行的清理和分析操作数量。在图示的一天内,操作数量保持在相对稳定的水平,没有明显波动,但可以看到约每 10 小时出现一次的周期性。如果调整自动清理设置,这张图可以帮助了解所做修改对自动清理工作的影响。工作负载发生显著变化,尤其是写入量变化时,也可能影响维护操作的执行频率,这些变化的后果同样会在图中体现出来。
8.3. 事务计数器及防止其回卷导致的错误
每个事务,即使只是一个单独的命令,也有唯一的标识符。它可以是虚拟事务标识符(virtualxid);如果事务修改数据,则会分配一个持久的 32 位标识符(transaction ID、xid 或 txid)。执行修改数据的命令(插入、更新、删除)时,行版本的系统字段 xmin 和 xmax7 中会记录事务标识符:xmin 记录创建该行的事务,xmax 记录删除该行的事务。行的可见性规则以此信息为依据。例如,刚由已提交事务创建的行版本不会出现在已经开始的查询中,因为该版本的 xmin 会大于查询中可见的最大编号8。
在持续负载下,数据库管理系统会不断分配新的事务 ID。事务 ID 的范围受 32 位限制,对应从 0 到 的值(约 42 亿)。这意味着在某个时刻,编号范围可能耗尽,事务计数器必须从零重新开始。但这样一来,过去事务创建的所有行都会落入未来,因为它们的标识符将超过当前计数器的值。这会导致所有数据突然丢失:数据虽然仍物理保留在页面中,却不再符合可见性规则,因而无法访问。为避免这种情况,事务 ID 范围会回卷并形成一个分成两部分的环:对于任意一个 ID,接下来的 20 亿个 ID 被视为比它“更老”、处于未来,而前面的 20 亿个 ID 被视为比它“更年轻”、处于过去。一项事务创建的行,在接下来的 20 亿个事务中处于过去;但如果不采取措施,对于再往后的事务它就会处于未来。因此,在达到 20 亿这个界限之前,数据库管理系统就会找出这些旧行并为它们设置冻结标记。根据可见性规则,冻结(frozen)行被视为极其古老,因此不再需要检查它们的 xmin 值。这些行无条件可见,直到它们被更新或删除;更新或删除会设置 xmax 值。
译注:事务 ID 范围公式
原文在这里保留公式 ,同时将范围描述为约 42 亿;这两种表述存在数学疑义,后者更接近 的数量级。本译文保留原公式和原文论证,不静默改写。原文随后用“更老/更年轻”描述回卷 ID 的两侧;这里保留该称呼,但“处于过去/未来”应以可见性规则为准,不能把这些相对称呼直接理解成自然时间顺序。
FrozenTransactionId
在 PostgreSQL 9.4 之前的版本中,行冻结通过将行的 xmin 替换为系统标识符 FrozenTransactionId(值为 2)实现。在后续版本中,冻结标志作为位标志设置在另一个系统字段中,而行的 xmin 得以保留。
单独一行是否需要冻结,由其 xmin 标识的事务年龄决定。事务年龄是指该事务之后直到当前时刻,在系统中启动的事务数量。冻结年龄较小的行可能并不划算,因为行可能随后发生变化,已经完成的工作就会白费。冻结也不能长期推迟:在高强度工作负载下,可能积累大量未冻结的行,处理它们需要大量资源和时间。冻结通常由清理工作进程自动执行(也可以手动执行 VACUUM FREEZE),因此,为了及时冻结行,自动清理也必须及时启动且不能延迟。根据数据库管理系统的配置或工作负载,可能出现推迟自动清理甚至妨碍自动清理的情况。长期忽略这些情况会降低性能,最糟糕时还可能导致数据库管理系统异常停止。以下情况都可能推迟清理:
在全局配置中关闭自动清理(autovacuum
= off),或通过存储参数在单独的表级别关闭自动清理;长事务(这是自动清理推迟删除过时行版本的最常见原因);
被遗忘且尚未结束的预备(prepared)事务;
使用 pg_dump 或
COPY命令执行的长时间数据导出,它们同样使用事务机制;定期执行的 DDL 操作可能取消自动清理,使部分工作推迟到以后;
不活动的复制槽。
在正常运行中,自动清理应始终启用,工作负载中也不应出现长时间运行或处于空闲状态的操作。
冻结界限。 每张表都有一个 pg_class.relfrozenxid 属性,其中包含创建该表中最晚的未冻结行版本的事务 ID。事务 relfrozenxid 的年龄称为该表的冻结界限——事务 ID 更老的所有行版本都已经确定被冻结。通过 pg_class 表,既可以获取 relfrozenxid 本身,也可以计算冻结界限(horizon 字段):
译注:relfrozenxid 与冻结界限
原文将 relfrozenxid 描述为最晚的未冻结行版本的创建事务 ID,同时把更老的行版本定义为已经冻结。这里保留原文的表述和“冻结界限”术语,不静默改写字段语义。按 PostgreSQL 15 pg_class 的说明,relfrozenxid 表示更早的事务 ID 已冻结的边界;当正文使用 age(...) 的结果时,horizon 表示该界限的年龄。
冻结界限范围内的事务 ID 区间,决定了由于仍有未冻结的行版本而暂时不能重新用于未来事务的事务 ID 数量。对于定期执行清理的表,行会及时冻结,界限也会得到维护,也就是 relfrozenxid 会向前推进。查询输出表明,有三张表会定期执行清理并推进 relfrozenxid;而 pgbench_accounts 从未清理过,因此其 relfrozenxid 会逐渐落后,冻结界限也会增长。
relminmxid 属性与多事务
除了 relfrozenxid,表还有一个类似的属性 relminmxid,它指向该表中仍在使用的最老多事务标识符。多事务是需要同时对一行取得共享锁的一组普通事务。这些事务也有 32 位标识符,会写入行版本的 xmax 字段;因此它们同样需要冻结的对应机制,以及 relminmxid 的推进。下文提到 relfrozenxid 时,相应语境也可以推广到多事务,虽然不再明确说明。
清理时,数据库管理系统会评估冻结界限并选择合适的工作模式。在普通模式下,清理会冻结 xmin 年龄超过 vacuum_freeze_min_age(默认 5000 万)的行版本。如果表的冻结界限超过 vacuum_freeze_table_age(默认 1.5 亿),清理会以激进模式运行,完整扫描所有页面,以便冻结那些在普通模式下因可见性映射而跳过的页面中的行版本。如果表的冻结界限年龄超过 autovacuum_freeze_max_age(默认 2 亿),即使表不需要清理,或自动清理已关闭(通过全局参数 autovacuum 或单独表的存储参数关闭),系统也会强制启动带冻结的清理。这还保证了那些行不会变化的表(例如归档分区)中的行版本能够被冻结。
如前所述,在我们的示例中有一张表 pgbench_accounts 从未清理过,其冻结界限也比其他表更大。可以执行一次强制冻结清理(VACUUM FREEZE)进行实验;执行后,relfrozenxid 会向前推进,冻结界限会减小。
如果查看单独数据库中的所有表,它们的 relfrozenxid 通常各不相同;在所有表中总会有一张表的冻结界限最大(relfrozenxid 最老)。该表的冻结界限决定数据库冻结界限,并存储在 pg_database.datfrozenxid 中——该数据库任意表中事务 ID 更老的所有行版本都已经确定被冻结。数据库集簇中 pg_database.datfrozenxid 最老的值决定整个集簇的冻结界限。推进这个界限可以释放事务 ID,使其能够重新使用。
只有 pgbench 数据库的 datfrozenxid 向前推进了(它最近执行过带冻结的清理)。其他数据库的值仍然保留在集簇初始化时的状态:其中没有活动,也不需要执行清理,因此不会发生冻结。但是,当这些数据库的冻结界限超过 autovacuum_freeze_max_age(默认 2 亿)时,系统会在其中启动强制冻结清理。现在距离这一时刻已经不远了。清理很快就会执行,查询将显示 datfrozenxid 向前推进、冻结界限减小:
pgbench 数据库保持不变,因为它最近才执行过冻结,目前还不需要再次执行。
事务 ID 余量。 在正常运行中,清理和冻结应及时执行:datfrozenxid 向前推进,数据库管理系统为未来事务保留着充足的事务 ID。实际上,工作负载中可能出现异常,导致清理(以及冻结)推迟。通常,清理无法处理行的最常见原因是长事务:长事务会保持其他事务的可见性界限,使清理无法处理该界限以内的行。最糟糕时,冻结开始推迟,事务 ID 余量也会开始耗尽。因此,跟踪事务持续时间、消除长事务的来源,并使用超时强制结束长事务非常重要。
从监控角度看,我们关心的是可用事务 ID 的余量。可以通过 pg_database.datfrozenxid 字段,根据集簇冻结界限计算它;也可以根据数据库的可见性界限计算。数据库可见性界限由该数据库活动事务中最大的可见性界限决定——超过可见性界限的行已经不再被任何活动事务需要,今后可以被冻结(或被修改,从而改变 xmax)。第二种方法给出的估计更乐观,因为事务 ID 余量还包括数据库可见性界限与集簇冻结界限之间的区间,而这个区间可能很大,包含几千万个事务 ID。下面这些字段可以帮助我们在活动事务中寻找最大的可见性界限:
pg_stat_activity.backend_xid——分配给会话的事务 ID;pg_prepared_xacts.transaction——预备事务的事务 ID;pg_replication_slots.xmin——确定该复制槽所保持的可见性界限的事务 ID;
前两个字段指向当前节点上正在执行的活动事务。如果使用副本并启用了反馈(hot_standby_feedback = on),最后一个字段表示副本上的事务通过复制槽保持的界限。如果复制不使用槽,同样的信息会出现在相应 walsender 进程的 pg_stat_activity.backend_xid 字段中。借助反馈,管理员可以从主库跟踪副本上的长时间活动,但反馈也会推迟清理,并带来所有相应的负面影响。因此,是否使用反馈应经过审慎权衡。
译注:复制反馈字段
原文在“不使用复制槽”的句子中写作 pg_stat_activity.backend_xid。按固定的 PostgreSQL 15 资料,backend_xid 是后端的顶层事务 ID,而副本通过 hot_standby_feedback 报告的可见性界限对应 pg_stat_activity.backend_xmin。这里保留原文字段和论述,并标明这一字段差异。
下面分别介绍计算事务 ID 余量的两种方法。
第一种方法是使用基于 datfrozenxid 和 datminmxid 字段的集簇冻结界限:从整个可用事务 ID 范围的一半(20 亿)中,减去这两个标识符中年龄较大的那个。
从上面的输出可以看到,冻结界限已经达到 350 万,而事务 ID 余量(available_xids 字段)仍然非常充足,超过 20 亿。
第二种确定事务 ID 余量的方法依赖于计算数据库的可见性界限。此时需要检查所有活动来源,找到持续时间最长的活动,计算它的年龄,然后像第一种方法一样,从整个可用事务 ID 范围的一半中减去这个年龄。此外,还可以输出保持可见性界限的事务 ID:
译注:示例输出的第一列
原文说可以输出保持可见性界限的事务 ID,但紧接着的查询选择的是 pid,并没有输出相应的事务 ID 值。这里保留原文说明和原始 SQL;读者应将示例第一列理解为进程 ID。
在正常情况下,查询输出应当为空;但是,如果使用较短的间隔执行 \watch(例如十分之一秒),就能看到具有极短界限的行快速出现又快速消失,例如上面的输出。在这个例子中,界限为 1:测试环境中没有长期事务长时间保持可见性界限。
不过,可以再打开一个会话,在新事务中更新 pgbench_accounts 的任意一行,然后暂时不要结束这个事务:
现在,如果再重复几次查询,就会看到情况发生了变化:
由于数据库中有事务活动,事务计数器不断增加;由于有一个事务保持打开状态,可见性界限开始增长(确定这个打开事务快照的标识符,相对于执行当前查询的事务编号不断向过去移动)。可用事务 ID 的数量也开始减少,虽然变化并不明显。最重要的是,第二个会话中的事务保持打开的时间越长,可见性界限就会增长得越多;在这个界限以内,自动清理无法删除过时的行版本(这会导致膨胀),也无法冻结旧的行版本(随着时间推移,这可能导致可用事务 ID 的实际数量减少)。事务提交或回滚后,界限会再次减小到零。
无论使用哪种方法计算事务 ID 余量,从监控角度看,都适合将它显示为图表。图 8.2 展示了这样的情况:某个数据库的 datfrozenxid 年龄超过了 autovacuum_freeze_max_age,因此执行了带冻结的强制自动清理。为了使变化更加明显,图中采用了几天的时间范围,因为测试环境中的事务 ID 余量下降得相对缓慢。冻结完成后,界限减小,事务 ID 余量也相应增加。在事务活动量较大的生产环境中,这种界限推进会定期发生,而且相当频繁。
防止回卷。 除了冻结机制,数据库管理系统还内置了各种检查,用于在冻结界限危险增长时通知数据库管理员,并避免事务计数器回卷相关的错误。一旦强制清理无法正常完成工作,
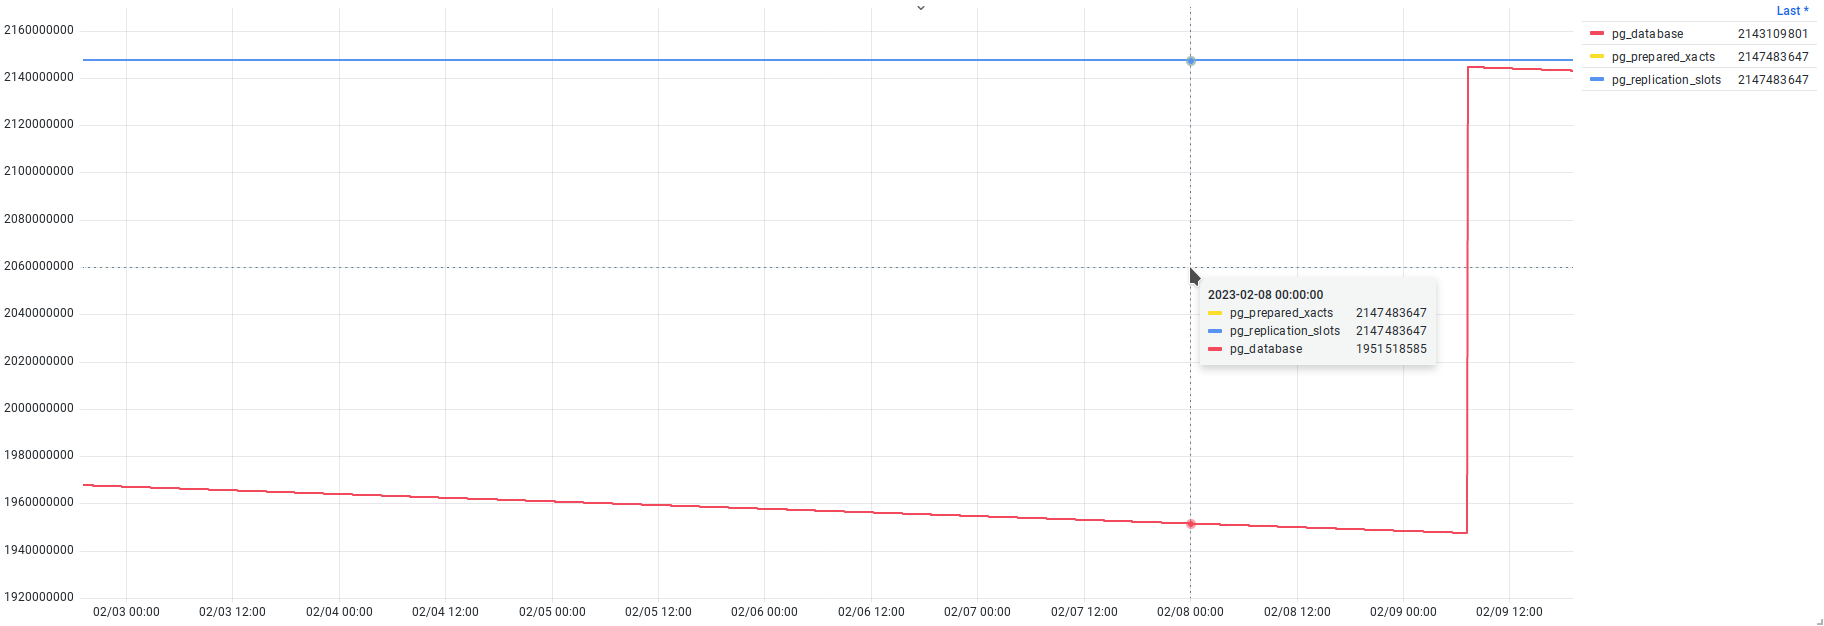
服务器日志中就会开始出现通知,说明当前使用中的最老事务 ID 已经落后很久:
作为提示,数据库管理系统建议结束未完成的事务,提交或回滚旧的预备事务,或者删除不活动的复制槽。情况继续恶化时,清理会以一种特殊的 failsafe 模式运行;为了加快冻结过程,该模式会跳过索引处理。当 relfrozenxid 的年龄超过 vacuum_failsafe_age 时,就会启用这种模式:
如果继续忽略这些消息,数据库管理系统会更加直接,开始报告哪些具体数据库必须执行清理:
在事务 ID 余量耗尽前大约 300 万个事务时,数据库管理系统会切换到只读模式。任何写入或修改数据的尝试都会以错误结束。
这种情况被视为危险状态;数据库管理系统进入紧急模式后将停止工作,从而避免继续运行并损坏数据。要恢复并继续正常运行,管理员必须以特殊的单用户模式(single-user mode)重启数据库管理系统,在需要处理的数据库中执行清理,然后再以普通模式重启数据库管理系统。
8.4. 表和索引的膨胀
过时的行版本由更新或删除操作产生。在正常运行时,这些行版本占用的空间会由清理及时释放,并用于插入新的行版本。但是,如果积累了过多过时版本,而自动清理又长时间无法清除它们,那么清理完成后,表和索引文件中就会形成大片空闲区域;这些区域今后可能不会被用到,只会继续占用磁盘空间。因此,磁盘空间没有得到有效利用。需要特别指出的是,这适用于文件开头或中间的“空洞”:如果清理释放的是文件末尾的空间,它可以尝试截断文件。
数据库长期运行时,表和索引中的这类空洞可能越来越多,于是就会出现所谓的膨胀。把所有空洞加在一起,可能得到一个相当可观的数字。从运维角度看,需要定期检查表和索引是否存在膨胀,执行维护并释放未使用的空间。
要查找膨胀对象,最有效、最准确的评估工具是 pgstattuple 扩展9。不过,准确性是以较大的开销为代价的:该扩展会读取被检查对象的每一页,这需要相应的输入/输出,并会增加磁盘子系统的负载。考虑到数据库管理系统没有内置的吞吐量限制机制,这种“检查”可能显著 加重存储子系统的负载,并严重影响并发执行查询的性能。因此,定期且频繁地使用 pgstattuple(例如在遥测数据采集代理中使用)可能并不合适;建议只在需要时使用 pgstattuple。
还有其他使用系统目录数据进行评估的启发式方法,它们会考虑行的总数、行宽以及其他存储特征;但是,这类方法通常准确性较低,可能产生较大的偏差。工具的选择始终由管理员决定,并应以运行条件为依据。可以在 PostgreSQL Wiki 的相应章节中找到这类查询的示例10。
为了说明,测试环境中已经安装了 pgstattuple 扩展;我们将使用它评估两张表的膨胀:pgbench_accounts 和较小的 pgbench_branches。
查询的执行时间取决于表的大小,因为必须读取表的每个数据块,所以评估 pgbench_accounts 所需的时间比评估 pgbench_branches 更长。通过分析表,可以得到以下信息,用来评估膨胀:
table_len——对象(表或索引)的大小,单位为字节;tuple_count——活行版本的总数;
tuple_len——活行版本的总大小,单位为字节;tuple_percent——活行版本占所有行版本总数的百分比;dead_tuple_count——死行版本的总数;dead_tuple_len——死行版本的总大小,单位为字节;dead_tuple_percent——死行版本占所有行版本总数的百分比;
译注:pgstattuple 百分比字段
原文把 tuple_percent 和 dead_tuple_percent 说明为行版本数量的百分比,但 PostgreSQL 15 的 pgstattuple 实现按 tuple_len / table_len 和 dead_tuple_len / table_len 计算,实际表示对象总字节数中的比例。示例中的 242000000 / 294264832 = 82.24% 也表明这里是字节比例。本译文保留原书字段说明,同时明确这一技术差异。
free_space——表文件内部空闲空间的总大小,单位为字节;这些空间由清除死行版本产生,因表膨胀而形成,只能在这张表中重复使用;free_percent——空闲空间占对象总大小的比例,也就是用百分比表示的同一项膨胀指标。
最值得关注的字段是 free_space 和 free_percent,因为它们直接表示空闲空间的大小。比较两张表的统计信息可以看到,pgbench_accounts 的膨胀程度远低于 pgbench_branches,分别为 3.5% 和 88%;但是,pgbench_branches 占用的空间只有 311 KB。释放空闲空间带来的收益可能很小,但如果这张表关联着大量输入/输出活动,就可以显著降低开销。
继续这个例子,我们对表 pgbench_branches 执行完全清理命令 VACUUM FULL。虽然这是一个会阻塞的操作,但由于目标表很小且只有 20 行,它会立即完成。完全清理之后,我们再次查看 pgstattuple 统计信息:
几乎所有空闲空间都被释放了,表也可以放入一个 8 KB 大小的页面中。不过,这只是测试环境中的一张小表。在真正的生产环境中,数值和结果会完全不同。
实际工作中可以使用各种工具释放空间。对于索引,可以使用 REINDEX CONCURRENTLY 命令;它会以非阻塞方式创建新索引,然后用新索引替换旧索引。对于表,数据库管理系统建议使用 VACUUM FULL 命令,但该命令会完全阻塞对表的访问,甚至不允许读取,因此不适合生产环境。作为替代方案,可以使用社区提供的第三方工具,例如 pg_repack11、pgcompacttable12 和 pg_squeeze13。这些工具的实现方式和工作原理各不相同,但目标相同:消除膨胀并释放空间。
8.5. 跟踪正在运行的清理进程
清理的执行时间可能受多种因素影响,例如配置参数、表的大小、索引数量以及死行数量等。清理处理表和索引时会给存储子系统增加额外负载,可能与数据库管理系统的其他进程争用输入/输出资源,并影响它们的性能。对管理员来说,不仅要了解清理操作的执行进度,还要评估它们对系统的影响,并了解资源的使用情况。
数据库管理系统提供了两个用于跟踪正在运行的清理进程的工具:
pg_stat_activity——用于跟踪数据库管理系统中全部活动的主要视图,其中也会显示清理进程;pg_stat_progress_vacuum——显示清理操作(包括手动清理和自动清理)的状态与执行进度的视图。
由于 pg_stat_activity 是通用视图,只以某种概括的形式显示数据库管理系统所有进程的活动,因此无法从中了解具体进程的特征。跟踪清理进程时应使用 pg_stat_progress_vacuum 视图:它包含更多关于清理本身的信息。此外,还可以合并两个视图,尽可能获取完整的信息。
pg_stat_activity 视图
前面的章节应该已经让你熟悉了 pg_stat_activity 视图,因此这里不再详细介绍,只列出我们关注的字段:
pid——执行清理操作的进程标识符;
backend_type——根据进程类型,可以筛选出属于自动清理进程的行。不过需要注意:通过这个字段无法找出在普通会话中使用VACUUM命令启动的清理;这类进程的backend_type值是client backend,与其他后端进程相同;datname——建立连接并执行清理的数据库名称;xact_start——事务开始时间,可用于确定清理的执行时长。这里还有一个细节:即使只清理一张表,也会执行多个事务,因此这个时间戳可能发生变化。可以使用backend_start,但自动清理工作进程在其生命周期内会处理许多表,因而无法单独确定处理某一张表所花的时间;state——进程状态;wait_event、wait_event_type——如果清理因某种原因暂停,等待事件可能很有用;query——查询文本是关键字段,可以据此只选出执行清理的进程,无论清理是自动执行的,还是管理员在单独会话中启动的。
必要时还可以加入其他字段。根据上面列出的字段设置过滤条件,可以排除其他进程,只选择执行清理的进程。从持续监控的角度看,我们可能关心以下问题:
当前正在运行多少个清理进程?这可以帮助判断是否已经达到工作进程数量的限制(由 autovacuum_max_workers 参数设置)。如果已经达到限制,同时又需要启动更多自动清理进程,表就必须排队等待处理,死行会继续积累,增加清理工作量。队列增长还会推迟其他表的处理,逐渐导致膨胀,并增大表和索引的大小。
清理持续了多长时间?理想情况下,只要资源允许,清理应当快速完成。数据库管理系统有空闲工作进程可用,就能避免表进入处理队列。对于混合负载的大型数据库(HTAP,即 Hybrid Transactional/Analytical Processing),这种情况尤其危险。这类数据库中既可能有很大的表,也可能有写入量很大的表。前者可能需要冻结;冻结要求完整读取整张表,可能耗费很长时间,而后者的变更会不断推动事务计数器向前。
在这种条件组合下(大型表清理持续时间长、写入活动频繁且清理工作进程不足),数据库管理系统将无法及时完成处理并推进事务计数器,最终可能紧急切换到只读模式。
要回答这些问题,只需使用 pg_stat_activity。在测试环境中很难捕捉到持续时间较长的清理,因此为了便于演示,我们先重写 pgbench_accounts 表:
在相邻会话中,使用 \watch 1 启动对 pg_stat_activity 的查询。更新 pgbench_accounts 的查询执行后约一分钟(因为 autovacuum_naptime = 1min),自动清理工作进程就会启动,并被对 pg_stat_activity 的查询捕捉到。
查询使用了针对查询文本的条件,要求文本以自动清理工作进程和单独会话中启动的清理所特有的模式开头。这种方法比根据 backend_type 设置条件更方便,因为后者无法筛选出普通会话中的清理。查询输出中的一行表示当前只启动了一个工作进程。使用 count 函数统计行数,就可以知道某一时刻启动了多少个清理工作进程,从而回答第一个问题,即正在运行的进程数量。duration 字段显示清理的执行时长,回答第二个问题,即清理持续了多久。查询中给出的状态和等待事件信息通常不会收集到监控中,主要只在排查和解决问题时使用。
可以将这些结果显示为图表。图 8.3 展示了清理进程数量。这里会产生一个合理的问题:为什么图中的数量与 pgbench_branches 和 pgbench_tellers 表实际执行的清理次数相差这么大?答案在于 pg_stat_activity 视图的特点:它显示的是当前快照,不是累计统计;两个快照之间发生的一切都不可见。要了解清理次数,最好使用图 8.1。
图 8.4 显示了在 pg_stat_activity 中捕捉到清理进程并记录其持续时间的时刻。数值仍然不多,但遗憾的是,数据库管理系统没有其他可以提取这类信息的视图。更完整、更准确的信息可以从活动日志中获得。设置 log_autovacuum_min_duration 参数后,每个执行时间超过指定值的自动清理进程的工作统计信息都会写入服务器日志。
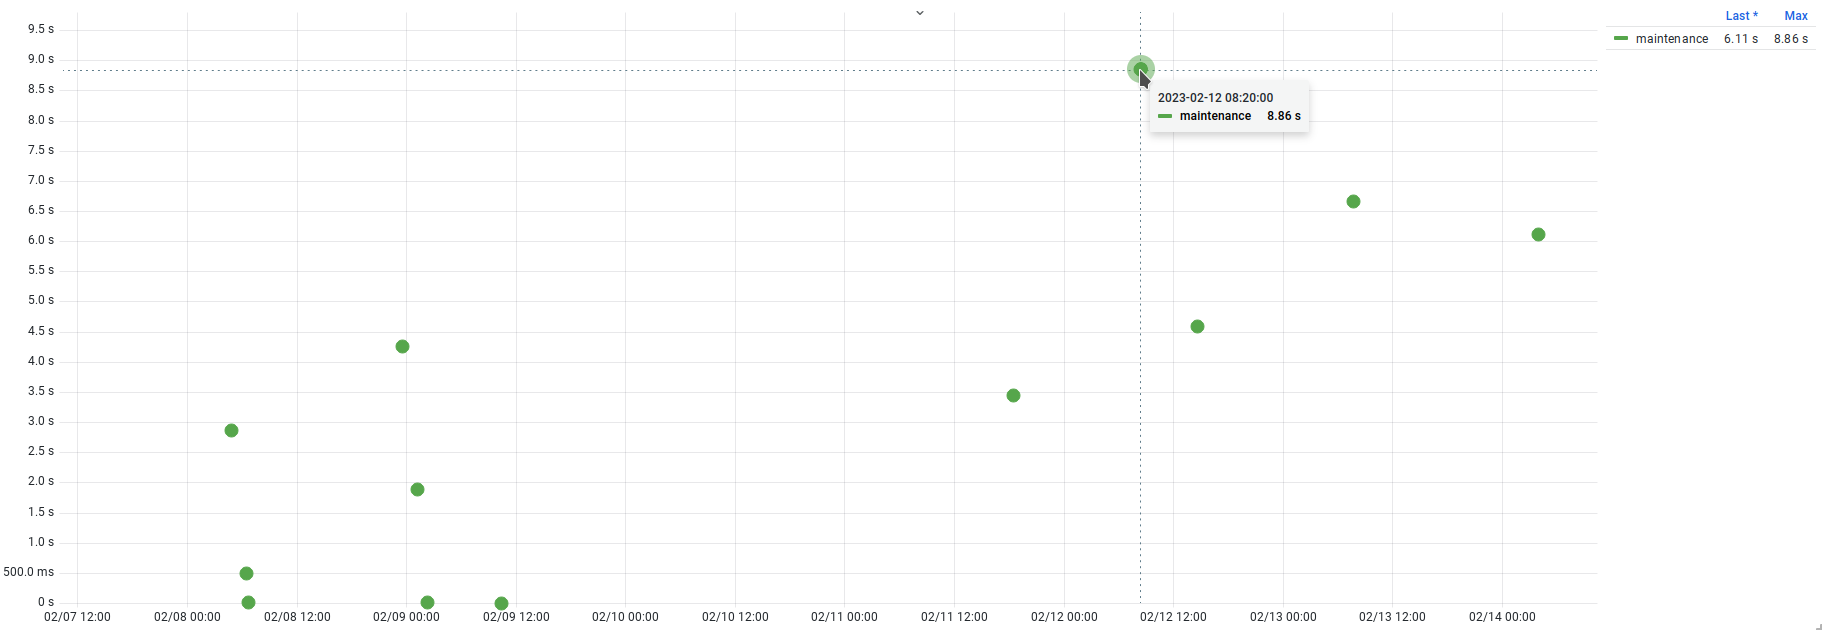
清理工作统计信息包含大量数据;如果分析较长时间段内的统计信息,肯定能得到一些有趣的观察和结论。在给出的示例中,我们关注最后一行,其中记录了清理耗时 53.38 秒。因此,通过分析日志流,可以跟踪所有执行时间超过 log_autovacuum_min_duration 的清理;与查询 pg_stat_activity 不同,这不需要依靠运气。不过,也不应滥用这一机制,过度降低 log_autovacuum_min_duration 的值,因为在活动量大且表很多的系统中可能执行大量清理,从而导致服务器日志产生大量写入。
pg_stat_progress_vacuum 视图
pg_stat_progress_vacuum 视图包含清理进程工作情况的详细信息,可以用来评估执行进度。视图中的每一行描述一个当前正在运行的进程。如果当前没有正在执行的清理,视图中也不会有任何行。
pid——操作系统中的进程标识符;datid、datname——已建立连接且当前正在其中清理表和索引的数据库的标识符和名称;relid——当前正在清理的表的标识符;phase——清理执行阶段:
— initializing——初始化并做好工作准备;
— scanning heap——扫描表,可能包括清理、页面碎片整理和冻结行;
— vacuuming indexes——处理索引;如果 autovacuum_work_mem 或 maintenance_work_mem 不足,可能执行多次;
— vacuuming heap——处理表。它与扫描的区别在于,每次处理索引后都会执行这一阶段(首先删除索引中指向行的指针,然后删除表中由这些指针标记的行版本);
— cleaning up indexes——最终处理索引,在完成表的完整扫描以及表和索引的清理后执行;
— truncating heap——截断表文件并释放空闲页面,以便将空间归还给操作系统;
— performing final cleanup——最终清理,更新空闲空间映射、更新 pg_class 中的统计信息等,并结束工作;
heap_blks_total——开始工作时表中的数据块总数;清理过程中新增的数据块不计入其中;heap_blks_scanned——已扫描的数据块总数。扫描经过优化,会使用可见性映射,部分数据块可以跳过检查;但是,被跳过的数据块也会计入该字段,最终heap_blks_scanned会等于heap_blks_total;heap_blks_vacuumed——已清除过时行版本的数据块总数。如果表没有索引,该计数器只会在vacuuming heap阶段增加。不包含死行的数据块会被跳过,因此该计数器可能会大幅跳增;
译注:heap_blks_vacuumed 的阶段条件
原文此处写作“如果表没有索引,该计数器只会在 vacuuming heap 阶段增加”。固定的 PostgreSQL 15 文档对应表述是“除非表没有索引,否则该计数器只会在 vacuuming heap 阶段增加”,也就是有索引时才受这一阶段条件限制;两者的条件相反。这里保留原书句子、字段名和示例代码,不把源文静默改写成 PostgreSQL 15 文档的表述。
index_vacuum_count——已完成的索引清理循环总数;max_dead_tuples——可以放入工作内存(autovacuum_work_mem、maintenance_work_mem)中的过时行版本指针数量。工作内存耗尽时,会执行一次索引清理循环;num_dead_tuples——自上一次索引清理循环完成以来,已收集到工作内存中的过时行版本指针数量。
未经处理的统计信息可能显得不够直观,也无法回答管理员提出的问题:当前正在处理哪张表?清理已经执行了多长时间、速度是多少?什么时候会结束?
输出中的标识符和数值以数据块为单位,不如通常使用的字节直观。为了便于理解,可以在查询中加入 pg_stat_activity 的信息,并将 pg_stat_progress_vacuum 的字段转换为更常见的形式:
现在,结果中已经给出了清晰的答案:
当前正在处理
pgbench_accounts表;当前表的处理已经持续了 52 秒;
当前正在执行处理数据块之间的常规暂停(
wait_event = Timeout.VacuumDelay);
mode = regular表示这是普通的自动清理(与维护事务计数器无关,也不是用户启动的清理);表的大小为 522 MB,包含索引在内为 608 MB;
scanned_pct = 100.0 %表示表已经完全扫描完毕,检查死行后正在直接执行清理(phase = vacuuming heap);vacuumed_pct = 45.7 %表示清理已经完成了将近一半;工作内存已经使用了 17.2%(
work_mem_usage),并且已经完成了一次索引处理循环(index_vacuum_count = 1)。
如果再次完整更新 pgbench_accounts 表,并在相邻会话中使用 \watch 1 启动查询,就可以直观看到清理的执行过程。不过,这类查询及其输出的统计信息更适合用于当前评估,将这类信息收集到监控中意义不大。
总结
并发访问机制允许同一行同时存在多个版本。
行的生命周期意味着会存在活行版本和死行版本。
必须定期清除死行版本。
表和索引都需要执行清理。
当死行版本数量超过某个阈值时,会执行自动清理。
清理会产生额外的输入/输出,并可能影响性能。
管理员需要跟踪数据库管理系统中的清理工作。
自动清理应当无延迟地启动。
自动清理维护事务计数器,并持续提供充足的可用事务 ID 余量。
管理员需要跟踪可用事务 ID 的余量。
在不利条件组合下,事务 ID 余量可能耗尽,导致数据库管理系统停止正常运行。
清理工作效率低下可能导致膨胀。
膨胀会造成磁盘空间使用效率低下,并降低性能。
使用
pgstattuple扩展评估膨胀程度。可以使用
pg_stat_activity和pg_stat_progress_vacuum视图跟踪正在运行的清理进程。
postgrespro.ru/docs/postgresql/current/sql-createtable#SQL-CREATETABLE-STORAGE-PARAMETERS ↩︎
postgrespro.ru/docs/postgresql/current/runtime-config-autovacuum#GUC-AUTOVACUUM-NAPTIME ↩︎
postgrespro.ru/docs/postgresql/current/sql-createtable#SQL-CREATETABLE-STORAGE-PARAMETERS ↩︎
postgrespro.ru/docs/postgresql/current/ddl-system-columns ↩︎
9 操作进度
本章将介绍:
跟踪命令执行的工具;
跟踪规划器统计信息的收集;
跟踪备份的执行进度;
跟踪
CLUSTER和VACUUM FULL命令的执行;跟踪
CREATE INDEX和REINDEX命令的执行;跟踪
COPY命令的执行。
本章将介绍一组专用的系统视图,它们用于指示各种命令的执行进度,而这些命令的运行时间可能较长。执行此类命令可能需要大量资源、造成负载(例如输入/输出子系统的负载)、与相邻进程竞争,甚至阻塞相邻进程。考虑到这些风险,管理员应提前规划此类操作,并准备能够跟踪其进度、估计何时完成的工具。本章讨论的所有工具都是视图,与 pg_stat_activity 和 pg_locks 类似,它们显示访问时刻的状态。这些统计信息主要用于运行过程中出现的特殊场景,也可以显示在 PostgreSQL 管理工具的用户界面中。它们不太适合在监控系统中积累和显示。
尽管可能运行很长时间的命令很多,但数据库管理系统只为其中一小部分提供了跟踪工具:
pg_stat_progress_vacuum—— 清理和自动清理操作的执行;pg_stat_progress_analyze—— 收集规划器统计信息的执行;pg_stat_progress_basebackup—— 备份操作的执行;pg_stat_progress_cluster—— 执行CLUSTER和VACUUM FULL命令;pg_stat_progress_create_index—— 执行CREATE INDEX和REINDEX命令;pg_stat_progress_copy—— 执行COPY命令。
pg_stat_progress_vacuum 视图已在专门介绍清理的 第 8 章中详细讨论,因此这里不再重复介绍。
所有这些视图都显示正在执行的命令;这些命令通常是在需要时手动启动的(自动清理除外)。数据库管理系统在后续版本中很可能会扩大对命令的支持,并增加新的类似视图。
9.1 pg_stat_progress_analyze 视图
执行查询时,数据库管理系统会采用规划器从众多可能的计划中选出的、从资源使用角度来看最优的执行计划。评估计划需要使用描述表中数据的统计信息,而所选计划的质量取决于这些统计信息的准确性。收集到的统计信息会反映在系统视图 pg_stats1 中,该视图基于表 pg_statistic2。在数据库管理系统运行过程中,数据的数量和质量特征可能会发生变化,而且规划器统计信息在 pg_statistics 中也不可避免地会过时。在数据不断变化的情况下,定期更新统计信息非常重要:否则,基于过时信息选择的计划会效率低下,导致资源使用过多并延长执行时间。
译注:pg_statistics 的名称
原书此处写作 pg_statistics,但同一段引用的 PostgreSQL 对象是 pg_stats 视图和 pg_statistic 系统表;PostgreSQL 15 文档中没有名为 pg_statistics 的同名标准对象。这里保留原书名称及链接,不把源文静默改写为另一个对象名。
统计信息通常由自动清理工作进程收集,但管理员也可以强制启动收集过程(使用 ANALYZE 命令3 或 VACUUM),然后等待它结束,或者估计它需要多长时间。
在以下各种情况下可能需要这样做:
从逻辑备份(使用 pg_dump 制作)恢复后,或者使用
COPY命令加载数据后,需要收集初始统计信息,因为此前根本不存在统计信息;修改了 default_statistics_target 参数4 后,该参数限制要分析和收集的数据量;
在使用
EXPLAIN5 开始深入研究某个查询的性能问题之前,可以先确认统计信息仍然是最新的;使用 pg_upgrade 工具6 升级数据库管理系统版本后,因为这种操作不会迁移规划器统计信息。
还可能有其他场景,但无论如何,统计信息收集过程可能持续很长时间,管理员应了解它还会运行多久。可以使用 pg_stat_progress_analyze 视图跟踪统计信息收集操作。视图中的每一行对应一个正在收集统计信息的进程,并包含以下字段:
pid—— 操作系统中的进程标识符;datid、datname—— 已建立连接的数据库的标识符和名称;relid—— 正在其中收集统计信息的表的标识符;phase—— 统计信息收集阶段:
— initializing —— 准备扫描表;
— acquiring sample rows —— 获取用于分析的随机行样本;
— acquiring inherited sample rows —— 从子表获取行样本;
— computing statistics —— 根据选出的行集计算统计信息;
— computing extended statistics —— 计算扩展统计信息;
— finalizing analyze —— 完成工作,更新 pg_class;
sample_blks_total—— 计算统计信息所需的随机样本中的块总数;sample_blks_scanned—— 已经扫描的块总数;ext_stats_total—— 扩展统计信息对象的数量;ext_stats_computed—— 已计算的扩展统计信息对象数量,仅在computing extended statistics阶段递增;child_tables_total—— 子表总数,用于分区表收集统计信息的情况;child_tables_done—— 已扫描的子表数量,仅在acquiring inherited sample rows阶段递增;current_child_table_relid—— 当前正在扫描的子表标识符;仅在acquiring inherited sample rows阶段包含当前值。
视图中的原始数据可能不够直观,因此为了提高信息量,可以做一些处理:将标识符转换成名称,将块转换成字节,并从 pg_stat_activity 获取额外信息,通过 pid 字段连接两个视图。
在测试环境中很难正好捕捉到自动收集统计信息的过程,因此可以在一个会话中使用 \watch 1 执行查询,再在另一个会话中启动 ANALYZE 命令。第一个会话中会出现类似下面的输出:
ANALYZE 命令已经执行了七秒;为了计算统计信息,需要获取 522 MB 的样本,目前已经扫描了 85%。在这个例子中,再过几秒扫描就会结束,然后进入统计信息计算阶段。对于包含分区表或扩展统计信息的复杂场景,还有其他字段提供更详细的信息。
9.2 pg_stat_progress_basebackup 视图
备份是生产数据库管理系统运行中的常规任务之一,根据数据库大小和硬件特征的不同,备份可能需要很长时间。使用 pg_basebackup 工具7 时,会完整复制数据文件和所需的 WAL 日志(传输它们时可能会启动额外的 walsender 进程)。这会给磁盘子系统造成很大负载,并可能减慢并发查询。如果资源不足并且性能受到负面影响,管理员需要了解备份已经运行了多久、还要多久才能结束。pg_basebackup 工具本身提供了跟踪功能(参数 -P、--progress),但也可以从数据库管理系统一侧使用 pg_stat_progress_basebackup 视图跟踪进度。
视图中的每一行对应一个备份进程,并包含以下信息:
pid—— 操作系统中的进程标识符;phase—— 备份阶段:
— initializing —— 准备备份;
— waiting for checkpoint to finish —— walsender 等待检查点完成;
— estimating backup size —— walsender 计算要传输的数据库文件大小;
— streaming database files —— walsender 传输数据;
— waiting for wal archiving to finish —— walsender 等待 WAL 日志段完成归档;
— transferring wal files —— walsender 传输备份过程中直接创建的 WAL 日志段;
backup_total—— 将要传输的数据总量。该值在备份前计算,是一个近似估计,因为复制过程中数据目录的内容可能发生变化。如果将要传输的数据开始超过计算出的值,该字段会设置为backup_streamed。如果 pg_basebackup 禁用了估算(参数--no-estimate-size),该值将不存在(NULL);backup_streamed—— 已传输的数据量,仅在streaming database files和transferring wal files阶段递增;tablespaces_total—— 将要传输的表空间总数;tablespaces_streamed—— 已传输的表空间数量,仅在streaming database files阶段递增。
要看到任何结果,可以在相邻终端启动备份,并使用 \watch 1 执行下面的查询。由于得到的备份不会被使用,可以将其输出重定向到 /dev/null:
备份执行期间,查询 pg_stat_progress_basebackup 的会话中会显示其执行进度:
从这段输出可以看出,备份已经运行了三十多秒,数据库内容的大部分已经发送给客户端,备份已经完成 87%,很快就会结束。从 pg_stat_activity 视图中取出了 state 字段和等待标记;由于进程正在复制数据文件且不使用锁,这个标记大多数情况下会显示输入/输出等待。
9.3 pg_stat_progress_cluster 视图
CLUSTER8 和 VACUUM FULL9 命令用于重建表。它们会消耗大量资源,并设置排他锁,禁止访问正在处理的表。如果使用不当,这些命令很容易在自身完成前持续阻塞应用程序,因此管理员需要能够跟踪其执行进度的工具。数据库管理系统提供了 pg_stat_progress_cluster 视图,其中每一行包含一个操作的信息,字段如下:
pid—— 操作系统中的进程标识符;datid、datname—— 执行操作的数据库的标识符和名称;relid—— 正在重建的表的标识符;command—— 正在执行的命令,可以是CLUSTER或VACUUM FULL;phase—— 操作阶段:
— initializing —— 准备扫描表;
— seq scanning heap —— 顺序扫描表;
— index scanning heap —— CLUSTER 命令对表执行索引扫描;
— sorting tuples —— CLUSTER 命令对行进行排序;
— writing new heap —— 将数据写入新的表文件;
— swapping relation files —— 用新文件替换旧文件;
— rebuilding index —— 重建索引;
— performing final cleanup —— 清理并完成工作;
cluster_index_relid——CLUSTER命令使用的索引标识符;heap_tuples_scanned—— 表中已扫描行的总数,仅在顺序扫描、索引扫描和写入新表阶段变化;heap_tuples_written—— 表中已写入行的总数,仅在顺序扫描、索引扫描和写入新表阶段变化;heap_blks_total—— 开始顺序扫描表时表中的块总数;heap_blks_scanned—— 已扫描块的总数,仅在顺序扫描表阶段变化;index_rebuild_count—— 已重建索引的总数,仅在重建索引阶段变化。
根据这些字段,可以很容易地了解命令执行所处的阶段,并估计执行进度。为了获得更多信息,也可以将该视图与 pg_stat_activity 连接起来并做一些处理。
为了让查询得到有意义的结果,需要在相邻终端启动 CLUSTER 或 VACUUM FULL 命令:
此时,在查询 pg_stat_progress_cluster 的会话中可以看到下面的输出:
在这个例子中,VACUUM FULL 命令已经运行了六秒,完成了 70%,但还有 33 个会话在等待它结束;这些会话正在查询被重建的表。因此,执行这些查询的应用程序也被阻塞,被迫等待该命令完成。
9.4 pg_stat_progress_create_index 视图
在应用程序积极开发、应用中出现新类型查询时,创建索引可能是很常见的操作。创建索引,尤其是为大表创建索引,可能需要很长时间、消耗大量资源,并影响并发查询的性能。
可以使用 pg_stat_progress_create_index 视图跟踪这一过程,视图中的每一行描述一个正在构建索引的进程:
pid—— 操作系统中的进程标识符;datid、datname—— 执行操作的数据库的标识符和名称;relid—— 索引所属表的标识符;index_relid—— 正在对其执行操作的索引标识符;command—— 正在执行的命令:CREATE INDEX、CREATE INDEX CONCURRENTLY、REINDEX或REINDEX CONCURRENTLY;phase—— 操作阶段:
— initializing —— 准备工作;
— waiting for writers before build —— CREATE INDEX CONCURRENTLY 或 REINDEX CONCURRENTLY 命令等待持有写锁且可能正在读取该表的事务结束。在阻塞模式下执行操作时会跳过此阶段。可以通过 lockers_total、lockers_done 和 current_locker_pid 跟踪此阶段的详细执行情况;
— building index —— 支持跟踪的访问方法会报告自身的状态。可以通过 blocks_total 和 blocks_done 字段跟踪索引构建的详细情况,但 tuples_total 和 tuples_done 的值也可能发生变化;
— waiting for writers before validation —— CREATE INDEX CONCURRENTLY 或 REINDEX CONCURRENTLY 命令等待持有写锁、并且可能正在向表写入的事务结束。在阻塞模式下执行操作时会跳过此阶段。可以通过 lockers_total、lockers_done 和 current_locker_pid 跟踪此阶段的详细执行情况;
— index validation: scanning index —— CREATE INDEX CONCURRENTLY 命令扫描索引,查找需要检查的行。在阻塞模式下执行操作时会跳过此阶段。阶段的详细进度反映在 blocks_total 和 blocks_done 字段中;
— index validation: sorting tuples —— CREATE INDEX CONCURRENTLY 命令对扫描阶段找到的行进行排序;
— index validation: scanning table —— CREATE INDEX CONCURRENTLY 命令扫描表,以检查前两个阶段收集的索引行。在阻塞模式下执行操作时会跳过此阶段。阶段的详细进度反映在 blocks_total 和 blocks_done 中; — waiting for old snapshots —— CREATE INDEX CONCURRENTLY 或 REINDEX CONCURRENTLY 命令等待可能看到表内容的事务释放快照。在阻塞模式下执行操作时会跳过此阶段。详细进度反映在 lockers_total、lockers_done 和 current_locker_pid 中;
— waiting for readers before marking dead —— 在将旧索引标记为不可用之前,REINDEX CONCURRENTLY 命令等待持有读锁的事务结束。在阻塞模式下执行操作时会跳过此阶段。详细进度反映在 lockers_total、lockers_done 和 current_locker_pid 中;
— waiting for readers before dropping —— 在删除旧索引之前,REINDEX CONCURRENTLY 命令等待持有读锁的事务结束。在阻塞模式下执行操作时会跳过此阶段。详细进度反映在 lockers_total、lockers_done 和 current_locker_pid 中;
lockers_total—— 必须等待的进程数量;lockers_done—— 已经等待结束的进程数量;current_locker_pid—— 当前持有锁的进程标识符;blocks_total (tuples_total)—— 此阶段需要处理的块(行)总数;blocks_done (tuples_done)—— 此阶段已经处理的块(行)总数;partitions_total—— 必须创建索引的分区总数(处理分区表时);partitions_done—— 已经完成索引创建的分区总数(处理分区表时)。
该视图非常详细地显示了索引构建进度。特别要注意,表示块和行的值对应于单独的阶段,而不是整个过程。
为了得到查询结果,需要在相邻会话中启动索引重建:
在查询 pg_stat_progress_create_index 的会话中可以看到类似下面的输出。由此可知,索引重建正处于扫描表阶段,该阶段已经完成 75%。随后将开始加载行的阶段,其进度可以通过 tuples_done,% 字段跟踪。
9.5 pg_stat_progress_copy 视图
pg_stat_progress_copy 视图用于跟踪 COPY 命令10,这些命令用于加载和导出数据,也包括使用 pg_dump 和 pg_restore 工具的情况。
在数据量较大而资源不足时,该命令可能持续很长时间,并影响并发查询的性能。
视图中的每一行描述一个命令的执行情况,并包含以下信息:
pid—— 操作系统中的进程标识符;datid、datname—— 已建立连接的数据库的标识符和名称;relid—— 正在操作的表的标识符;command—— 正在执行的命令,可以是COPY TO或COPY FROM;type—— 处理数据时使用的输入/输出方法:FILE、PROGRAM、PIPE(用于COPY FROM STDIN和COPY TO STDOUT),或者逻辑复制初始同步表时的CALLBACK;bytes_processed—— 命令处理的字节总数;bytes_total—— 执行COPY FROM时源文件的字节大小。如果无法确定大小,该值可能为零;tuples_processed——COPY命令处理的行总数;tuples_excluded—— 被指定的WHERE条件丢弃的行总数。
为了获得更多信息,应将该视图与 pg_stat_activity 连接起来,通过调用 pg_relation_size 添加表大小,并采用只适用于 COPY 命令的进度估算方法。
COPY 命令有两种工作模式:加载(COPY FROM)和导出(COPY TO);在输出中,为了便于理解,工作模式与数据源类型合并显示。已完成工作的估算(done,% 字段)也会同时考虑这两种模式。
对于加载,可以只使用视图自身的字段进行估算:bytes_total 表示要加载的源文件大小,bytes_processed 表示 COPY 命令已经读取的字节数。因此,完成百分比就是已读取数据量与总数据量的比值。
导出的估算稍微复杂一些:数据库管理系统中的数据表示方式不同于导出格式(更不用说数据库中的数据也可能以不同方式压缩,而且导出格式不止一种),因此最终文件的大小会与原表完全不同。在示例查询中,估算值是已处理行数 tuples_processed 与从 pg_class.reltuples 字段取得的表总行数之比。不过,这种方法也有一个缺点:pg_class.reltuples 会在清理后更新,如果清理已经很久没有执行,该值就会与实际情况不符,估算也会不准确。但经验表明,这种估算仍然比根据 bytes_processed 和表大小进行的估算更准确。
应当在一个会话中使用元命令 \watch 1 查询 pg_stat_progress_copy,再在另一个会话中启动 COPY 或 pg_dump:
在查询 pg_stat_progress_copy 的会话中可以看到大致如下的输出:
在这个例子中,表 pgbench_accounts 使用 COPY TO 通过管道导出到标准输出(stdout)。导出已经运行了 18 秒,完成了 87%。此外,输出中还给出了进程状态的附加信息。
总结
数据库管理系统只提供了有限的一组视图,用于跟踪长时间运行的命令。
进度跟踪视图不积累统计信息,而是显示进程的当前状态。
pg_stat_progress_vacuum用于跟踪清理操作。pg_stat_progress_analyze用于跟踪规划器所需统计信息的收集。pg_stat_progress_basebackup用于跟踪备份。pg_stat_progress_cluster用于跟踪CLUSTER和VACUUM FULL命令。pg_stat_progress_create_index用于跟踪CREATE INDEX和REINDEX命令。pg_stat_progress_copy用于跟踪COPY命令。将这些视图与
pg_stat_activity和pg_locks连接起来,可以提高信息量。
附录:测试环境
本附录介绍测试环境的启动和使用方法。理解本书并不一定需要这个环境,但在阅读过程中使用它可能会很有帮助。利用该环境可以重现书中给出的所有示例,也可以进行各种与监控相关的实验。
基本信息
该环境基于 Docker 容器构建,包含以下组件:
两节点 PostgreSQL 流复制集群。该集群用于演示复制监控工具和方法。
pgSCV 指标导出器。这是一个从 PostgreSQL 节点收集统计信息并以 Prometheus 格式提供这些信息的监控代理。该监控代理属于实验性产品,不建议用于生产环境。
基于 Victoriametrics 和 Vmagent 的监控系统。该监控系统从 pgSCV 代理收集指标,并将其保存两天。
基于 pgbench 工具、用于产生工作负载的应用。环境中运行着多个 pgbench 实例,它们的任务是持续为 PostgreSQL 集群生成动态负载。
Grafana 可视化系统。它作为监控系统的前端,可以创建各种高度可配置的图表。
依赖项
请确认运行测试环境的系统中已经安装以下工具:
Docker-compose,版本 ⩾ 1.29.2;
Docker Engine,版本 ⩾ 20.10.12;
GNU Make,版本 ⩾ 4.2.1。
不保证测试环境能够在更早版本上运行。
可以按照官方说明安装 docker-compose,说明地址为 docs.docker.com/compose/install/。Docker Engine 也应按照官方说明安装:docs.docker.com/engine/install/#server。GNU Make 软件包可以使用软件包管理器,从适用于操作系统的官方软件包仓库中安装。
安装好所有依赖项后,就可以启动环境了。
启动环境
可以通过 Makefile 使用基本命令,但用户也可以直接调用 docker 和 docker-compose 工具来执行其他命令。
执行以下命令进入测试环境目录,然后查看可用 make 目标的帮助:
make 目标提供了启动和停止测试环境、连接容器中服务的简便方式,后续操作会用到这些目标。执行目标时,第一行会输出实际执行的命令,因此无需使用 Makefile,也可以直接执行该命令。
启动测试应用:
首次启动时会构建容器、初始化服务,并将数据加载到测试数据库(约 300 MB)。这一过程可能需要一段时间,具体取决于设备的性能。
基本可用性检查
初始化完成后,应检查环境是否已经准备就绪。首先需要了解容器和服务的总体状态:
所有容器的 STATUS 字段都应为 running。两个数据库服务都应显示已准备好接受客户端连接,两个节点之间的复制也应正常工作。可以这样检查主节点的服务器日志:
备用节点也可以用类似的方法检查:
现在启动连接到集群主节点的会话,作为可用性检查:
在打开的会话中,可以向服务器发送 SQL 查询:
查询结果会以表格形式显示。在读完本书之前,不必理解这些查询及其结果的含义;统计信息就是这样使用的:针对所需视图编写 SQL 查询,将其发送给服务器,然后以表格形式得到结果,其中包含若干行(有时一行也没有)。
除非特别说明,书中的所有查询都在主节点上执行。
Grafana
Grafana 前端的地址是 127.0.0.1:3000。登录时不需要用户名和密码。要创建图表,可以使用 Explore 模式,也可以创建一个单独的面板集合,并在其中添加图表面板。
停止和删除
要停止测试环境,请执行以下命令:
如果不再需要测试环境,可以停止它并删除所有相关组件:
主题索引
A
address 42
archive_timeout 168
atop 29
autovacuum_max_workers 214
autovacuum_vacuum_scale_factor 198
autovacuum_vacuum_threshold 198
B
C
D
E
F
G
H
I
iostat 30
K
L
LISTEN 138
log_directory 126
logging_collector 126
logical replication worker 187
log_lock_waits 68
log_min_duration_statement 56
log_statement 56
M
N
O
P
pg_activity 24
pg_authid 117
pg_backend_memory_contexts 136
pg_backend_pid 64
pgbench_accounts 135, 143, 166, 200, 204, 208, 211–212, 215, 219–220, 233
pgbench_history 143
pg_blocking_pids 66
pgcompacttable 213
pg_current_wal_flush_lsn 160
pg_current_wal_insert_lsn 160
pg_filenode_relation 123
pg_get_userbyid 75
pg_global 102
pg_is_in_recovery 182
pg_last_wal_receive_lsn 182
pg_last_wal_replay_lsn 182
pg_lock_status 36
pg_lsn 178
pg_namespace 104
pg_prepared_xacts 206
pg_read_binary_file 125
pg_read_server_files 117
pg_relation 105
pg_relation_filenode 123
pg_repack 213
pg_restore 231
pgSCV 235
pg_size_bytes 118
pg_size_pretty 118
pg_squeeze 213
pg_stat_activity 31–32, 34–40, 50–51, 58–60, 64–66, 91, 133, 177, 213, 215–217, 219, 221, 223, 226–227, 232
pg_stat_all_indexes 110
pg_stat_bgwriter 150
pg_stat_database 31, 37, 39–40, 44–47, 107, 110, 112, 114, 139, 143–149
pg_stat_file 125
pg_stat_get_activity 32
pg_stat_get_autovacuum_count 200
pg_statio_all_sequences 139
pg_statistic 222
pg_statistics 222
pg_stat_monitor 72
pg_stat_slru 138
pg_stat_statements 34, 46, 72–76, 79–80, 86, 91–97, 141, 143–149, 161–162, 165–166
blks_dirtied 141
blks_written 141
local_blks_dirtied 144
local_blks_hit 144
local_blks_read 144
local_blks_written 144
max_exec_time 79
max_plan_time 77
mean_exec_time 79
mean_plan_time 77
min_exec_time 79
min_plan_time 77
rows 79
shared_blks_dirtied 144
shared_blks_hit 143
shared_blks_read 144
shared_blks_written 144
stddev_exec_time 79
stddev_plan_time 77
temp_blks_read 147
temp_blks_written 147
total_rows 83
total_time 79
userid 75
wal_bytes 165
wal_fpi 165
wal_records 165
pg_stat_statements_reset 74
pg_stat_statements.save 74
pg_stat_statements.track_planning 74
pg_stat_statements.track_utility 74
pg_stat_sys_indexes 110
pg_tables 104
pg_tablespace_location 118
pg_upgrade 222
pg_user 75
pg_walfile_name 160
pidstat 30
postgres_activity_connections_in_flight 54
postgres_activity_max_seconds 60
postgres_checkpoints_seconds_total 153
postgres_connected_clients_total 42
postgres_database_checksum_failures_total 115
postgres_database_conflicts_total 115
postgres_database_deadlocks_total 115
postgres_database_sessions_total 115
postgres_database_size_bytes 121
postgres_database_temp_bytes_total 146
postgres_database_tuples_deleted_total 108
postgres_database_tuples_fetched_total 108
postgres_database_tuples_inserted_total 108
postgres_database_tuples_returned_total 108
postgres_database_tuples_updated_total 108
postgres_database_xact_rollbacks_total 115
postgres_fdw 103
postgres_index_size_bytes 121
postgres_service_settings_info 42
postgres_shared_buffers_all_usage_bytes 135
postgres_statements_calls_total 80
postgres_statements_query_info 77
postgres_statements_time_seconds_total 77
postgres_table_idx_tup_fetch_total 113
postgres_table_seq_tup_read_total 113
postgres_table_size_bytes 121
postgres_table_tuples_deleted_total 113
postgres_table_tuples_hot_updated_total 113
postgres_table_tuples_inserted_total 113
postgres_table_tuples_updated_total 113
Prometheus 235
ps 29
public 103
Q
R
S
T
text 125
TOAST 106
top 29
topk_avg 78
track_activity_query_size 34
track_commit_timestamp 137
track_functions 95
track_utility 46
track_wal_io_timing 162
U
V
vacuum_failsafe_age 209
vacuum_freeze_min_age 204
vacuum_freeze_table_age 204
Victoriametrics 235
Vmagent 235
vmstat 30
W
А
Б
- 输入/输出 139
块,参见 页面
В
Г
Ж
З
И
- 多余访问 110
К
Л
- 时间线 159
М
Н
О
关系 105
П
Р
С
Т
Ф
Э
- 实例 100
出版信息
生产实践类出版物
Лесовский Алексей Викторович
PostgreSQL 监控
由 Postgres Professional 提供支持
postgrespro.ru
| 责任编辑 | Ю. В. Семенова |
| 编辑 | Е. В. Рогов |
| 校对 | О. Е. Шишмаренкова |
| 封面设计 | М. М. Гранько |
2023 年 12 月 25 日付印。
开本 。胶版纸。胶印。
字体:ПТ(Паратайп)和 Iosevka(Renzhi Li)。
印张 15.5。印数 1000 册。
ООО «Бумба»
108811,莫斯科,莫斯科市内自治辖区“莫斯科”定居点,
基辅公路 22 千米,4 号地块,5 号建筑
电话:+7 (977) 586-38-56
电子邮箱:info@boombabook.ru
www.boombabook.ru
由 АО «Первая Образцовая Типография» 旗下“Чеховский Печатный Двор”分部印刷。
142300,莫斯科州契诃夫市,Полиграфистов 街 1 号
电话:+7 (495) 107-02-68
www.chpd.ru
订单号:
信息产品标识 12+
(2010 年 12 月 29 日第 436-ФЗ 号联邦法律)