8 清理
本章将讨论:
什么是清理以及为什么需要清理;
活行和死行;
自动清理后台进程;
在什么条件下以及多久执行一次清理;
如何查看等待处理的表队列;
事务计数器以及防止与其回卷相关的错误;
事务界限;
如何确定可用事务 ID 的数量;
膨胀现象;
如何确定表和索引的膨胀程度;
跟踪正在运行的清理进程的方法。
前几章介绍了数据库管理系统的一些后台进程,本章继续介绍这类进程。本章讨论清理过程,即通常所说的 vacuum。下文使用“清理”一词时,既包括手动清理,也包括自动清理;在自动清理的语境中使用“自动清理”这一术语。
清理是垃圾收集器(garbage collector)的一种实现,也是数据库管理系统的重要组成部分。清理是否高效会直接影响性能。本章将介绍清理机制、需要跟踪的工作特征,以及数据库管理系统为监控清理提供的工具。
8.1. 清理简介
为了在高负载下保证客户端并发工作的高性能,PostgreSQL 实现了 MVCC1(多版本并发控制,Multiversion Concurrency Control)模型。该模型尽量减少锁的数量,使读进程不会阻塞写进程,写进程也不会阻塞读进程。
执行查询和事务时,数据库管理系统使用快照(snapshot)。快照确定事务可见的数据状态,只包含快照创建时已经提交的变更;快照的创建时刻取决于事务设置的隔离级别(isolation level)。事务(以及查询)的并发执行意味着系统中会同时存在多个快照,而这些快照既可以用于读取数据,也可以用于修改数据。
在 PostgreSQL 的 MVCC 模型中,行不会原地修改(in-place);相反,各种操作会处理行版本:
INSERT操作插入新行的第一个版本;UPDATE操作插入行的新版本,并将旧版本标记为已删除;DELETE操作将行版本标记为已删除。
因此,同一行可能存在多个版本:一个当前版本,也就是活行(live),以及可能存在的多个死行(dead)。标记为已删除的行会继续在原来的页面和数据文件中保存一段时间,因为其他活动事务可能仍然需要它们(也就是说,这些行版本仍属于这些事务使用的快照)。在写入活动很高的情况下,标记为已删除的行版本会不断增加,从而影响表和索引的大小。随着事务逐步结束,死行最终不再被任何事务需要,此时可以安全地删除它们,为新行释放空间。有关 MVCC 机制工作方式的更多信息,参见《The Internals of PostgreSQL》的相应章节2。
死行版本逐渐变得不再需要,但仍会占用页面空间,造成我们希望避免的多余输入/输出操作和资源消耗。因此,数据库管理系统需要删除那些已经过时且不再被任何人需要的行版本,这正是清理所负责的工作。在 PostgreSQL 的早期版本中,清理通过单独的 VACUUM 命令实现,管理员必须手动执行该命令,或借助外部任务调度器(通常是 cron)执行。除了清理之外,VACUUM 命令还具有一些附加功能,例如收集规划器统计信息、执行完全阻塞式清理、冻结行等。有关清理命令工作方式的更多信息,参见文档3。后来,数据库管理系统又实现了自动清理版本,由按需启动的后台进程执行。
第一个自动清理进程 autovacuum launcher 维护数据库列表,并决定何时在具体数据库中启动清理。需要清理时,autovacuum launcher 向主进程 postmaster 发送信号,后者随即启动自动清理工作进程 autovacuum worker。清理工作进程获取目标数据库的名称,连接到该数据库,并建立待处理表的列表。它依次处理列表中的表,扫描其中不再被任何活动事务需要的过时行版本,并同时为表和索引释放空间。释放出的空间可以用于插入新行。如果清理在表文件末尾形成了空闲空间,清理还可以截去末尾的空页面(truncate heap),从而减小表文件。
在某些工作负载下,表和索引中只有相对较少的活行,其余空间虽然已经释放,却没有被使用。如果这些空闲空间在物理上分布于文件的不同位置,清理就无法释放这些区域并缩小文件。这样的区域形成并逐渐增大的过程称为膨胀(bloat)。在最轻微的情况下,膨胀效应只会导致空间被白白占用;在最严重的情况下,则会因为多余的输入/输出操作、缓冲区缓存不足,以及索引层级增加导致索引访问效率下降而降低性能。因此,在运行数据库管理系统时,需要跟踪表和索引的过度膨胀并减少这种膨胀。
概括来说,从运维角度看,数据库管理员应跟踪自动清理的工作效率、它产生的负载,以及表中死行所占的比例,并在必要时调整清理设置、减少已经形成的膨胀。
随着现代存储系统性能提高,跟踪清理负载的重要性已经大幅降低。过去在 HDD 磁盘时代,这项工作很重要,因为清理可能显著影响查询性能;现在使用 SSD 和 NVMe 介质时,这种负面影响已经大幅减小,甚至基本消失。
8.2. 清理的实际特点
为了了解清理工作中究竟应该跟踪什么,下面来看它在实践中的一些特点。清理只会在特定事件发生后启动,理想情况下不应延迟。但如果清理发生延迟,就需要了解已经积累了多少工作。
自动清理何时执行?
当表中的死行数量超过某个允许值时,自动清理就会处理该表。过时行版本由更新和删除操作产生;执行这些操作时,系统会持续跟踪过时行版本的数量,一旦超过允许值,就会将表加入待处理列表。允许值根据以下信息计算:
pg_class.reltuples——根据最近一次清理得到的表中总行数;pg_stat_all_tables.n_dead_tup——死行总数,在更新和删除操作期间更新;autovacuum_vacuum_threshold——确定基础阈值的参数,即表中触发清理所需的最少死行数(默认 50 行);
autovacuum_vacuum_scale_factor——确定表中总行数比例的参数,该比例用于增加基础阈值 autovacuum_vacuum_threshold(默认值为 0.2,即
pg_class.reltuples的 20%)。
按默认值计算,表中的死行数量必须超过 50 行加总行数的 20%,自动清理才会触发。参数 autovacuum_vacuum_scale_factor = 0.2 常被认为较为保守;在现代配置中通常会指定 0.01 到 0.05 范围内的更小值,从而更频繁地触发自动清理,并在死行数量少得多时就开始清理。对于非常大的表(以及很大的索引),即使 autovacuum_vacuum_scale_factor 较小,换算成行数后也可能很大,工作内存可能不足以容纳全部死行指针。这会显著增加清理成本,因为系统不得不多次完整扫描并清理索引。在这种情况下,可以通过存储参数4为单独的表设置清理参数。
现在已经知道自动清理的触发条件,可以编写查询,找出死行数量超过允许值的表。该查询输出用户表及其一些统计信息:
relation——表名;如有需要,也可以同时输出模式名;reltuples——表中行数的近似值。每次执行自动清理、VACUUM、ANALYZE以及某些 DDL 命令(例如CREATE INDEX)后,该值都会更新;live_tup——表中的活行数;dead_tup——表中过时的死行数;boundary——允许的死行版本数。当死行版本数超过该值时,表就应由自动清理处理;av_cnt——表上已执行的自动清理操作总次数;since_last_av——距离上次自动清理执行已经过去的时间;
av_need——表示死行版本数超过允许值、表需要处理的标志;dead_ratio——死行版本数占表中总行数的百分比。
根据查询结果,可以观察到几点:
有两张表(
pgbench_tellers和pgbench_branches)需要清理:其中的死行版本数大幅超过允许值,av_need = t这一标志说明了这一点;av_cnt和since_last_av的值表明,这两张表会定期清理,但在当前工作负载下,下一次清理启动前,表中仍会积累大量死行版本(参见dead_ratio);要评估
since_last_av的值,需要知道参数 autovacuum_naptime5 的值(默认一分钟)。该参数确定autovacuum launcher 向每个数据库发送信号、启动清理工作进程的间隔。查询输出中有两张表带有需要清理的标志。这两张表的since_last_av值都在一分钟以内,说明虽然表需要处理,但没有发生延迟。反过来,如果表带有清理标志,而since_last_av的值超过 autovacuum_naptime,就说明清理发生了延迟;有一张表包含大量行,但从未被处理过(
pgbench_accounts),因为其中的死行数量从未达到阈值。
可以得出结论:测试环境中的表不多,自动清理能够完成自己的工作。
还需要说明允许值(boundary)是如何计算的。计算以全局配置参数为基础,但数据库管理系统允许通过所谓的存储参数(storage parameter)6为单独的表指定这些参数。表级存储参数的优先级高于全局配置参数,计算阈值时应将其考虑在内。测试环境中的表没有显式设置存储参数,因此查询没有考虑它们。
清理执行统计
前面查询使用了函数 pg_stat_get_autovacuum_count,该函数返回表被自动清理处理的次数。这个函数以及其他几个类似函数都被 pg_stat_all_tables 视图使用,pg_stat_user_tables 和 pg_stat_sys_tables 视图也建立在该视图之上。借助这些函数,相关视图会显示多个字段,用于表示自动清理和手动清理的工作情况:
last_vacuum——表上一次由VACUUM命令清理的时间;last_autovacuum——表上一次由自动清理处理的时间;vacuum_count——表由VACUUM命令处理的总次数;autovacuum_count——表由自动清理处理的总次数。
收集规划器统计信息
规划器统计信息收集操作也有一组类似字段。统计信息既可以通过调用 ANALYZE 命令收集,也可以在调用 VACUUM 命令时指定 ANALYZE 参数,将其作为附加操作收集,或者由自动清理工作进程收集。
下面的查询可以跟踪清理的规律性:
查询输出同时反映了手动清理和自动清理的统计信息。清理的主要工作由自动清理完成,VACUUM 命令只偶尔执行(这是工作负载的特征)。
汇总所有数据库中的清理操作执行统计信息,可以得到整个实例的总体情况,并将其显示在监控中(图 8.1):
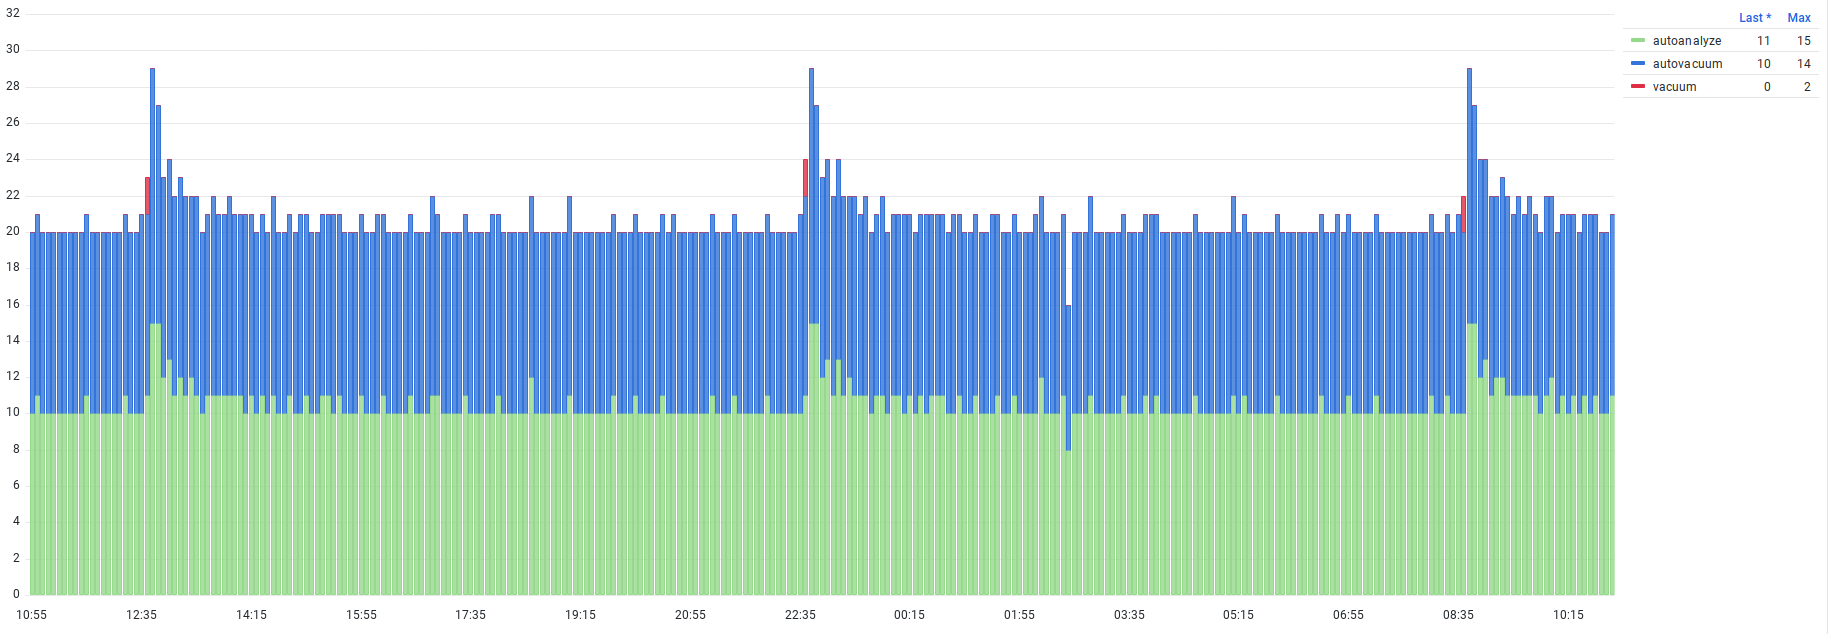
图 8.1 显示了五分钟内执行的清理和分析操作数量。在图示的一天内,操作数量保持在相对稳定的水平,没有明显波动,但可以看到约每 10 小时出现一次的周期性。如果调整自动清理设置,这张图可以帮助了解所做修改对自动清理工作的影响。工作负载发生显著变化,尤其是写入量变化时,也可能影响维护操作的执行频率,这些变化的后果同样会在图中体现出来。
8.3. 事务计数器及防止其回卷导致的错误
每个事务,即使只是一个单独的命令,也有唯一的标识符。它可以是虚拟事务标识符(virtualxid);如果事务修改数据,则会分配一个持久的 32 位标识符(transaction ID、xid 或 txid)。执行修改数据的命令(插入、更新、删除)时,行版本的系统字段 xmin 和 xmax7 中会记录事务标识符:xmin 记录创建该行的事务,xmax 记录删除该行的事务。行的可见性规则以此信息为依据。例如,刚由已提交事务创建的行版本不会出现在已经开始的查询中,因为该版本的 xmin 会大于查询中可见的最大编号8。
在持续负载下,数据库管理系统会不断分配新的事务 ID。事务 ID 的范围受 32 位限制,对应从 0 到 的值(约 42 亿)。这意味着在某个时刻,编号范围可能耗尽,事务计数器必须从零重新开始。但这样一来,过去事务创建的所有行都会落入未来,因为它们的标识符将超过当前计数器的值。这会导致所有数据突然丢失:数据虽然仍物理保留在页面中,却不再符合可见性规则,因而无法访问。为避免这种情况,事务 ID 范围会回卷并形成一个分成两部分的环:对于任意一个 ID,接下来的 20 亿个 ID 被视为比它“更老”、处于未来,而前面的 20 亿个 ID 被视为比它“更年轻”、处于过去。一项事务创建的行,在接下来的 20 亿个事务中处于过去;但如果不采取措施,对于再往后的事务它就会处于未来。因此,在达到 20 亿这个界限之前,数据库管理系统就会找出这些旧行并为它们设置冻结标记。根据可见性规则,冻结(frozen)行被视为极其古老,因此不再需要检查它们的 xmin 值。这些行无条件可见,直到它们被更新或删除;更新或删除会设置 xmax 值。
译注:事务 ID 范围公式
原文在这里保留公式 ,同时将范围描述为约 42 亿;这两种表述存在数学疑义,后者更接近 的数量级。本译文保留原公式和原文论证,不静默改写。原文随后用“更老/更年轻”描述回卷 ID 的两侧;这里保留该称呼,但“处于过去/未来”应以可见性规则为准,不能把这些相对称呼直接理解成自然时间顺序。
FrozenTransactionId
在 PostgreSQL 9.4 之前的版本中,行冻结通过将行的 xmin 替换为系统标识符 FrozenTransactionId(值为 2)实现。在后续版本中,冻结标志作为位标志设置在另一个系统字段中,而行的 xmin 得以保留。
单独一行是否需要冻结,由其 xmin 标识的事务年龄决定。事务年龄是指该事务之后直到当前时刻,在系统中启动的事务数量。冻结年龄较小的行可能并不划算,因为行可能随后发生变化,已经完成的工作就会白费。冻结也不能长期推迟:在高强度工作负载下,可能积累大量未冻结的行,处理它们需要大量资源和时间。冻结通常由清理工作进程自动执行(也可以手动执行 VACUUM FREEZE),因此,为了及时冻结行,自动清理也必须及时启动且不能延迟。根据数据库管理系统的配置或工作负载,可能出现推迟自动清理甚至妨碍自动清理的情况。长期忽略这些情况会降低性能,最糟糕时还可能导致数据库管理系统异常停止。以下情况都可能推迟清理:
在全局配置中关闭自动清理(autovacuum
= off),或通过存储参数在单独的表级别关闭自动清理;长事务(这是自动清理推迟删除过时行版本的最常见原因);
被遗忘且尚未结束的预备(prepared)事务;
使用 pg_dump 或
COPY命令执行的长时间数据导出,它们同样使用事务机制;定期执行的 DDL 操作可能取消自动清理,使部分工作推迟到以后;
不活动的复制槽。
在正常运行中,自动清理应始终启用,工作负载中也不应出现长时间运行或处于空闲状态的操作。
冻结界限。 每张表都有一个 pg_class.relfrozenxid 属性,其中包含创建该表中最晚的未冻结行版本的事务 ID。事务 relfrozenxid 的年龄称为该表的冻结界限——事务 ID 更老的所有行版本都已经确定被冻结。通过 pg_class 表,既可以获取 relfrozenxid 本身,也可以计算冻结界限(horizon 字段):
译注:relfrozenxid 与冻结界限
原文将 relfrozenxid 描述为最晚的未冻结行版本的创建事务 ID,同时把更老的行版本定义为已经冻结。这里保留原文的表述和“冻结界限”术语,不静默改写字段语义。按 PostgreSQL 15 pg_class 的说明,relfrozenxid 表示更早的事务 ID 已冻结的边界;当正文使用 age(...) 的结果时,horizon 表示该界限的年龄。
冻结界限范围内的事务 ID 区间,决定了由于仍有未冻结的行版本而暂时不能重新用于未来事务的事务 ID 数量。对于定期执行清理的表,行会及时冻结,界限也会得到维护,也就是 relfrozenxid 会向前推进。查询输出表明,有三张表会定期执行清理并推进 relfrozenxid;而 pgbench_accounts 从未清理过,因此其 relfrozenxid 会逐渐落后,冻结界限也会增长。
relminmxid 属性与多事务
除了 relfrozenxid,表还有一个类似的属性 relminmxid,它指向该表中仍在使用的最老多事务标识符。多事务是需要同时对一行取得共享锁的一组普通事务。这些事务也有 32 位标识符,会写入行版本的 xmax 字段;因此它们同样需要冻结的对应机制,以及 relminmxid 的推进。下文提到 relfrozenxid 时,相应语境也可以推广到多事务,虽然不再明确说明。
清理时,数据库管理系统会评估冻结界限并选择合适的工作模式。在普通模式下,清理会冻结 xmin 年龄超过 vacuum_freeze_min_age(默认 5000 万)的行版本。如果表的冻结界限超过 vacuum_freeze_table_age(默认 1.5 亿),清理会以激进模式运行,完整扫描所有页面,以便冻结那些在普通模式下因可见性映射而跳过的页面中的行版本。如果表的冻结界限年龄超过 autovacuum_freeze_max_age(默认 2 亿),即使表不需要清理,或自动清理已关闭(通过全局参数 autovacuum 或单独表的存储参数关闭),系统也会强制启动带冻结的清理。这还保证了那些行不会变化的表(例如归档分区)中的行版本能够被冻结。
如前所述,在我们的示例中有一张表 pgbench_accounts 从未清理过,其冻结界限也比其他表更大。可以执行一次强制冻结清理(VACUUM FREEZE)进行实验;执行后,relfrozenxid 会向前推进,冻结界限会减小。
如果查看单独数据库中的所有表,它们的 relfrozenxid 通常各不相同;在所有表中总会有一张表的冻结界限最大(relfrozenxid 最老)。该表的冻结界限决定数据库冻结界限,并存储在 pg_database.datfrozenxid 中——该数据库任意表中事务 ID 更老的所有行版本都已经确定被冻结。数据库集簇中 pg_database.datfrozenxid 最老的值决定整个集簇的冻结界限。推进这个界限可以释放事务 ID,使其能够重新使用。
只有 pgbench 数据库的 datfrozenxid 向前推进了(它最近执行过带冻结的清理)。其他数据库的值仍然保留在集簇初始化时的状态:其中没有活动,也不需要执行清理,因此不会发生冻结。但是,当这些数据库的冻结界限超过 autovacuum_freeze_max_age(默认 2 亿)时,系统会在其中启动强制冻结清理。现在距离这一时刻已经不远了。清理很快就会执行,查询将显示 datfrozenxid 向前推进、冻结界限减小:
pgbench 数据库保持不变,因为它最近才执行过冻结,目前还不需要再次执行。
事务 ID 余量。 在正常运行中,清理和冻结应及时执行:datfrozenxid 向前推进,数据库管理系统为未来事务保留着充足的事务 ID。实际上,工作负载中可能出现异常,导致清理(以及冻结)推迟。通常,清理无法处理行的最常见原因是长事务:长事务会保持其他事务的可见性界限,使清理无法处理该界限以内的行。最糟糕时,冻结开始推迟,事务 ID 余量也会开始耗尽。因此,跟踪事务持续时间、消除长事务的来源,并使用超时强制结束长事务非常重要。
从监控角度看,我们关心的是可用事务 ID 的余量。可以通过 pg_database.datfrozenxid 字段,根据集簇冻结界限计算它;也可以根据数据库的可见性界限计算。数据库可见性界限由该数据库活动事务中最大的可见性界限决定——超过可见性界限的行已经不再被任何活动事务需要,今后可以被冻结(或被修改,从而改变 xmax)。第二种方法给出的估计更乐观,因为事务 ID 余量还包括数据库可见性界限与集簇冻结界限之间的区间,而这个区间可能很大,包含几千万个事务 ID。下面这些字段可以帮助我们在活动事务中寻找最大的可见性界限:
pg_stat_activity.backend_xid——分配给会话的事务 ID;pg_prepared_xacts.transaction——预备事务的事务 ID;pg_replication_slots.xmin——确定该复制槽所保持的可见性界限的事务 ID;
前两个字段指向当前节点上正在执行的活动事务。如果使用副本并启用了反馈(hot_standby_feedback = on),最后一个字段表示副本上的事务通过复制槽保持的界限。如果复制不使用槽,同样的信息会出现在相应 walsender 进程的 pg_stat_activity.backend_xid 字段中。借助反馈,管理员可以从主库跟踪副本上的长时间活动,但反馈也会推迟清理,并带来所有相应的负面影响。因此,是否使用反馈应经过审慎权衡。
译注:复制反馈字段
原文在“不使用复制槽”的句子中写作 pg_stat_activity.backend_xid。按固定的 PostgreSQL 15 资料,backend_xid 是后端的顶层事务 ID,而副本通过 hot_standby_feedback 报告的可见性界限对应 pg_stat_activity.backend_xmin。这里保留原文字段和论述,并标明这一字段差异。
下面分别介绍计算事务 ID 余量的两种方法。
第一种方法是使用基于 datfrozenxid 和 datminmxid 字段的集簇冻结界限:从整个可用事务 ID 范围的一半(20 亿)中,减去这两个标识符中年龄较大的那个。
从上面的输出可以看到,冻结界限已经达到 350 万,而事务 ID 余量(available_xids 字段)仍然非常充足,超过 20 亿。
第二种确定事务 ID 余量的方法依赖于计算数据库的可见性界限。此时需要检查所有活动来源,找到持续时间最长的活动,计算它的年龄,然后像第一种方法一样,从整个可用事务 ID 范围的一半中减去这个年龄。此外,还可以输出保持可见性界限的事务 ID:
译注:示例输出的第一列
原文说可以输出保持可见性界限的事务 ID,但紧接着的查询选择的是 pid,并没有输出相应的事务 ID 值。这里保留原文说明和原始 SQL;读者应将示例第一列理解为进程 ID。
在正常情况下,查询输出应当为空;但是,如果使用较短的间隔执行 \watch(例如十分之一秒),就能看到具有极短界限的行快速出现又快速消失,例如上面的输出。在这个例子中,界限为 1:测试环境中没有长期事务长时间保持可见性界限。
不过,可以再打开一个会话,在新事务中更新 pgbench_accounts 的任意一行,然后暂时不要结束这个事务:
现在,如果再重复几次查询,就会看到情况发生了变化:
由于数据库中有事务活动,事务计数器不断增加;由于有一个事务保持打开状态,可见性界限开始增长(确定这个打开事务快照的标识符,相对于执行当前查询的事务编号不断向过去移动)。可用事务 ID 的数量也开始减少,虽然变化并不明显。最重要的是,第二个会话中的事务保持打开的时间越长,可见性界限就会增长得越多;在这个界限以内,自动清理无法删除过时的行版本(这会导致膨胀),也无法冻结旧的行版本(随着时间推移,这可能导致可用事务 ID 的实际数量减少)。事务提交或回滚后,界限会再次减小到零。
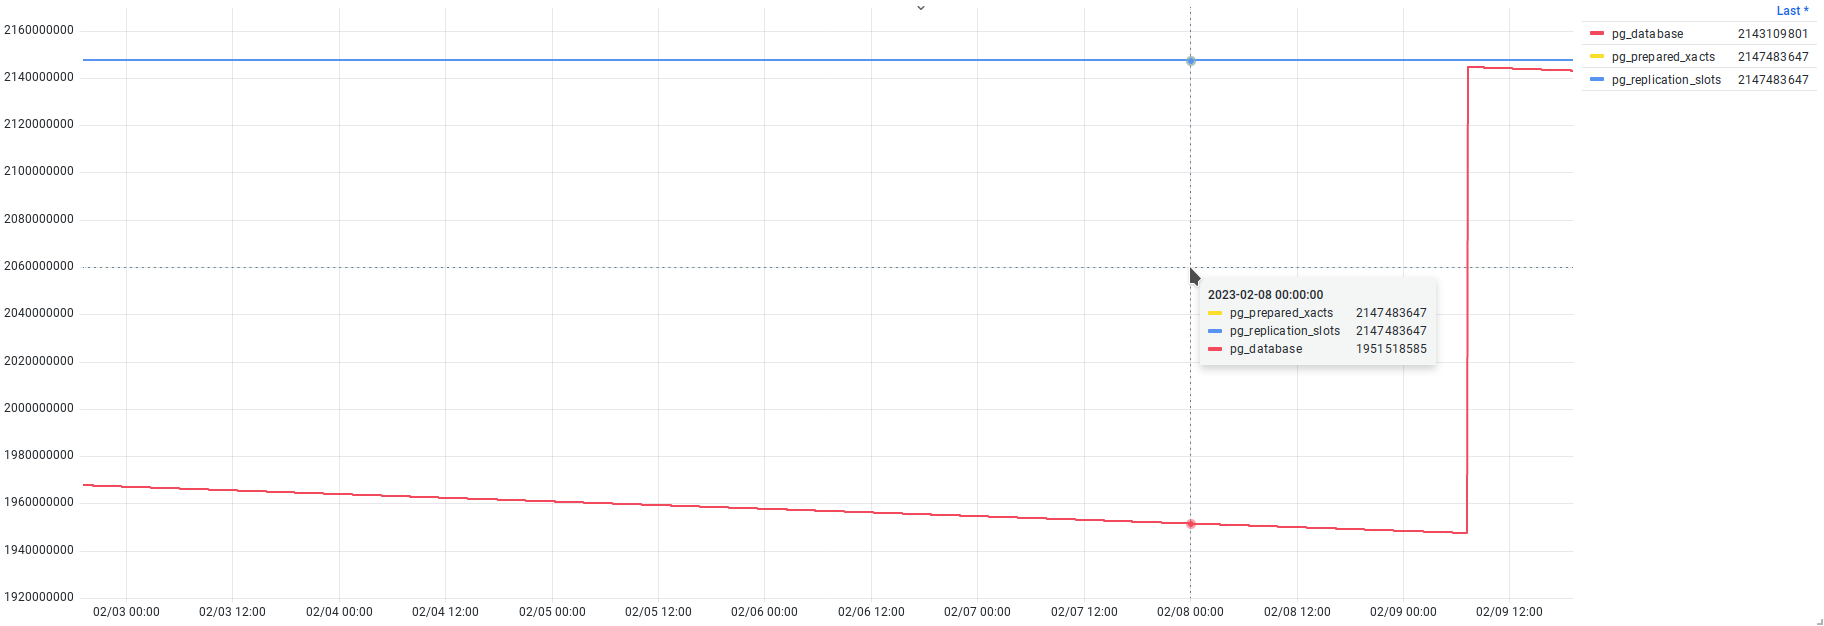
无论使用哪种方法计算事务 ID 余量,从监控角度看,都适合将它显示为图表。图 8.2 展示了这样的情况:某个数据库的 datfrozenxid 年龄超过了 autovacuum_freeze_max_age,因此执行了带冻结的强制自动清理。为了使变化更加明显,图中采用了几天的时间范围,因为测试环境中的事务 ID 余量下降得相对缓慢。冻结完成后,界限减小,事务 ID 余量也相应增加。在事务活动量较大的生产环境中,这种界限推进会定期发生,而且相当频繁。
防止回卷。 除了冻结机制,数据库管理系统还内置了各种检查,用于在冻结界限危险增长时通知数据库管理员,并避免事务计数器回卷相关的错误。一旦强制清理无法正常完成工作,
服务器日志中就会开始出现通知,说明当前使用中的最老事务 ID 已经落后很久:
作为提示,数据库管理系统建议结束未完成的事务,提交或回滚旧的预备事务,或者删除不活动的复制槽。情况继续恶化时,清理会以一种特殊的 failsafe 模式运行;为了加快冻结过程,该模式会跳过索引处理。当 relfrozenxid 的年龄超过 vacuum_failsafe_age 时,就会启用这种模式:
如果继续忽略这些消息,数据库管理系统会更加直接,开始报告哪些具体数据库必须执行清理:
在事务 ID 余量耗尽前大约 300 万个事务时,数据库管理系统会切换到只读模式。任何写入或修改数据的尝试都会以错误结束。
这种情况被视为危险状态;数据库管理系统进入紧急模式后将停止工作,从而避免继续运行并损坏数据。要恢复并继续正常运行,管理员必须以特殊的单用户模式(single-user mode)重启数据库管理系统,在需要处理的数据库中执行清理,然后再以普通模式重启数据库管理系统。
8.4. 表和索引的膨胀
过时的行版本由更新或删除操作产生。在正常运行时,这些行版本占用的空间会由清理及时释放,并用于插入新的行版本。但是,如果积累了过多过时版本,而自动清理又长时间无法清除它们,那么清理完成后,表和索引文件中就会形成大片空闲区域;这些区域今后可能不会被用到,只会继续占用磁盘空间。因此,磁盘空间没有得到有效利用。需要特别指出的是,这适用于文件开头或中间的“空洞”:如果清理释放的是文件末尾的空间,它可以尝试截断文件。
数据库长期运行时,表和索引中的这类空洞可能越来越多,于是就会出现所谓的膨胀。把所有空洞加在一起,可能得到一个相当可观的数字。从运维角度看,需要定期检查表和索引是否存在膨胀,执行维护并释放未使用的空间。
要查找膨胀对象,最有效、最准确的评估工具是 pgstattuple 扩展9。不过,准确性是以较大的开销为代价的:该扩展会读取被检查对象的每一页,这需要相应的输入/输出,并会增加磁盘子系统的负载。考虑到数据库管理系统没有内置的吞吐量限制机制,这种“检查”可能显著 加重存储子系统的负载,并严重影响并发执行查询的性能。因此,定期且频繁地使用 pgstattuple(例如在遥测数据采集代理中使用)可能并不合适;建议只在需要时使用 pgstattuple。
还有其他使用系统目录数据进行评估的启发式方法,它们会考虑行的总数、行宽以及其他存储特征;但是,这类方法通常准确性较低,可能产生较大的偏差。工具的选择始终由管理员决定,并应以运行条件为依据。可以在 PostgreSQL Wiki 的相应章节中找到这类查询的示例10。
为了说明,测试环境中已经安装了 pgstattuple 扩展;我们将使用它评估两张表的膨胀:pgbench_accounts 和较小的 pgbench_branches。
查询的执行时间取决于表的大小,因为必须读取表的每个数据块,所以评估 pgbench_accounts 所需的时间比评估 pgbench_branches 更长。通过分析表,可以得到以下信息,用来评估膨胀:
table_len——对象(表或索引)的大小,单位为字节;tuple_count——活行版本的总数;
tuple_len——活行版本的总大小,单位为字节;tuple_percent——活行版本占所有行版本总数的百分比;dead_tuple_count——死行版本的总数;dead_tuple_len——死行版本的总大小,单位为字节;dead_tuple_percent——死行版本占所有行版本总数的百分比;
译注:pgstattuple 百分比字段
原文把 tuple_percent 和 dead_tuple_percent 说明为行版本数量的百分比,但 PostgreSQL 15 的 pgstattuple 实现按 tuple_len / table_len 和 dead_tuple_len / table_len 计算,实际表示对象总字节数中的比例。示例中的 242000000 / 294264832 = 82.24% 也表明这里是字节比例。本译文保留原书字段说明,同时明确这一技术差异。
free_space——表文件内部空闲空间的总大小,单位为字节;这些空间由清除死行版本产生,因表膨胀而形成,只能在这张表中重复使用;free_percent——空闲空间占对象总大小的比例,也就是用百分比表示的同一项膨胀指标。
最值得关注的字段是 free_space 和 free_percent,因为它们直接表示空闲空间的大小。比较两张表的统计信息可以看到,pgbench_accounts 的膨胀程度远低于 pgbench_branches,分别为 3.5% 和 88%;但是,pgbench_branches 占用的空间只有 311 KB。释放空闲空间带来的收益可能很小,但如果这张表关联着大量输入/输出活动,就可以显著降低开销。
继续这个例子,我们对表 pgbench_branches 执行完全清理命令 VACUUM FULL。虽然这是一个会阻塞的操作,但由于目标表很小且只有 20 行,它会立即完成。完全清理之后,我们再次查看 pgstattuple 统计信息:
几乎所有空闲空间都被释放了,表也可以放入一个 8 KB 大小的页面中。不过,这只是测试环境中的一张小表。在真正的生产环境中,数值和结果会完全不同。
实际工作中可以使用各种工具释放空间。对于索引,可以使用 REINDEX CONCURRENTLY 命令;它会以非阻塞方式创建新索引,然后用新索引替换旧索引。对于表,数据库管理系统建议使用 VACUUM FULL 命令,但该命令会完全阻塞对表的访问,甚至不允许读取,因此不适合生产环境。作为替代方案,可以使用社区提供的第三方工具,例如 pg_repack11、pgcompacttable12 和 pg_squeeze13。这些工具的实现方式和工作原理各不相同,但目标相同:消除膨胀并释放空间。
8.5. 跟踪正在运行的清理进程
清理的执行时间可能受多种因素影响,例如配置参数、表的大小、索引数量以及死行数量等。清理处理表和索引时会给存储子系统增加额外负载,可能与数据库管理系统的其他进程争用输入/输出资源,并影响它们的性能。对管理员来说,不仅要了解清理操作的执行进度,还要评估它们对系统的影响,并了解资源的使用情况。
数据库管理系统提供了两个用于跟踪正在运行的清理进程的工具:
pg_stat_activity——用于跟踪数据库管理系统中全部活动的主要视图,其中也会显示清理进程;pg_stat_progress_vacuum——显示清理操作(包括手动清理和自动清理)的状态与执行进度的视图。
由于 pg_stat_activity 是通用视图,只以某种概括的形式显示数据库管理系统所有进程的活动,因此无法从中了解具体进程的特征。跟踪清理进程时应使用 pg_stat_progress_vacuum 视图:它包含更多关于清理本身的信息。此外,还可以合并两个视图,尽可能获取完整的信息。
pg_stat_activity 视图
前面的章节应该已经让你熟悉了 pg_stat_activity 视图,因此这里不再详细介绍,只列出我们关注的字段:
pid——执行清理操作的进程标识符;
backend_type——根据进程类型,可以筛选出属于自动清理进程的行。不过需要注意:通过这个字段无法找出在普通会话中使用VACUUM命令启动的清理;这类进程的backend_type值是client backend,与其他后端进程相同;datname——建立连接并执行清理的数据库名称;xact_start——事务开始时间,可用于确定清理的执行时长。这里还有一个细节:即使只清理一张表,也会执行多个事务,因此这个时间戳可能发生变化。可以使用backend_start,但自动清理工作进程在其生命周期内会处理许多表,因而无法单独确定处理某一张表所花的时间;state——进程状态;wait_event、wait_event_type——如果清理因某种原因暂停,等待事件可能很有用;query——查询文本是关键字段,可以据此只选出执行清理的进程,无论清理是自动执行的,还是管理员在单独会话中启动的。
必要时还可以加入其他字段。根据上面列出的字段设置过滤条件,可以排除其他进程,只选择执行清理的进程。从持续监控的角度看,我们可能关心以下问题:
当前正在运行多少个清理进程?这可以帮助判断是否已经达到工作进程数量的限制(由 autovacuum_max_workers 参数设置)。如果已经达到限制,同时又需要启动更多自动清理进程,表就必须排队等待处理,死行会继续积累,增加清理工作量。队列增长还会推迟其他表的处理,逐渐导致膨胀,并增大表和索引的大小。
清理持续了多长时间?理想情况下,只要资源允许,清理应当快速完成。数据库管理系统有空闲工作进程可用,就能避免表进入处理队列。对于混合负载的大型数据库(HTAP,即 Hybrid Transactional/Analytical Processing),这种情况尤其危险。这类数据库中既可能有很大的表,也可能有写入量很大的表。前者可能需要冻结;冻结要求完整读取整张表,可能耗费很长时间,而后者的变更会不断推动事务计数器向前。
在这种条件组合下(大型表清理持续时间长、写入活动频繁且清理工作进程不足),数据库管理系统将无法及时完成处理并推进事务计数器,最终可能紧急切换到只读模式。
要回答这些问题,只需使用 pg_stat_activity。在测试环境中很难捕捉到持续时间较长的清理,因此为了便于演示,我们先重写 pgbench_accounts 表:
在相邻会话中,使用 \watch 1 启动对 pg_stat_activity 的查询。更新 pgbench_accounts 的查询执行后约一分钟(因为 autovacuum_naptime = 1min),自动清理工作进程就会启动,并被对 pg_stat_activity 的查询捕捉到。
查询使用了针对查询文本的条件,要求文本以自动清理工作进程和单独会话中启动的清理所特有的模式开头。这种方法比根据 backend_type 设置条件更方便,因为后者无法筛选出普通会话中的清理。查询输出中的一行表示当前只启动了一个工作进程。使用 count 函数统计行数,就可以知道某一时刻启动了多少个清理工作进程,从而回答第一个问题,即正在运行的进程数量。duration 字段显示清理的执行时长,回答第二个问题,即清理持续了多久。查询中给出的状态和等待事件信息通常不会收集到监控中,主要只在排查和解决问题时使用。
可以将这些结果显示为图表。图 8.3 展示了清理进程数量。这里会产生一个合理的问题:为什么图中的数量与 pgbench_branches 和 pgbench_tellers 表实际执行的清理次数相差这么大?答案在于 pg_stat_activity 视图的特点:它显示的是当前快照,不是累计统计;两个快照之间发生的一切都不可见。要了解清理次数,最好使用图 8.1。
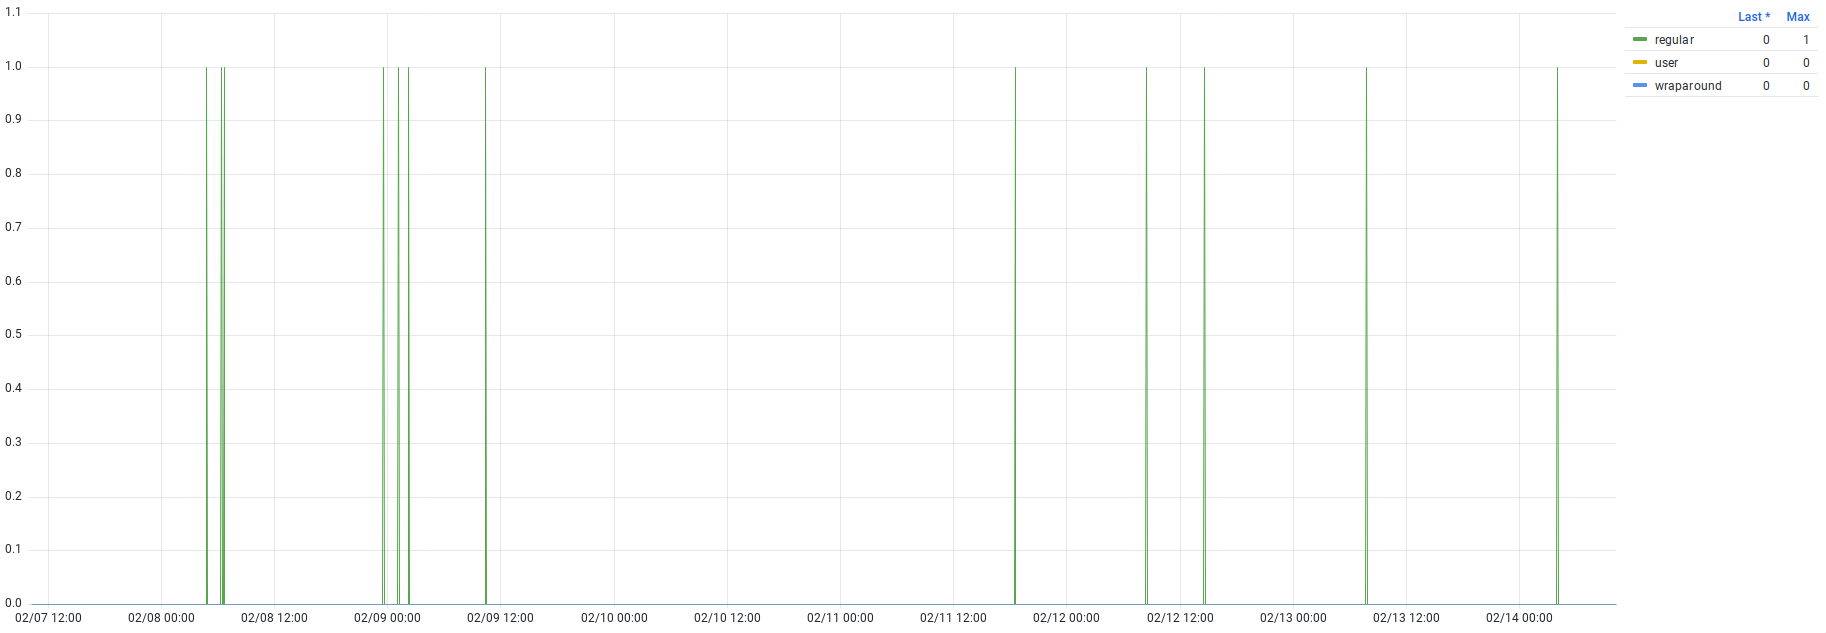
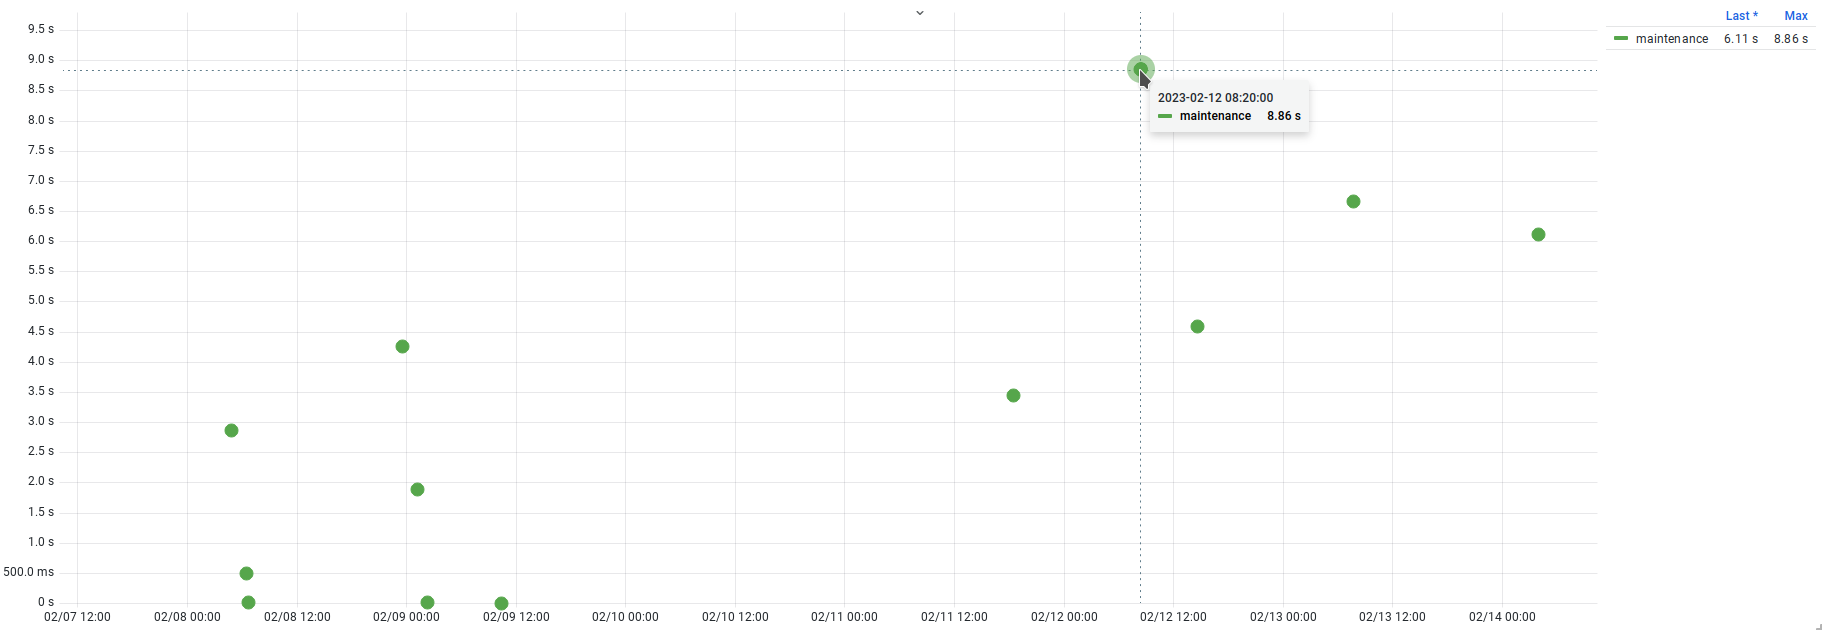
图 8.4 显示了在 pg_stat_activity 中捕捉到清理进程并记录其持续时间的时刻。数值仍然不多,但遗憾的是,数据库管理系统没有其他可以提取这类信息的视图。更完整、更准确的信息可以从活动日志中获得。设置 log_autovacuum_min_duration 参数后,每个执行时间超过指定值的自动清理进程的工作统计信息都会写入服务器日志。
清理工作统计信息包含大量数据;如果分析较长时间段内的统计信息,肯定能得到一些有趣的观察和结论。在给出的示例中,我们关注最后一行,其中记录了清理耗时 53.38 秒。因此,通过分析日志流,可以跟踪所有执行时间超过 log_autovacuum_min_duration 的清理;与查询 pg_stat_activity 不同,这不需要依靠运气。不过,也不应滥用这一机制,过度降低 log_autovacuum_min_duration 的值,因为在活动量大且表很多的系统中可能执行大量清理,从而导致服务器日志产生大量写入。
pg_stat_progress_vacuum 视图
pg_stat_progress_vacuum 视图包含清理进程工作情况的详细信息,可以用来评估执行进度。视图中的每一行描述一个当前正在运行的进程。如果当前没有正在执行的清理,视图中也不会有任何行。
pid——操作系统中的进程标识符;datid、datname——已建立连接且当前正在其中清理表和索引的数据库的标识符和名称;relid——当前正在清理的表的标识符;phase——清理执行阶段:
— initializing——初始化并做好工作准备;
— scanning heap——扫描表,可能包括清理、页面碎片整理和冻结行;
— vacuuming indexes——处理索引;如果 autovacuum_work_mem 或 maintenance_work_mem 不足,可能执行多次;
— vacuuming heap——处理表。它与扫描的区别在于,每次处理索引后都会执行这一阶段(首先删除索引中指向行的指针,然后删除表中由这些指针标记的行版本);
— cleaning up indexes——最终处理索引,在完成表的完整扫描以及表和索引的清理后执行;
— truncating heap——截断表文件并释放空闲页面,以便将空间归还给操作系统;
— performing final cleanup——最终清理,更新空闲空间映射、更新 pg_class 中的统计信息等,并结束工作;
heap_blks_total——开始工作时表中的数据块总数;清理过程中新增的数据块不计入其中;heap_blks_scanned——已扫描的数据块总数。扫描经过优化,会使用可见性映射,部分数据块可以跳过检查;但是,被跳过的数据块也会计入该字段,最终heap_blks_scanned会等于heap_blks_total;heap_blks_vacuumed——已清除过时行版本的数据块总数。如果表没有索引,该计数器只会在vacuuming heap阶段增加。不包含死行的数据块会被跳过,因此该计数器可能会大幅跳增;
译注:heap_blks_vacuumed 的阶段条件
原文此处写作“如果表没有索引,该计数器只会在 vacuuming heap 阶段增加”。固定的 PostgreSQL 15 文档对应表述是“除非表没有索引,否则该计数器只会在 vacuuming heap 阶段增加”,也就是有索引时才受这一阶段条件限制;两者的条件相反。这里保留原书句子、字段名和示例代码,不把源文静默改写成 PostgreSQL 15 文档的表述。
index_vacuum_count——已完成的索引清理循环总数;max_dead_tuples——可以放入工作内存(autovacuum_work_mem、maintenance_work_mem)中的过时行版本指针数量。工作内存耗尽时,会执行一次索引清理循环;num_dead_tuples——自上一次索引清理循环完成以来,已收集到工作内存中的过时行版本指针数量。
未经处理的统计信息可能显得不够直观,也无法回答管理员提出的问题:当前正在处理哪张表?清理已经执行了多长时间、速度是多少?什么时候会结束?
输出中的标识符和数值以数据块为单位,不如通常使用的字节直观。为了便于理解,可以在查询中加入 pg_stat_activity 的信息,并将 pg_stat_progress_vacuum 的字段转换为更常见的形式:
现在,结果中已经给出了清晰的答案:
当前正在处理
pgbench_accounts表;当前表的处理已经持续了 52 秒;
当前正在执行处理数据块之间的常规暂停(
wait_event = Timeout.VacuumDelay);
mode = regular表示这是普通的自动清理(与维护事务计数器无关,也不是用户启动的清理);表的大小为 522 MB,包含索引在内为 608 MB;
scanned_pct = 100.0 %表示表已经完全扫描完毕,检查死行后正在直接执行清理(phase = vacuuming heap);vacuumed_pct = 45.7 %表示清理已经完成了将近一半;工作内存已经使用了 17.2%(
work_mem_usage),并且已经完成了一次索引处理循环(index_vacuum_count = 1)。
如果再次完整更新 pgbench_accounts 表,并在相邻会话中使用 \watch 1 启动查询,就可以直观看到清理的执行过程。不过,这类查询及其输出的统计信息更适合用于当前评估,将这类信息收集到监控中意义不大。
总结
并发访问机制允许同一行同时存在多个版本。
行的生命周期意味着会存在活行版本和死行版本。
必须定期清除死行版本。
表和索引都需要执行清理。
当死行版本数量超过某个阈值时,会执行自动清理。
清理会产生额外的输入/输出,并可能影响性能。
管理员需要跟踪数据库管理系统中的清理工作。
自动清理应当无延迟地启动。
自动清理维护事务计数器,并持续提供充足的可用事务 ID 余量。
管理员需要跟踪可用事务 ID 的余量。
在不利条件组合下,事务 ID 余量可能耗尽,导致数据库管理系统停止正常运行。
清理工作效率低下可能导致膨胀。
膨胀会造成磁盘空间使用效率低下,并降低性能。
使用
pgstattuple扩展评估膨胀程度。可以使用
pg_stat_activity和pg_stat_progress_vacuum视图跟踪正在运行的清理进程。
postgrespro.ru/docs/postgresql/current/sql-createtable#SQL-CREATETABLE-STORAGE-PARAMETERS ↩︎
postgrespro.ru/docs/postgresql/current/runtime-config-autovacuum#GUC-AUTOVACUUM-NAPTIME ↩︎
postgrespro.ru/docs/postgresql/current/sql-createtable#SQL-CREATETABLE-STORAGE-PARAMETERS ↩︎
postgrespro.ru/docs/postgresql/current/ddl-system-columns ↩︎