# 复制
LLMS 索引: [llms.txt](/llms.txt)
---
> [!NOTE]
> **本章将讨论:**
>
> - 复制及其工作方式;
>
> - 复制跟踪工具;
>
> - `pg_stat_replication` 和 `pg_stat_wal_receiver` 视图;
>
> - 复制滞后;
>
> - 复制槽;
>
> - `pg_replication_slots` 视图;
>
> - 发布与订阅;
>
> - `pg_stat_replication_slots` 视图;
>
> - `pg_stat_subscription` 和 `pg_stat_subscription_stats` 视图;
>
> - 恢复冲突和 `pg_stat_database_conflicts` 视图。
上一章介绍了预写式日志,这是数据库管理系统中保证数据持久性的关键组件之一。此外,复制建立在使用 WAL 日志的基础上。借助复制,可以构建复杂的分布式配置,用于提供冗余、容错与灾难恢复能力,并分摊负载。使用复制和集群配置会增加管理复杂度,需要认真负责的态度以及配置和运维技能。本章简要介绍 PostgreSQL 中复制的工作方式及其使用方式,并更详细地介绍数据库管理系统提供的、用于跟踪集群和复制机制运行情况的工具。
## 7.1. 复制概览 {#mon-section-7-1}
复制是两个或更多节点之间同步数据的过程。通常区分物理复制和逻辑复制。物理复制传输数据块的物理变更,不分析所传输变更的内容。逻辑复制更复杂,包括分析、过滤和选择性传输变更。在最小配置中,复制涉及两个节点:一个作为*主库*(primary),作为变更来源;另一个作为*副本*,接收来自主库的变更并在自身重放。根据复制类型,术语可能不同:例如在物理复制中,副本通常称为*备库*或*备用节点*(standby)。更复杂的复制方案可包含多个主库,复制类型也可组合,每个节点都可将变更复制到其他节点。复制主要用于在多个节点间分摊负载和提供容错能力:主库发生故障时,可以将副本切换为主库模式,以最小化整体系统停机时间(downtime)继续处理工作负载。物理复制因通用且适用于两种场景而广泛采用。逻辑复制则用于选择性传输数据集,例如分片(sharding)。本章主要讨论物理复制,较少涉及逻辑复制。
PostgreSQL 中的两种复制工作方式相近。首先将数据从主库初始同步到副本。随后副本连接到主库,主库中写入 WAL 日志的所有变更都通过复制协议传输到副本。副本也可以继续向其他节点传输变更,从而构建级联配置。
默认情况下,复制是异步过程:主库上的变更无论是否有副本都会提交。可以将复制切换到同步模式(参见 *synchronous\_commit*),此时主库上的事务只有在备库确认收到后才提交。根据参数 *synchronous\_commit* 的值,确认消息可以在收到的日志记录写入磁盘后(`remote_write`)、与磁盘同步后(`on`,默认值)或接收的变更重放后(`remote_apply`)发送。同步模式可以在发生故障时将已提交事务的丢失量降为零。不过,使用同步复制,尤其是 `remote_apply` 模式,可能会显著影响性能;此外,副本发生故障还可能导致主库无法提供服务:所有事务提交操作都要等待日志记录传送到副本。因此,是否使用同步复制必须经过审慎、充分的论证。无论如何,写入主库日志的所有变更都会以一定的*滞后*(replication lag)出现在副本上;滞后程度取决于节点性能、网络环境和当前工作负载等因素。
复制过程由副本发起。walreceiver 进程检查本地 WAL 日志的状态,并向主库发送传输日志记录的请求。如果主库拥有所请求的记录,就会在主库上启动后台 walsender 进程,负责后续的日志流式传输。walsender 和 walreceiver 两个进程之间保持持久连接;日志中一出现新数据(包括尚未提交事务的数据),walsender 就会将其传给 walreceiver。walreceiver 进程等待数据传输。收到日志记录后,它把记录保存到主数据目录的本地 `pg_wal` 目录中;随后,另一个后台进程 startup 在本地数据副本上*重放*(replay)所传输的变更。变更一经应用,更新后的数据就对在副本上执行的查询可见。这种复制机制已经证明简单而可靠。
两种复制都基于 WAL 记录的传输实现,包括物理复制和逻辑复制。由于 WAL 日志记录的是单个物理块层面的变更,物理复制实际上就是传输物理块的变更。这些变更描述了数据块从一种物理状态原子地转变为另一种物理状态,但不说明究竟修改了哪些用户数据(表、行或单个字段)。因此,walsender 和 walreceiver 进程负责在节点之间连续、按顺序传输变更流,而 startup 进程则不跳过任何变更,严格按照日志记录的顺序应用全部变更。要评估物理复制的运行情况,只需跟踪 walsender 和 walreceiver 进程的状态,以及主库向副本传输的数据量。
逻辑复制更复杂,可以选择性地复制变更。在 PostgreSQL 中,这项功能通过*发布*[^mon-176-1]和*订阅*[^mon-176-2]机制实现。在逻辑复制中,主库和备库的概念不再适用,因为逻辑复制节点可以同时承担两种角色;表示变更来源和接收方时,使用*发布服务器*和*订阅服务器*这两个术语。发布服务器对日志流进行解码,识别发生变更的对象。解码后,就可以过滤记录流,并复制单个对象的变更(全部操作或指定的一组操作)。选定的变更会传给订阅端服务器,后者在本地保存这些变更,然后按照事务在发布服务器端提交的顺序应用事务,而不是像物理复制那样按照 WAL 记录的顺序应用。
物理复制可以使用所谓的*复制槽*,而逻辑复制必须使用复制槽。复制槽可以保留所需数量的 WAL 段,避免它们在执行检查点时被回收。复制槽是复制机制的重要组成部分,需要管理员关注和控制:监控逻辑复制时,不仅要跟踪变更传输,还要跟踪复制槽的状态。
复制集群运行过程中可能出现各种问题,影响集群的可用性以及各节点的性能:
- 节点故障或不可用,导致无法传输日志;
- 数据库管理系统节点或传输环境性能不足,导致日志传输延迟;
- 副本上的日志重放性能不足,从而落后于主库;
- 日志重放时发生冲突,导致滞后或查询执行出错;
- 日志段累积导致磁盘空间不足,数据库管理系统异常终止。
从上面的列表可以看出,潜在问题很多。其中一些问题会造成性能下降,甚至完全无法提供服务,而且恢复时间无法预测。因此,管理员有责任跟踪集群状态和各节点的可用性,并预防可能破坏正常运行的问题。下面将介绍数据库管理系统提供的、用于跟踪复制和发现相关问题的工具。
## 7.2. 复制跟踪工具 {#mon-section-7-2}
复制跟踪有多种工具,根据所使用的复制方式,可能只需要其中一部分:
- `pg_stat_replication` ——跟踪 walsender 进程以及向副本传输日志的过程;
- `pg_stat_wal_receiver` ——跟踪 walreceiver 进程以及接收日志的过程;
- `pg_replication_slots` ——跟踪物理和逻辑复制槽;
- `pg_stat_replication_slots` ——逻辑复制槽的使用统计;
- `pg_stat_subscription` ——订阅端的工作统计;
- `pg_stat_subscription_stats` ——订阅端工作错误的统计;
- `pg_stat_database_conflicts` ——恢复冲突的统计,并按发生原因分类。
下面将介绍这些工具及其可能的使用场景。
### `pg_stat_replication` 视图 {#mon-section-star-141}
主库是所有变更的来源,可以向多个节点复制数据。发送变更的速度与副本应用变更的速度可能不同,这会体现为复制滞后以及数据新鲜程度的差异。可以使用 `pg_stat_replication` 视图确定复制滞后和日志传输的其他特征。视图的每一行都包含一个 walsender 进程的工作统计。`pg_stat_replication` 视图显示当前数据的方式与 `pg_stat_activity` 视图类似:
```text {label="text" .source-commands hl_lines="1"}
# TABLE pg_stat_replication;
-[ RECORD 1 ]----+------------------------------
pid | 39
usesysid | 16431
usename | replica
application_name | walreceiver
client_addr | 172.22.0.3
client_hostname |
client_port | 46666
backend_start | 2022-12-14 03:54:32.228266+00
backend_xmin |
state | streaming
sent_lsn | D8/EF27AFC0
write_lsn | D8/EF27AFC0
flush_lsn | D8/EF27AFC0
replay_lsn | D8/EF27AFC0
write_lag | 00:00:00.000159
flush_lag | 00:00:00.002637
replay_lag | 00:00:00.002807
sync_priority | 0
sync_state | async
reply_time | 2022-12-16 04:36:36.495495+00
```
测试环境配置了一个带单个备库的复制集群,因此该视图中只有一行。字段如下:
- `pid` ——操作系统中的 walsender 进程标识符;
- `usesysid`、`usename` ——数据库管理系统用户的标识符和名称,备库一侧使用该用户建立连接;
- `application_name` ——连接主库时可以指定的附加应用标识符;
- `client_addr`、`client_hostname`、`client_port` ——备库一侧的网络信息:地址、节点名称和端口号;
- `backend_start` ——连接建立和 walsender 进程创建的时间戳;
- `backend_xmin` ——副本通过反馈传给主库的事务界限(参见 *hot\_standby\_feedback*);
- `state` ——walsender 进程的当前状态,也决定复制的总体状态:
— `startup` ——walsender 正在启动;
— `catchup` ——副本正在尝试“追上”主库;
— `streaming` ——这是主要工作模式:副本成功“追上”主库后,walsender 向副本传输变更流;
— `backup` ——walsender 正在传输备份;
— `stopping` ——walsender 正在关闭。
根据下面这些显示日志发送和接收状态的字段,可以确定具体副本的滞后量,以及它要完全消除滞后还需要完成多少工作:
- `sent_lsn` ——日志位置;截至该位置的记录已经发送到副本;
- `write_lsn` ——日志位置;截至该位置的记录已经接收,但尚未由 walreceiver 同步;
- `flush_lsn` ——日志位置;截至该位置的记录已经由 walreceiver 同步;
- `replay_lsn` ——日志位置;截至该位置的记录已经由 startup 重放。
前面提到过,变更可能会延迟出现在副本上。复制滞后在理想情况下应接近于零,但并不总能做到。滞后也可以理解为还需要完成的工作量。不过,主库并不会停下来,其日志中会不断写入新的变更。新增变更量可能变化,因此副本的滞后也不会保持不变。滞后增加可能表现为在主库和副本上执行查询得到的结果不一致,设计从副本读取数据的应用时应考虑这一点。
要“追上”主库,副本需要:a)从主库接收全部变更;b)将其写入本地存储;c)完成同步;d)在本地数据副本上重放。利用上述日志位置字段,可以计算位置之间的字节距离,从而判断最大的滞后出现在处理链路的哪个环节。这里需要用到已经介绍过的 `pg_current_wal_lsn` 函数,以及由 `pg_lsn` 数据类型支持的减法运算符:
- `pg_current_wal_lsn - sent_lsn` ——待发送数据量,包括主库上已经积累、但尚未传给副本的全部日志记录;
- `sent_lsn - write_lsn` ——已从主库发送、但尚未在副本一侧写入的数据量;
- `write_lsn - flush_lsn` ——已经写入、但尚未在副本上同步的数据量;
- `flush_lsn - replay_lsn` ——等待 startup 进程重放的数据量。
计算出的数据量以字节表示,可以直观地反映副本滞后的规模。实际中,滞后经常出现在日志发送或重放阶段。这通常是因为大量数据变更生成了许多日志记录,walsender 或 walreceiver 进程来不及传输,或者 startup 进程性能不足,无法及时重放全部日志。
下面一组字段可以直接跟踪以秒为单位的滞后时间,显示副本“追上”主库大约需要多长时间:
- `write_lag` ——从本地同步日志到收到通知之间经过的时间;通知表明变更已经写入副本,但尚未同步;
- `flush_lag` ——从本地同步日志到收到通知之间经过的时间;通知表明变更已经写入副本并完成同步;
- `replay_lag` ——从本地同步日志到收到通知之间经过的时间;通知表明变更已经写入、同步并应用;
- `reply_time` ——收到副本最后一条状态消息的时间戳;该消息包含日志处理数据。
这些字段可以帮助评估同步复制中确认事务时产生的延迟,此时参数 *synchronous\_commit* 设置为 `remote_write`、`on` 或 `remote_apply` 之一。
还剩两个字段:`sync_priority` 和 `sync_state`。在异步复制中,`sync_state` 始终为 `async`。在同步复制中,各节点可能处于不同状态,在集群中承担不同角色。值为 `sync` 表示副本当前作为同步副本运行。如果使用*基于优先级*的同步复制,值为 `potential` 表示副本当前以异步模式运行,但具备切换到同步模式的候选资格(此时 `sync_priority` 显示该节点的优先级)。如果使用*基于仲裁*的同步复制,值为 `quorum` 表示该副本属于确认收到变更所需的最少节点集合。有关同步复制配置的更多信息,参见文档[^mon-180-1]。
从排查和解决问题的角度看,地址、日志处理位置和滞后字段尤其有用。它们可以准确识别副本(特别是副本不止一个时),并确定日志处理的哪个阶段出现延迟。日志位置字段可以直接转换为滞后量:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5 6 7 8 9 10 11 12"}
# SELECT
client_addr,
state,
pg_current_wal_lsn() - replay_lsn AS total_lag_bytes,
pg_current_wal_lsn() - sent_lsn AS pending_bytes,
sent_lsn - write_lsn AS write_lag_bytes,
write_lsn - flush_lsn AS flush_lag_bytes,
flush_lsn - replay_lsn AS replay_lag_bytes,
write_lag,
flush_lag,
replay_lag
FROM pg_stat_replication;
-[ RECORD 1 ]----+----------------
client_addr | 172.22.0.3
state | streaming
total_lag_bytes | 17152
pending_bytes | 0
write_lag_bytes | 0
flush_lag_bytes | 17152
replay_lag_bytes | 0
write_lag | 00:00:00.000151
flush_lag | 00:00:00.000151
replay_lag | 00:00:00.000151
```
该视图可以按字节和秒评估滞后量,显示副本需要处理多少数据才能“追上”主库,以及需要多长时间。查询输出表明副本滞后很小,只有几微秒;按字节计算,滞后量仅约 17 KB。此时数据已经传输并写入副本,只需完成同步和重放。
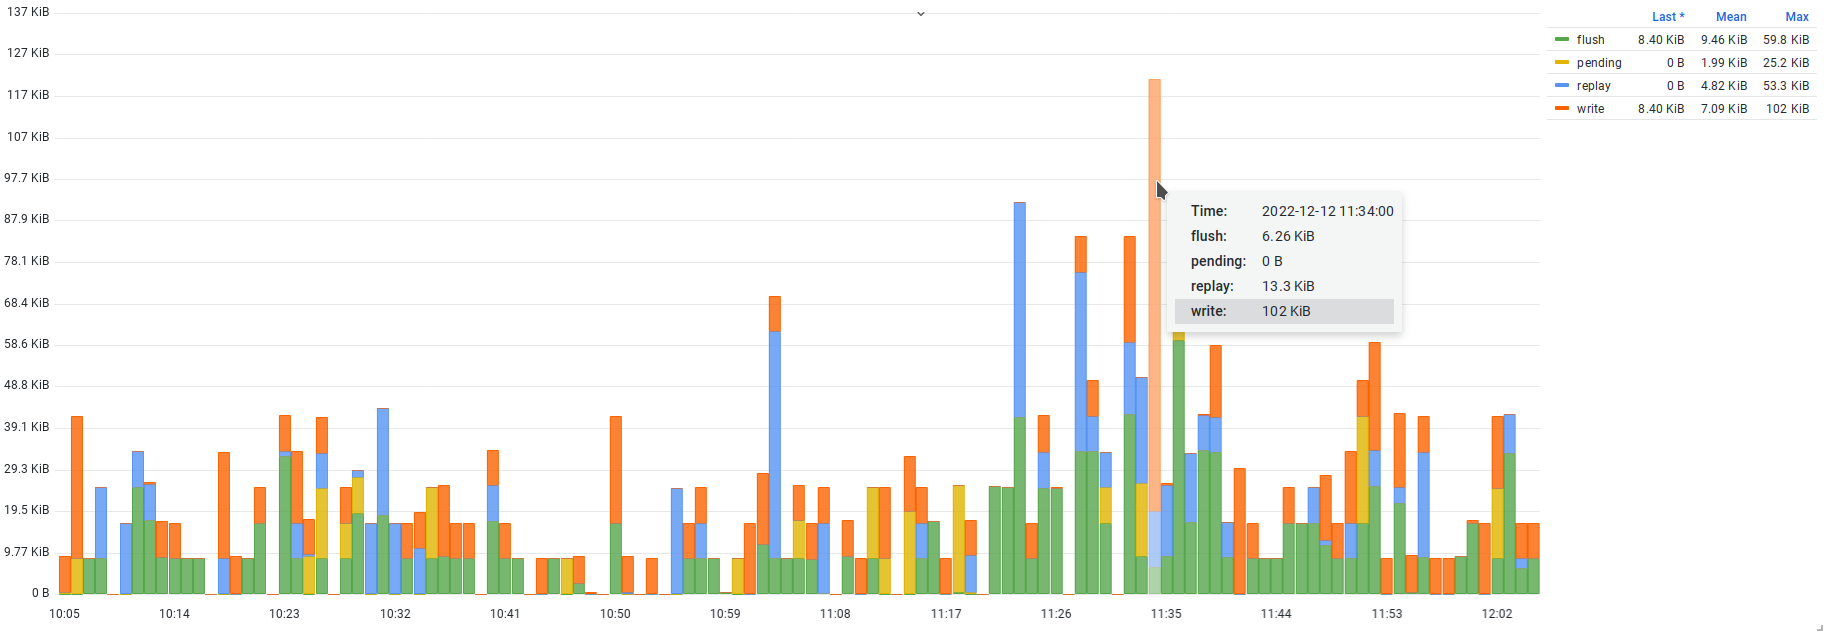
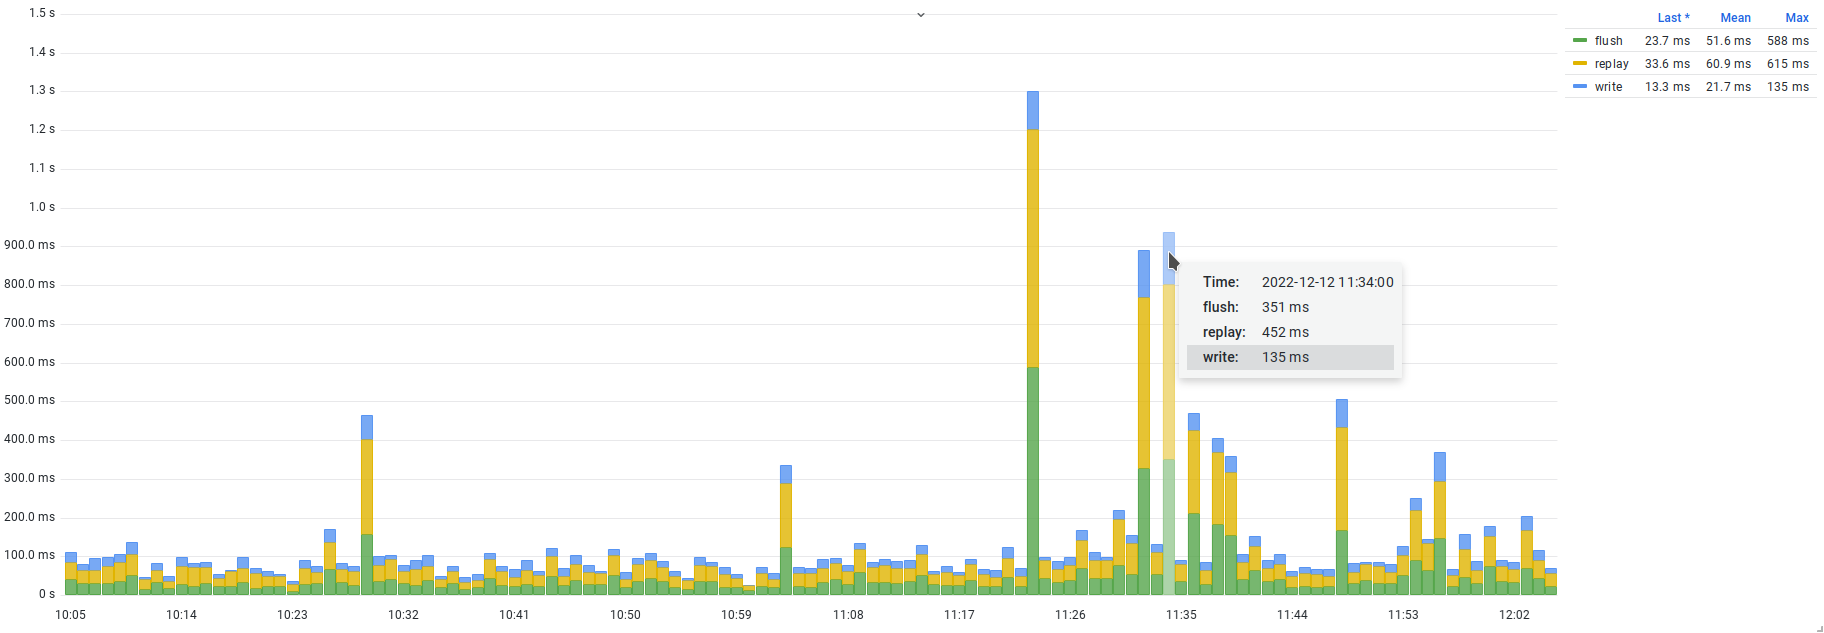
可以根据滞后量收集指标并绘制图表,显示副本随时间变化的滞后情况(图 [7.1](/07-replication/#mon-figure-caption-142) 和 [7.2](/07-replication/#mon-figure-caption-143))。
注意两张图表的图例。按字节表示的滞后更详细,其中包含尚未发送到副本的日志量。另一个有趣的现象是,在选定时刻,两张图表显示的滞后峰值不同。例如,大部分字节滞后出现在变更写入阶段,而按秒计算的滞后已经出现在同步和重放阶段。数值较小时尤其容易看到这一点。两张图表的整体情况表明,滞后经常出现在同步和重放阶段。这说明副本处理其负责的那部分工作稍慢。
{#fig-7.1 num="7.1" caption="副本的字节滞后" width=1824 height=632}
{#fig-7.2 num="7.2" caption="副本的秒级滞后" width=1824 height=633}
### `pg_stat_wal_receiver` 视图 {#mon-section-star-144}
下一种复制跟踪方式是在备库上使用 `pg_stat_wal_receiver` 视图。该视图从 walreceiver 进程的角度反映复制状态,并包含以下信息:
- `pid` ——操作系统中的 walreceiver 进程标识符;
- `status` ——walreceiver 进程的状态;
- `receive_start_lsn` ——walreceiver 进程启动时的日志位置;
- `receive_start_tli` ——walreceiver 进程启动时的日志时间线;
- `written_lsn` ——对应于最近写入但尚未同步的数据的日志位置;
- `flushed_lsn` ——对应于最近写入并同步的数据的日志位置。walreceiver 进程启动时使用该位置作为起点;
- `received_tli` ——对应于最近写入并同步数据的时间线编号。启动 walreceiver 进程时使用该时间线作为起始时间线;
- `last_msg_send_time` ——从主库收到的最后一条消息的发送时间;
- `last_msg_receipt_time` ——从主库收到的最后一条消息的到达时间;
- `latest_end_lsn` ——副本在最后一条消息中发给主库的日志位置;
- `latest_end_time` ——副本在最后一条消息中发给主库的最后日志位置对应的时间;
- `slot_name` ——当前复制会话使用的槽名称;
- `sender_host` ——建立连接的主库名称;
- `sender_port` ——建立连接的主库网络端口号;
- `conninfo` ——walreceiver 进程使用的、连接到主库的连接字符串。
该视图不包含日志重放信息,因为重放由 startup 进程负责。walreceiver 进程只负责接收和写入日志。从监控角度看,该视图几乎没有使用价值,因为通过主库上的 `pg_stat_replication` 就能获取全部这些数据。
除了 `pg_stat_wal_receiver`,还有几个函数可以提供日志的补充信息:
- `pg_last_wal_receive_lsn` ——从主库收到的最后日志位置;
- `pg_last_wal_replay_lsn` ——最后一个日志位置;截至该位置的记录已经由 startup 进程重放;
- `pg_is_in_recovery` ——数据库管理系统是否处于恢复模式(这是副本的工作模式,因为副本一直在根据日志进行恢复)。
`pg_is_in_recovery` 函数可用于判断节点是主库还是备库。`pg_last_wal_receive_lsn` 和 `pg_last_wal_replay_lsn` 适合用于确定副本上仍需重放的日志量,但不能用来计算复制滞后,因为它们没有考虑主库上尚未传给副本的日志量。如果主库发生故障并完全不可用(硬件故障、网络不可用或灾难),可以使用这两个函数来确定哪个节点最适合成为主库:比较各节点的日志位置,选择已经接收更多日志记录,或已经重放其中更大部分的节点。
### 复制槽与 `pg_replication_slots` {#mon-section-star-145}
复制正常运行时,主库向副本发送日志,副本在本地数据副本上重放变更。不过,副本可能来不及重放变更,甚至来不及接收和写入日志。例如,主库负载增加会生成大量日志,网络带宽不足,日志段开始在主库上堆积,副本滞后不断增加。又或者,主库与副本之间的网络连通性中断,日志传输被打断,复制停止。在 PostgreSQL 的早期版本中,主库不会跟踪副本需要哪些日志段:如果副本断开,服务器会继续运行,并可能在执行检查点时删除尚未传给副本的日志。如果副本重新连接并从已知位置请求日志,而主库上已不存在这些日志段,复制就无法继续。解决办法是从归档中加载所需日志段,或者重新初始化副本。这两种办法都有缺点:保存日志段归档可能消耗大量资源,而重新初始化可能需要很长时间。为了减轻这个问题,可以使用参数 *wal\_keep\_size*(原名为 *wal\_keep\_segments*),要求数据库管理系统额外保留一定量的日志,专门应对这类副本故障。另一种更现代的解决办法是使用复制槽。
复制槽保证在特定复制会话中保留日志段,直到这些日志段传输到副本为止。不过,如果副本长时间断开,同时新日志段大量增长,就有可能耗尽全部可用空间,导致数据库管理系统异常终止。作为保护措施,增加了参数 *max\_slot\_wal\_keep\_size*,用于指定上限;达到上限后,数据库管理系统会开始删除日志段。它类似于改进版的 *wal\_keep\_size*。无论选择哪种设置,仍然存在两种风险:副本完全且不可逆地滞后(只能借助 WAL 归档恢复),或者数据库管理系统因空间耗尽而异常终止。
因此,使用复制槽会给管理员增加跟踪其状态和使用情况的任务。为此,可以使用 `pg_replication_slots` 视图,它包含全部复制槽的信息,每个复制槽一行:
```text {label="text" .source-commands hl_lines="1"}
# TABLE pg_replication_slots;
-[ RECORD 1 ]-------+------------
slot_name | standby
plugin |
slot_type | physical
datoid |
database |
temporary | f
active | t
active_pid | 39
xmin |
catalog_xmin |
restart_lsn | D3/94ADE4C8
confirmed_flush_lsn |
wal_status | reserved
safe_wal_size |
two_phase | f
```
通常,该视图已经足以评估复制槽状态并确定是否存在问题:
- `slot_name`、`slot_type`、`plugin` ——用于标识复制槽的字段:槽名称、类型以及用于解码 WAL 记录流的插件(仅逻辑槽有插件);
- `datoid`、`database` ——与复制槽关联的数据库标识符和名称(仅逻辑槽有值);
- `temporary` ——表示复制槽是否为临时槽的标志。临时槽的状态不会保存到磁盘;发生错误或会话结束时,它们会自动删除;
- `active` ——表示复制槽当前是否处于活动状态并正在使用的标志。这是复制槽最重要的属性之一,可以据此判断槽的消费者是否存活;
- `active_pid` ——当前使用复制槽的会话进程标识符;
- `xmin` ——确定行版本可清理界限的事务标识符;
- `catalog_xmin` ——系统目录对象中行版本的相应界限;
- `restart_lsn` ——从该日志位置开始,槽消费者在工作过程中仍可能需要这些记录。从该位置开始的所有日志记录都不能在执行检查点时被回收,直到其总量超过 *max\_slot\_wal\_keep\_size* 为止;
- `confirmed_flush_lsn` ——日志位置;截至该位置的记录消费者已经确认收到(仅逻辑槽有值);
- `wal_status` ——该复制槽所需日志文件的状态:
— `reserved` ——所需日志量在 *max\_wal\_size* 限制以内;
— `extended` ——日志量超过 *max\_wal\_size* 限制,但日志段仍由复制槽保留,或者仍在 *wal\_keep\_size* 限制以内;
— `unreserved` ——复制槽不再保留所需的日志段,其中一些会在下一次检查点时删除。这说明消费者来不及读取变更,但如果读取速度提高,该状态仍可能恢复为 `reserved` 或 `extended`;
— `lost` ——所需日志段已经删除,该复制槽已经无法使用;
- `safe_wal_size` ——在没有消费者的情况下,再向日志写入这么多字节的变更后,复制槽就会进入 `lost` 状态。如果复制槽已经丢失,或者没有设置 *max\_slot\_wal\_keep\_size*,该值可能不显示(`NULL`);
- `two_phase` ——表示复制槽是否用于解码已准备事务的标志(仅逻辑槽有值)。
监控复制槽时,以下指标很重要:
- 当前日志位置(`pg_current_wal_lsn` 函数的返回值)与 `confirmed_flush_lsn` 之间的差值。本质上,这是等待发送给订阅端的数据量,用来表示订阅端的滞后。该值越大,积累的日志越多,订阅端处理变更所需的时间也越长。
- 事务界限的大小(根据 `xmin` 和 `catalog_xmin` 字段确定);清理进程会在删除过时行版本时考虑该界限。
- 槽消费者所需日志段的可用性(`wal_status`);数据库管理系统会自行评估这一点。
- `safe_wal_size` 的大小;它表示可写入日志的余量,耗尽该余量后可能发生日志回收并导致复制槽无法使用。
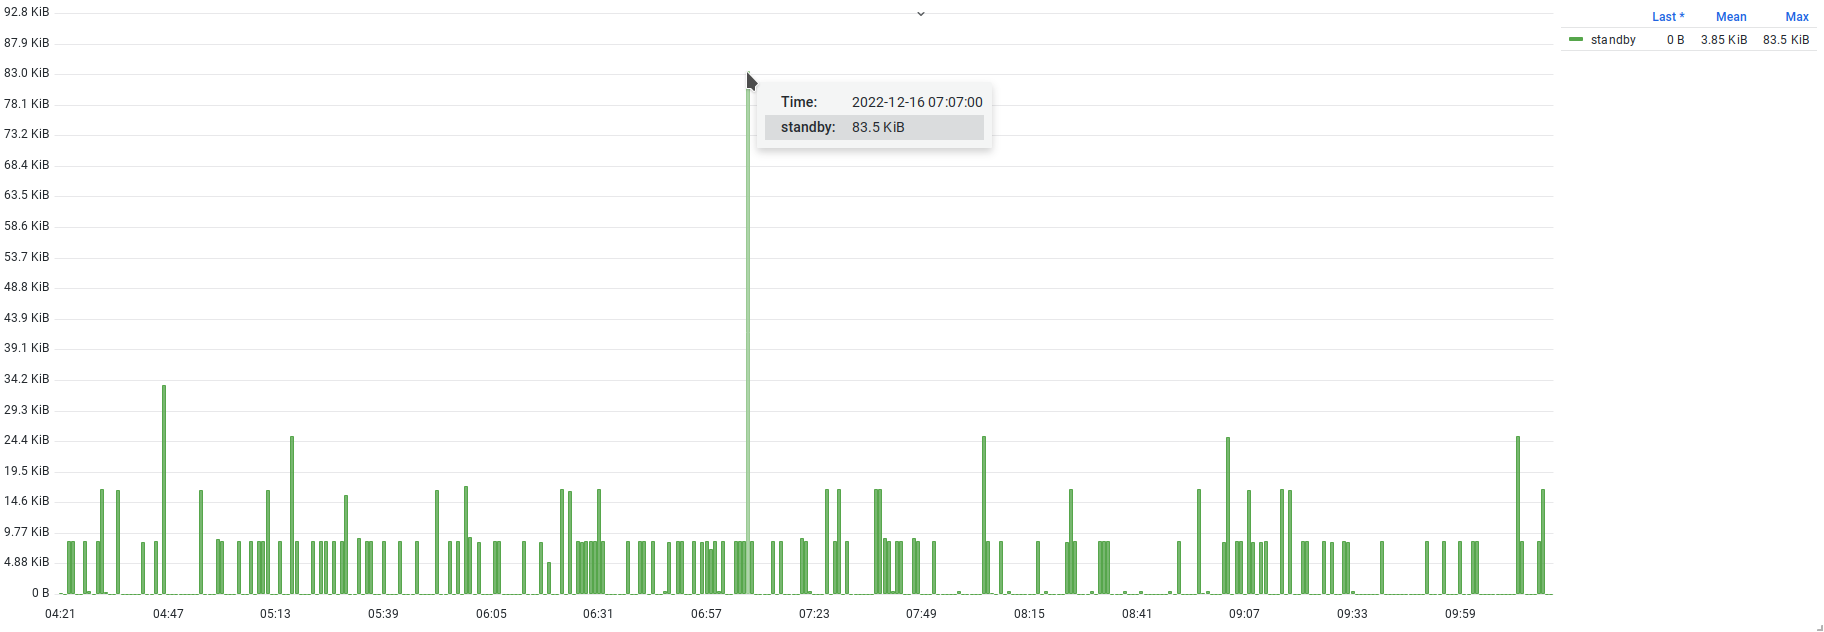
例如,在测试环境中,复制使用了复制槽,可以通过 `pg_replication_slots` 跟踪滞后情况(图 [7.3](/07-replication/#mon-figure-caption-146)):
可以做一个小实验:设置 *max\_slot\_wal\_keep\_size* 并关闭副本,观察统计信息如何变化。数据库管理系统会在一段时间内保留日志段;但日志量超过 *max\_slot\_wal\_keep\_size* 后,数据库管理系统会回收部分日志段,使复制槽无法继续使用。现在设置 *max\_slot\_wal\_keep\_size*:
```text {label="psql" .source-commands hl_lines="1 2"}
# ALTER SYSTEM SET max_slot_wal_keep_size TO '1GB';
# SELECT pg_reload_conf();
```
接下来关闭运行副本的容器:
```text {label="text" .source-commands hl_lines="1 2"}
# cd playground
# docker-compose stop standby
```
{#fig-7.3 num="7.3" caption="复制槽保留的日志量" width=1824 height=632}
现在查看 `pg_replication_slots` 的内容:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5"}
# SELECT
slot_name, active,
pg_current_wal_lsn() - restart_lsn AS backlog,
wal_status, safe_wal_size
FROM pg_replication_slots;
slot_name | active | backlog | wal_status | safe_wal_size
-----------+--------+-----------+------------+---------------
standby | f | 353427008 | reserved | 722212616
```
由于备库关闭,通过复制槽传输的变更停止了,复制槽变为非活动状态(`active = f`)。但工作负载并没有消失,新的变更仍在继续写入 WAL 日志,因此消费者的滞后不断增加(`backlog` 字段)。随着滞后增加,日志量余量 `safe_wal_size` 开始减少;此时日志状态仍为 `reserved`,说明所需日志量仍在 *max\_wal\_size* 限制之内。
可以运行元命令 `\watch 60`,观察滞后如何随时间增加,以及 `safe_wal_size` 最终变为负数。
```text {label="text"}
Tue Jan 3 14:21:54 2023 (every 60s)
```
```text {label="text"}
slot_name | active | backlog | wal_status | safe_wal_size
-----------+--------+------------+------------+---------------
standby | f | 1115080952 | unreserved | -39441328
```
```text {label="text"}
Tue Jan 3 14:22:54 2023 (every 60s)
```
```text {label="text"}
slot_name | active | backlog | wal_status | safe_wal_size
-----------+--------+---------+------------+---------------
standby | f | | lost |
```
如果没有及时启动副本,复制槽就会丢失,本实验正是如此。服务器日志中可以找到一条记录,说明复制槽在执行检查点时失效:
```text {label="text"}
2023-01-03 14:18:10.111 UTC 21 LOG: checkpoint starting: time
2023-01-03 14:22:40.095 UTC 21 LOG: invalidating slot "standby" because its restart_lsn E3/DDE30AB8
exceeds max_slot_wal_keep_size
2023-01-03 14:22:40.458 UTC 21 LOG: checkpoint complete: wrote 3545 buffers (21.6%); 0 WAL file(s)
added, 57 removed, 6 recycled; write=269.931 s, sync=0.015 s, total=270.348 s; sync files=10,
longest=0.009 s, average=0.002 s; distance=78162 kB, estimate=81638 kB
```
要让副本恢复运行,必须重新初始化它(因为测试环境中没有 WAL 归档):
```text {label="text" .source-commands hl_lines="1 2 3"}
# docker-compose rm standby
# docker volume rm playground_standby_data
# docker-compose up -d
```
重新创建容器后,复制槽状态会显示它重新开始使用,和之前一样:
```text {label="psql" .source-commands hl_lines="1 2 3 4 5"}
# SELECT
slot_name, active,
pg_current_wal_lsn() - restart_lsn AS backlog,
wal_status, safe_wal_size
FROM pg_replication_slots;
slot_name | active | backlog | wal_status | safe_wal_size
-----------+--------+-----------+------------+---------------
standby | f | 0 | reserved | 1090234536
```
### 发布与订阅 {#mon-section-star-147}
逻辑复制使用发布与订阅模型。可以在一个节点上发布一张或多张表中的变更,在另一个节点上订阅这些变更并重放。与物理复制一样,发布与订阅机制也是基于传输预写式日志实现的。复制过程从订阅端发起:创建订阅时,会启动一个逻辑复制工作进程(logical replication worker),它按照指定地址连接发布服务器。在发布端会启动两个 walsender 进程,其中一个执行目标表的初始复制后退出,另一个保留下来负责传输 WAL 日志。如果订阅服务器有多个,则会为每个订阅服务器启动一个独立的 walsender 进程,但总数不会超过参数 *max\_wal\_senders* 指定的值。随后开始对 WAL 日志进行解码:解析日志记录,提取单个表行的变更数据,并按事务分别分组。最终向订阅端传输已提交事务的数据。解码使用一个缓冲区,其大小由参数 *logical\_decoding\_work\_mem* 决定(默认 64 MB)。如果缓冲区不足,发送端可以决定将缓冲区内容溢出到磁盘,或者立即向订阅端发送部分已解码数据。这个决定取决于创建订阅端时指定的 `streaming` 参数。默认情况下,流式传输关闭;事务会先在发送端完成全部解码,然后才把已解码数据传给订阅端。有关逻辑复制的工作方式、配置和运行的更多信息,参见官方文档[^mon-189-1]。
测试环境没有使用逻辑复制,也没有发布或订阅,但下面仍介绍跟踪它们运行情况的工具。
`pg_stat_replication_slots` 视图只包含逻辑复制槽的信息,可用于评估正在执行的工作量。视图的每一行都包含一个逻辑槽的统计信息:
- `slot_name` ——复制槽的唯一标识符;
- `spill_txns` ——由于日志解码时工作内存不足而溢出到磁盘的事务总数。统计顶层事务和嵌套事务(subtransaction);
- `spill_count` ——日志解码时事务溢出到磁盘的总次数。每次事务溢出都会增加计数器,同一事务可能多次溢出;
- `spill_bytes` ——日志解码时溢出到磁盘的已解码数据总量,单位为字节;
- `stream_txns` ——由于日志解码时工作内存不足,数据被发送给订阅端的活动事务总数。因此,只有顶层事务的数据可以这样传输(嵌套事务的数据不会单独在流中传输),所以计数器不统计嵌套事务;
- `stream_count` ——由于日志解码时工作内存不足,活动事务数据被发送给订阅端的总次数。每次以流式方式传输事务数据时,计数器都会增加;同一事务可能以这种方式传输多次;
- `stream_bytes` ——以流式方式传给订阅端的已解码数据总量,单位为字节;
- `total_txns` ——发送给订阅端的已解码事务总数。只统计顶层事务,不统计嵌套事务。计数器同时包括以流式方式传输的事务和溢出的事务;
- `total_bytes` ——发送给订阅端的已解码数据总量,单位为字节。计数器同时包括流式传输事务和溢出事务的数据;
- `stats_reset` ——这组统计信息重置的时间戳。
这些计数器有助于评估逻辑解码相关的工作量和 I/O,并调整参数 *logical\_decoding\_work\_mem*。
下一个工具是 `pg_stat_subscription` 视图,它提供订阅统计信息,可以跟踪接收日志的过程:
- `subid`、`subname` ——订阅的唯一标识符和名称;
- `pid` ——负责订阅的进程;
- `relid` ——当前正在进行初始同步的关系标识符。如果进程处于只应用变更的常规工作模式,该值为空(`NULL`);
- `received_lsn` ——最后一个已由订阅端接收的日志位置;
- `last_msg_send_time` ——订阅端收到的最后一条消息的发送时间;
- `last_msg_receipt_time` ——从发布节点收到的最后一条消息的到达时间;
- `latest_end_lsn` ——订阅端向发布节点确认的最后一个本地日志位置;
- `latest_end_time` ——订阅端向发布节点确认的最后一个本地日志位置对应的时间。
实践中,`pg_stat_subscription` 可以用于跟踪订阅状态以及接收变更的处理速度。
下一个工具是 `pg_stat_subscription_stats` 视图,它有助于跟踪订阅端是否出现错误。复制与更新、删除操作(`UPDATE` 和 `DELETE` 命令)相关的变更时,会使用所谓的*复制标识*,通常基于表的主键值。也可以使用其他唯一键,甚至使用整行代替主键。如果复制变更时违反复制标识的唯一性,例如尝试插入一个表中已经存在的标识符,就会发生*冲突*,并导致错误。冲突不会自动解决;同步或应用变更的进程会停止,需要管理员手动干预。为避免出现此类冲突,初始同步表时,订阅端的表应为空;在复制运行期间,应避免在订阅端修改数据。不过,即使满足这些条件,也应该通过 `pg_stat_subscription_stats` 视图跟踪错误,该视图包含以下字段:
- `subid`、`subname` ——订阅的唯一标识符和名称;
- `apply_error_count` ——正在运行的复制过程中应用变更时发生的错误总数;
- `sync_error_count` ——表初始同步过程中发生的错误总数;
- `stats_reset` ——这组统计信息重置的时间戳。
发布与订阅机制刚加入时,这类错误只能记录在服务器日志中,需要对日志进行处理和分析。增加 `pg_stat_subscription_stats` 后,跟踪这类错误变得更加容易。
## 7.3. 恢复冲突 {#mon-section-7-3}
物理复制的一种使用场景是分摊负载:应用程序的一部分查询在主库上执行,另一部分查询(读取查询)在副本上执行,从而更高效地利用整个数据库集群的计算资源。
在承担读负载的副本上重放变更时,下一条日志记录的应用可能导致查询无法继续执行。这样的情况称为*恢复冲突*(recovery conflict)。数据库管理系统面临一个选择:继续执行查询,同时暂停变更应用(也就是暂停复制),还是取消查询并应用变更。数据库管理系统的处理方式是:将变更应用暂停 *max\_standby\_streaming\_delay* 的时长(默认 30 秒),给查询留出完成的机会。如果查询在这段时间内未能完成,数据库管理系统就会强制终止查询并恢复应用变更。需要注意,在这段延迟倒计时期间,数据库管理系统仍会从主库接收新的日志记录,但不会应用它们。理想情况下,导致复制延迟的查询很少出现,而查询执行期间积累的滞后会很快补回来。最糟糕的情况是,大量并发查询导致日志记录应用不断推迟:一个冲突查询结束后,同一条日志记录可能又与下一个查询发生冲突,使滞后不断积累。
如果查询被强制取消,应用程序会收到错误,该错误也会记录在服务器日志中:
```text {label="text"}
ERROR: canceling statement due to conflict with recovery
DETAIL: User query might have needed to see row versions that must be removed.
```
从归档恢复时也可能发生恢复冲突,此时日志段不是通过流复制传输,而是从 WAL 归档复制。在这种情况下,滞后时间由 *max\_standby\_archive\_delay* 决定,默认同样为 30 秒。
如何处理这些错误取决于业务要求:需要判断两种代价中哪一种更小,是落后于主库,还是中断查询。如果更重视查询无错误完成,可以增大 *max\_standby\_streaming\_delay* 的值,但这可能导致副本进一步滞后。反过来,如果不能容忍副本滞后(例如副本是故障切换的主要候选节点),则可以忽略错误,或在应用侧处理错误,将失败的查询重试到主库上。另一种常见方案是使用一个允许极大滞后的独立副本,它可能严重落后。这个副本主要用于执行长时间查询,不参与故障切换过程。
除了服务器日志,还可以通过 `pg_stat_database.conflicts` 跟踪恢复冲突:该计数器按数据库统计所有类型的冲突。更具体的冲突原因可以在 `pg_stat_database_conflicts` 视图中查看。这个视图只对副本有意义,因为冲突只会在那里发生。视图包含数据库列表,以及每类冲突的计数器:
- `datid`、`datname` ——数据库的唯一标识符和名称;
- `confl_tablespace` ——因表空间被删除而取消的查询总数;
- `confl_lock` ——因锁超时到期而取消的查询总数;
- `confl_snapshot` ——因数据快照过时而取消的查询总数;
- `confl_bufferpin` ——因共享缓存中的缓冲区被固定而取消的查询总数;
- `confl_deadlock` ——因发生死锁而取消的查询总数。
通常,恢复冲突被视为错误;当 `pg_stat_database.conflicts` 中出现非零值时,可以进一步借助服务器日志(哪些查询引发了冲突)和 `pg_stat_database_conflicts` 视图(发生了哪些具体冲突)调查细节和原因。
恢复冲突可能由主库上发生的不同事件引起。实践中最常见的是因清理而取消查询:清理过时行版本产生的变更传到副本时,副本上正在执行的查询仍然需要这些版本(`confl_snapshot` 计数器)。这通常是处理大量数据的长时间分析查询,因此执行时间可能无法预测,并且需要大量资源。取消并重试这类查询可能在资源和等待结果的时间上代价很高。为了减少查询被取消的概率,可以单独采取或同时采取两项措施。第一,增大允许的滞后时间 *max\_standby\_streaming\_delay*。第二,启用反馈 *hot\_standby\_feedback*。通过反馈,walsender 进程会从副本收到它所需的界限,并在删除过时行版本时考虑该界限(如果未使用复制槽,该界限显示在 `pg_stat_replication.backend_xmin` 中;如果使用复制槽,则显示在 `pg_replication_slots.xmin` 中)。这样就不会发生与这些变更冲突的情况(关于事务界限的详细说明,参见介绍清理的第 [8](/08-vacuum/#mon-chapter-8) 章)。不过,这两种方法都不能保证查询 100% 执行成功,而且都会带来一定的负面影响。增大滞后时间可能导致滞后增加;如果查询执行时间超过这个滞后时间,查询仍会被取消(极端情况下,可以将参数设置为 −1,让副本无限等待)。反馈只能保证免受清理影响,但清理推迟会使表膨胀;此外,仍有其他原因可能导致冲突并随后取消查询。因此不存在理想的解决方案,应根据业务要求,在允许取消查询和允许副本滞后之间作出取舍。对于分析查询,一个折中办法是创建一个允许较大滞后时间的独立副本,但不要将其用于选择主库。这样可以容忍较大的滞后;同时可以不启用反馈,从而尽量减少膨胀效应。
## 总结 {#mon-p193-h589}
- 复制几乎总是用于生产环境。
- 复制基于传输 WAL 日志运行。
- 复制分为物理复制和逻辑复制。
- `pg_stat_replication` 是跟踪复制的主要工具。
- 在副本上跟踪复制时使用 `pg_stat_wal_receiver`。
- 复制滞后是最常见的问题。
- 复制滞后量可以按字节或秒进行测量。
- 复制槽可以排除副本不可逆滞后的风险,但会增加磁盘空间耗尽的风险。
- 使用 `pg_replication_slots` 视图跟踪复制槽。
- 逻辑复制使用发布与订阅模型。
- 可以使用 `pg_stat_replication_slots` 视图跟踪逻辑复制槽。
- 可以使用 `pg_stat_subscription` 和 `pg_stat_subscription_stats` 视图跟踪订阅。
- 在副本上执行查询时可能发生恢复冲突。
- 可以使用 `pg_stat_database` 和 `pg_stat_database_conflicts` 视图跟踪恢复冲突。
[^mon-176-1]: [postgrespro.ru/docs/postgresql/current/sql-createpublication]()
[^mon-176-2]: [postgrespro.ru/docs/postgresql/current/sql-createsubscription]()
[^mon-180-1]: [postgrespro.ru/docs/postgrespro/15/runtime-config-replication#GUC-SYNCHRONOUS-STANDBY-NAMES]()
[^mon-189-1]: [postgrespro.ru/docs/postgresql/current/logical-replication]()