6 预写式日志
说明
本章将讨论:
什么是预写式日志;
PostgreSQL 中预写式日志的结构;
如何跟踪与日志相关的活动;
pg_stat_wal 视图;
使用查询跟踪日志写入;
归档日志段;
pg_stat_archiver 视图;
如何跟踪日志归档问题;
跟踪日志归档队列。
本章将介绍预写式日志,也称为预写日志(Write-Ahead Log,WAL),它以某种形式存在于大多数数据库管理系统中。概括地说,预写式日志记录了数据库管理系统中发生的所有数据变更历史。发生故障时,可以利用这段历史重放故障前的全部变更序列,恢复数据库管理系统最新且一致的状态。本章先简要介绍日志的结构(下文在本章中提到“日志”时,均指 WAL,而不是数据库管理系统的服务器日志),再详细介绍跟踪与日志相关事件的工具和方法。
6.1. Write-Ahead Log — 预写式日志
为了保证可靠性,数据库管理系统中的所有数据变更都必须写入可靠的存储(通常是磁盘)。即使系统发生故障,也不能允许数据出现错误、损坏,更不能丢失数据。为了满足这些要求,几乎所有数据库管理系统都使用预写式日志。在 PostgreSQL 中,日志记录数据变更历史;发生故障时,数据库管理系统利用日志重放这些变更,恢复到故障前最后一个一致状态。
一个数据库实例由许多后端进程和后台进程组成,它们处理位于共享内存中的数据,其中包括存储用户数据的缓冲区 缓存和系统数据结构。应用程序发送查询,数据库管理系统执行这些查询。对于读取查询,数据库管理系统访问数据并返回所需的行集;对于修改数据(或模式)的查询,数据库管理系统执行相应的变更。所有变更都发生在共享内存中,随后后台写入进程或检查点进程以延迟方式将缓存中的变更同步到主存储。数据库管理系统的共享内存属于易失性存储,其内容无法抵御断电等系统故障。此外,还存在一类软件错误,会损坏共享内存区域,需要将其完全清理并重新创建——通常是段错误(segmentation fault)。操作系统异常终止数据库管理系统进程也会造成类似后果。这类故障通常突然发生,无法提前做好准备,也无法预知它会在什么时候发生。因此,数据库管理系统需要一种工具,用来恢复那些已经在共享内存中发生、但因故障未能写入主存储的数据变更。
然而,数据库管理系统可能长期运行,不可能保存全部变更历史(否则就需要投入大量甚至不合理的经济成本)。为了重复使用日志文件并将日志控制在合理大小,系统会使用检查点:检查点之前的所有变更都已可靠写入主数据存储,后者被视为可靠存储。检查点成功完成的标记也会写入日志,之后可以删除检查点之前的一部分日志。发生故障时,只需重放检查点之后写入日志的变更,将系统恢复到故障发生前的状态。
实际上,日志是一组位于主数据目录 pg_wal 子目录中的文件(日志段):
# ls -l /var/lib/postgresql/data/pg_wal/
total 196616
-rw-------    1 postgres postgres       341 Nov  4 05:03 000000010000000000000011.0001F7A0.backup
-rw-------    1 postgres postgres  16777216 Nov 18 05:26 000000010000004B000000C2
-rw-------    1 postgres postgres  16777216 Nov 18 05:27 000000010000004B000000C3
-rw-------    1 postgres postgres  16777216 Nov 18 05:28 000000010000004B000000C4
-rw-------    1 postgres postgres  16777216 Nov 18 05:28 000000010000004B000000C5
-rw-------    1 postgres postgres  16777216 Nov 18 05:29 000000010000004B000000C6
-rw-------    1 postgres postgres  16777216 Nov 18 05:30 000000010000004B000000C7
-rw-------    1 postgres postgres  16777216 Nov 18 05:31 000000010000004B000000C8
-rw-------    1 postgres postgres  16777216 Nov 18 05:32 000000010000004B000000C9
-rw-------    1 postgres postgres  16777216 Nov 18 05:24 000000010000004B000000CA
-rw-------    1 postgres postgres  16777216 Nov 18 05:20 000000010000004B000000CB
-rw-------    1 postgres postgres  16777216 Nov 18 05:25 000000010000004B000000CC
-rw-------    1 postgres postgres  16777216 Nov 18 05:23 000000010000004B000000CD
drwx------    2 postgres postgres      4096 Nov 18 05:31 archive_status
所有日志段的名称都是不带扩展名的 24 个十六进制数字。名称由三个八位组组成(以日志段 000000010000004B000000CD 为例):
00000001——时间线标识符(timeline ID)。时间点恢复机制(Point-in-Time Recovery,PITR)使用时间线 。
0000004B——日志段高位范围标识符,取值范围为 00000000 至 FFFFFFFF。
000000CD——日志段低位范围标识符,取值从 00000000 开始;最后一个编号取决于初始化主数据目录时指定的日志段大小。
每个日志段的大小固定(参见 wal_segment_size),默认为 16 MB。每个日志段内部又划分为 8 KB 的块(参见 wal_block_size)。初始化集簇时可以通过参数 --wal-segsize 修改日志段大小。每个块都包含采用不可打印的二进制格式的 WAL 记录(records),用于描述单独的数据变更。每条记录都包含在系统发生故障时重放(重新应用)某个具体变更所需的足够信息。记录可以有不同类型,并对应各种对象的变更。可以使用 pg\_waldump 工具或 pg_walinspect 扩展分析日志内容。这两个工具提供相同的功能,但前者只能在终端环境中使用,而扩展提供了 SQL 接口,能够更灵活地分析结果:
# SELECT * FROM pg_get_wal_records_info('4B/DF000000','4B/E0000000') LIMIT 14;
  start_lsn  |   end_lsn   |  prev_lsn   |   xid    | resource_manager | record_type | record_length | main_data_length | fpi_length |
-------------+-------------+-------------+----------+------------------+-------------+---------------+------------------+------------+-----------...
 4B/DF000350 | 4B/DF0003F8 | 4B/DEFFE370 | 43601290 | Heap             | HOT_UPDATE  |           163 |               14 |          0 | off 88 xma...
 4B/DF0003F8 | 4B/DF000448 | 4B/DF000350 | 43601290 | Heap             | HOT_UPDATE  |            78 |               14 |          0 | off 22 xma...
 4B/DF000448 | 4B/DF000498 | 4B/DF0003F8 | 43601290 | Heap             | HOT_UPDATE  |            74 |               14 |          0 | off 111 xm...
 4B/DF000498 | 4B/DF0004E8 | 4B/DF000448 | 43601290 | Heap             | INSERT      |            79 |                3 |          0 | off 43 fla...
 4B/DF0004E8 | 4B/DF000518 | 4B/DF000498 | 43601290 | Transaction      | COMMIT      |            46 |               20 |          0 | 2022-11-18...
 4B/DF000518 | 4B/DF0024E8 | 4B/DF0004E8 |        0 | Heap2            | PRUNE       |          8119 |                8 |       8060 | latestRemo...
 4B/DF0024E8 | 4B/DF002590 | 4B/DF000518 | 43601291 | Heap             | HOT_UPDATE  |           163 |               14 |          0 | off 104 xm...
 4B/DF002590 | 4B/DF0025E0 | 4B/DF0024E8 | 43601291 | Heap             | HOT_UPDATE  |            78 |               14 |          0 | off 71 xma...
 4B/DF0025E0 | 4B/DF002630 | 4B/DF002590 | 43601291 | Heap             | HOT_UPDATE  |            74 |               14 |          0 | off 133 xm...
 4B/DF002630 | 4B/DF002680 | 4B/DF0025E0 | 43601291 | Heap             | INSERT      |            79 |                3 |          0 | off 27 fla...
 4B/DF002680 | 4B/DF0026B0 | 4B/DF002630 | 43601291 | Transaction      | COMMIT      |            46 |               20 |          0 | 2022-11-18...
 4B/DF0026B0 | 4B/DF004680 | 4B/DF002680 |        0 | Heap2            | PRUNE       |          8119 |                8 |       8060 | latestRemo...
 4B/DF004680 | 4B/DF004728 | 4B/DF0026B0 | 43601292 | Heap             | HOT_UPDATE  |           163 |               14 |          0 | off 78 xma...
 4B/DF004728 | 4B/DF004778 | 4B/DF004680 | 43601292 | Heap             | HOT_UPDATE  |            78 |               14 |          0 | off 179 xm...
每条记录都有唯一的 LSN(日志序列号,log sequence number)。可以把这个标识符当作 WAL 中的位置,据此确定记录在日志中的位置。以记录 4B/DF0026B0 为例:
可以使用 pg_walfile_name 函数并向其传入 LSN,确定某条记录所在的日志段:
# SELECT pg_walfile_name('4B/DF008B78');
     pg_walfile_name
--------------------------
 000000010000004B000000DF
在数据库管理系统运行期间,数据不断发生变更,新的记录会写入日志,当前的位置(用 LSN 表示)也会不断向前移动。记录插入后,还需要将新增记录可靠地写入主存储。可以使用几个函数获取日志记录的当前位置:
pg_current_wal_insert_lsn——最后插入日志的记录所在的位置;
pg_current_wal_lsn——最后写入磁盘的记录所在的位置;
pg_current_wal_flush_lsn——最后写入并与磁盘同步的记录所在的位置。
日志段填满后,写入会从下一个顺序排列的日志段开始。
WAL 的大小受配置参数限制,正常运行时日志段数量会在某个范围内波动。在负载高峰期,尤其是涉及数据变更的高峰期,可能会创建额外的日志段,从而使日志大小增加。当负载恢复正常并完成检查点后,日志大小会重新调整——多余的日志段要么被删除,要么被重命名,以便将来复用;因此,日志大小会缩小到数据库管理系统配置指定的范围。下面的列表中可以根据时间戳看出,当前正在向日志段 000000010000004B000000FC 写入,而编号更大但时间更早的日志段已预留给近期使用——当前日志段填满后,数据库管理系统就会切换到下一个日志段。
# ls -l /var/lib/postgresql/data/pg_wal/
total 196616
-rw-------    1 postgres postgres       341 Nov  4 05:03 000000010000000000000011.0001F7A0.backup
-rw-------    1 postgres postgres  16777216 Nov 18 06:21 000000010000004B000000F5
-rw-------    1 postgres postgres  16777216 Nov 18 06:22 000000010000004B000000F6
-rw-------    1 postgres postgres  16777216 Nov 18 06:23 000000010000004B000000F7
-rw-------    1 postgres postgres  16777216 Nov 18 06:24 000000010000004B000000F8
-rw-------    1 postgres postgres  16777216 Nov 18 06:25 000000010000004B000000F9
-rw-------    1 postgres postgres  16777216 Nov 18 06:26 000000010000004B000000FA
-rw-------    1 postgres postgres  16777216 Nov 18 06:27 000000010000004B000000FB
-rw-------    1 postgres postgres  16777216 Nov 18 06:28 000000010000004B000000FC <<< активный сегмент
-rw-------    1 postgres postgres  16777216 Nov 18 06:17 000000010000004B000000FD
-rw-------    1 postgres postgres  16777216 Nov 18 06:16 000000010000004B000000FE
-rw-------    1 postgres postgres  16777216 Nov 18 06:19 000000010000004B000000FF
-rw-------    1 postgres postgres  16777216 Nov 18 06:18 000000010000004C00000000
drwx------    2 postgres postgres      4096 Nov 18 06:27 archive_status
日志既可以由后端进程写入,也可以由后台进程 walwriter 写入。默认情况下,所有变更都由后端进程写入日志。这可能发生在使用 COMMIT 命令提交事务时,或者 WAL 缓冲区填满时(参见 wal_buffers)。这种写入称为同步写入:在发送下一条命令或查询之前,客户端必须等待日志写入完成。数据库管理系统的设置允许改变这一行为,使用异步事务提交(参见 synchronous_commit)。在这种模式下,日志写入交给后台运行的 walwriter 进程。将日志写入任务交给后台进程后,后端进程无需等待写入完成,就可以立即向服务器发送下一条命令。不过需要注意,在这种模式下,如果发生故障,仍可能丢失尚未由 walwriter 进程写入的最后几个事务。事务提交设置在复制场景下还提供其他几种模式。详细说明请参见文档。关于 WAL 的工作方式,还可以参阅完整资料 。
6.2. 跟踪日志活动
预写式日志是数据库管理系统的重要组成部分,管理员需要了解与它相关的活动。日志写入会影响事务持续时间,因此为了保证数据库管理系统的良好性能,日志写入应当快速完成且不产生延迟。还可能有其他问题:日志写入量是多少?写入需要多长时间?不同类型的查询分别产生了多少日志写入量?
可以使用多个工具跟踪与日志相关的活动:
pg_waldump 和 pg_walinspect——用于详细分析日志的工具,更适合调试、查找问题或教学;
pg_stat_wal——与日志相关活动的总体统计信息;
pg_stat_statements——这个成熟的扩展还提供按查询类型划分的日志相关统计信息;
EXPLAIN ANALYZE——用于输出查询计划的工具,指定 WAL 参数后可以显示有关日志写入的附加信息。
从定期监控的角度看,pg_stat_wal 和 pg_stat_statements 视图尤其值得关注,下面将对它们作更详细的介绍。
pg_stat_wal 视图
pg_stat_wal 视图只包含一行:
# TABLE pg_stat_wal;
-[ RECORD 1 ]----+------------------------------
wal_records      | 322508636
wal_fpi          | 46090986
wal_bytes        | 393680012729
wal_buffers_full | 15545
wal_write        | 48958771
wal_sync         | 48846599
wal_write_time   | 5697276.907
wal_sync_time    | 486414839.104
stats_reset      | 2022-11-04 05:01:49.427562+00
统计信息是累积的,包含以下内容:
wal_records——写入日志的记录总数;
wal_fpi——写入的 FPI 页面总数(full page image,整页镜像);
wal_bytes——写入日志的数据总量,单位为字节;
wal_buffers_full——因 WAL 缓冲区填满而将数据写入日志的次数;
wal_write——将数据从 WAL 缓冲区写入时执行的输入/输出操作次数;
wal_sync——将 WAL 段与主存储同步的请求次数;
wal_write_time——将 WAL 缓冲区内容写入主存储所耗费的时间,单位为毫秒。如果参数 wal_sync_method 设置为 open_datasync 或 open_sync,其中可能包括同步所耗费的时间;
wal_sync_time——将日志段同步到主存储所耗费的时间,单位为毫秒;
stats_reset——重置统计信息的时间戳。
只有启用 track_wal_io_timing 参数后,才会跟踪时间统计信息。根据该视图的数据,可以跟踪与日志相关的活动、写入量和写入时长,以及表明 WAL 缓冲区空间不足的情况;后者可能促使我们重新考虑 wal_buffers 参数的设置。
根据这些统计信息中的指标,可以绘制数据库实例层面的总体 WAL 活动图表。
图 6.1 展示了写入日志的普通记录和 FPI 页面的数量。可以看到,日志写入量很稳定,没有明显的峰值。同时还可以看到,FPI 页面的写入流量持续呈锯齿状。峰值持续时间在五分钟以内,这与默认的 checkpoint_timeout 值相符。强制执行检查点在视觉上不会影响 FPI 页面的写入量,在图表中也看不出来。
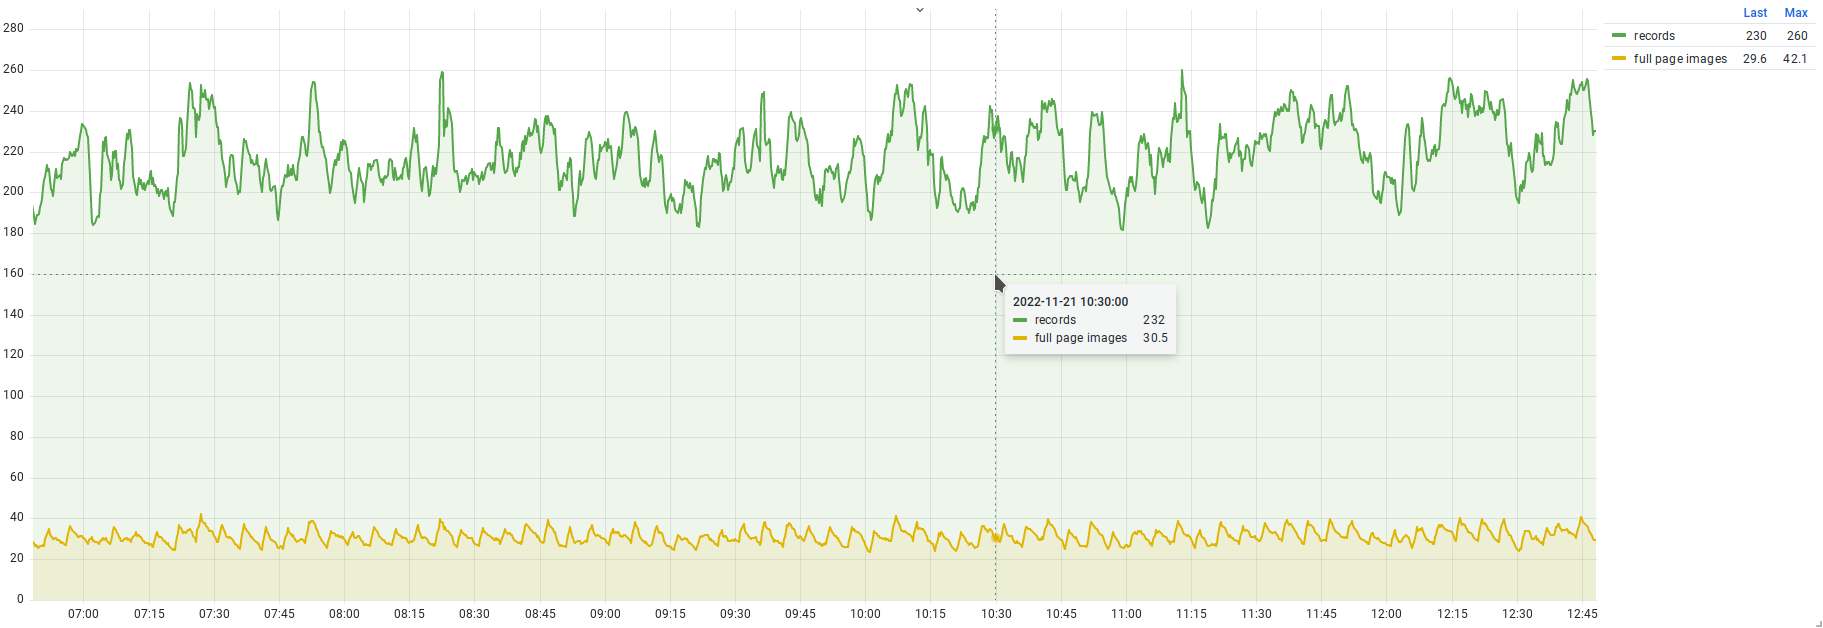 图 6.1 写入日志的普通记录和 FPI 页面的数量
图 6.2 展示了以字节为单位的日志写入量,负载同样比较平稳。不过仔细观察可以发现,这张图与上一张图一样,呈现出五分钟间隔的锯齿状。可以利用这样的图表将日志写入量可视化。
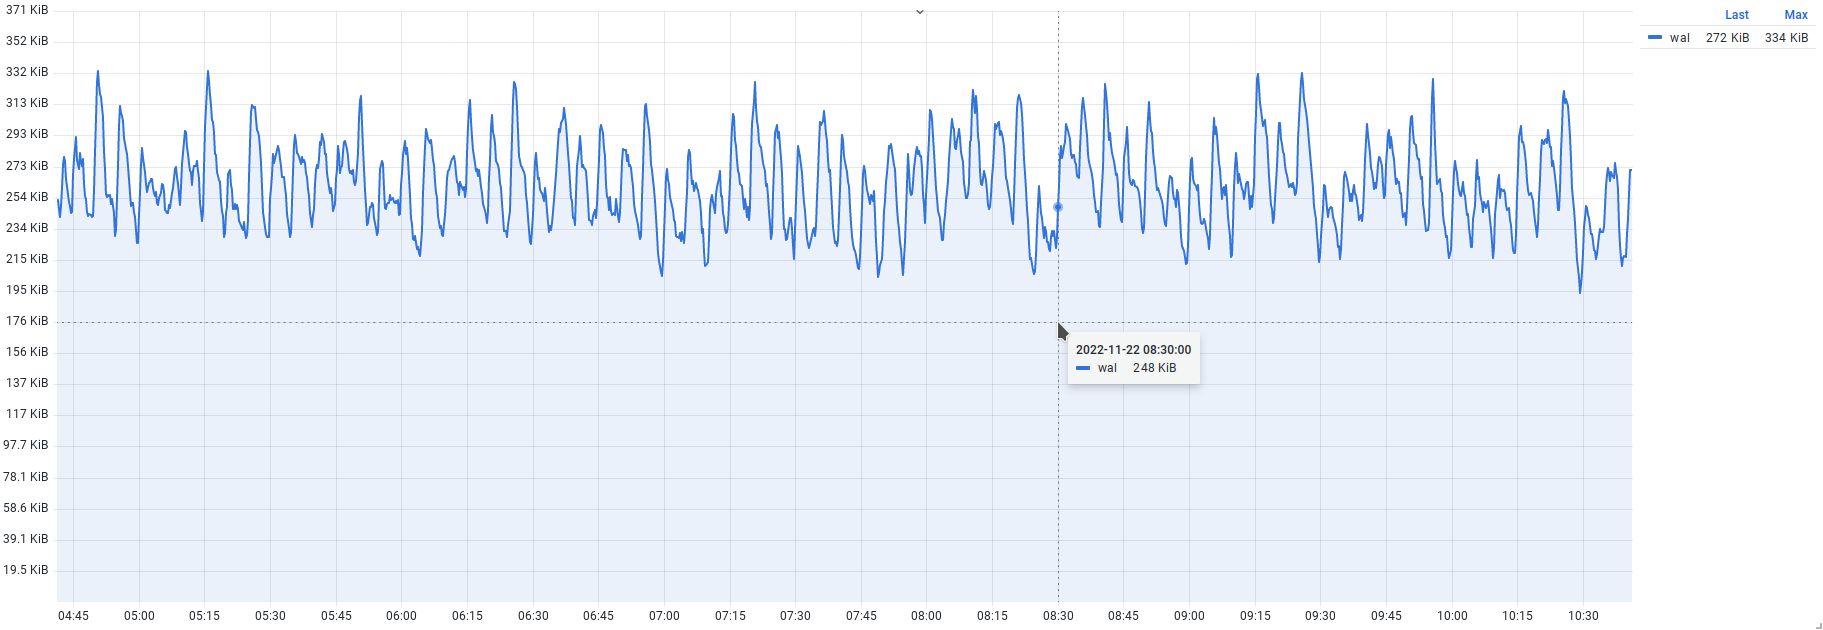 图 6.2 日志写入量(字节)
图 6.3 展示了从缓冲区向日志写入数据的操作次数,以及随后进行的段同步次数。图表左侧的写入操作次数与同步次数相同。这是因为每个事务完成时都会执行写入及随后的同步。旁边还显示了已提交事务的数量(蓝色的 commits 线),它与其他指标几乎重合。图表右侧,在事务流量不变的情况下,段同步次数大幅减少,经过一段时间后又恢复到原来的水平。写入操作次数也有所减少,但幅度没有那么大。在这段时间内启用了异步事务提交模式(synchronous_commit = off)。在这种模式下,日志写入和段同步任务交给 walwriter 进程,由它根据自身设置执行这些任务。
写入和同步所耗费的时间同样很重要(图 6.4)。
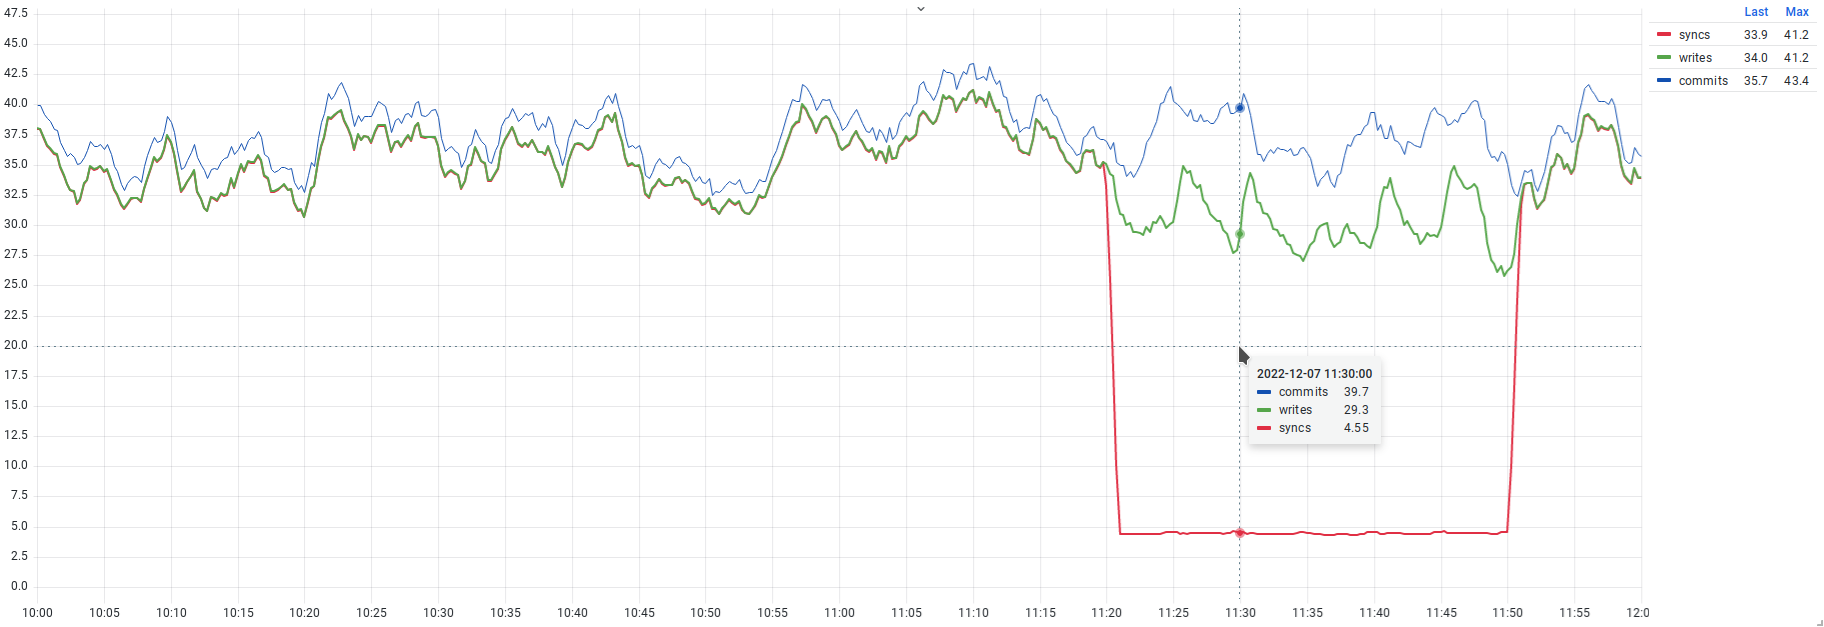 图 6.3 从 WAL 缓冲区写入的操作次数、段同步次数和已提交事务数
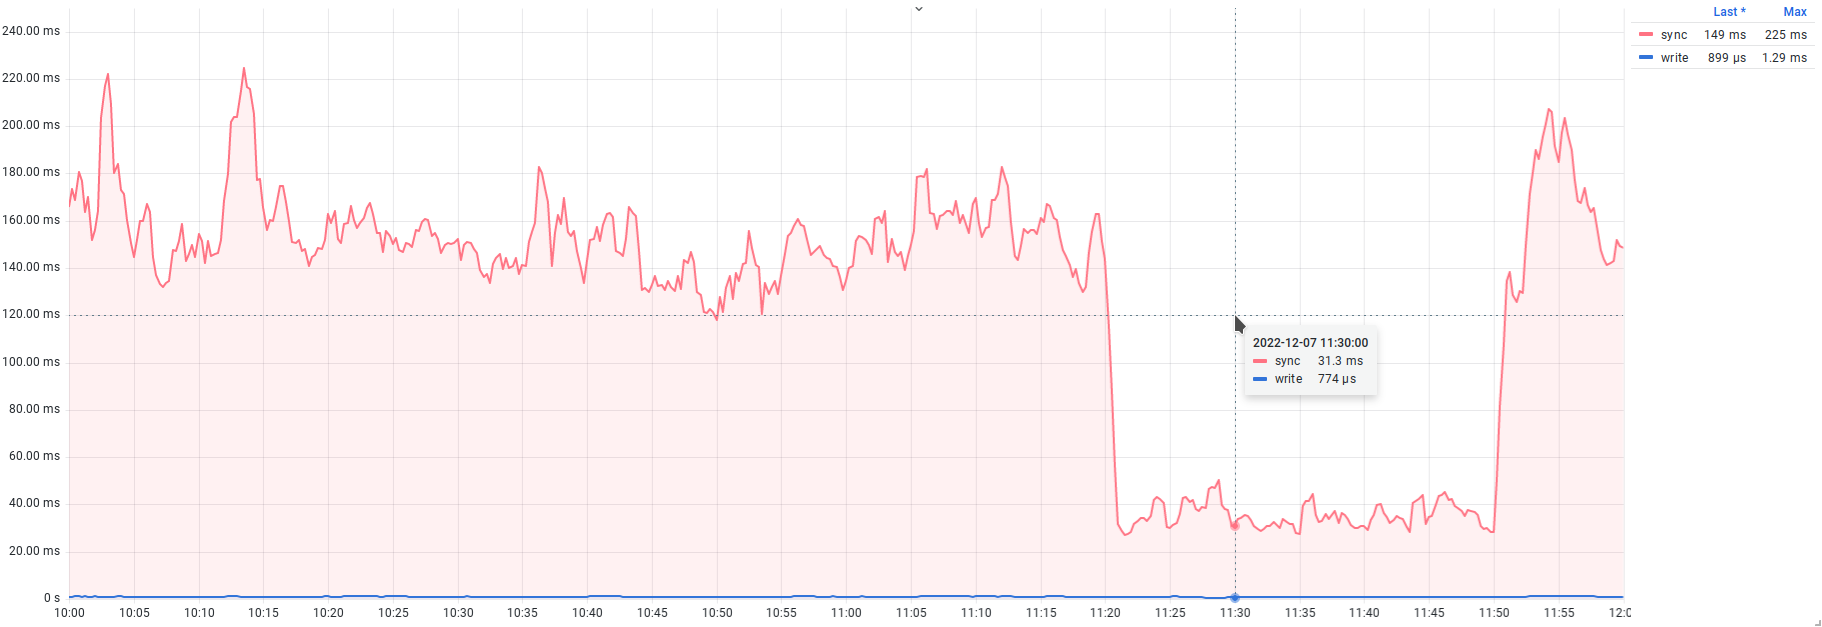 图 6.4 日志写入和段同步所耗费的时间
在这样的图表中,重要的是跟踪峰值,并找出数据库管理系统写入日志所耗费时间异常增加的原因。
关闭同步事务提交也会影响时间。当日志由后台 walwriter 进程以异步方式写入时,随着同步次数减少,段同步所耗费的时间也会减少。关闭同步事务提交常被用作一种性能优化手段:把事务提交确认的职责从后端进程转移给后台进程。节省下来的时间可以用于执行更多查询,从而提高数据库管理系统的总体吞吐量。
pg_stat_statements 视图
如果说 pg_stat_wal 视图包含数据库管理系统层面的总体统计信息,那么在 pg_stat_statements 视图中,可以找到按查询类型划分的类似统计信息:
上述字段包含每一种具体查询类型的写入统计信息。利用这些信息,可以分析 WAL 的组成,并回答这样的问题:哪些查询写入日志的量最大?
# SELECT
    pg_size_pretty(sum(wal_bytes)) AS wal_volume,
    left(query, 64) AS query_trunc
  FROM pg_stat_statements
  GROUP BY query
  ORDER BY sum(wal_bytes) DESC
  LIMIT 10;
 wal_volume |                           query_trunc
------------+------------------------------------------------------------------
 678 GB     | UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE aid =
 10196 MB   | INSERT INTO pgbench_history (tid, bid, aid, delta, mtime) VALUES
 8219 MB    | UPDATE pgbench_tellers SET tbalance = tbalance + $1 WHERE tid =
 7805 MB    | UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE bid =
 9313 kB    | SELECT abalance FROM pgbench_accounts WHERE aid = $1
 1394 kB    | truncate pgbench_history
 536 kB     | vacuum pgbench_tellers
 375 kB     | select count(*) from pgbench_branches
 250 kB     | vacuum pgbench_branches
 129 kB     | SELECT current_database() AS database, schemaname AS schema, fun
结果表明,产生最大日志写入量的是更新 pgbench_accounts 表中行的查询(678 GB),远远超过排名第二的查询。可以使用下面的查询从监控中获取数据:
# topk_avg(5,
  sum by (queryid,query) (
    rate(postgres_statements_wal_bytes_all_total{
        service_id="primary"
    }[1m]) + on(database,user,queryid) group_left(query)
        0 * postgres_statements_query_info{service_id="primary"}
  ), "other")
图 6.5 证实了对 pg_stat_statements 的查询结果:从变化趋势可以看出,更新 pgbench_accounts 表的查询平均每秒写入约 500 KB,在写入量上明显超过其他查询。
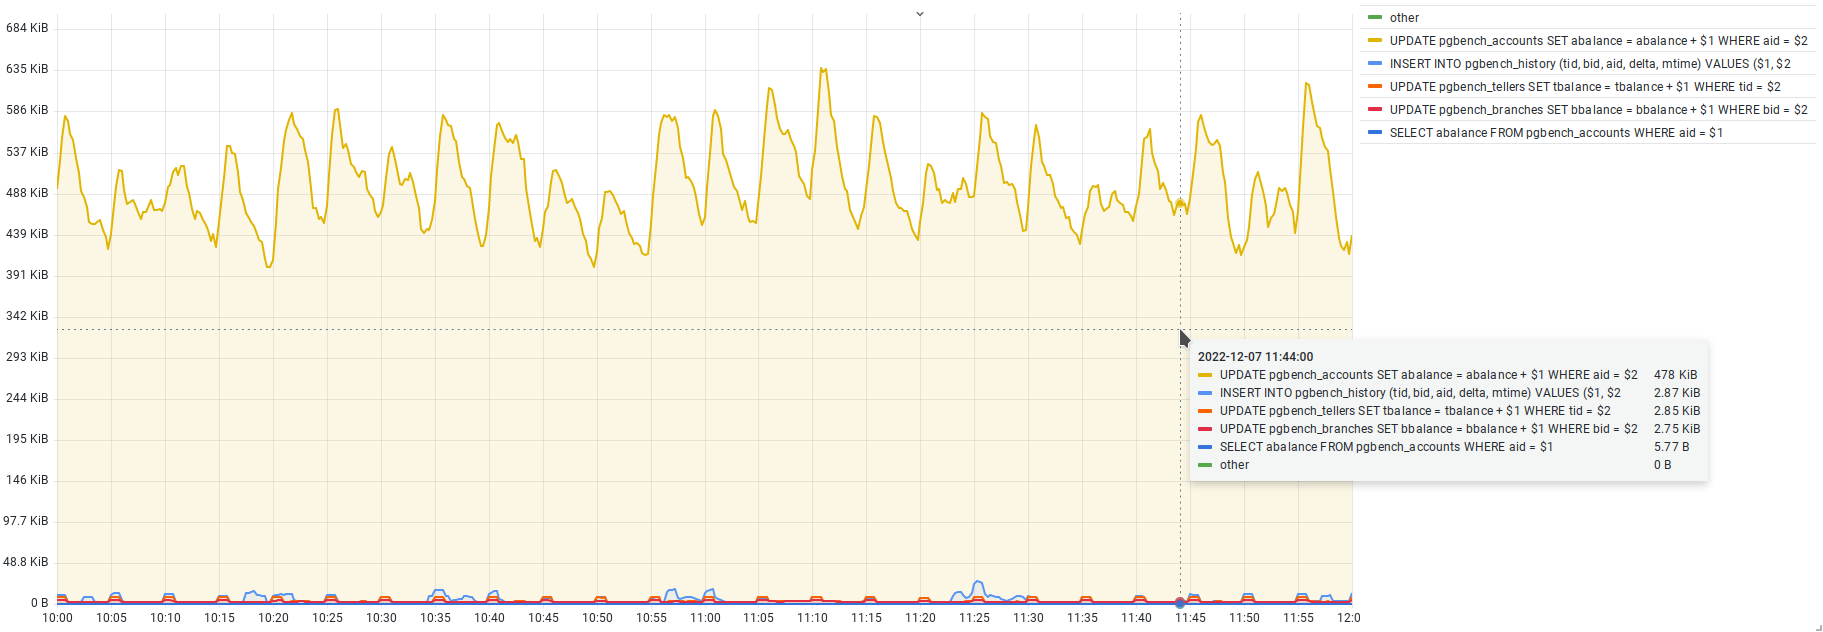 图 6.5 日志写入量较大的查询
6.3. WAL 归档
数据库管理系统在维护日志的同时,会持续保存数据变更历史,以防范潜在的系统故障。还记得吗,发生故障后,数据库管理系统可以通过重放变更,自动恢复数据的一致状态。日志还为数据库管理系统提供了备份的可能。将数据库管理系统的文件与日志段一起备份后,日后可以从创建的备份中恢复数据库管理系统在任意时间点的状态——先恢复文件,再根据日志重放变更。这种方法会带来一些复杂性,但总体上有许多优点。
采用这种方法,需要持续将日志段归档到独立于数据库管理系统的存储中。默认情况下,日志段归档处于关闭状态,需要单独配置。启用归档后,数据库管理系统会启动 archiver 后台进程。当一个日志段写入完成、可以归档时,archiver 会执行参数 archive_command 中指定的命令,并等待命令结束。如果命令执行失败,进程会在一段时间后再次尝试归档该日志段,并持续重试,直到命令成功为止。显然,这可能导致归档故障,使日志段数量不断增加,最终耗尽磁盘空间,并使数据库管理系统在尝试写入日志时异常停止。面对这样的风险,管理员又多了一项职责:监视归档工作、跟踪潜在错误并加以解决。
pg_stat_archiver 视图
可以使用 pg_stat_archiver 视图跟踪归档进程;该视图只有一行,包含以下字段:
archived_count——成功归档的日志段总数;
last_archived_wal——最近成功归档的日志段名称;
last_archived_time——最近一次成功归档日志段的时间戳;
failed_count——归档失败的尝试次数;
last_failed_wal——最近一次归档失败时对应的日志段名称;
last_failed_time——最近一次归档失败的时间戳;
stats_reset——重置统计信息的时间戳。
测试环境配置了伪归档:需要将日志段发送到归档时,会调用 /bin/true 命令;该命令什么也不做,只返回成功退出码。不过,这仍然可以让我们看到归档统计信息:
# TABLE pg_stat_archiver;
-[ RECORD 1 ]------+------------------------------
archived_count     | 45711
last_archived_wal  | 00000001000000B20000009D
last_archived_time | 2022-12-07 06:43:05.091157+00
failed_count       | 21
last_failed_wal    | 000000010000004600000073
last_failed_time   | 2022-11-17 05:52:27.826036+00
stats_reset        | 2022-11-04 05:01:49.427562+00
要想正确使用这些统计信息,必须了解日志归档过程中可能出现的问题类型:
归档端数据传输错误或服务拒绝——此时归档进程无法将日志段传输到存储中;
执行归档命令时出错,例如脚本出错或脚本不存在;
负责将日志段实际发送到归档存储的进程因某些未知原因挂起;
archiver 进程挂起——这种情况不太可能发生,但也不能完全排除。
对于前两种情况,需要跟踪归档失败的尝试次数。如果归档已经中断,还需要了解它处于这种状态的时间。failed_count 和 last_archived_time 字段很适合进行评估。发生错误时,failed_count 计数器会开始增加(而 archived_count 会停止增长)。失败次数增加比没有归档尝试更能说明问题,因为系统可能没有负载、处于空闲状态,此时没有成功的归档尝试也可能是正常的。时间指标也是如此:now() - last_archived_time 的值会一直增加,直到归档恢复,因此也是判断归档是否存在问题的良好指标。
图 6.6 展示了归档成功和失败尝试的次数。失败尝试形成的条带表明,归档在 10 分钟内未正常运行,而日志段仍在不断累积。问题解决后,可以看到积累的日志段被成功归档,形成了一个小峰值。
挂起这类问题更复杂:在这种情况下,命令已经启动,但无法结束,归档进程在等待命令完成。此时 archived_count、failed_count 和 last_failed_time 都不会改变,但 now() - last_archived_time 的值会开始增加,表明归档已经停止。图 6.7 展示了与图 6.6 相同的归档停止情况。日志段通常每 54 秒归档一次,但有一段时间间隔增加到了 11 分钟。
根据上次成功发送距今的时间进行判断,适用于日志写入量大且持续稳定、日志段定期归档的活跃系统。对于活动量较小、日志写入零星且数量不多的系统,两次日志段归档之间可能间隔很长,此时 now() - last_archived_time 的值很大,却不一定表示存在问题。当然,也可以使用超时设置强制归档(参见 archive_timeout):超时后会切换到下一个日志段,并将前一个日志段发送到归档。
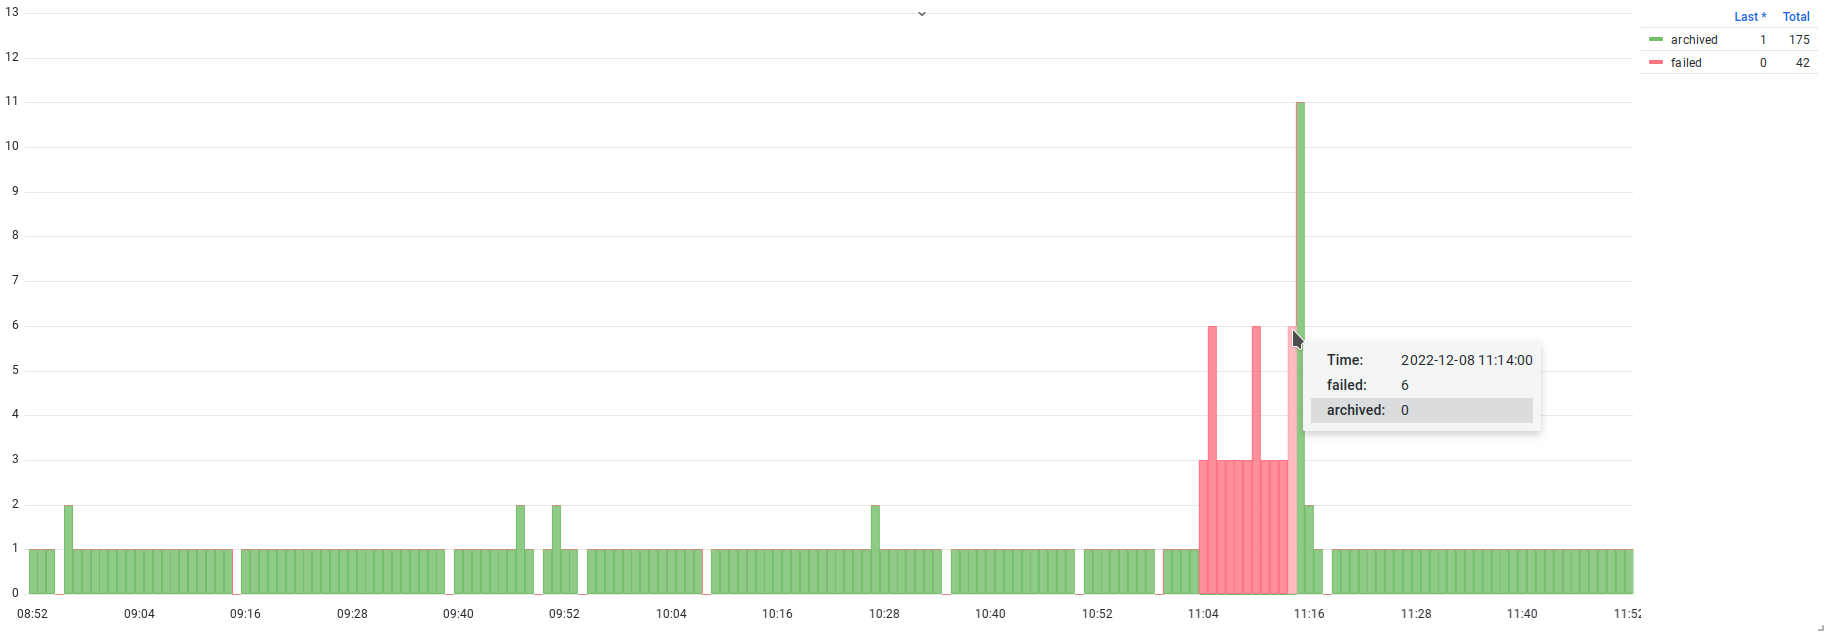 图 6.6 日志段归档的成功与失败尝试
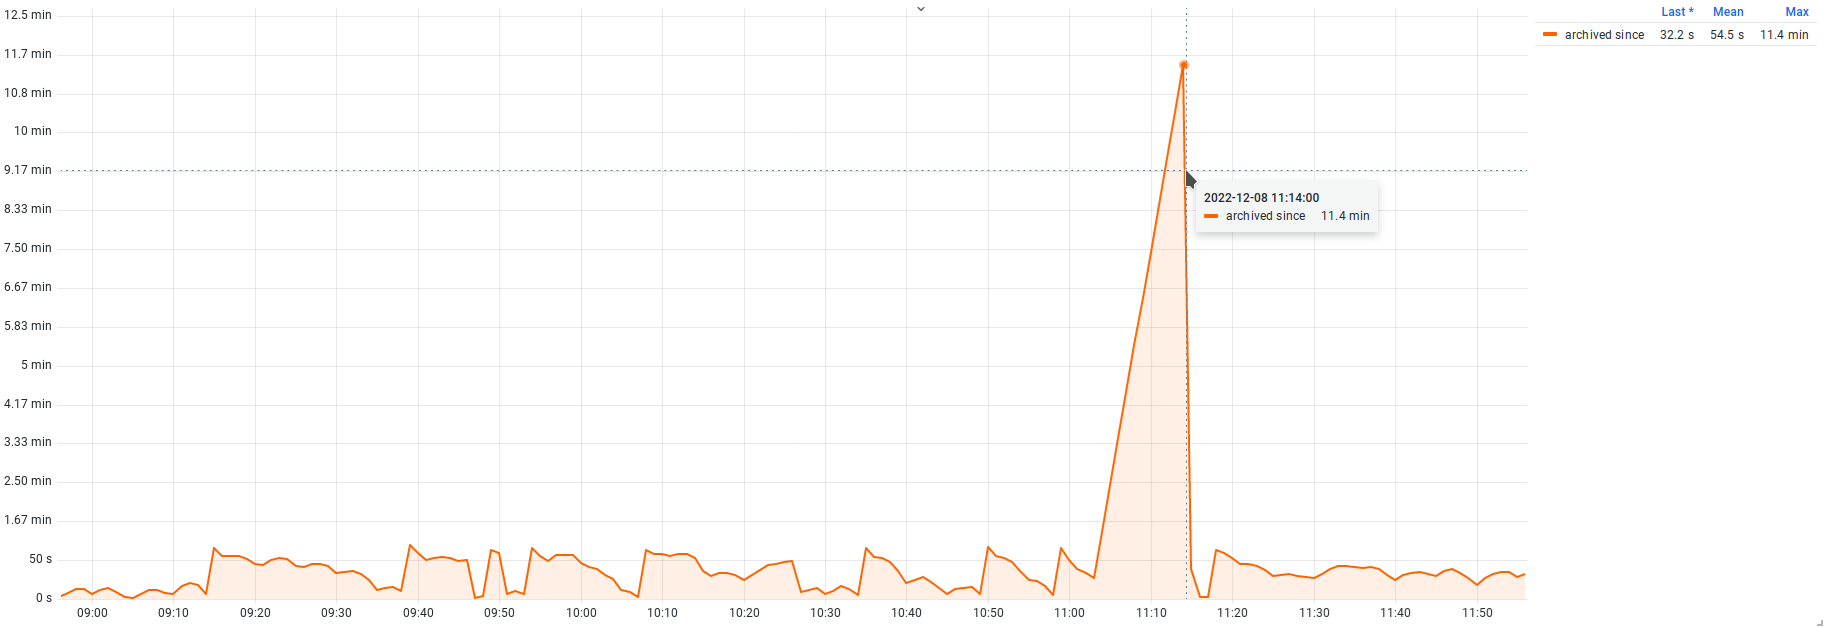 图 6.7 距离上次成功归档日志段的时间
归档队列
前面介绍的归档状态评估方法都依赖最终结果:日志段是否已成功归档。还可以采用另一种方法跟踪归档是否正常工作。这种方法关注待完成的工作量,跟踪等待发送的队列中有多少日志段。如果队列为空,说明一切正常;如果队列不断增长,说明存在问题。要实现这种方法,需要了解主数据目录的文件层次结构。
pg_wal 目录中有一个 archive_status 子目录,其中包含描述具体日志段归档状态的一组文件。
# ls -l /var/lib/postgresql/data/pg_wal/archive_status/
-rw-------    1 postgres postgres         0 Nov  4 05:03 000000010000000000000011.0001F7A0.backup.done
-rw-------    1 postgres postgres         0 Dec  8 06:00 00000001000000B7000000D7.done
-rw-------    1 postgres postgres         0 Dec  8 06:01 00000001000000B7000000D8.done
-rw-------    1 postgres postgres         0 Dec  8 06:02 00000001000000B7000000D9.done
-rw-------    1 postgres postgres         0 Dec  8 06:04 00000001000000B7000000DA.done
-rw-------    1 postgres postgres         0 Dec  8 06:05 00000001000000B7000000DB.done
-rw-------    1 postgres postgres         0 Dec  8 06:06 00000001000000B7000000DC.done
-rw-------    1 postgres postgres         0 Dec  8 06:06 00000001000000B7000000DD.done
-rw-------    1 postgres postgres         0 Dec  8 06:08 00000001000000B7000000DE.done
在这个目录中,我们关注扩展名为 ready 和 done 的文件。ready 状态表示相应日志段已准备好归档,done 状态表示日志段已成功归档。因此,要得到等待发送队列中的日志段数量,只需统计扩展名为 ready 的文件数量即可。还可以将队列大小换算为字节(乘以日志段大小,默认为 16 MB),从而了解待归档日志段占用了多少磁盘空间。可以使用 pg_ls_archive_statusdir 函数,或者使用更通用的 pg_ls_dir 函数进行统计:
# SELECT count(*)
  FROM pg_ls_archive_statusdir()
  WHERE name ~'.ready';
 count
-------
     0
测试环境使用 /bin/true 命令进行伪归档;调用该命令时不会真正复制文件,但这种归档仍会反映在 pg_stat_archiver 统计信息中。为了进行实验,可以把 /bin/true 换成 /bin/false,从而使归档“失效”。
开始实验前,可以先查询统计信息,记录归档正常工作时的状态:
# SELECT *, now() - last_archived_time AS last_archived_age
  FROM pg_stat_archiver;
-[ RECORD 1 ]------+------------------------------
archived_count     | 47058
last_archived_wal  | 00000001000000B7000000E0
last_archived_time | 2022-12-08 06:10:14.254712+00
failed_count       | 0
last_failed_wal    |
last_failed_time   |
stats_reset        | 2022-11-04 05:01:49.427562+00
last_archived_age  | 00:00:09.227001
现在修改 archive_command 参数:
# ALTER SYSTEM SET archive_command TO '/bin/false';
ALTER SYSTEM
# SELECT pg_reload_conf();
 pg_reload_conf
----------------
 t
观察此时统计信息的变化:
# SELECT *, now() - last_archived_time AS last_archived_age
  FROM pg_stat_archiver;
-[ RECORD 1 ]------+------------------------------
archived_count     | 47061
last_archived_wal  | 00000001000000B7000000E3
last_archived_time | 2022-12-08 06:13:06.971114+00
failed_count       | 75
last_failed_wal    | 00000001000000B7000000E4
last_failed_time   | 2022-12-08 06:17:23.115775+00
stats_reset        | 2022-11-04 05:01:49.427562+00
last_archived_age  | 00:04:21.452935
archived_count 计数器停止增长,而 failed_count 开始增加;新增字段 last_archived_age 表示的上次成功归档距今的时间也在增长,已经达到四分钟。检查状态目录中的情况:
# SELECT *
  FROM pg_ls_archive_statusdir() ORDER BY modification;
                     name                      | size |      modification
-----------------------------------------------+------+------------------------
 000000010000000000000011.0001F7A0.backup.done |    0 | 2022-11-04 05:03:21+00
 00000001000000B7000000E0.done                 |    0 | 2022-12-08 06:10:14+00
 00000001000000B7000000E1.done                 |    0 | 2022-12-08 06:11:08+00
 00000001000000B7000000E2.done                 |    0 | 2022-12-08 06:12:06+00
 00000001000000B7000000E3.done                 |    0 | 2022-12-08 06:13:06+00
 00000001000000B7000000E4.ready                |    0 | 2022-12-08 06:14:15+00
 00000001000000B7000000E5.ready                |    0 | 2022-12-08 06:15:17+00
 00000001000000B7000000E6.ready                |    0 | 2022-12-08 06:16:19+00
 00000001000000B7000000E7.ready                |    0 | 2022-12-08 06:17:29+00
出现了扩展名为 ready 的文件。可以统计这些文件,从而确定归档队列中的日志段数量:
# SELECT count(*)
  FROM pg_ls_archive_statusdir() WHERE name ~'.ready';
 count
-------
     4
可以将相应的测量结果绘制成图表(图 6.8):
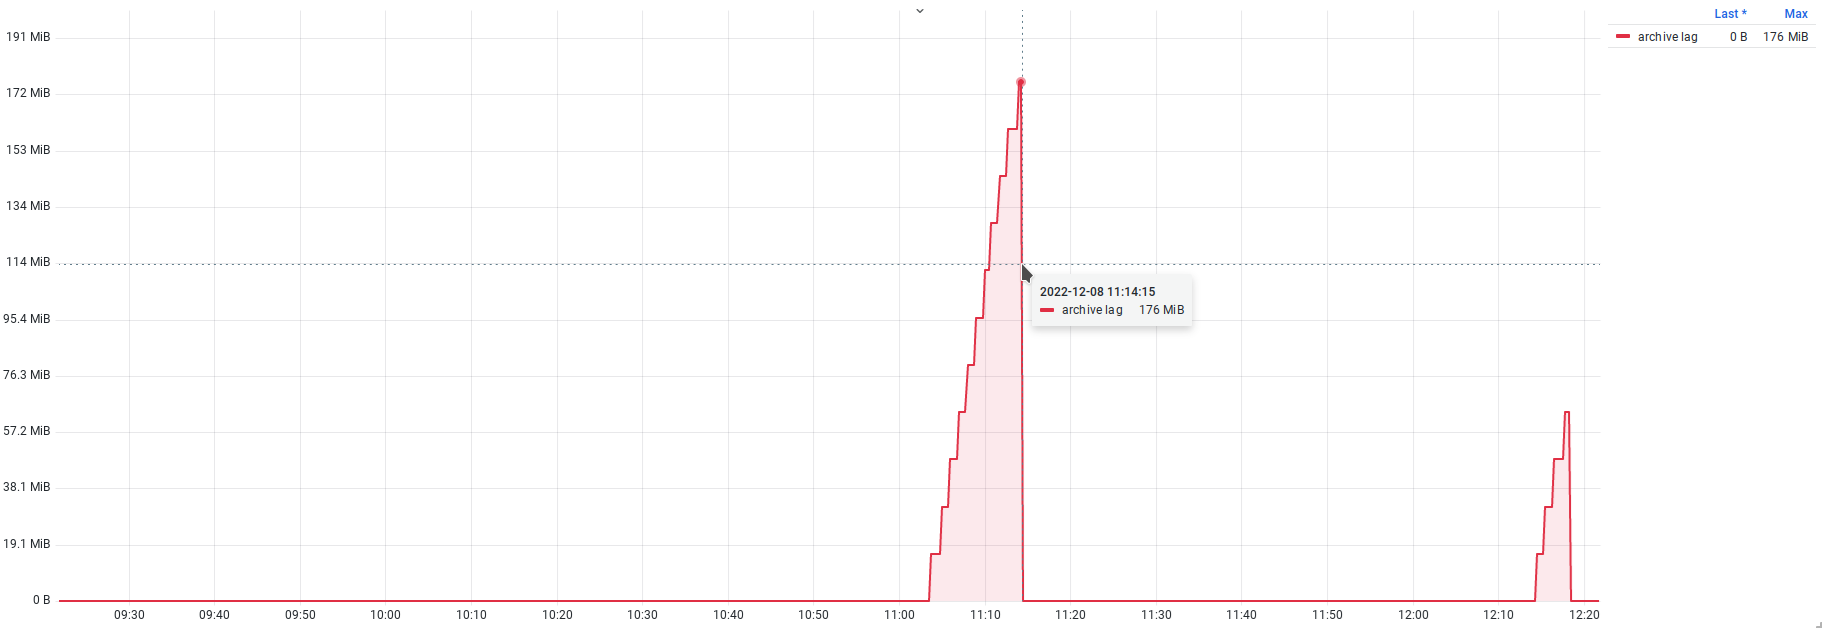 图 6.8 归档队列(字节)
按队列大小监控的方法具有通用性,不受日志活动和写入量影响,既可以跟踪归档错误,也可以发现归档挂起的情况。
实验结束后,不要忘记恢复配置:
# ALTER SYSTEM RESET archive_command;
# SELECT pg_reload_conf();
总结
预写式日志是任何数据库管理系统的重要组成部分,保存了所有变更的历史。
日志由一系列连续的日志段文件组成。
可以使用 pg_waldump 工具和 pg_walinspect 扩展详细分析日志内容。
可以使用 pg_stat_wal 视图跟踪与日志相关的总体活动。
pg_stat_statements 包含针对具体查询的日志写入统计信息。
日志还用于备份和复制。
可以为备份和恢复任务归档日志。
可以使用 pg_stat_archiver 视图跟踪归档。
跟踪归档队列是发现问题最通用的方法。