4 数据库
本章将讨论:
数据库管理系统对象的层次结构;
数据库集簇、表空间、数据库、模式、表和索引;
关系;
关系的辅助结构——TOAST、可见性映射和空闲空间映射;
表和索引层面的工作负载;
多余的表顺序扫描;
数据库集簇中的错误和不良事件;
用于确定对象大小的函数;
用于输出数据库集簇辅助目录内容的函数。
上一章我们把查询视为任何工作负载的基础,并介绍了与查询相关的统计信息和活动监控。工作负载的另一面是用户数据。查询中会指定要从中读取数据、以及要向其中保存数据的具体表。本章将从访问数据库管理系统对象的角度考察活动统计信息,并跟踪发生在这些对象——数据库、表和索引——上下文中的事件。
4.1. 数据库管理系统对象的层次结构
数据库管理系统的主要任务之一,是可靠地保存数据并提供对数据的访问。在数据库管理系统层面,表和其他类型的对象负责组织和存储数据,每种对象都有自己的用途。所有这些对象构成了数据组织的逻辑层。不过,数据库管理系统并不是一个自给自足的实体,必须依托操作系统提供的工具、抽象和资源。从操作系统角度看,数据库管理系统的数据位于文件系统中,并使用块设备。在物理层面,所有表、索引以及数据库管理系统的许多其他抽象,都只是磁盘上的文件和目录。
接下来我们将考察数据库管理系统如何组织数据存储。这有助于更好地理解工作负载的组成(负载落在哪些数据库管理系统对象上),并更有意识地从对象和数据的使用角度构建工作负载监控。熟悉内部存储结构的资深管理员可以直接跳到 4.2 节。
数据库集簇
首先要考察的是数据库集簇(database cluster)这一概念。集簇是数据库以及供它们共同使用的全局对象的统一且不可分割的集合。“统一且不可分割”意味着,整个集合存在于同一个数据库管理系统实例(instance)中;实例是一组运行在操作系统空间中、并拥有共享内存区域的进程。同一台服务器上可以运行多个数据库管理系统实例,只要它们使用的 TCP 端口不冲突。不要把数据库集簇与复制集群混为一谈。复制集群通常由多个运行在相互独立环境中的数据库管理系统实例组成,这些环境可以是独立的物理服务器、虚拟服务器或容器。
从操作系统角度看,数据库集簇是一组目录和文件。可以通过 initdb 命令并指定目标目录来初始化集簇。得到的目录通常称为数据目录(data directory),其中包含集簇的其他目录和文件。表空间目录和 WAL 日志目录可能是例外:它们可以移到数据目录之外,再通过符号链接与主目录关联。因此,数据目录以及所有可能的外部目录(表空间和 WAL)共同构成集簇的数据存储。
下面给出测试环境中的一个数据目录示例。每个子目录都在集簇运行中发挥重要作用。管理员需要了解每个子目录的用途,以及它在数据库管理系统运行中的作用。
关于数据库物理存储的组织方式,可以参阅官方文档3。
表空间
数据目录的下一个(外部)组成部分是表空间。借助表空间,可以把位于不同文件系统和块设备上的独立目录组合起来,供数据库管理系统使用。执行 initdb 初始化后,数据库管理系统中会有两个表空间:
pg_default——默认表空间,所有数据库、表和索引都会在这里创建。该表空间位于集簇主目录内。初始化时,这个表空间中会创建两个系统数据库——template0和template1,它们用作创建新数据库的模板(参见CREATE DATABASE命令4);pg_global——系统表空间,同样位于集簇主目录内。整个集簇共用的系统目录对象存放在这里。
可以使用元命令 \db+ 或查询 pg_tablespace 表来获取全部表空间的列表:
命令输出中的 Location 字段值得关注,它包含表空间目录的路径。对于默认表空间,该字段为 NULL(因为二者都位于主数据目录中)。其他所有附加表空间通常都位于主数据目录之外,并通过 pg_tblspc 子目录中定义的符号链接与主目录关联。
表空间既可以用于存放数据库,也可以用于存放单独的表和索引。数据库尤其需要单独说明:把数据库放在某个表空间中,实际上表示该数据库的系统目录对象位于其中,而其余内容还可以位于其他表空间。例如,一个数据库完全可以位于 pg_default 表空间,其中有一张大型分区表;这张表最近三个月的分区和索引可以位于快速 SSD 存储上的表空间,而更早的归档分区和索引则位于较慢的 HDD 存储上。因此,数据库位于一个表空间中,但其中一部分数据位于另外两个表空间。
表空间与维护成本
实践表明,使用额外表空间会增加数据库管理系统的维护复杂度。需要记住这些表空间的存在,并在升级、配置物理复制以及许多其他工作中将它们考虑在内。表空间之间迁移数据时还会增加额外操作。最好尽可能避免使用表空间,并认真评估引入它们的利弊。在实践中,大多数系统使用默认创建的表空间就足够了。
数据库
数据库可以看作数据的容器,并负责隔离数据。一个数据库中的表和索引无法在其他数据库中访问(可以使用 postgres_fdw 和 dblink 等工具绕过这一限制)。在同一个集簇内,可以使用不同的数据库对数据进行逻辑划分:多个彼此无关的应用的数据可以分开存储在不同数据库中。
可以使用元命令 \l(或查询 pg_database 表)查看数据库列表:
初始化集簇时会创建三个数据库。两个数据库——template0 和 template1——由数据库管理系统用作创建新数据库时的模板;第三个数据库——postgres——是一个普通数据库,可以在其中创建表。通常,postgres 数据库不用于应用业务,管理员一般会在其中安装辅助脚本和工具。建议为用户数据创建单独的数据库,并使用能够清楚说明数据库用途或其中所存数据性质的名称。
主目录中的所有数据库都位于 base 子目录下。每个数据库都存放在一个目录中,目录名对应 pg_database.oid 中的标识符。
模式
在单个数据库内部,还可以按模式(schema)进一步划分数据。模式本质上是命名空间(namespace),提供额外一层对象隔离和存储,但不支持嵌套。例如,可以使用模式按照不同业务领域组织表,或者对函数和视图进行版本管理。关于模式的有趣用法,可以参阅 Б. Момджян 关于微服务的演讲5。
任何数据库都会创建一个 public 模式,它是所有新建表和索引的默认模式。很多情况下,一个模式就足够了。
可以使用元命令 \dn+(或查询 pg_namespace 表)查看模式列表:
模式是数据库管理系统用于逻辑分组对象的内部抽象。它们在文件系统中没有与之关联的文件或目录。
表和索引
表是存放用户数据的主要对象,甚至可以说是最主要的对象;用户数据以行的形式表示。索引是表的附加结构,可以加快对表中单独行的查找。
可以使用元命令 \dt+ 或查询 pg_tables 视图来获取表列表:
输出中只包含用户表。要查看包括系统表在内的所有表,应指定修饰符 S,命令形式为 \dtS+。索引也有对应的元命令 \di 和 pg_indexes 视图(该视图基于 pg_index 表):
还可以特别关注 pg_class 表,它包含当前数据库中所有对象的列表,在获取数据库对象统计信息时经常作为辅助表使用。后续的一些查询会访问这张表。
关系与元组
关系(relation)是数据库中所有具有名称和属性列表的对象的统称。表和索引、外部表、视图(普通视图和物化视图)、序列(sequence)、复合类型,都可以称为关系。PostgreSQL 中还存在类(class)这一术语;它是关系的过时同义词,来源于早期对面向对象思想的热衷。PostgreSQL 最早的版本中有一张 pg_relation 表,后来很快重命名为 pg_class,但属性名中的 rel 前缀保留了下来。
更一般地说,关系是元组(tuple)的集合;例如,查询结果也是一种关系。元组是属性按顺序排列的集合。属性顺序在定义将要保存元组的表(或其他关系)时确定。在这种情况下,元组通常称为表的行。元组也可以由结果集的结构定义;这样的元组有时称为记录。这个术语经常带有“行版本”的含义,因为它更多指页面内部数据的物理表示,而不是行这一逻辑概念。
表和索引(以及其他一些关系类型)在数据库目录中都表示为独立文件。如果表中包含大量行,表文件(或索引文件)会自动按每个 1 GB 切分成多个文件段。每个文件段按递增顺序编号。
每个表或索引都由多个文件组成,这些文件称为分支(fork):
表的主分支(main fork)以行的形式包含用户数据。
可见性映射(visibility map)用于跟踪其中的行对所有活动事务都可见的页面。可见性映射只存在于表中。可见性映射文件的后缀为
_vm。可见性映射会在清理时更新,通常只占用很少空间。详细说明请参阅文档6。空闲空间映射(free space map)用于跟踪表(或索引)中的空闲空间,以及可以插入新行的页面。与可见性映射一样,空闲空间映射会在清理时更新,并且占用的空间很少。这些映射文件的后缀为
_fsm。详细说明请参阅文档7。初始化分支(initialization fork)只用于不记录 WAL 的表(unlogged table)和索引,它们的变更不会记录到 WAL 日志中。这类表不会在故障后恢复,而是通过把初始化文件复制到主文件上来重新创建(如果表很大、包含多个段,则会删除这些段)。文档中关于初始化文件的信息并不多8。
在更低层面,表和索引采用分页组织方式,由大小为 8 KB 的页面(块)组成。每个页面都有辅助字段,以及为用户数据——行或元组——预留的空间。索引同样采用分页组织方式,但根据索引类型(btree、hash、gin 等)不同,页面内部的空间组织方式也可能不同。
TOAST
分页组织的限制之一是,行不能跨越页面边界,也就是说,一个页面中不能存放长度超过页面大小的行。为克服这一限制,PostgreSQL 使用超长属性存储技术 TOAST(The Oversized-Attribute Storage Technique),通过压缩和/或拆分长属性值来存储数据。这个过程对最终用户是自动且透明的,不过需要指出,TOAST 也提供了精细调整的可能。TOAST 技术只支持那些可以表示为变长属性(varlena,variable-length attribute)的数据类型,因为它对固定大小类型没有意义。
如果表中包含变长类型的列,该表还会关联一个额外的 TOAST 表,无法放入普通页面的数据就存放在其中。与普通表一样,TOAST 表也采用固定页面大小的分页组织方式;但通过额外压缩并把值拆分成片段,这项技术可以把大值分布到多个页面中。关于这项技术的更多说明,以及数据如何在磁盘和内存中存放,可以参阅官方文档9。
我们简要考察了数据库管理系统对象层次结构中的主要概念。后续内容将帮助我们更好地理解统计信息,尤其是与磁盘空间和共享缓存使用有关的问题。
4.2. 数据库集簇中的事件
在第 3 章中,我们从正在执行的查询角度考察了工作负载。可以把查询看作应用施加给数据库管理系统的外部力量,而把工作负载看作数据库管理系统在这种力量作用下完成的内部工作。这使我们能够从完全不同的角度看待工作负载,例如考察应用命令时所涉及的数据库对象(表和索引)。
表和索引层面的工作负载
另一类同样能够描述工作负载的统计信息,是表和索引使用情况统计。这些统计信息有两种粒度:行级和块级。第一种表示查询执行过程中有多少行受到影响。行级统计是工作负载的逻辑反映,因为它说明了数据库管理系统逻辑抽象的使用情况;以页面或字节表示的块级统计更接近数据存储的物理层,适合分析输入/输出。
要获取所需数据,需要使用多个视图。可以在 pg_stat_database 视图中获取集簇或单个数据库范围的总体情况,其中包含一些必要字段:
tup_returned和tup_fetched——表示访问表和索引时涉及的行总数(不是返回给客户端的行数!)。
— 对于索引,tup_returned 表示索引访问方法(Index Scan、Bitmap Index Scan、Index Only Scan)返回的行数,tup_fetched 表示此过程中从表中读取的行数(但只统计不使用位图的简单索引访问)。
— 对于表,tup_returned 表示顺序扫描(Seq Scan)从表中读取的行数,tup_fetched 表示使用位图访问时从表中读取的行数(Bitmap Heap Scan)。这是因为合并位图(Bitmap And)时,无法把访问统计归属于某个具体索引,因此这些统计信息始终计入表的统计信息。
从上述说明可以看出,有些操作会同时增加两个计数器,因此不要把它们的值相加。更新和删除行时,计数器也可能增加(因为仍然需要找到并读取目标行)。在 pg_stat_database 中可以获得受影响行的总体情况;如果需要更详细的信息,则应分析单个表和索引的统计信息。
tup_inserted、tup_updated和tup_deleted——这些字段简单得多:它们记录INSERT、UPDATE和DELETE操作影响的行数,没有额外的细节和例外。
这些统计信息也适合粗略评估工作负载的波动。可以从监控系统中通过以下指标获取:
postgres_database_tuples_returned_total;postgres_database_tuples_fetched_total;postgres_database_tuples_inserted_total;postgres_database_tuples_updated_total;postgres_database_tuples_deleted_total.
每个指标都会返回单个数据库中相应的受影响行数。要观察动态变化,应关注数值变化的频率;要评估总体情况,则应将各个数据库的指标相加。
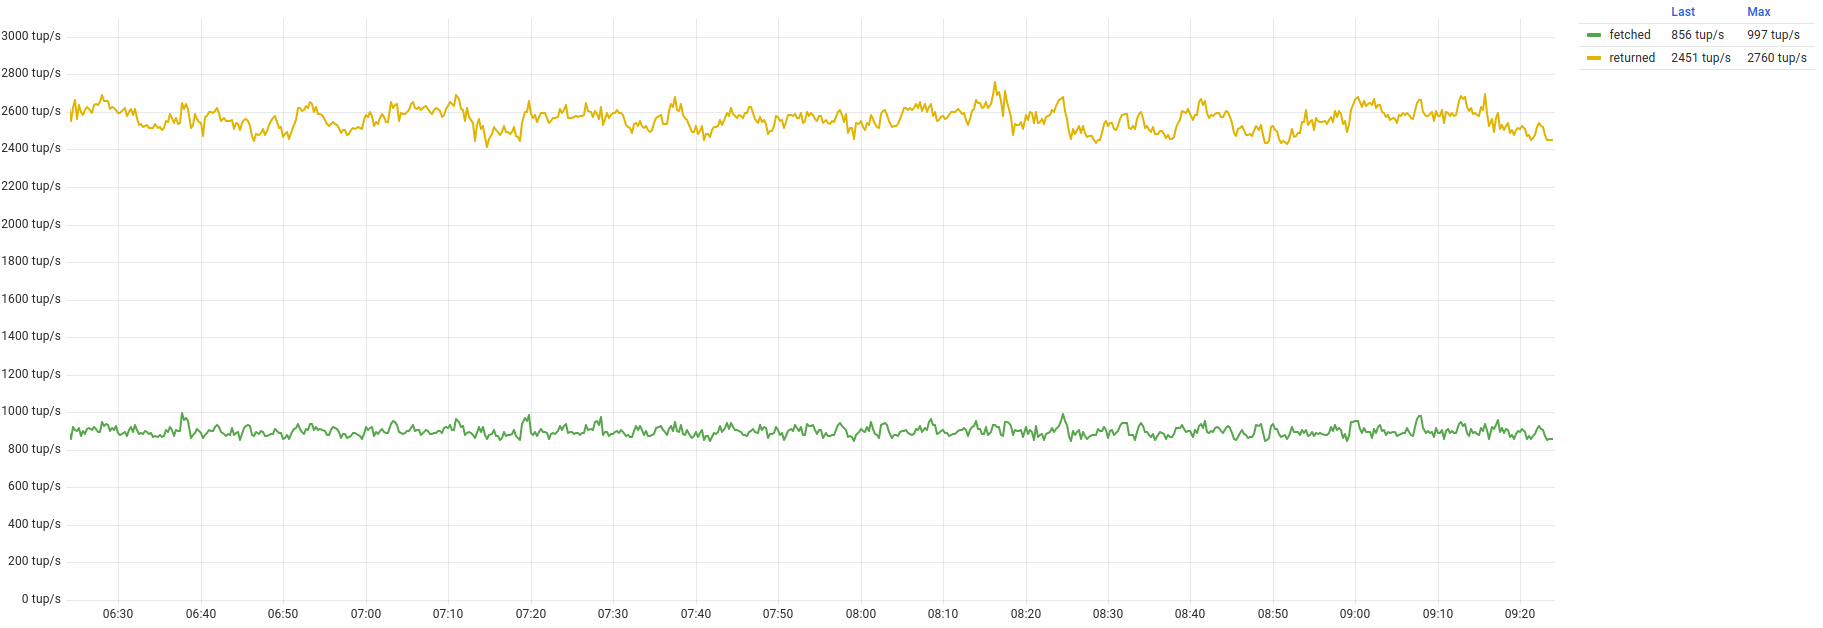
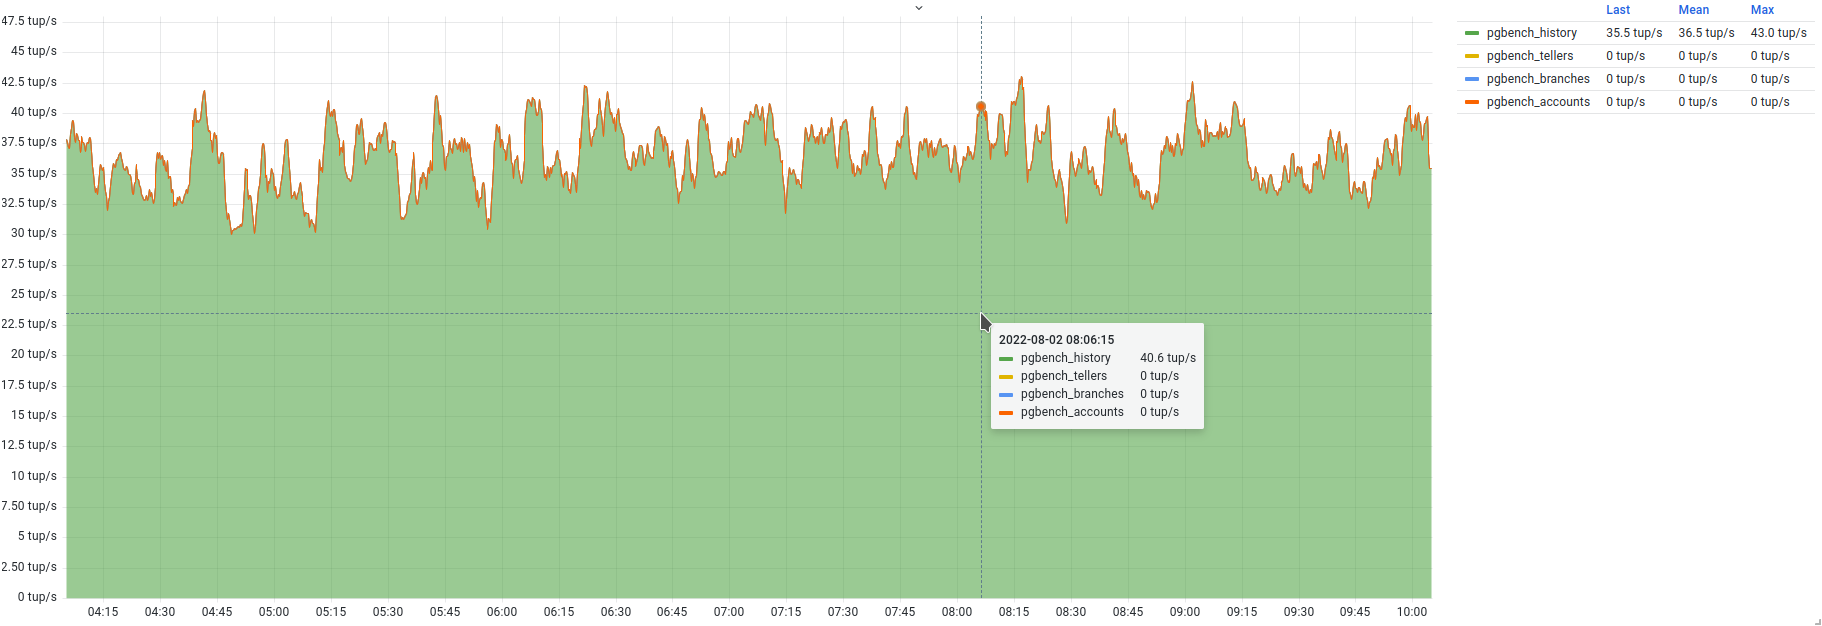
要绘制图表(图 4.1),需要使用两个查询;每个指标描述一种与行有关的操作。
对修改操作影响的行也可以得到类似的情况。要绘制图表(图 4.2),需要使用三个查询:
两张图都显示出平稳的工作负载,没有明显波动。这说明从应用侧看,客户端数量和请求量基本保持不变;从数据库管理系统侧看,工作负载执行过程中受影响的行数也保持稳定。剧烈波动可能由应用实例数量或发送请求量的变化引起,也可能由内部原因造成,例如
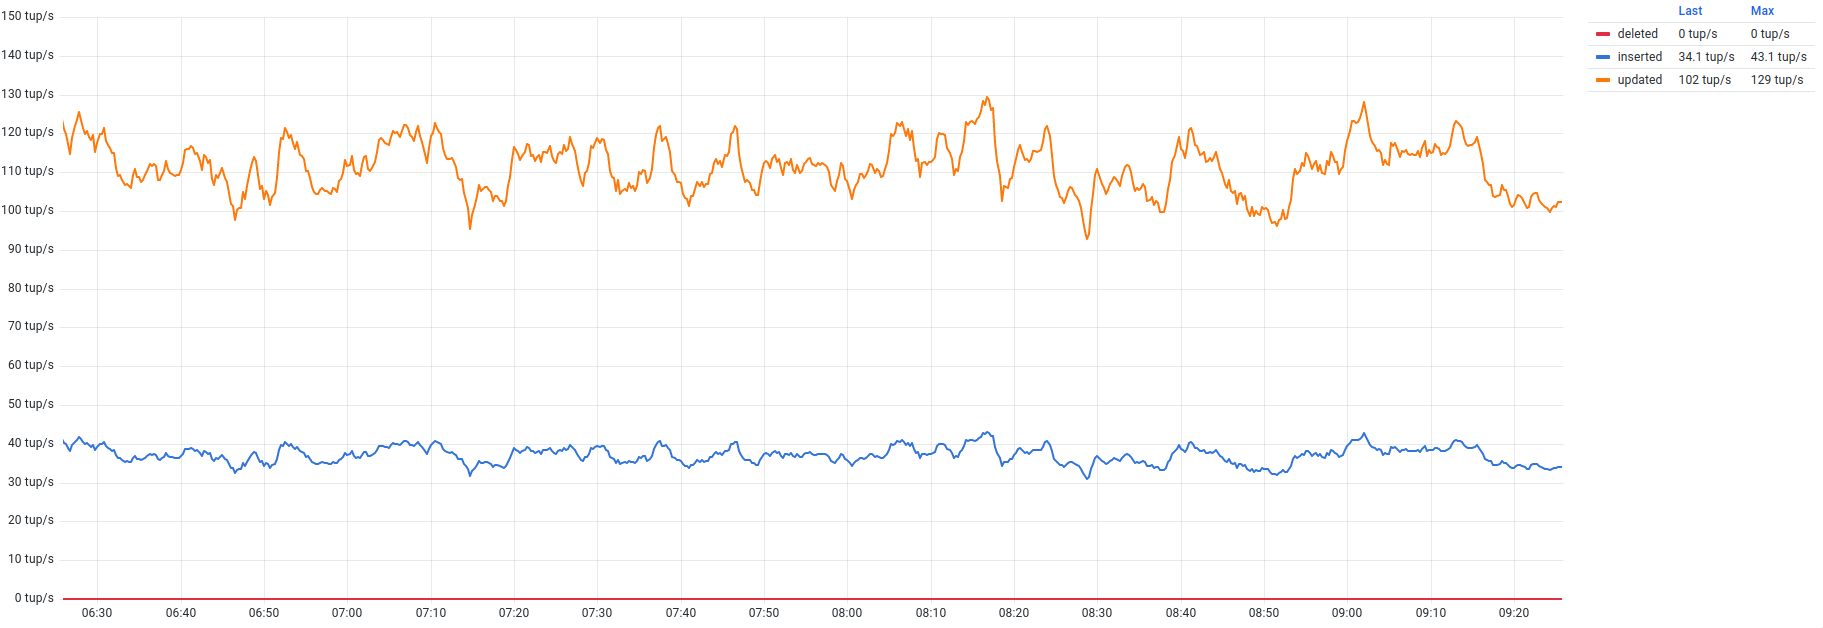
使用非最优计划,这些计划可能改变受影响的行数,并导致查询执行时间变长。
如果要更详细地分析工作负载中究竟涉及哪些表,应使用 pg_stat_user_tables 和 pg_stat_user_indexes 视图。这些视图包含更多有关具体表和索引使用情况的信息。pg_stat_user_tables 中值得关注的字段包括:
seq_scan——顺序访问(sequential scan)操作的次数;seq_tup_read——所有顺序访问操作执行过程中涉及的行数;idx_scan——索引访问(index scan)操作的次数;idx_tup_fetch——索引访问涉及的行数;n_tup_ins——插入的行数(通常由INSERT查询产生);n_tup_upd——更新的行数,包括所谓的 HOT 更新(由UPDATE查询产生);n_tup_del——删除的行数(由DELETE查询产生);n_tup_hot_upd——使用 HOT(HeapOnly Tuples update,堆内元组更新)机制更新的行数。HOT 是一种用于减少行更新开销的优化。其要点是:如果更新后属性值在任何索引中都没有变化,就可以省略插入索引指针。因此,更新会更快,资源开销也更低。HOT 更新的数量也计入n_tup_upd字段。关于 HOT 机制的更多信息,可以参阅相关资料10 11。
pg_stat_user_indexes 视图中也有类似的索引统计信息:
idx_scan——访问该索引的次数。这个字段可以帮助发现未使用的索引,这一点很重要,因为保留索引并不是没有代价的;idx_tup_read——索引扫描时读取的索引项数量(不访问表);idx_tup_fetch——简单索引扫描从表中选出的存活行数量。
需要弄清楚在使用索引位图时,idx_tup_read 和 idx_tup_fetch 计数器是如何工作的。使用多个索引时,扫描结果可以通过逻辑乘法或加法合并,因此无法把对单独行的选择归属于具体索引。在这种情况下,所用索引的 pg_stat_user_indexes.idx_tup_read 值会增加,每个表的 pg_stat_user_tables.idx_tup_fetch 计数器也会增加,而 pg_stat_user_indexes.idx_tup_fetch 的值不会变化。
pg_stat_user_tables 和 pg_stat_user_indexes 视图汇总了用户表和用户索引的统计信息。系统对象的统计信息则汇总在类似的 pg_stat_sys_tables 和 pg_stat_sys_indexes 视图中。这些视图会访问另外两个汇总所有对象统计信息的视图(pg_stat_all_tables 和 pg_stat_all_indexes);而后两者又建立在一组大型函数之上,这些函数访问各个统计计数器。上述视图都针对单个数据库,区别于面向整个数据库集簇的 pg_stat_database。
下面考察这些统计信息的几种使用场景:
多余的顺序访问;
插入、更新和删除次数最多的表。
多余的顺序访问。 顺序访问意味着访问表(读取并可能写入),直到处理完所需数量的行。这是基本访问方法之一,适用于需要访问大量行,或不存在合适索引的情况。前一种情况下,顺序扫描可以用于分析查询或批量(bulk)修改,因为这类操作需要读取表的大部分,甚至整张表。后一种情况下,如果没有合适的索引,即使查询只需要一行,也会使用顺序访问,从而可能造成输入/输出和处理器资源的过度消耗(读取并过滤行)。
实践中需要跟踪顺序访问的次数,并判断它们是否确实必要。对于分析查询,顺序访问是合理的;而对于 OLTP 查询,通常不需要大量记录,使用顺序访问的成本可能高于使用索引。不过,这并不意味着应为每个字段都创建索引——维护索引并非没有代价,在某些情况下还会造成多余的输入/输出。添加新索引时,需要评估查询执行计划,并确认新索引是否会被使用、是否有益。
要获取顺序读取的表列表,可以使用下面的查询(连接必须建立到 pgbench 数据库):
查询输出了表通过顺序访问和索引访问时的统计信息,包括操作次数和受影响行数。在测试负载中,表并不多,因此查询只输出一张通过顺序方式访问的表。实际上,这张表有一个本可以使用的索引,但表中只有 20 行(也就是说整张表只占一个块),规划器认为使用索引的代价更高:因为那样不仅要读取表的块,还要读取索引的块。因此,它选择了成本更低的顺序访问计划。
在负载多样的生产环境中,顺序扫描的表可能更多。比较这些表时,还应考虑一些指标(为了方便,也可以把它们输出到查询中):
每次扫描的平均行数——
seq_tup_read / seq_scan。平均行数越多,扫描所需的资源就越多。但这并不意味着所有查询都会读取恰好这么多行;顺序访问占全部访问的比例——
seq_scan / (seq_scan + idx_scan)。比例越高,扫描使用的资源越多;不过要记住,有些小表可能完整放入共享缓存;表的字节大小,用于相互比较表。例如,消除大型表的顺序访问可能比消除小表的顺序访问更优先。本章稍后将介绍如何确定表和其他数据库对象的大小。
通过查询获取这类统计信息,适合构建按时间段生成的报告;但要进行实时分析和问题排查,还需要看到变化趋势。下面的查询可以返回按顺序访问读取行数最多的前 K 张表:
如果根据这个查询绘制图表,图中只会显示一张表,这与 SQL 查询的结果完全一致。
可以做一个小实验:执行一次查询,读取另一张表中的所有行:
过一段时间后,图表中会出现一个明显的尖峰(图 4.3)。
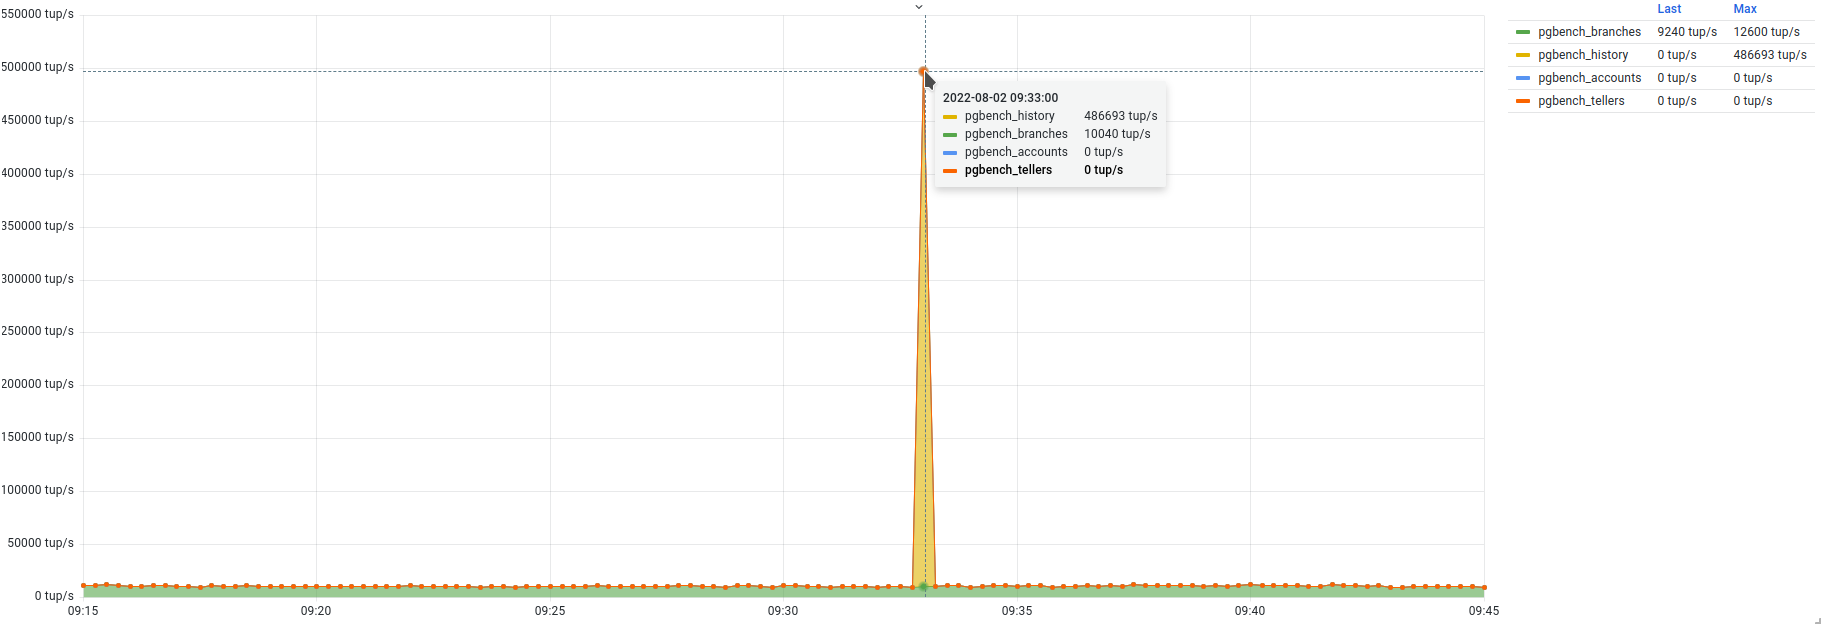
因此,借助这类图表,可以实时跟踪顺序访问的变化趋势,并采取适当措施(分析访问表的查询、创建索引等)。
插入、更新和删除次数最多的表。 表使用统计信息是 pg_stat_database 中行统计信息的逻辑延伸。如果说前者展示的是数据库层面的总体统计信息,那么借助 pg_stat_user_tables 就可以深入各个数据库,更详细地分析工作负载涉及的表,并评估受影响行的数量。
pg_stat_user_tables 针对单个数据库,因此要获取 pgbench 数据库中表的统计信息,必须连接到这个数据库。下面的查询可以获取受影响行的统计信息:
这个例子输出了 pgbench 数据库中的所有用户表,以及不同操作影响的行总数;在 ORDER BY 子句中指定关注的字段,就可以得到受影响行数最多的表。不过,输出中再次出现了很大的数字,实践中更适合跟踪这些数值的变化趋势。可以使用下面的指标(指标名称与字段名称类似):
postgres_table_seq_tup_read_total;postgres_table_idx_tup_fetch_total;postgres_table_tuples_inserted_total;postgres_table_tuples_updated_total;postgres_table_tuples_deleted_total;postgres_table_tuples_hot_updated_total.
下面的查询可以获取更新次数最多的表:
图表(图 4.4)可以更直观地显示哪些表的更新次数最多。
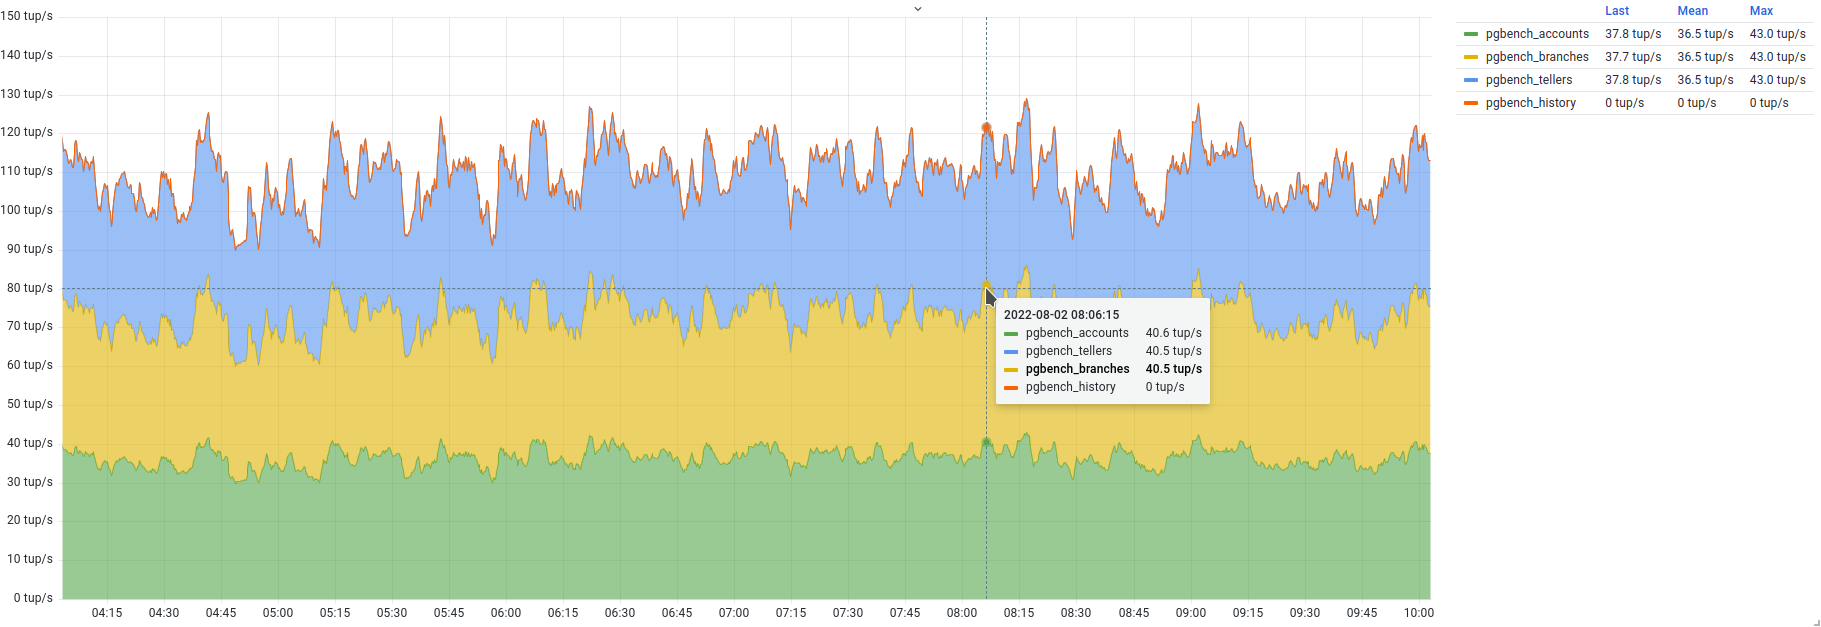
修改查询中的指标,就可以得到其他指标对应的图表,例如插入行数(图 4.5)。在实践中使用这类图表,可以实时跟踪工作负载的波动,尤其是应用侧发生重大变化时。
错误和不良事件
我们再次回到 pg_stat_database,考察以下字段:
xact_rollback——这个字段在介绍事务活动时已经提到。它表示以回滚结束的事务数量。回滚这一事实可以视为发生了错误(显式调用ROLLBACK命令的情况除外)。因此,大量回滚可能说明单个查询或事务执行过程中发生了错误,xact_rollback可以作为这类错误的计数器。典型例子包括插入行时违反唯一性约束、语法错误、函数参数指定错误或访问不存在的对象。不过,除了这类错误外,还可能有其他由与应用无关的原因引起的错误,而这类信息只能从数据库管理系统日志中获得。conflicts——由于热备节点上查询执行与 WAL 日志重放之间发生冲突而取消的查询数量(使用复制时)。这是一类单独的错误,将在第 7 章“复制”中详细讨论。无论如何,这类冲突也可以视为错误。deadlocks——死锁;前面第 2 章已经讨论过。为解决死锁,某个事务会被强制结束,这同样可以视为错误。checksum_failures和checksum_last_failure——分别表示校验数据页校验和时发生的错误数量,以及最近一次记录到错误的时间。校验和根据数据页内容计算,并在后续修改时重新计算,用于在访问页面时发现数据损坏。这是最令人不安的错误类型之一;出现这类错误时(尤其是在生产环境中),应高度重视,并采取一切必要措施,避免今后再次发生。sessions_abandoned、sessions_fatal、sessions_killed——表示异常结束的会话数量。这些字段也在第 2 章中讨论过。它们表明会话以异常方式结束,也可以视为错误。
正如你可能已经注意到的,前面讨论的所有事件本质上都是错误;在数据库管理系统和应用正常、正确运行时,它们本不应该发生。一个好的做法是绘制一张图,把所有这些错误指标汇总在一起:
postgres_database_xact_rollbacks_total;postgres_database_conflicts_total;postgres_database_deadlocks_total;postgres_database_checksum_failures_total;postgres_database_sessions_total{reason=~"abandoned|fatal|killed"}.
理想情况下,这样的图应该是“空的”,如图 4.6 所示。任何尖峰都应该引起数据库管理员的注意,并促使其查明原因。
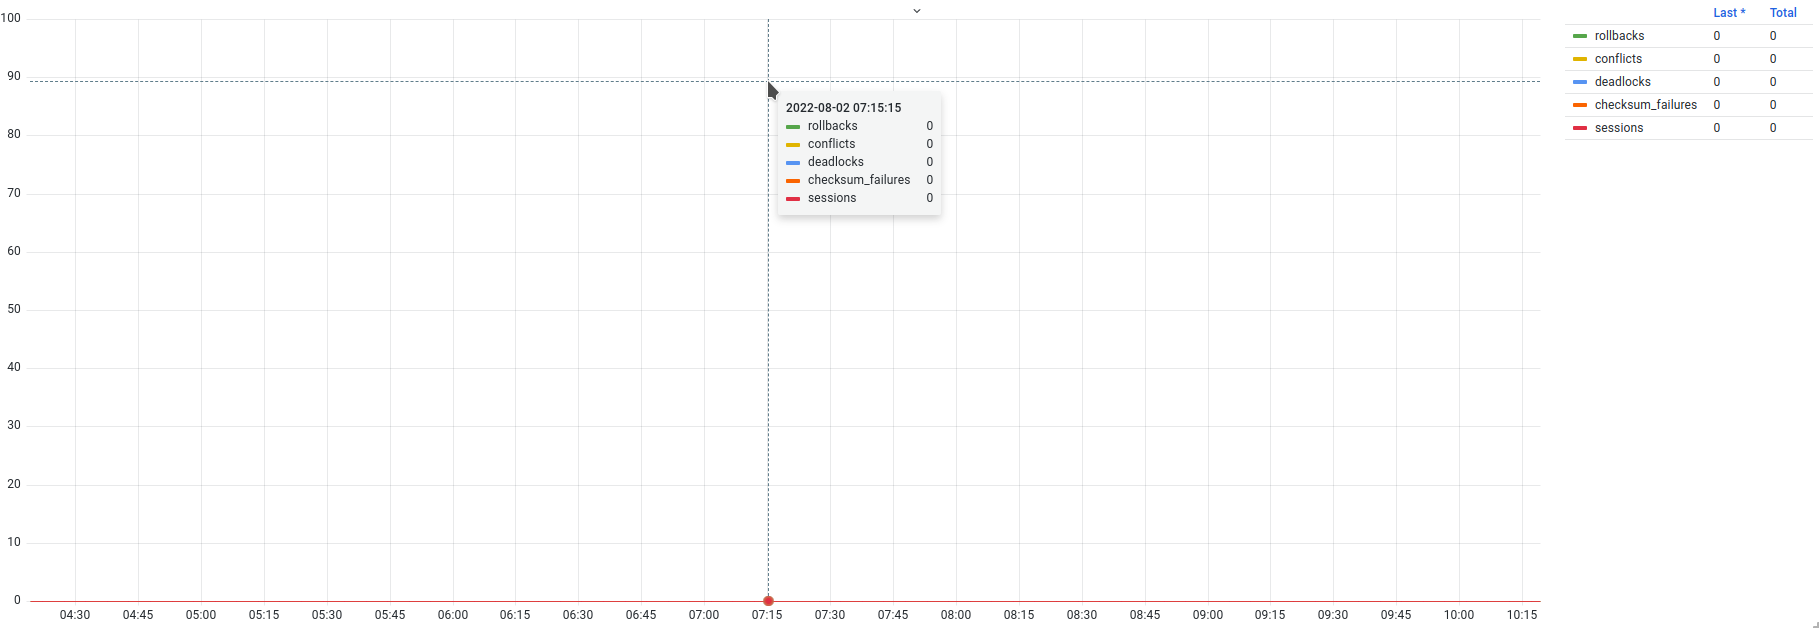
列出的多数事件说明问题出在应用侧,只有校验和错误指向数据库管理系统自身的问题。长期运行后,有些错误可能呈现出持续累积的特征;如果绘制这类图表,错误曲线可能已经形成某种持续的背景值。此外,有些错误类别可能因为由应用侧处理而被视为常见且正常,例如连接中断后重新建立会话,或死锁后重试查询。在这种情况下,可以忽略回滚和复制冲突等不太重要、对数据库管理系统性能影响不大的事件;但仍应认真对待死锁和校验和错误——死锁会损害并发工作性能,而校验和错误可能意味着存在数据损坏风险。
4.3. 数据库管理系统对象操作函数
在查看数据库对象的主要统计信息时,我们经常还希望看到这些对象的大小,以便了解它们的相对规模。对象大小往往决定工作的优先级和处理方式:大型对象需要更加谨慎(不能让锁长时间持有,也应避免引入额外负载),完成工作后可能获得更大的最终收益。对象大小本身也很重要,是规划磁盘空间容量的关键因素之一。数据库管理系统长期运行后,数据会不断增加,对象会不断变大,并占用越来越多的磁盘空间。
既可以从操作系统侧跟踪对象大小,也可以从数据库管理系统侧跟踪。我们知道,数据库管理系统中的几乎所有对象都是文件和目录,因此可以在文件系统中获取这些对象占用的空间。另一方面,数据库管理系统使用自己的抽象——表空间、数据库、表、索引等。在这两种情况下,都需要使用所谓的系统管理函数12。这是一组规模很大的辅助函数,用于获取管理员可能需要的各种信息。目前我们关注其中的两组:
数据库对象管理函数13。这一组中的大多数函数用于计算各种数据库管理系统对象占用的空间。
文件访问函数14提供对运行数据库管理系统服务器的操作系统目录的访问。这是一组功能强大的系统调查函数;只有超级用户和
pg_read_server_files角色成员可以访问它们。授予这些函数的权限时必须非常谨慎,并充分考虑安全要求,因为数据库管理系统内置的权限检查不适用于这些函数。例如,授予pg_read_file函数EXECUTE权限,就允许读取数据库管理系统服务器进程可以访问的任意文件;拥有该函数执行权限的用户可以读取任意表的内容,包括可能包含机密数据的表(例如pg_authid)。
确定数据库管理系统对象的大小
对象管理函数中值得关注的包括:
pg_tablespace_size——显示指定表空间的大小;pg_database_size——显示指定数据库的大小;pg_table_size——显示指定表的总大小,包括 TOAST 存储和辅助分支(vm、fsm、init);pg_indexes_size——显示指定表的所有索引的总大小;pg_total_relation_size——显示指定表的总大小(包括 TOAST 和辅助分支)以及该表的所有索引。计算结果等于pg_table_size和pg_indexes_size两个函数结果之和;pg_relation_size——显示第一个参数指定的关系(表或索引)分支的大小。第二个参数可以指定要关注的分支名称:main——计算包含数据的主分支大小;
— fsm——计算空闲空间映射的大小;
— vm——计算可见性映射的大小。
如果不指定第二个参数,则默认使用 main。对于索引,可见性映射的大小始终为零。
pg_size_pretty——辅助函数,将以字节表示的值转换为带单位的文本(bytes、kB、MB、GB、TB、PB)。pg_size_bytes——辅助函数,是pg_size_pretty的逆操作,可以把文本值换算成字节数。
其中一些函数有两个变体,对象既可以用数值 OID 标识符表示,也可以用文本名称表示。
在输出数据库对象统计信息的查询中,可以方便地使用这些函数显示对象大小。表空间或数据库这样的复合对象的大小,是评估存储空间使用情况和规划容量所必需的。表和索引等其他对象的大小,通常用于评估数据库内部的空间使用,或评估膨胀效应的影响。下面简要介绍这些函数的使用示例。
表空间。 本章开头提到过元命令 \db+,它会显示表空间列表。大多数元命令实际上都会对系统目录的系统表执行 SQL 查询,因此也可以直接使用 SQL 得到与 \db+ 输出相似的结果。
元命令查询
要获取元命令使用的查询文本,可以在启动 psql 时使用参数 -E (--echo-hidden),让 psql 在使用内置元命令时显示查询。在已打开的会话中,可以使用 \set ECHO_HIDDEN on 命令开启查询显示。
下面的查询是元命令 \db+ 的简化版本:
路径(path 字段)由 pg_tablespace_location 函数确定。在测试环境中使用的是默认表空间;它们的路径值为空(NULL),因为这些表空间位于数据库集簇的主目录中。大小由 pg_tablespace_size 函数获取,该函数既可以接收数值 OID,也可以接收表空间名称。
数据库。 使用 pg_database_size 函数获取数据库大小。该函数的参数可以是数值 OID,也可以是数据库名称。下面是获取数据库大小的查询示例:
表。 表是复杂的抽象,谈到表的大小时,必须明确“大小”这一术语的具体含义。表由用户行所在的主分支组成,同时还包括可见性映射和空闲空间映射等辅助分支。此外,表还可能关联索引和 TOAST 表;从物理角度看,它们是独立的实体(磁盘上的文件),但从逻辑角度看,离开其父表就无法存在。要获取包括全部辅助结构在内的表完整大小,可以使用 pg_table_size 函数。如果还要计入索引,则应使用 pg_total_relation_size 函数(它等价于 pg_table_size 与 pg_indexes_size 之和)。最后,要在辅助分支层面确定大小,应使用 pg_relation_size,并向它传入具体的辅助分支。下面的查询演示了这些函数的用法:
这个例子有几个特点:
使用
pg_class代替pg_stat_user_tables,因为前者包含数据库对象的完整列表。使用过滤条件
c.relkind IN ('p', 'r', 'm')获取所需对象,只保留普通表(r)、分区表(p)和物化视图(m),从而排除索引、TOAST 表、普通视图、序列以及其他对象。排除以排他模式
AccessExclusiveLock锁定的表。使用管理函数时,一个重要的细节是它们建立的锁级别。函数要计算对象大小,需要ExclusiveLock级别的锁15。如果经常使用这些函数,例如用于监控,就可能与最严格的排他锁(AccessExclusiveLock)发生冲突,并有可能排队等待。为消除这一风险,查询不输出已经被锁定的表;待锁释放后,可以在下一次获取它们的大小。只选择大小超过 500 KB 的表。使用这种条件可以方便地过滤掉小表。不过,测试环境中的表本来就不多,大表则更少。
通过对
pg_index执行子查询,计算每张表的索引总数。为完整起见,加入了 init 分支大小的计算,尽管这只在使用不记录 WAL 的表时有意义,而测试环境中并没有这类表。
这个查询还可以做一个逻辑上的改进:把辅助分支表示为相对于表总大小的百分比,这样更容易发现异常和失衡(虽然我想不起见过辅助分支特别大的情况)。还可以输出表所属的表空间,但这需要与 pg_tablespace 进行连接。
索引。 可以使用 pg_relation_size 或 pg_total_relation_size 函数确定具体索引的大小。这两个函数既适用于表,也适用于索引。
为了便于处理索引,可以使用基于 pg_class 和 pg_index 的 pg_indexes 视图。不过,该视图没有包含唯一标识符字段,因此无法按 OID 与其他视图连接。为简单起见,查询只访问 pg_indexes,不与 pg_locks 连接,但与排他锁发生冲突的风险仍然存在,和表的情况一样。
在监控系统中评估数据库对象大小。 用 SQL 查询中的表格形式展示大小,很适合生成报告。要实时观察数据库管理系统对象的大小,可以使用以下指标:
postgres_database_size_bytes;postgres_table_size_bytes;postgres_index_size_bytes.
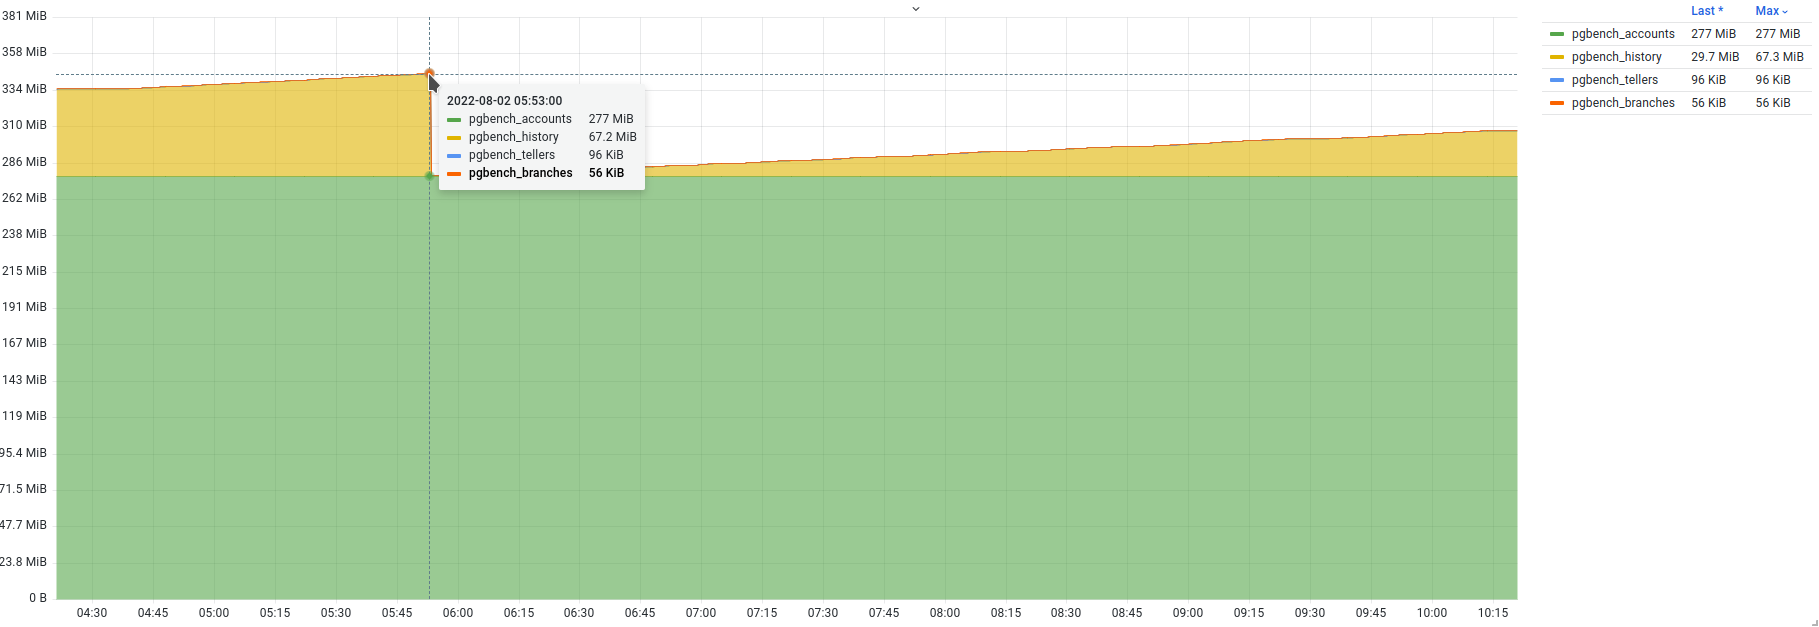
根据这些指标,可以绘制两类图表。第一种、也是最简单的方式,是显示最大的对象。这可以粗略评估最大数据库对象的空间使用情况,但这样的图表不会显示其他表的异常增长——只有当某张表增长到足以进入最大对象列表时,才会被发现。增长可能持续很长时间,在此期间,异常增长问题本来可能已经得到解决。第二种补充方式,是绘制在某个时间区间内大小变化最大的对象。
以表为例,考察几种情况。下面的查询可以得到最大的表:
图表(图 4.7)如下所示:
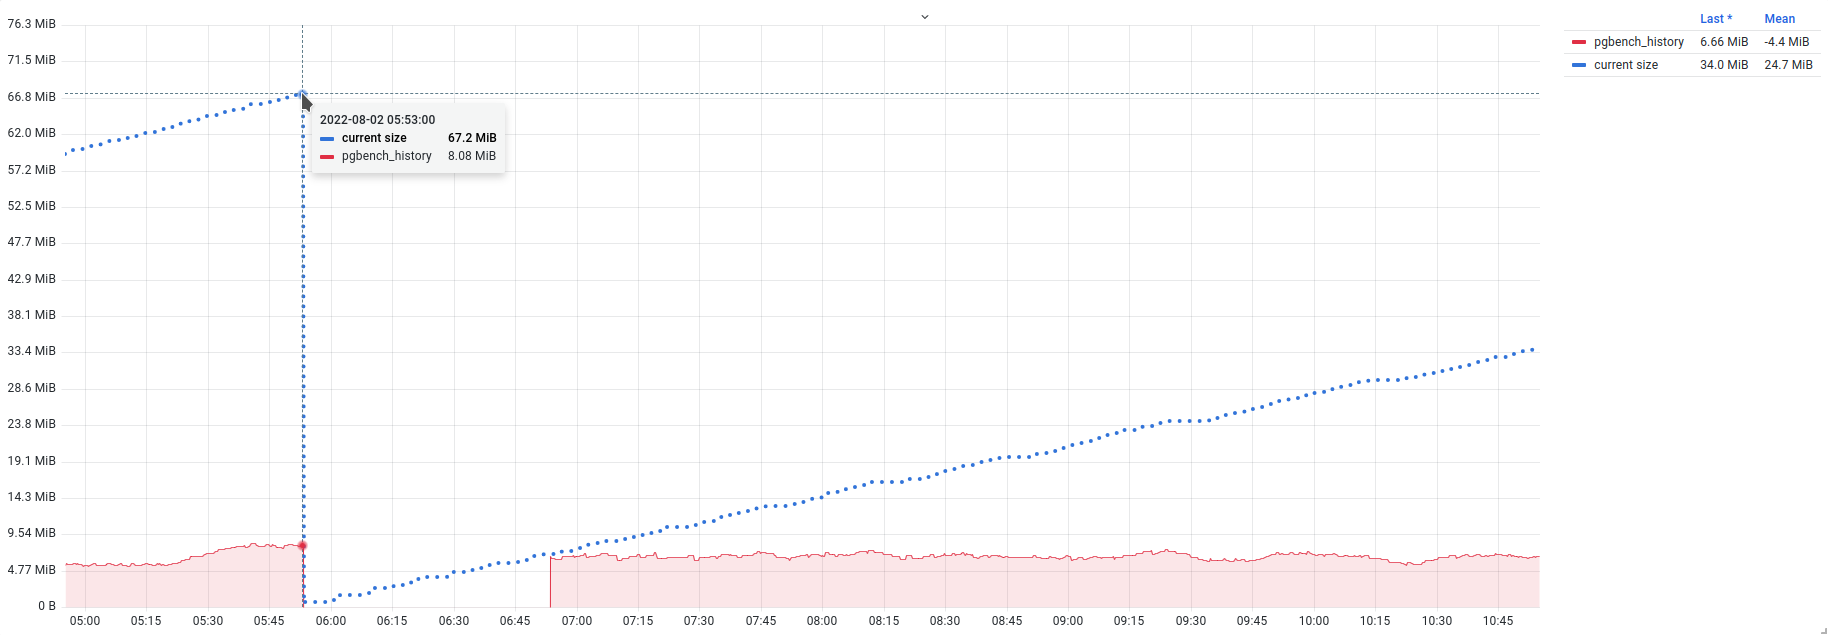
第二种查询用于获取大小变化最大的表:
这里使用了 delta 函数,它计算一小时区间内的数值差。选择区间时要谨慎:即使一小时也可能过长,会把短时间内的剧烈大小变化平滑掉。根据该函数绘制的图表如图 4.8 所示:
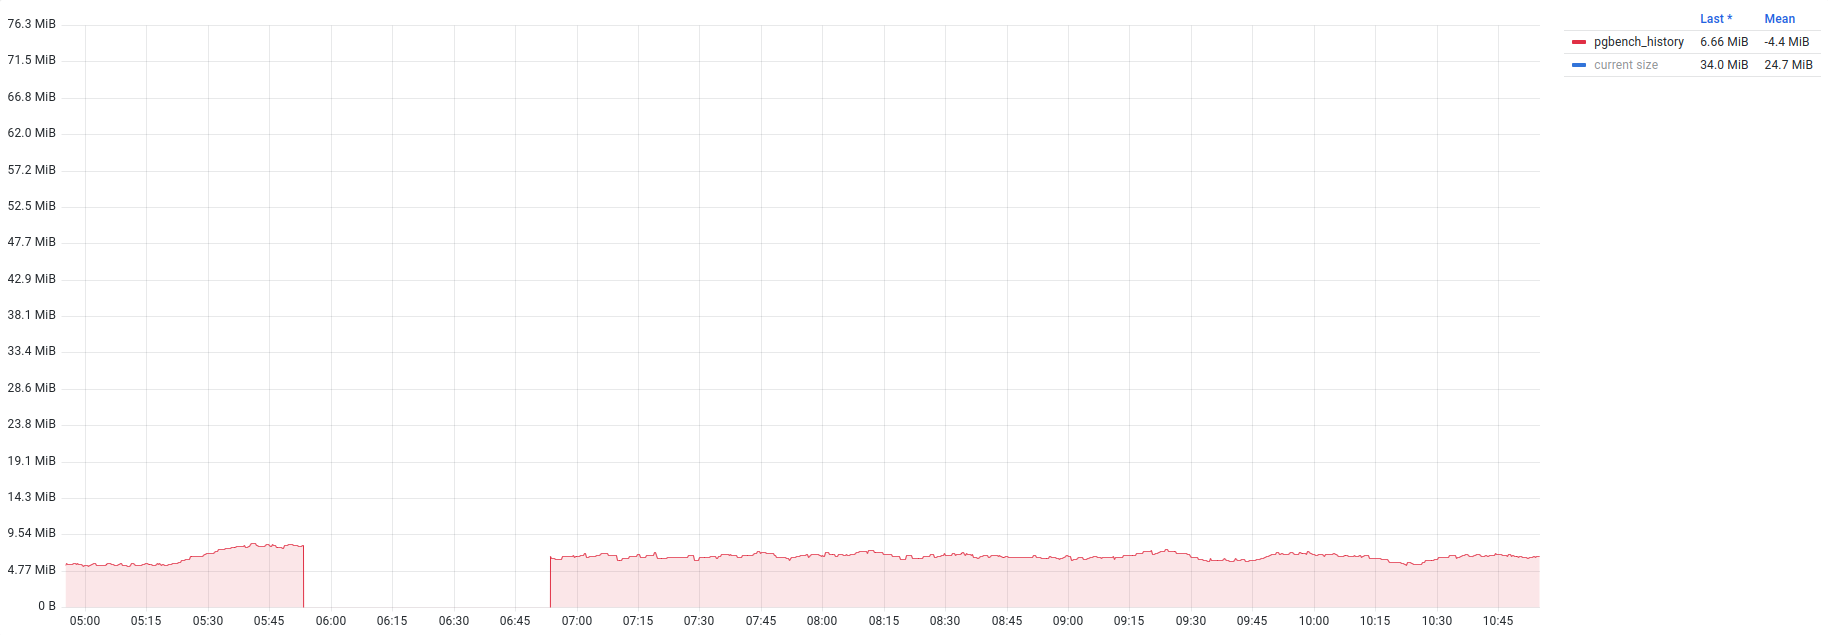
从这个例子可以看出,表先经过清理,然后以每小时约 5 MB 的速度稳定增长。为了让图表更直观,还可以叠加表本身的大小(图 4.9):
对象在文件系统中的位置
有时需要访问表和索引的物理存储层,因此必须找到对象在文件系统中的物理位置。这在分析损坏和恢复数据时经常是必要的。为此,数据库管理系统提供了几个函数:
pg_relation_filenode——接收 OID 标识符或对象名称,返回与指定对象关联的所谓文件节点(filenode)编号。文件节点是用于存储数据的文件名中的主要组成部分。对于大多数表,这个编号与pg_class.relfilenode的值相同;但对于某些系统目录,该值为零,要获取实际值就必须使用这个函数。如果指定的关系不存储在磁盘上,例如视图,该函数会返回NULL;pg_relation_filepath——返回相对于主数据目录的关系文件路径;pg_filenode_relation——这是pg_relation_filenode的逆函数,用于按文件节点编号(从文件名中取得)查找表。它根据指定的表空间 OID 和文件节点返回关系的 OID。对于默认表空间中的表,第一个参数可以传入零。
除了存放用户数据的对象外,数据库管理系统还有其他也存储在磁盘上的对象,在某些情况下同样可能占用大量空间。数据库管理系统也提供了一组函数用于查看和分析这些对象:
pg_ls_logdir——输出保存数据库管理系统服务器日志的目录内容;pg_ls_waldir——输出pg_wal目录的内容,该目录存放 WAL 日志段;pg_ls_archive_statusdir——输出pg_wal/archive_status目录的内容,该目录存放各个 WAL 段的归档状态;pg_ls_tmpdir——输出用于保存临时文件的目录内容;pg_ls_logicalmapdir——输出pg_logical/mappings的目录内容;pg_ls_logicalsnapdir——输出pg_logical/snapshots的目录内容;pg_ls_replslotdir——输出pg_replslot中指定复制槽目录的内容;pg_ls_dir——输出任意目录内容的通用函数(包括主数据目录之外的目录)。
在这些函数中,最通用的是 pg_ls_dir。该函数输出指定目录中所有文件和目录的名称,因此可以查看数据库管理系统所在服务器上的任意目录,包括操作系统目录(当然,前提是用户拥有数据库管理系统运行账号对应的访问权限):
虽然 pg_ls_dir 是通用函数,但其他函数使用起来更方便,因为不需要记住目录的确切位置。
下一个同样有趣的函数是 pg_read_file。该函数读取指定文本文件并返回其内容。下面的示例只是输出结果,但当然也可以把结果传给另一个函数继续处理。还可以指定偏移量和长度作为附加参数,以更精确地指定读取范围。
读取的内容会按照数据库编码处理;如果其中的字符不符合该编码,就会产生错误。绕过这一问题可以使用 pg_read_binary_file 函数。它同样用于读取文件,但读取任意二进制数据,并以 bytea 而不是 text 类型返回结果,因此可以绕过编码检查。结合 convert_from,可以使用这个函数读取指定编码的文本,并将其转换为数据库编码:
下一个值得特别关注的函数是 pg_stat_file,它输出指定文件系统对象的属性:
以字节为单位的大小;
最后访问时间(atime,access time);
最后修改时间(mtime,modification time);
最后状态变更时间(ctime,change time),仅适用于 Unix 系统;
创建时间(creation time),仅适用于 Windows;
指示对象是否为目录的标志。
总结一下:只要能够访问上述函数,就可以在运行数据库管理系统的用户权限范围内,读取任意目录和文件的内容。默认情况下,对这些函数的访问受到限制;如需授予函数权限,必须认真权衡并考虑安全风险。
数据库管理系统服务器日志目录的内容。 pg_ls_logdir 函数可以输出数据库管理系统日志目录的内容。目录位置取决于配置设置;使用该函数可以直接以文件列表及其属性的形式显示目录内容。考虑到快速确定数据库管理系统如何、以及向哪里写入服务器日志并不简单,而且答案还取决于系统版本,这项功能非常方便。
该函数输出数据库服务器日志目录中所有文件(隐藏文件和特殊文件除外)的名称、大小和最后修改时间(mtime)。从监控角度看,可以获得日志在磁盘上占用的总空间:
如果日志收集子系统关闭(logging_collector = off),并且 log_directory 指定的目录不存在,该函数可能返回错误。某些配置下,服务器日志可能占用大量空间,甚至可能位于数据库集簇目录中。如果日志填满文件系统上的所有可用空间,就会导致数据库管理系统异常停止。
默认情况下,只有超级用户和 pg_monitor 组成员可以访问 pg_ls_logdir 函数;也可以把执行权限授予其他用户。
输出 WAL 日志目录的内容。 下一个不直接存放用户数据、但同样可能占用大量空间的目录,是 WAL 日志目录 pg_wal。这个目录通常位于数据库集簇主目录中,但也经常被移到外部,在集簇目录中只创建一个符号链接。这样做是出于性能和空间使用方面的考虑。可以使用 pg_ls_waldir 函数输出 WAL 目录的内容。该函数输出所有普通文件的名称、大小和最后修改时间。名称以点开头的文件、目录和其他特殊文件不会输出。默认情况下,只有超级用户和 pg_monitor 组成员可以访问该函数;也可以把执行权限授予其他用户。
配置了 WAL 归档后,pg_wal 目录中会创建 archive_status 目录,用于保存所有(需要归档的)段的归档状态。可以使用 pg_ls_archive_statusdir 函数获取其内容;该函数同样输出目录中所有普通文件的名称、大小和最后修改时间(不输出名称以点开头的文件、目录及其他特殊文件)。
默认情况下,只有超级用户和 pg_monitor 组成员可以访问这个函数;也可以把执行权限授予其他用户。
pg_ls_waldir 和 pg_ls_archive_statusdir 两个函数都可以用于监控目录大小和归档队列。关于这一主题的更多内容,请参见第 7 章“复制”监控。
输出临时文件目录的内容。 下一个函数用于输出临时文件目录的内容。pg_ls_tmpdir 函数输出临时对象目录中所有普通文件的名称、大小和最后修改时间。这类目录可能有多个,位于各个表空间目录中。该函数考虑到了这一点,参数可以接收具体表空间的名称(未指定时使用 pg_default)。名称以点开头的文件、目录和其他特殊文件不会输出。默认情况下,只有超级用户和 pg_monitor 组成员可以访问该函数;也可以把执行权限授予其他用户。
pg_ls_tmpdir 可以用于监控临时文件,但其中有多种方法和细节需要考虑。关于临时文件监控的更多内容,请参见第 5 章“输入/输出”。
输出其他目录的内容。 下面的函数用于输出复制和逻辑解码相关目录的内容,逻辑解码用于逻辑复制。以下函数都会输出目标目录中所有普通文件的名称、大小和最后修改时间:
pg_ls_logicalmapdir输出 pg_logical/mappings 的内容;pg_ls_logicalsnapdir输出 pg_logical/snapshots 的内容;
pg_ls_replslotdir输出pg_replslot/slot_name的内容,其中slot_name是具体复制槽的名称。
使用逻辑复制或复制槽时,可以用上述函数进行监控。与往常一样,名称以点开头的文件、目录和其他特殊文件不会输出。默认情况下,只有超级用户和 pg_monitor 组成员可以访问这些函数;也可以把执行权限授予其他用户。
总结
数据库管理系统提供了许多用于组织和存储数据的抽象。
数据库集簇是数据库的统一且不可分割的集合。
数据库集簇、表空间、表和索引在文件系统中表现为目录和文件。
数据库是彼此隔离的“容器”。
模式是用于分组对象的命名空间。
表由用户数据主存储和辅助分支组成。
表采用固定块大小的分页组织方式。
TOAST 表是主表的附加结构,用于存储大值。
数据库集簇目录中有许多与用户数据存储无关的辅助目录。
数据库管理系统为管理员提供了一组用于操作其对象的函数。
表和索引的使用统计信息可以从另一个角度展现工作负载。
工作负载中可能出现错误和不良事件。
大小是数据库管理系统对象的重要特征。
stackoverflow.com/questions/36900462/postgres-wont-start-after-deleting-pg-xlog-files ↩︎
www.depesz.com/2016/10/25/waiting-for-postgresql-10-rename-pg_xlog-directory-to-pg_wal ↩︎
postgrespro.ru/docs/postgresql/current/sql-createdatabase ↩︎
www.cybertec-postgresql.com/en/hot-updates-in-postgresql-for-better-performance ↩︎
postgrespro.ru/docs/postgresql/current/functions-admin#FUNCTIONS-ADMIN-DBOBJECT ↩︎
postgrespro.ru/docs/postgresql/current/functions-admin#FUNCTIONS-ADMIN-GENFILE ↩︎