3 查询与函数的执行
本章将讨论:
为什么需要监控查询;
pg_stat_statements扩展;查询元数据;
查询规划和执行统计信息;
pg_stat_statements的实际使用示例;在所有统计信息来源间进行跨来源查询识别;
基于
pg_stat_statements的报告示例;pg_stat_statements_info视图;pg_stat_user_functions视图。
上一章我们介绍了后端进程和会话、相关统计信息,以及利用这些统计信息进行监控的示例。本章将深入客户端会话内部,了解分析工作负载的方法。客户端发送的查询决定了工作负载;数据库服务器执行这些负载的效率决定了系统的整体性能。数据库系统的统计信息使管理员能够从不同角度考察负载,将工作负载中的查询流拆分为单条查询。逐条考察查询,可以找到优化的切入点,最终改善数据库系统的整体性能。
3.1. 为什么需要监控查询
建立连接并配置会话后,数据库系统就可以执行客户端命令。客户端可以通过命令查询和修改数据(DML 命令)、管理模式对象(DDL 命令)、执行实用操作等。完整的命令列表请参见官方文档1。可以将查询(queries)看作工作负载中的基本执行单位,它们通常是提取和修改数据的命令:SELECT、INSERT、UPDATE、DELETE。
命令、语句,还是查询?
除了查询这个术语外,文档中还会出现语句(statement)这个术语。它的含义更宽泛:“语句”涵盖所有现有命令,而“查询”只是其中返回结果或修改数据的命令子集。在本章后文中,我将用更熟悉的“查询”代替“命令”和“语句”。
查询、查询数量和类型,以及其中涉及的数据库对象,共同构成每个数据库系统独有的工作负载特征,而执行这些查询需要消耗资源。针对各类查询进行优化,最终可以改善数据库系统自身的资源使用,并显著提升性能(或者减少原先必不可少、优化后已显多余的资源分配)。
实践中经常可以看到这样的尝试:通过寻找设置中的某个神奇参数来解决性能问题,打开它就能让一切立刻加速。遗憾的是,这类参数带来的“加速”会牺牲系统的稳定性或可靠性,因此必须提前认真评估风险。更重要的是,这种方法无法带来性能质的提升,也无法达到只有优化查询才能实现的惊人效果(速度提升几个数量级)。最恰当的做法是重构查询;在简单情况下,则是针对特定查询类型添加索引。因此,了解系统执行了哪些查询,是未来优化性能的关键。
可以使用多个视图来评估工作负载特征和正在执行的查询:
pg_stat_statements— 由同名扩展提供的查询累计统计信息视图;pg_stat_user_functions— 用户定义函数执行统计信息视图。
除了这些标准工具外,社区还基于 pg_stat_statements 开发了其他工具:
pg_stat_kcache2 — 该扩展收集后端进程中各个查询实际使用系统资源的统计信息。统计信息通过系统调用getrusage3 进行收集,这可能会对 Linux 以外的平台造成一些限制;pg_stat_monitor4 — 该扩展定位为pg_stat_statements的补充,提供了更丰富的查询评估能力:按时间区间聚合统计信息、收集执行计划、统计查询涉及的表等。
这些扩展会添加单独的视图,用新的能力补充 pg_stat_statements 的功能。不过,我把对它们的研究留作读者的课后作业。
3.2. pg_stat_statements 扩展
pg_stat_statements 视图是数据库系统中所有查询统计信息的主要来源之一。该视图是同名扩展的接口,扩展跟踪查询执行阶段并保存累计统计信息。扩展会保存所有成功执行的查询的统计信息。如果查询执行出错(或被管理员中止),其统计信息就不会保存;这可以算作资源统计方面的一个缺点。
默认情况下,pg_stat_statements 扩展处于关闭状态,但建议始终启用它。可以按以下步骤操作:
在 shared_preload_libraries 参数中指定该扩展,然后重启服务器。这是为了预留共享内存空间;共享内存只在启动时初始化,数据库系统运行期间无法动态地从已经分配的共享内存中获取空间。
重启数据库系统后,需要在某个具体数据库中安装扩展。任何数据库都可以,例如默认情况下始终会创建的
postgres数据库。虽然扩展安装在一个具体数据库中,但它会全局收集所有查询的统计信息,与查询在哪个数据库中运行无关。使用命令CREATE EXTENSION pg_stat_statements;完成安装。
测试环境中已经安装并配置了 pg_stat_statements 扩展,因此不需要额外操作。安装扩展后,统计信息会自动开始收集。可以通过对 pg_stat_statements 执行一个统计视图行数的简单查询来确认:
目前已经积累了 113 个查询类型的统计信息。即使查询非常相似,其参数值也可能不同。把参数取值各不相同的查询逐一保存在统计信息中,会造成冗余,因为查询可能包含数百甚至数千个参数和不同的值。因此,收集过程中会对每个查询执行规范化:把具体参数替换为 $1、$2、$3 等形式的编号占位符。规范化可以把查询归入某个类型,并统计该类型使用的资源量。
除了主视图外,还会安装另一个视图 pg_stat_statements_info,其中包含扩展自身运行的元数据;两个视图都基于同名函数。扩展还提供了实用函数 pg_stat_statements_reset,用于重置累计统计信息。
除了必须在 shared_preload_libraries 中指定外,该扩展还有多个配置参数,可以根据数据库系统的不同运行条件调整扩展的工作方式:
pg_stat_statements.max — 扩展跟踪的查询类型最大数量,对应视图中的行数。当记录的查询数量很多时,不常更新的部分统计信息可能被删除。可以通过
pg_stat_statements_info.dealloc了解删除情况。该参数只能在服务器启动时设置。实践中默认值(5000)通常足够,但对于查询种类很多的生产服务器,最好一开始就至少增加一倍,以免将来重启数据库系统。pg_stat_statements.track — 要跟踪的查询层级。可选值:
— top — 跟踪顶层调用,即客户端请求的调用。默认开启;
— all — 跟踪所有调用,包括函数和过程中嵌套的调用;
— none — 关闭统计信息的收集和保存。
如果存在存储过程和函数,设置为 all 是有意义的,这样可以获得正在执行的工作负载的更详细统计信息。
pg_stat_statements.track_utility — 是否跟踪不同于
SELECT、INSERT、UPDATE和DELETE等 DML 查询的实用命令统计信息。如果基于pg_stat_statements视图构建性能报告,启用该参数可以更完整、更准确地展示工作负载。但要记住,被跟踪的实用命令也会占用内存,当达到 pg_stat_statements.max 时,统计信息可能被删除。pg_stat_statements.track_planning — 是否收集查询规划统计信息。默认关闭,因为它可能降低性能,尤其是在大量客户端执行结构相同的查询时(OLTP 负载就具有这种特征),因为这会造成对相同统计信息项更新的竞争。
pg_stat_statements.save — 是否在服务器重启或关闭时保存统计信息。默认开启,通常可以保持不变。
可以在主配置文件 postgresql.conf 中指定上述参数。大多数参数只需重新加载配置即可生效(修改 pg_stat_statements.max 需要重启)。
关于扩展运行方式的更多细节,请参见官方文档5。
pg_stat_statements 中的全部统计信息大致可以分为几类:
查询及其元数据;
规划统计信息(从 PostgreSQL 13 和
pg_stat_statements1.8 开始提供);执行统计信息;
资源使用统计信息 — 这里指从数据库系统角度看到的资源使用情况;从操作系统角度看,它可能呈现略有不同的形式,后文会单独提到;
WAL 写入统计信息(从 PostgreSQL 13 和
pg_stat_statements1.8 开始提供);JIT 编译器统计信息(从 PostgreSQL 15 和
pg_stat_statements1.10 开始提供)。
可以看到,不同统计信息会在扩展的不同版本中出现。升级数据库系统主版本时,也应同时升级扩展。
后续各节将逐步考察所有统计信息类别。
3.3. 查询元数据
查询文本及其元数据可以区分不同查询,也为查找发送查询的应用提供切入点。查询及其元数据由多个字段表示:
userid— 执行查询时所用用户的标识符。可以通过与pg_user连接,或使用pg_get_userbyid函数查找用户名;dbid— 执行查询所在数据库的标识符。可以通过与pg_database连接来查找数据库名,但没有根据数据库标识符获取数据库名的函数;queryid— 根据查询文本计算出的查询标识符。它不受用户名或数据库名影响;如果相同的查询在其他数据库中或由其他用户执行,这些查询的queryid值也会相同;query— 规范化后的查询文本。规范化会把参数值不同的多个同类查询合并为一个通用查询类型,其中具体值被编号参数替换;
toplevel— 查询调用层级:顶层调用为true,如果调用嵌套在过程中或函数中则为false。如果 pg_stat_statements.track 设置为top,该字段始终为true。创建性能报告时,可以用这个标志过滤嵌套调用,不统计它们的统计信息,因为这些信息已经包含在顶层查询的统计信息中。不使用这个标志可能导致统计信息被重复计算,报告也会因此错误。
译注:queryid 的适用边界
上文保留了原书对跨数据库查询标识符的表述。按 PostgreSQL 15 的实现,queryid 根据解析分析后的查询树计算,其中包含对象的内部标识符。因此,文本相同的查询在不同数据库中、或因 search_path 不同而引用不同对象时,不能保证得到相同的 queryid。参见 PostgreSQL 15 文档中的查询标识符说明。
借助元数据,可以按单独的用户、数据库或组提取并分组统计信息:
3.4. 查询规划
规划是查询执行前的一个独立阶段。在这个阶段,规划器会考察一组执行计划,这些计划的执行复杂度和代价(cost)可能不同;代价是执行查询所需计算资源量的估计值。代价以约定的单位度量,基准是顺序访问时读取一个页面的代价。在构建出的计划中,会选择最优的计划,也就是代价最低的计划,查询将按照该计划执行。一般来说,计划取决于查询复杂度、是否存在合适的索引、规划器设置,以及统计信息与实际数据的符合程度。pg_stat_statements 中的规划统计信息可以跟踪规划次数和规划耗时总量。不过,如前所述,默认关闭规划统计信息的收集,因为对于类似 OLTP 的工作负载,收集规划统计信息可能降低性能。
pg_stat_statements 中的规划统计信息由以下字段表示:
plans— 查询规划次数;total_plan_time— 该类型查询的总规划耗时;
min_plan_time— 最短规划时长;max_plan_time— 最长规划时长;mean_plan_time— 平均规划时长;stddev_plan_time— 规划耗时的标准差。
所有时间值都以毫秒表示。
这类统计信息中最值得关注的是规划时长及其显著变化,尤其是规划次数大致不变、但查询规划耗时变长的情况。这种情况在实践中确实会发生,但幸运的是并不常见。
规划统计信息的使用场景并不多,可以从以下方面入手:
当执行查询的数量没有变化时,各类查询的规划时长可用于跟踪规划异常;
标准差表示规划时长相对于平均规划时长的波动程度。
下面以第一种情况为例。需要使用以下查询:
本章后文还会继续使用类似查询,因此有必要详细拆解它:
首先取某个具体指标作为主要数值,这里是
postgres_statements_time_seconds_total;按一分钟的时间区间,计算该指标的变化速率;
为了获得包含查询文本的标签(
query),根据共同标签database、user、queryid与指标postgres_statements_query_info进行连接;postgres_statements_query_info的值为 1,因此把它乘以 0,避免给主要指标的数值额外加上 1;对得到的变化速率指标按
queryid和query标签分组求和,因为测试环境中有多个用户共同执行相同的查询;
topk_avg函数计算时间序列所选区间内的平均值,按降序排列并取前 K 个值(本例中为 5 个),再把其余值汇总到带有other标签的第六个指标中。
上述查询会输出规划耗时最长的 5 种查询的规划时间统计信息(标签 mode="planning")。其余查询的规划时间合并到带有 other 标签的第六个指标中。
可以根据该查询构建所谓的 top-K 图表(图 3.1),这种图表在全书中会经常出现。它的便利之处在于既能显示最大的数值,也能显示其余数值的总和。
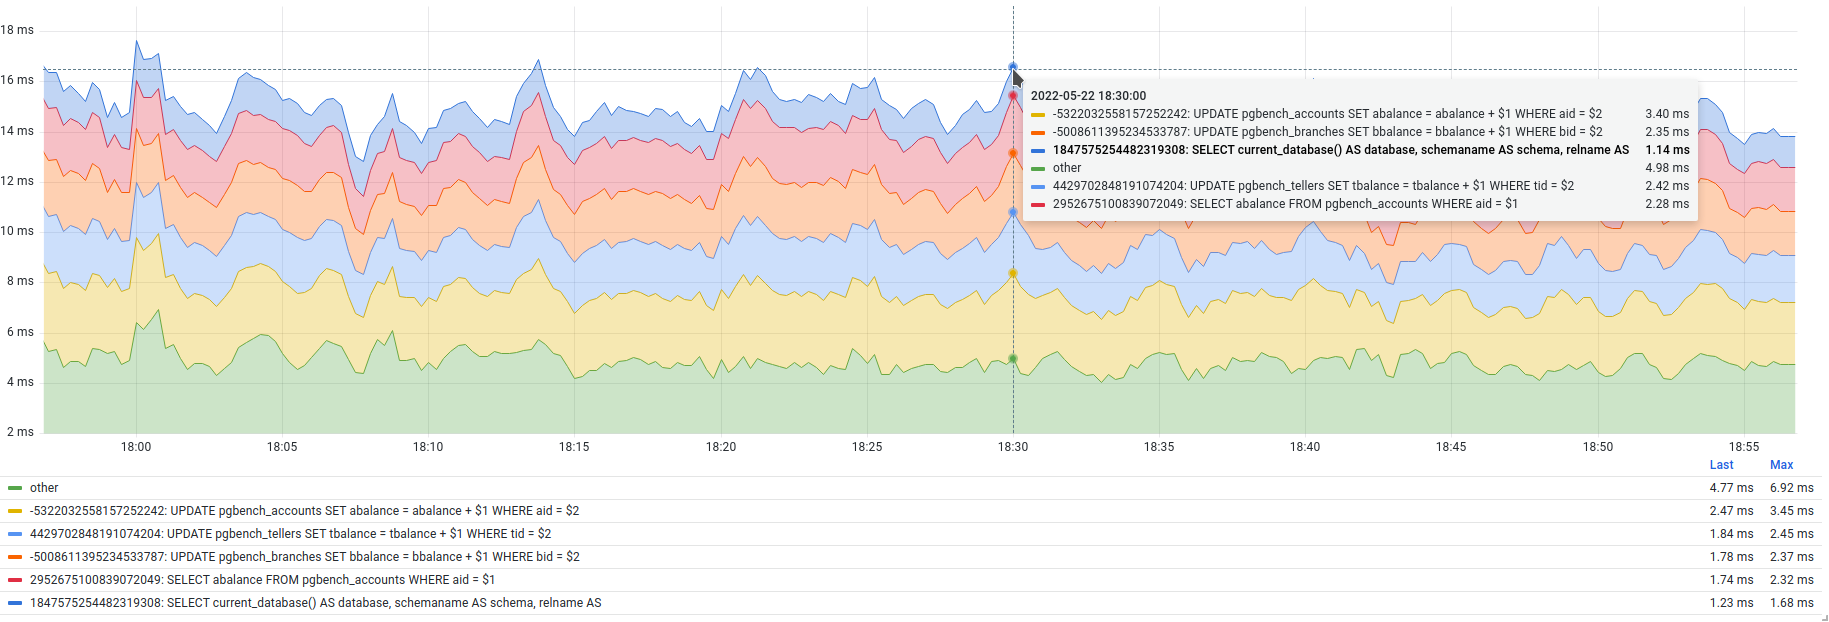
图例的每一行都包含查询标识符和文本,以及指标的最新值和最大值。对于每种查询类型,图表显示数据库系统在 1 秒实际经过时间内用于规划的机器时间。机器时间是所有 CPU 核心工作时长之和,因此在多核处理器的高负载系统中,1 秒实际经过时间内的机器时间很容易超过 1 秒。图表显示的是特定查询类型所有查询的总规划时间变化速率,理解这一点非常重要。图中标出了一个具体时刻——18:30:00;在这一秒实际经过时间内,所有核心为所有查询进行规划合计耗时约 16 毫秒(悬浮提示中给出了更详细的信息)。
译注:“机器时间”的统计口径
此处保留作者的“机器时间”称呼和解释。total_plan_time 实际累计的是各次规划从开始到结束的经过时间,并非操作系统测得的 CPU 运行时间;并发规划的累计耗时可以超过同一段实际经过时间,但不能据此直接推算 CPU 利用率。下文的 total_exec_time 同样属于执行经过时间统计,且包含等待时间,不能直接用于计算剩余 CPU 容量。依据为 PostgreSQL 15 的 规划与执行计时代码 和 区间计时实现。这里的 rate(...[1m]) 以一分钟为计算窗口,结果表示每秒的变化速率,参见 Prometheus 2.55 的 rate 说明。
规划时间图表应与基于 pg_stat_statements.plans 的规划次数图表一起考察。由于规划耗时与规划次数成正比,规划次数减少(或增加)时,耗时也会减少(或增加)。如果规划时间发生变化,而规划次数保持不变,甚至朝相反方向变化,就应当引起怀疑。
3.5. 查询执行
执行是查询生命周期中的主要阶段。在这个阶段,数据库系统利用系统资源,按照计划执行查询,并向用户返回结果。结果可以是一组行,也可以是命令标签(command tag)。执行速度直接影响当前性能和响应时间:查询执行得越快、单位时间内能执行的查询越多,数据库系统的整体性能也就越高。查询执行统计信息最有用,也最常用,因为它可以帮助我们发现查询执行过程中的异常,并立即着手优化(重构查询、添加索引等),而不必深入研究资源使用的细节。
执行统计信息由以下几个字段表示:
calls— 成功执行的查询次数。这个字段的含义与plans接近,但两个字段彼此独立,分别计数,因此数值可能不同。规划成功并不保证执行时不会出错。反过来,执行成功也不意味着此前进行了规划:对于预备语句(prepared statements),执行计划可能在准备阶段就已缓存;rows— 执行该类型的所有查询所返回(SELECT)或影响(INSERT、UPDATE、DELETE)的总行数;total_exec_time— 执行该类型查询所花费的总时间,其中也包括等待锁和事件的时间;min_exec_time— 最短执行时长;max_exec_time— 最长执行时长;mean_exec_time— 平均执行时长;stddev_exec_time— 执行时长的标准差;blk_read_time— 读取数据并将其放入缓冲区缓存所花费的总时间;blk_write_time— 写入数据所花费的总时间。
规划时间
在 pg_stat_statements 1.9 之前,表示执行时间的字段使用其他名称,其中不含 exec。引入规划跟踪后,需要添加新字段,并重命名已有字段。例如,total_time 字段更名为 total_exec_time。
译注:字段更名的扩展版本
原书此处写作 1.9,译文予以保留。PostgreSQL 13 随附的 pg_stat_statements 扩展版本为 1.8,其 1.7 → 1.8 升级脚本 已同时定义规划时间字段和带 exec 的执行时间字段,因此这次更名发生在扩展 1.8。这里的扩展版本号与 PostgreSQL 主版本号不同。
启用并安装扩展后,统计信息会自动收集,缓冲区缓存读写耗时的统计信息(blk_read_time 和 blk_write_time)除外。要统计 I/O 时间,需要启用参数 track_io_timing。与其他时间统计一样,执行时间的单位也是毫秒。
查询执行统计信息可以帮助我们了解工作负载的构成,即查询类型及其在总量中的占比。了解这些查询后,就可以直接着手优化。接下来,我们来看几个使用执行统计信息的实际例子。
调用次数最多的查询。 调用次数可以从 calls 字段取得,并用于计算当前性能。计算时,需要对所有查询的 calls 值求和:
输出的数字相当大。提醒一下,pg_stat_statements 的统计信息会在一段时间内不断累积,因此得到的是整个统计期间执行的查询总数。性能总是针对某个时间段来衡量,例如每秒或每分钟的查询数。通过简单的算术运算就能算出性能;在 PostgreSQL 中,可以使用 SQL 和 psql 客户端的 \watch 功能来计算。另一种办法是使用监控系统查询语言提供的函数:
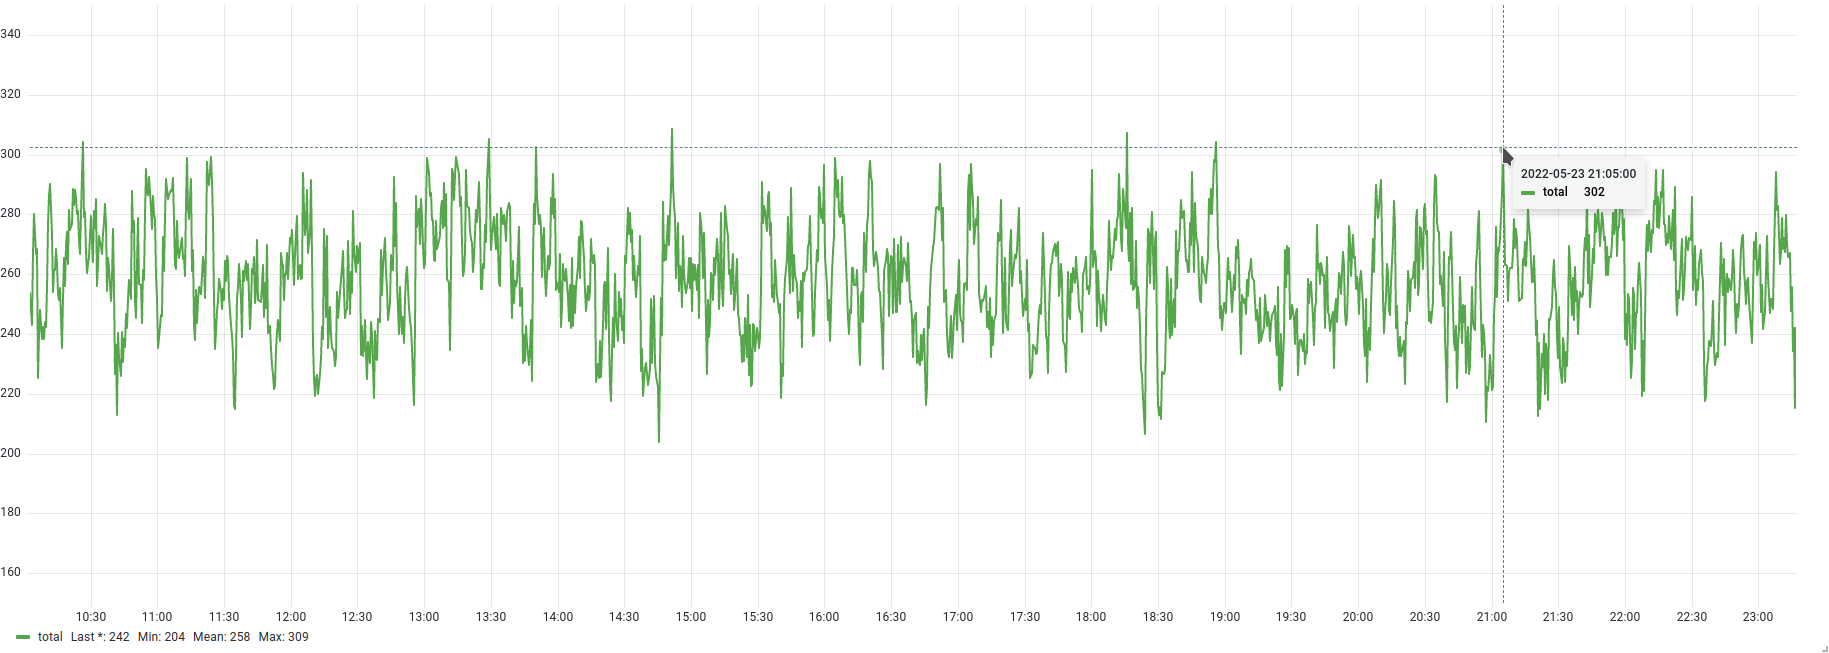
rate 函数计算 postgres_statements_calls_total 在指定时间区间(一分钟)内的变化速率,然后对所有指标求和(每种查询类型对应一个独立指标)。根据查询结果绘制的图表见图 3.2。
图表展示了查询执行频率的变化,下方图例给出了这段时间的聚合值。例如,在大约 12 小时内,平均执行频率为每秒 258 次查询。
这种图表能让我们大致了解当前的工作负载;工作负载发生变化时,也能看到性能的变化,尤其是波动较大的时候。去掉对所有指标求和的步骤,就能看到更详细的情况,确定各类查询在总执行量中的占比。这样便可以知道哪些查询执行得最频繁,以及优化时应重点关注哪些查询。
使用 SQL,也可以通过以下查询得到类似结果:
查询结果显示了执行最频繁的十种查询。不过,这里又出现了“大”数字,表示整个收集期间累积的统计总量。这些数字适合用于生成报告,但在实时监控中,负载并不恒定,重要的是能看到查询执行频率的变化。
图表可以展示这一情况的动态变化,我们先使用下面的查询:
根据这个查询,可以得到如下图表(图 3.3):
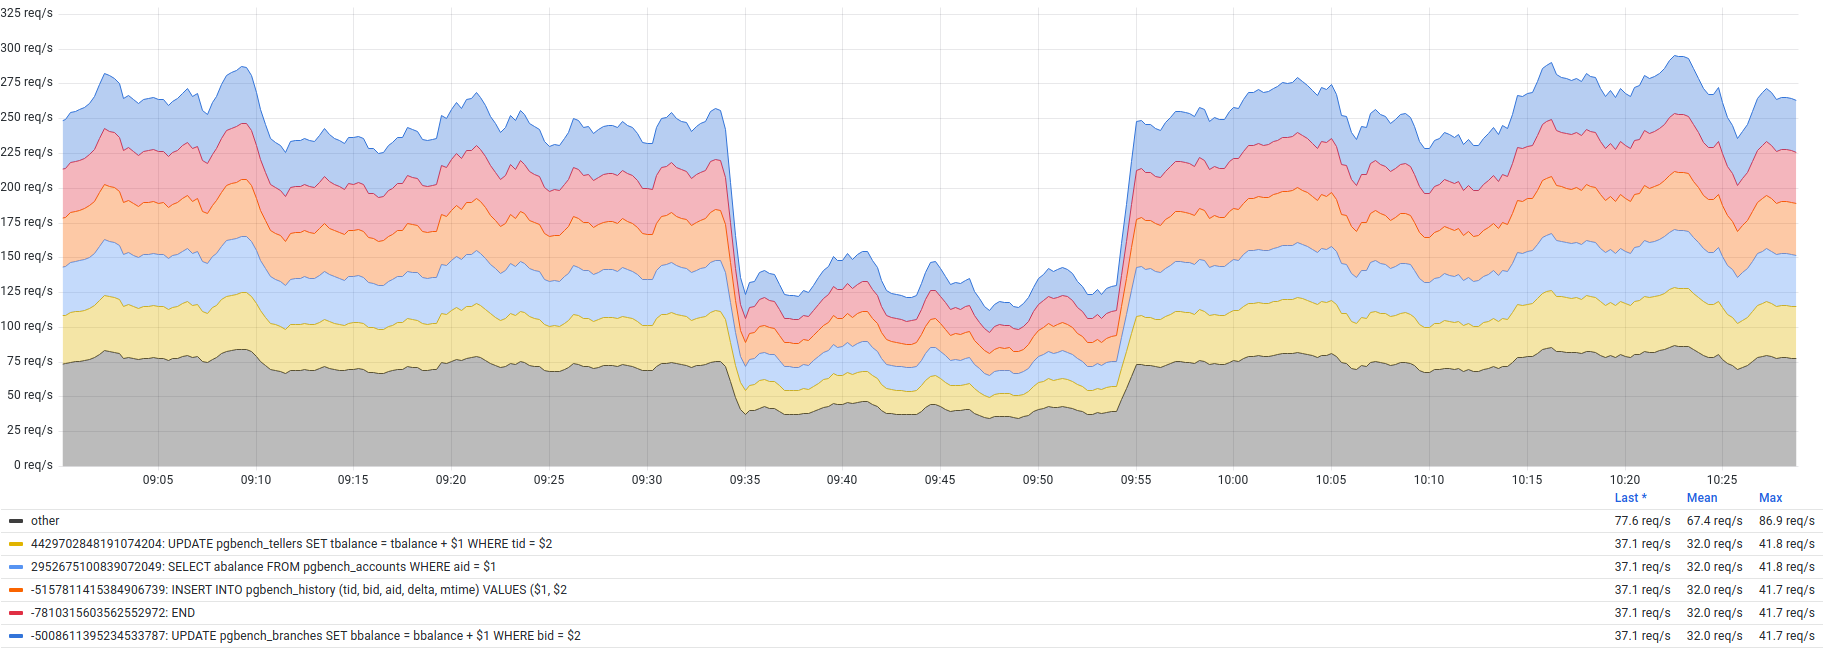
这张图同样展示了当前性能,但细节更多。可以看到哪些查询在工作负载中占比最大、执行最频繁。其余查询也出现在图中,合并为带有 other 标签的指标。工作负载的数量发生变化时,例如应用实例数(或同时工作的用户数)变化,图上就会有所体现:图中的下凹是关闭一个应用所致。不过,需要注意,查询执行次数多并不意味着资源消耗大。接下来,我们将通过例子说明,如何获取资源使用信息,并找出在工作负载中占据较大份额的查询。
影响行数最多的查询。 分析 OLTP 工作负载时,按影响行数对查询排序很有用。这类工作负载中的查询通常只返回少量行。如果查询返回大量行(数千行乃至更多),可能表明应用设计存在问题:执行查询的客户端不太可能需要这数千行中的全部数据。也许查询漏写了 LIMIT 关键字,也许应用自行处理这些行,而这些处理原本可以在数据库系统中完成。可以用以下方法找出这类查询:
与按查询执行次数排序时一样,total_rows 字段中也是很大的数值。使用以下查询,可以在监控中看到这一情况的动态变化:
对应的图表见图 3.4:
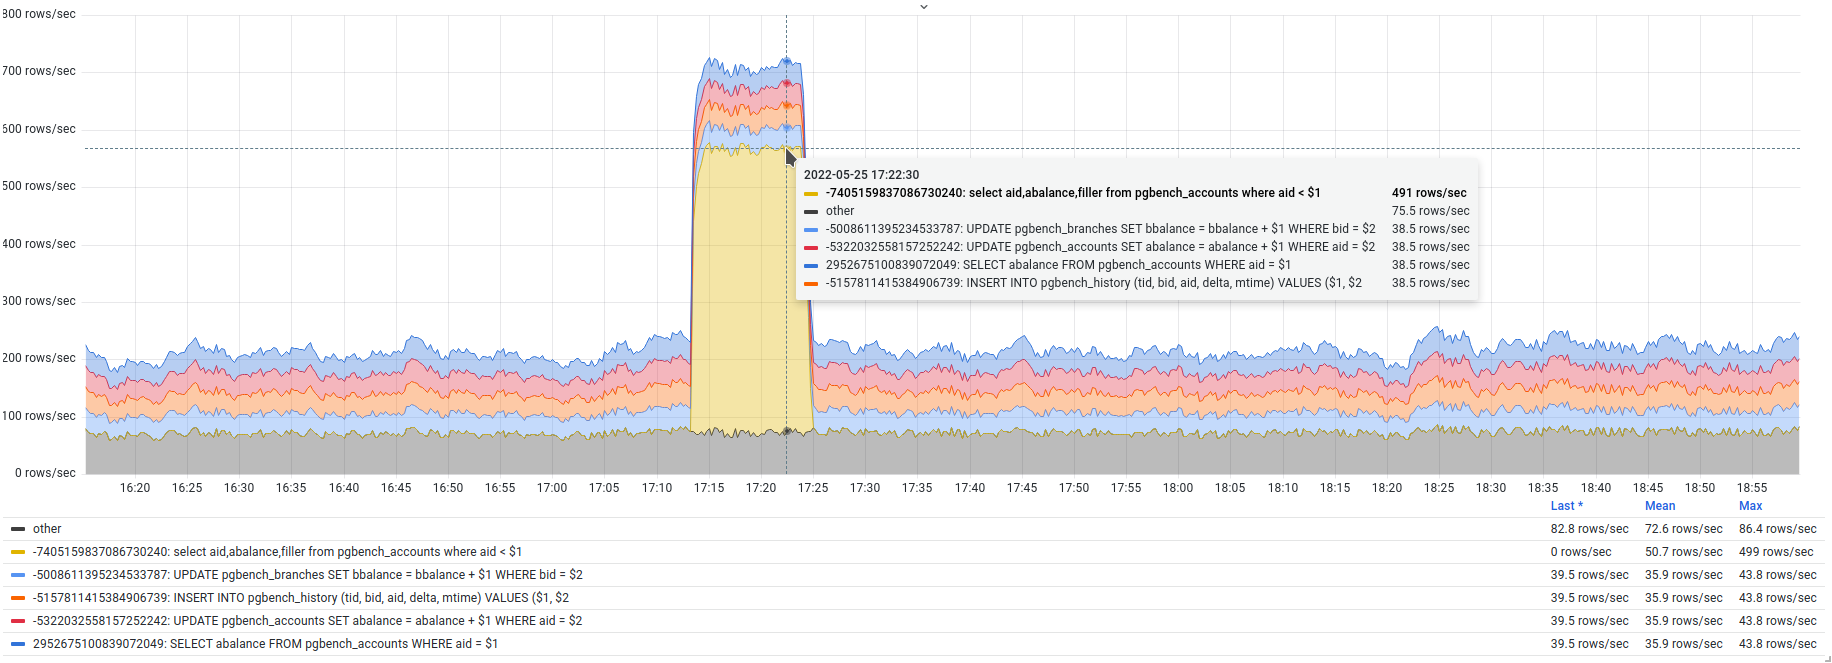
如果工作负载稳定、没有剧烈波动,这张图就会相对平稳,几乎任何异常查询都能明显地凸显出来。在这个例子中,可以通过一个简单查询观察到这一点;我们在 psql 中用 \watch 1 命令循环执行它:
这个查询每秒返回约 490 行,而与它最接近的其他查询平均只返回 35 行,图中的差别很明显。在实践中,漏写 LIMIT 关键字的查询通常就是这个样子。例如,查询可能使用排序;为了满足查询条件并进行后续排序,数据库系统会扫描大量行,还会把这些行发送给客户端,导致数据库系统和应用两侧都产生过量的资源消耗。如果这是一条定期执行的查询,而非一次性任务,就需要分析查询是否符合技术需求。如果查询的写法确实符合设计意图,则应检查使用该查询的功能所对应的业务需求,判断访问如此多的行是否合理(即使是分页,也有办法只读取所需的行)。
执行耗时最多的查询。 作为工作负载的组成部分,查询最重要的特征是执行时间。缩短查询执行时间可以提高数据库系统的性能:释放出来的资源可以用于执行更多查询。要找出执行耗时最多的查询,可以使用与前面类似的查询:
提醒一下,total_exec_time 字段以毫秒存储时间;为了方便阅读,这个查询将其转换成了常见的时间格式。还可以把规划时间 total_plan_time 加进来,得到包含规划在内的查询总耗时。
结果中有一条查询格外突出:它的累计执行时间约为 105 小时,是第二名的七倍。执行这个查询占据了工作负载的大部分。不过,有一个重要细节还没有体现出来:这些统计信息覆盖了多长时间?一天内累积 105 小时机器时间,与一个月内累积同样的时间,代表的工作负载完全不同。要回答这个问题,可以查看 pg_stat_statements_info.stats_reset:
这里的统计信息累积了 17 天,也就是说,我们关注的查询平均每天执行约六小时。考虑到一天还剩 18 小时,这个数字其实不大;如果再乘以可用的处理器核心数,可用的时间就更多了。
现在转向监控,观察查询执行时间的动态变化:
根据这个查询,可以得到图 3.5 所示的图表。
图表展示了各类查询执行时间的变化(标签 mode="executing")。可以看到,数据库系统的大部分时间都花在执行同一类型的查询上,执行其余查询所需的时间要少得多。这里还应注意时间的剧烈波动:我们关注的查询在 83 到 1900 毫秒之间波动,这值得怀疑。在相对稳定的工作负载中,执行时间的变化范围应当小得多(整个样本的标准差应接近零)。原因在于执行时间也包含等待时间,而上一章已经说明,测试工作负载中经常出现锁等待。等待其他事务会使查询的执行时间大幅波动,这一点反映在图中。
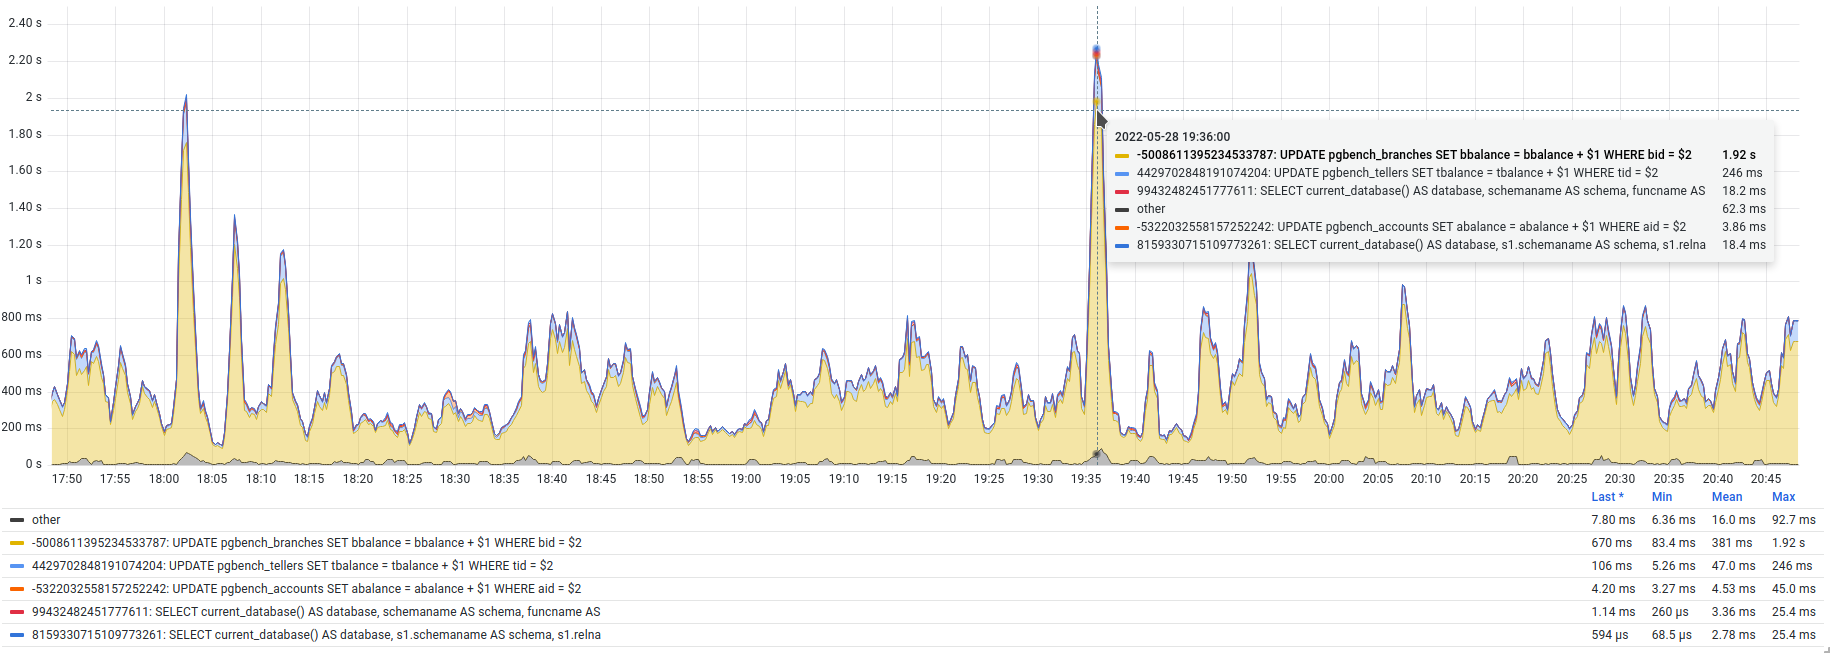
在实践中,这是最常用的图表之一,因为它能帮助我们迅速找出需要关注的查询,并立即着手优化。很多时候,只需创建索引就能大幅缩短查询的执行时间。情况更复杂时,则需要重构查询,或者像测试工作负载这样,采取措施减少资源竞争。
I/O 耗时最多的查询。 块 I/O 耗时是工作负载的另一个重要特征。它可以显示数据库系统将数据读入缓冲区缓存(shared buffers)以及从中写出数据所花费的时间,也能在一定程度上反映缓冲区缓存是否够用。如果缓存中没有所需数据,数据库系统就会请求操作系统读取,很可能需要读盘。访问磁盘比访问内存中的缓存慢,会对查询执行时间产生不利影响。所需数据也有可能位于页缓存(page cache)中,这时读取同样很快,只是会有一些额外开销。
pg_stat_statements 中有几个字段记录块 I/O 耗时:
blk_read_time和blk_write_time统计共享缓存和本地缓存中页面的 I/O 时间;temp_blk_read_time和temp_blk_write_time统计临时文件中页面的 I/O 时间。
只有启用参数 track_io_timing 才会收集这些统计信息。根据经验,建议始终启用它(不过,额外开销可能达到 1% 左右)。有了这些统计信息,就能找出经常需要访问磁盘的查询,并安排优化或增加资源。
可以分别计算读取和写入的统计信息,也可以把二者合并统计。实践中通常采用后一种方式:
大部分 I/O 时间都花在一种查询上。这与前面执行耗时最多的查询并不是同一条。分析这类查询时,需要考虑它们的执行频率。例如,对于很少执行、访问冷数据(归档数据)的查询,访问磁盘可能是可以接受的。对于定期执行的查询,例如测试环境中发现的这条查询,持续访问磁盘可能成为额外开销,延长执行时间。消除磁盘访问,或至少缩短访问时间,都可以加快查询执行。具体可采取的措施取决于访问模式:增大缓冲区缓存,使所有需要的热数据都能容纳其中;升级系统资源(增加内存、使用性能更高的存储设备或虚拟机等)。当然,最好的办法还是分析并优化查询。
在监控中,可以用以下查询找出块 I/O 耗时最多的查询:
注意,查询中为 mode 标签列出了 ioread 和 iowrite 两种取值;需要时,也可以只获取读取时间或只获取写入时间。
使用这个查询,可以观察 I/O 的动态变化(图 3.6):
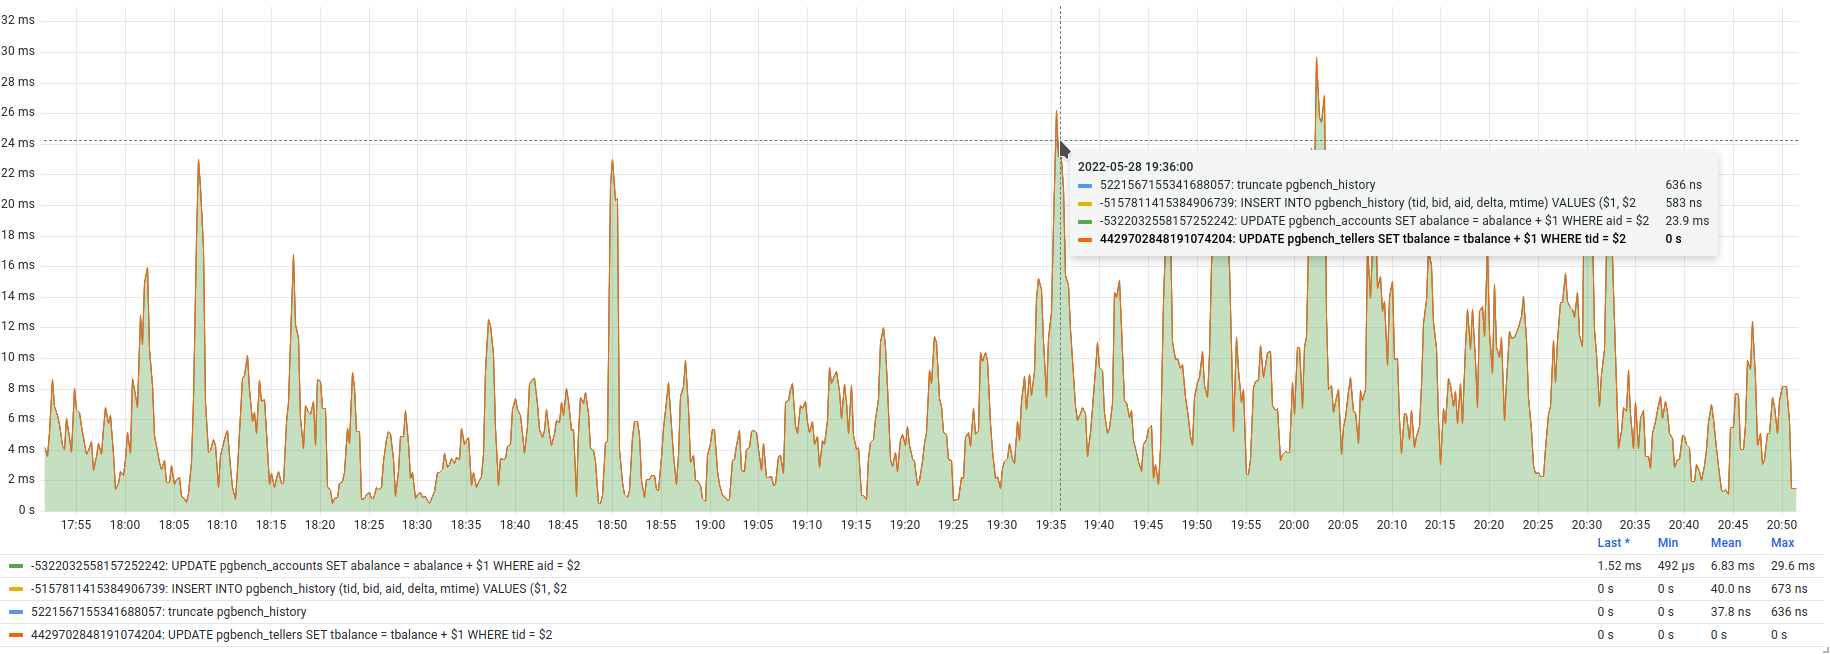
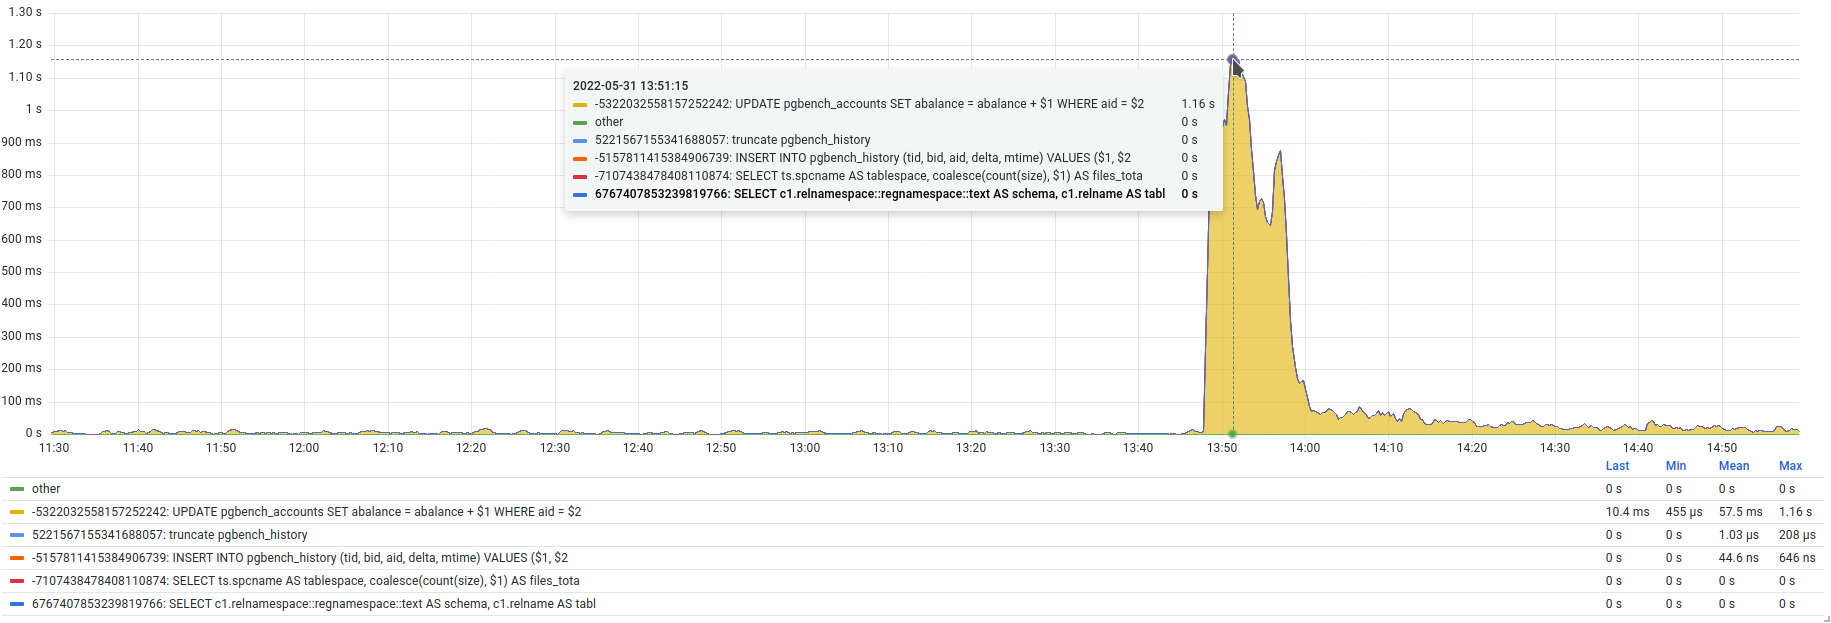
图中的情况与 SQL 查询结果一致。只有一种查询持续花费时间进行 I/O,平均每秒实际经过时间内消耗 6.83 毫秒。这看起来似乎不多,但要记住,开销很小的操作系统页缓存访问也算作块 I/O。可以做个实验:清空页缓存,看看数据库系统被迫真正访问磁盘时,I/O 时间如何变化。在 Linux 中,以 root 用户执行以下命令即可清空缓存(不要在生产环境中这样做,这会降低性能):
几分钟后,数据进入监控系统,就能看到 I/O 时间的峰值升至 1.16 秒(图 3.7)。随着工作负载继续运行,缓冲区缓存和页缓存逐渐填满,I/O 时间会逐步下降,最终恢复到清空页缓存之前的水平。
扣除 I/O 后执行耗时最多的查询。 既然能得到块 I/O 耗时,就可以通过简单的算术运算,得到一个暂且视为处理器执行查询所耗时间的数值。之所以说“暂且”,是因为这个统计值虽然反映执行时间,却不能精确表示处理器实际处于运行状态、执行该类查询的时间。还有一点很重要:它也包含等待时间。精确的处理器使用统计信息则可以借助相应模块获取。
用于此目的的 pg_stat_kcache 模块使用 getrusage 系统调用。不过,这不是官方扩展,需要单独安装软件包。
因此,要得到上述统计值,应从总时间 total_exec_time 中减去块 I/O 耗时:
这里的处理器时间几乎与总时间相同,说明数据库系统用于块 I/O 的时间相对较少,只有约 1%:
使用 SQL 评估查询执行时间时,同时输出这两项统计信息总是很有用,这样就能看出时间究竟花在了哪里。
这里可以直接看出 I/O 时间和 CPU 时间的比例,其中一条查询约三分之一的总执行时间花在 I/O 上,十分醒目。如果能让这类查询在缓冲区缓存中找到所需数据,就能从四小时的累计执行时间中节省约 80 分钟。这些时间可以用来执行其他查询,提高性能。
pg_stat_statements 提供的不只是规划和执行统计信息。这个视图中还有 I/O 和 WAL 写入统计信息,我们将在其他章节继续讨论。
3.6. 使用 queryid 进行跨来源查询识别
数据库系统中执行的查询,其信息可以从几个来源取得:
pg_stat_activity— 会话中正在执行的查询;pg_stat_statements— 成功执行的查询的累计统计信息;服务器日志 — 查询信息,不论查询最终成功还是出错;
EXPLAIN命令的输出 — 查询执行计划。
不过,很长一段时间里,这些来源之间并没有关联。要完整了解某种查询,就需要综合处理所有来源的数据。但 pg_stat_activity 和服务器日志记录的是完整查询文本,pg_stat_statements 保存的则是规范化后的查询,匹配它们并不容易。pg_stat_statements 扩展能够计算查询标识符 queryid;从版本 14 开始,其他来源中也能获取这一标识符,如今要在各个来源中识别同一查询就容易多了。
标识符的计算由参数 compute_query_id 控制。默认值 auto 允许 pg_stat_statements 及类似扩展自动计算标识符。启用 compute_query_id 后,查询标识符会出现在 pg_stat_activity、csvlog 格式的日志(或通过 log_line_prefix 指定格式的日志)以及 EXPLAIN VERBOSE 的输出中。
跨来源查询识别实现后,两个视图中的字段名并不相同,分别是 pg_stat_activity.query_id 和 pg_stat_statements.queryid。
3.7. 基于 pg_stat_statements 生成报告
评估系统较长时间内的运行情况时,汇总报告会很有用。这类报告通常从不同角度展示系统处理工作负载的效率。借助报告,既可以迅速评估系统状态,也能与此前的时间段比较,跟踪变化趋势。利用 pg_stat_statements 中查询统计信息的累积特性,就可以生成这类报告。
这类报告的思路很简单:先计算 pg_stat_statements 中各个维度的资源使用总量,再计算每条查询在相应总量中的占比。得到各查询的资源使用占比后,按某个标准排序,例如查询的累计执行时间。
DataEgret 的代码仓库中提供了生成这类报告的示例脚本6。报告列出执行耗时最多的查询,并附上 pg_stat_statements 中的详细信息。以下是针对测试环境中查询生成的一份报告:
报告分为两部分。第一部分显示总体信息:
成功执行所有查询所花费的总时间,并单独标出 I/O 占比;
成功执行的查询总数,以及不同查询类型的数量;
报告版本与 PostgreSQL 版本;
pg_stat_statements的设置。
第二部分按累计执行时间对查询排序,并为每条查询提供补充信息:
查询在总执行时间中的占比,分为 CPU 和 I/O 两部分;
查询调用次数及其在全部调用中的占比;
查询平均执行时间,其中单独列出 I/O;
用户、数据库和影响行数的信息;
规范化后的查询文本。
这些信息足以评估各查询在工作负载中的占比,并在需要时进一步分析性能、重构查询。也可以按需修改脚本,添加其他信息,例如统计信息的时间范围、查询标识符、资源使用情况、生成的日志记录量等。
另一个例子是 pgcenter 输出的报告。它可以针对 pg_stat_statements 中任意一条感兴趣的查询,给出汇总信息:
pgcenter 报告只关注选中的一条查询。报告上方的第一部分给出总体汇总信息,第二部分显示所选查询的统计信息及其在整体工作负载中的占比:
调用次数、影响行数及各自占比;
生成的日志记录量,细分为记录数、字节数和 FPI 页面数(参见 full_page_writes7);
该类型所有查询的累计执行时间,细分为规划、执行和 I/O;
该类型查询的平均执行时间及其明细;
规范化后的查询文本。
比较两份报告可以看出,它们的用途不同。DataEgret 报告更全面地展示数据库系统正在执行什么,更适合作为汇总报告。pgcenter 报告评估某条查询的资源使用情况,更侧重即时分析,以及查看可疑查询的细节。
生成这类报告、计算资源使用总量时,要记住 pg_stat_statements 不仅可以收集顶层查询的执行统计信息,也可以收集嵌套查询的统计信息;这一行为由参数 pg_stat_statements.track 控制。取值为 all 时,跟踪更详细,但可能把部分统计信息重复计算。例如,查询调用的函数内部又执行其他查询或函数,汇总时便会同时计入函数本身和其中所有嵌套查询的统计信息,可能严重扭曲结果。为避免这一问题,应考虑 toplevel 标志;它表示执行层级,可用于排除嵌套查询(toplevel = false)。遗憾的是,toplevel 标志在版本 14 中才出现,因此在更早的版本中,建议使用 pg_stat_statements.track = top 这一设置来生成报告。
3.8. pg_stat_statements_info 视图
除了主要视图,扩展还提供一个小型辅助视图 pg_stat_statements_info,只有一行、两个字段:
dealloc— 由于达到 pg_stat_statements.max 限制,扩展被迫删除部分统计信息的次数。这可能导致部分统计信息丢失,从而影响报告数据的准确性。一种变通办法是使用监控系统作为数据来源。如果尚未达到限制,可以通过增大数据库系统配置中的 pg_stat_statements.max 来解决问题,不过这需要重启服务器。stats_reset— 最近一次重置统计信息的时间戳,可用于明确查询统计信息累积的时间范围。
输出示例:
从这个例子可以看出,现有容量足够,至少在过去 18 天内,没有发生过统计信息删除。
3.9. 过程与函数的执行
处理数据时,可以用函数实现复杂逻辑。这些函数可以用 SQL 编写,在其中组合多条查询。除了 SQL,还支持 PL/pgSQL、PL/Tcl、PL/Perl 和 PL/Python 等过程语言(procedural language,PL)。如果工作负载中的查询调用了函数,管理员就需要找出较慢的函数并加以优化。数据库系统提供 pg_stat_user_functions 视图,其中包含函数执行统计信息的最基本集合,可用于简单的函数性能分析。更细致的函数性能剖析则需要借助第三方工具。
pg_stat_user_functions 的主要用途是优化应用的性能,而不是单条查询的性能。通过这个视图,可以找出目标应用调用最频繁的热点函数并进行优化,从而提高应用性能。
pg_stat_user_functions 还可以与 pg_stat_statements 配合使用。在后者中,可以找到调用函数的查询,并通过相应字段了解执行时间和资源使用情况。
配置参数 track_functions 用于控制函数执行统计信息的收集,可以取以下值(修改后只需重新加载配置即可生效):
none— 关闭统计跟踪(默认值);pl— 只跟踪用过程语言编写的函数;all— 跟踪所有函数,包括用 SQL 和 C 编写的函数。
需要注意,无论参数取何值,内联(inline)到调用查询中的 SQL 函数都不会被跟踪。
pg_stat_user_functions 视图包含的数据相对较少:
funcid— 函数的唯一标识符;schemaname— 函数所属模式的名称;funcname— 函数名称,在同一模式内可能不唯一,因为允许通过不同的输入参数列表来重载函数;calls— 函数调用总次数;total_time— 函数执行总时间(毫秒),若有嵌套函数,也包括嵌套函数的执行时间;self_time— 函数自身的执行总时间(毫秒),不包括嵌套函数的执行时间。
如我前面所说,这些统计信息主要用于找出调用最频繁和执行耗时最多的函数。基于 pgbench 标准场景的测试工作负载不调用函数,因此统计信息较少,只包含扩展中函数的调用:
这个查询没有附加条件或排序,因为我事先知道统计数据不多。这里只有三个函数的统计信息,它们属于 pg_buffercache 和 pg_stat_statements 两个扩展。其中两个函数由监控代理调用,calls 字段记录调用次数。由于这两个函数都没有嵌套调用其他用户定义函数,各自的 total_time 和 self_time 相同。它们的累计执行时间分别约为 122 秒和 14 秒。pg_buffercache_pages 的调用频率约为另一个函数的两倍,但总执行时间约为其 8.5 倍,也就是说,数据库系统执行它的开销更大。
用这种方法比较函数的执行时间,就能找出耗时最多的函数。以下查询可以从监控系统获取统计信息:
这个查询使用 increase,而不是 rate。由于这些函数只由监控代理调用,显然调用频率相对较低,每分钟只有几次。因此,观察每分钟(而非每秒)花在函数执行上的时间更方便。对于生产工作负载,函数可能执行得更频繁,还可能在多个会话中并发执行,这时使用 rate 也许更合适。
图 3.8 与查询 pg_stat_user_functions 的输出反映了相同情况:大部分时间都花在执行 pg_buffercache_pages 上。
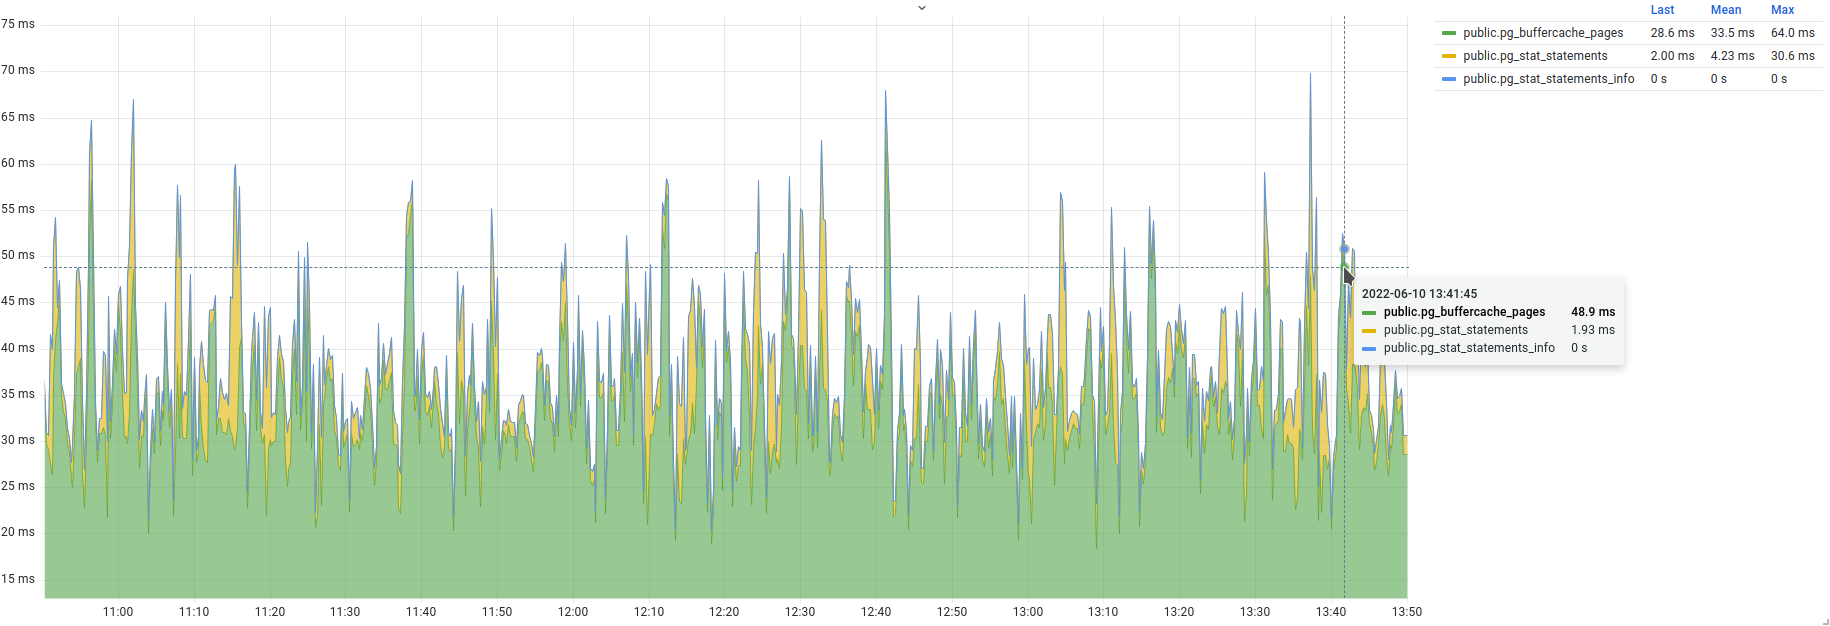
平均每分钟,执行这个函数需要 33 毫秒,而 pg_stat_statements 函数只需 4 毫秒。
小结
查询是执行工作负载的基本单位。
查询监控不可或缺,对理解工作负载十分重要。
分析工作负载可以使用
pg_stat_statements扩展,该扩展默认关闭。pg_stat_statements视图包含查询规划与执行、资源使用、I/O 时间和 WAL 生成等统计信息。pg_stat_statements视图是监控图表和数据库系统运行报告的重要数据来源。数据库系统提供跨来源查询识别功能,以便分析不同来源的统计信息。
pg_stat_statements_info视图提供有关pg_stat_statements扩展运行情况的有用信息。用户定义函数的执行统计信息位于
pg_stat_user_functions中。